我們把自己的預測庫抓來體檢:84 檔波動率預測,到底準不準?
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
我們把自己的預測庫抓來體檢:84 檔波動率預測,到底準不準?
做波動率預測這行,最該被問的問題其實最少人敢答:你們過去喊的那些數字,事後對照真實市場,準嗎?
VolPred 累積了一百多組已存的樣本外(OOS)預測,全部出自 GARCH 家族模型。過去我們算過 QLIKE、算過 VaR,卻從沒回頭做過一件更基本的事:檢查這些預測有沒有「系統性地偏一邊」。這次補上,把其中 84 檔預測全部攤開來體檢一遍。先說結論:好壞參半。我們照樣把它攤開來講,這正是一個負責任的平台該做的事。
怎麼判斷一個預測「準不準」
我們用的方法叫 Mincer-Zarnowitz 校準回歸,名字嚇人,做法很白話。
把每天的預測值放在橫軸 X,把那天實際發生的波動放在縱軸 Y,跑一條直線。如果模型完美,這條線的斜率會剛好是 1、截距剛好是 0:你喊多少,市場就走多少。斜率如果小於 1,代表預測的高低起伏比市場實際劇烈,模型喊得比行情走的還兇。截距如果不是 0,代表整體水位偏高或偏低。
我們再用一個統計檢定(joint Wald)同時問這兩件事:斜率是不是 1、截距是不是 0。兩個都成立,這檔預測就算「校準合格」。有一個明顯不對,就被標成偏誤。整套流程固定隨機種子、用 HAC 穩健標準誤,而且刻意不把不同資產同一天的數字混在一起算,避免把市場共同震盪誤當成獨立樣本。
體檢結果:合格率三成,GJR 家族最穩
84 檔預測橫跨 7 個資產(SPY、QQQ、GLD、TLT、EEM、USO、BTC-USD)與 4 個模型家族。整體算下來,大約 31% 的預測校準合格。沒有全勝,也遠不是全軍覆沒。
四個家族的表現有高有低:
| 模型家族 | 檔數 | 校準合格比例 | 預測÷實際(中位數) | 斜率 b̂(穩健版) | Wald 拒絕比例 |
|---|---|---|---|---|---|
| GJR-GARCH | 38 | 15 檔(39%) | 1.07 | 0.76 | 0.61 |
| GARCH(1,1) | 25 | 6 檔(24%) | 1.11 | 0.75 | 0.76 |
| EGARCH | 7 | 2 檔(29%) | 1.13 | 0.43 | — |
| CGARCH | 5 | 0 檔(0%) | 1.02 | 0.87 | — |
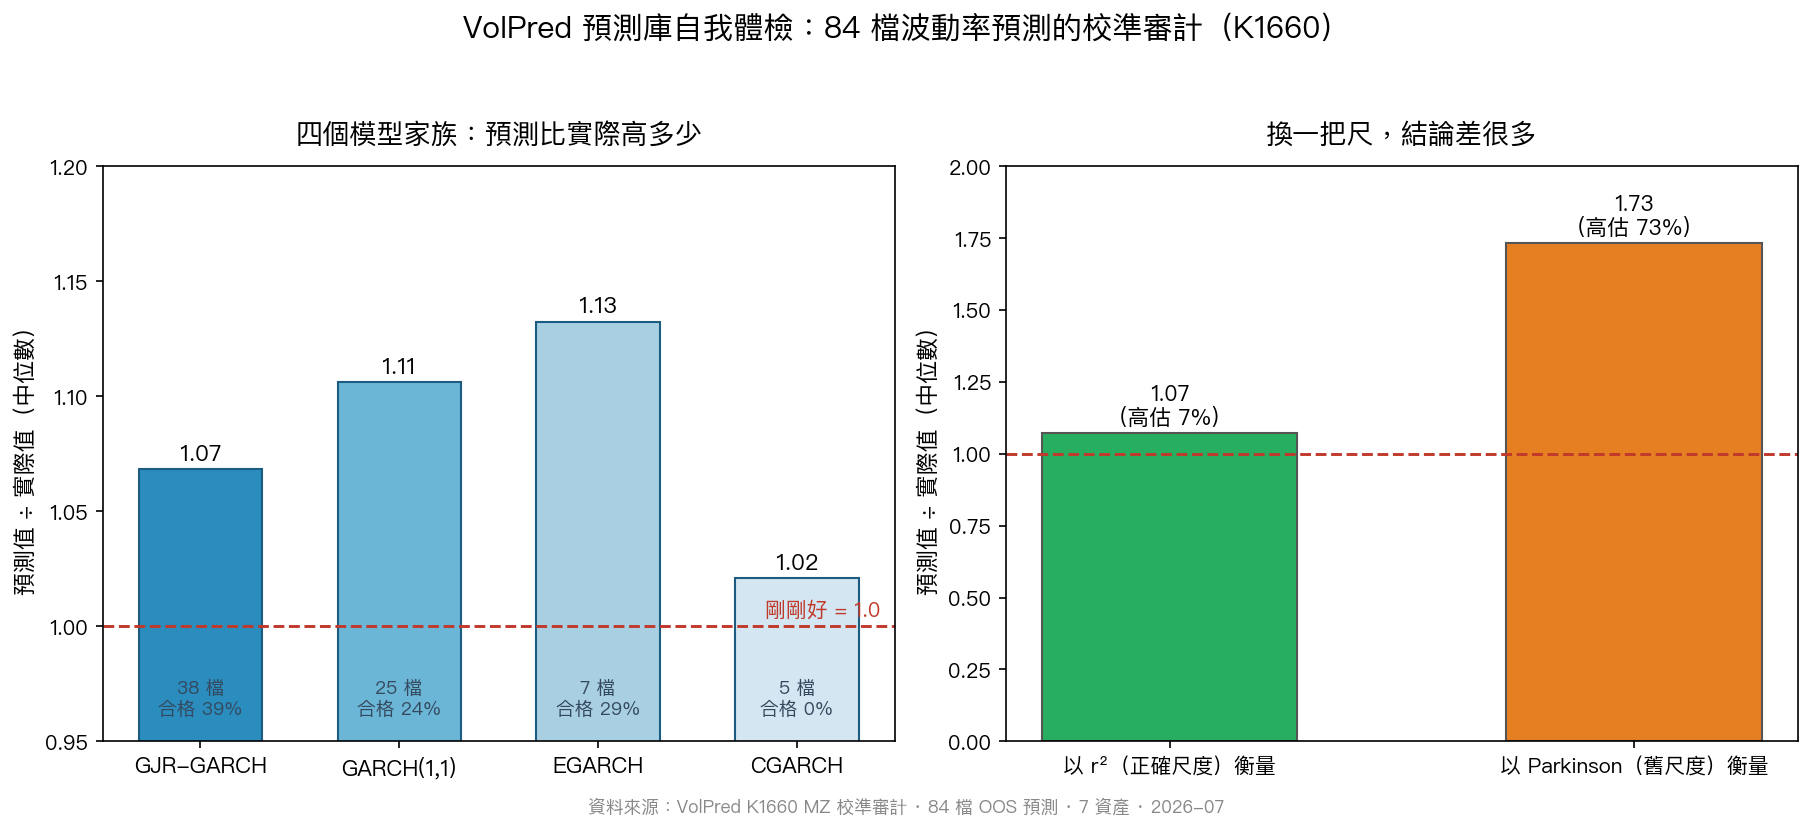
GJR-GARCH 是這次表現最好的家族,38 檔裡 15 檔合格,水位偏差也最溫和(預測只比實際高約 7%)。GARCH(1,1) 合格率就掉到四分之一,Wald 拒絕比例高達 76%。
兩個偏誤,一個溫和、一個穩定
體檢抓到兩種偏誤,方向一致。
第一種是水位偏高。四個家族的「預測÷實際」中位數落在 1.02 到 1.13 之間,也就是模型整體傾向把未來波動喊得比實際高一點點。原因不神秘:這些模型大多在 2022 那個高波動年份訓練,接著要預測相對平靜的 2023、2024。GARCH 家族有個天生的慢動作特性,當市場從激烈回歸平靜,它把預測值降下來的速度不夠快,於是就一路喊得偏高。
第二種是起伏太大。前面提到的斜率,全體核心檔案的穩健中位數大約是 0.75,小於 1。翻成白話:模型預測的高低震盪,比市場單日真正走出來的還要誇張一點。有意思的是,這個 0.75 和我們過去一份獨立實驗算出的 0.67-0.68 幾乎對得上,說明它是模型的結構特徵,不是這批樣本的雜訊。
最實用的發現:量錯了尺,結論會差很多
如果只挑一個能立刻改進平台的收穫,是這個:用錯衡量基準,會把偏誤誇大好幾倍。
我們的資料管線過去存的「實際波動」用的是 Parkinson 估計值,它只看盤中最高最低價,漏掉了隔夜跳動。但 GARCH 預測的是整日(含隔夜)的波動。尺不對,比出來的結果就走樣。
同一批 84 檔預測,換兩把尺量:
用正確的 r²(收盤到收盤報酬平方)當基準,預測只比實際高約 7%。改用舊的 Parkinson 當基準,同一批預測看起來高估了 73%。差距十倍。上方右圖把這件事畫得很清楚:綠色那把尺量出來的偏差溫和,橘色那把尺量出來的偏差被硬生生放大。
也就是說,過去平台看到的「模型好像高估很多」,一大半是量測基準選錯造成的假象,不是模型真的爛。這條發現直接告訴我們:GARCH 家族的存檔評估應該改用 r²(或更精細的 5 分鐘已實現波動),Parkinson 這把尺留給它原本適合的 range 類、HAR 類模型。
知道有偏誤,不等於能事後修好
既然抓到系統性偏誤,那把回歸算出來的斜率、截距反過來校正一下,預測不就變準了?我們試了,答案很老實:沒用。
拿旗艦 SPY 的 GARCH 預測做嚴格的樣本外校正,QLIKE 只改善了 0.42%,DM 檢定 p 值 0.68——統計上跟沒改一樣。四個家族逐一試過,沒有任何一個的樣本外校正達到顯著。唯一看起來大的是 EGARCH SPY,校正後改善 17.3%,但那是因為它原本斜率偏得最誇張(只有 0.13),把最差的拉回一點而已,而且 p 值 0.28 一樣不顯著。
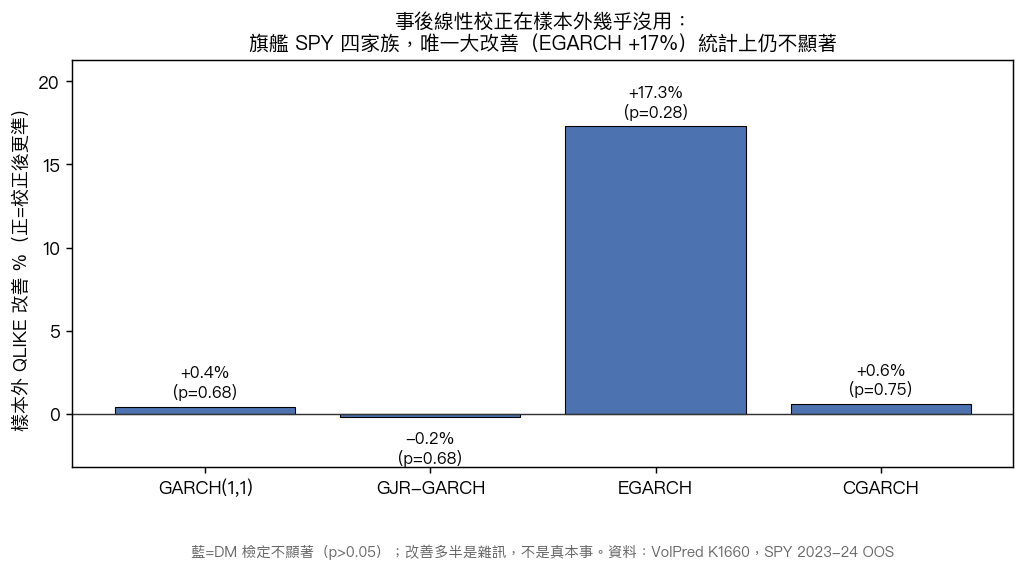
這個結果呼應了我們一直在講的「複雜度天花板」:知道模型哪裡偏,跟能把它事後修準,是兩回事。偏誤真實存在,但一條簡單的線性校正,救不回可投資的預測品質。
一個必須誠實交代的限制
r² 是個很吵的基準,它的雜訊大約是 5 分鐘已實現波動的 8 倍。所以在平靜的 2023、2024,這些回歸的 R²(解釋力)只有 0.01 到 0.05,看起來很低。這是這把尺的天生特性,不代表模型無效。真正有意義的校準訊號藏在斜率的穩健推論裡,不在 R² 那個數字上。把這件事講清楚,才對得起看數字的讀者。
為什麼把不太好看的結果公開
回到最開始的問題:這些預測準嗎?答案是三成合格、水位溫和偏高、起伏略大,而且最大的「高估」其實是量測方法造成的假象。
這種好壞參半的體檢,換個角度想,正是一個預測平台該有的樣子。願意定期把自己的預測庫抓來對照真實市場、願意把 null 結果原原本本寫出來,比每次都宣稱「我們超準」可信得多。這次體檢也留下兩個明確的下一步:把 GARCH 家族的存檔評估換成正確的尺,以及繼續往更精細的已實現波動基準走。
體檢會定期做下去。下次再攤開來看。
數據來源 :VolPred K1660 MZ 校準審計,84 檔 OOS 預測,7 資產(SPY / QQQ / GLD / TLT / EEM / USO / BTC-USD)× 4 模型家族,2026-07。方法:Mincer-Zarnowitz 校準回歸、HAC-NW(lag=5)穩健標準誤、joint Wald 檢定、expanding-window 樣本外校正、seed=42。完整結果與可復現腳本見 experiments/k1660_mz_calibration_audit/。
延伸閱讀
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊