同一組對照,兩種 p 值差了十七個數量級:重疊視窗如何讓 t 檢定失去鑑別力
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
K1495 檢驗的是一個好懂的問題:當 SPY 相對 RSP 的累積報酬差(市值加權相對等權重的「集中度 pulse」)站上 expanding 第 80 百分位時,接下來 21 天的市場波動會不會比較高。結論那一面已經寫過一篇給一般讀者的版本(〈集中度警報響起時,等權重指數震得比大盤還兇〉),要看「所以呢」的讀者請看那篇。
這一篇要談的是那份結果裡沒有進到前一篇的東西: 同一組對照、同一份資料,Welch t 檢定與 stationary bootstrap 給出的 p 值差了十七個數量級,而且在其中兩個檢定上,兩者的判定方向不一樣。
這不是誰算錯了。這是重疊視窗的資料上,兩種推論方法各自在說不同的話。
五個檢定,兩種算法
樣本是 2004-05-28 到 2026-05-13 的 5,524 個交易日,高集中 regime 佔 29.06%。目標變數是隔天起算、往後二十一個交易日的實現波動率,regime 判定只用到當天為止的歷史(expanding 百分位),所以沒有偷看未來。
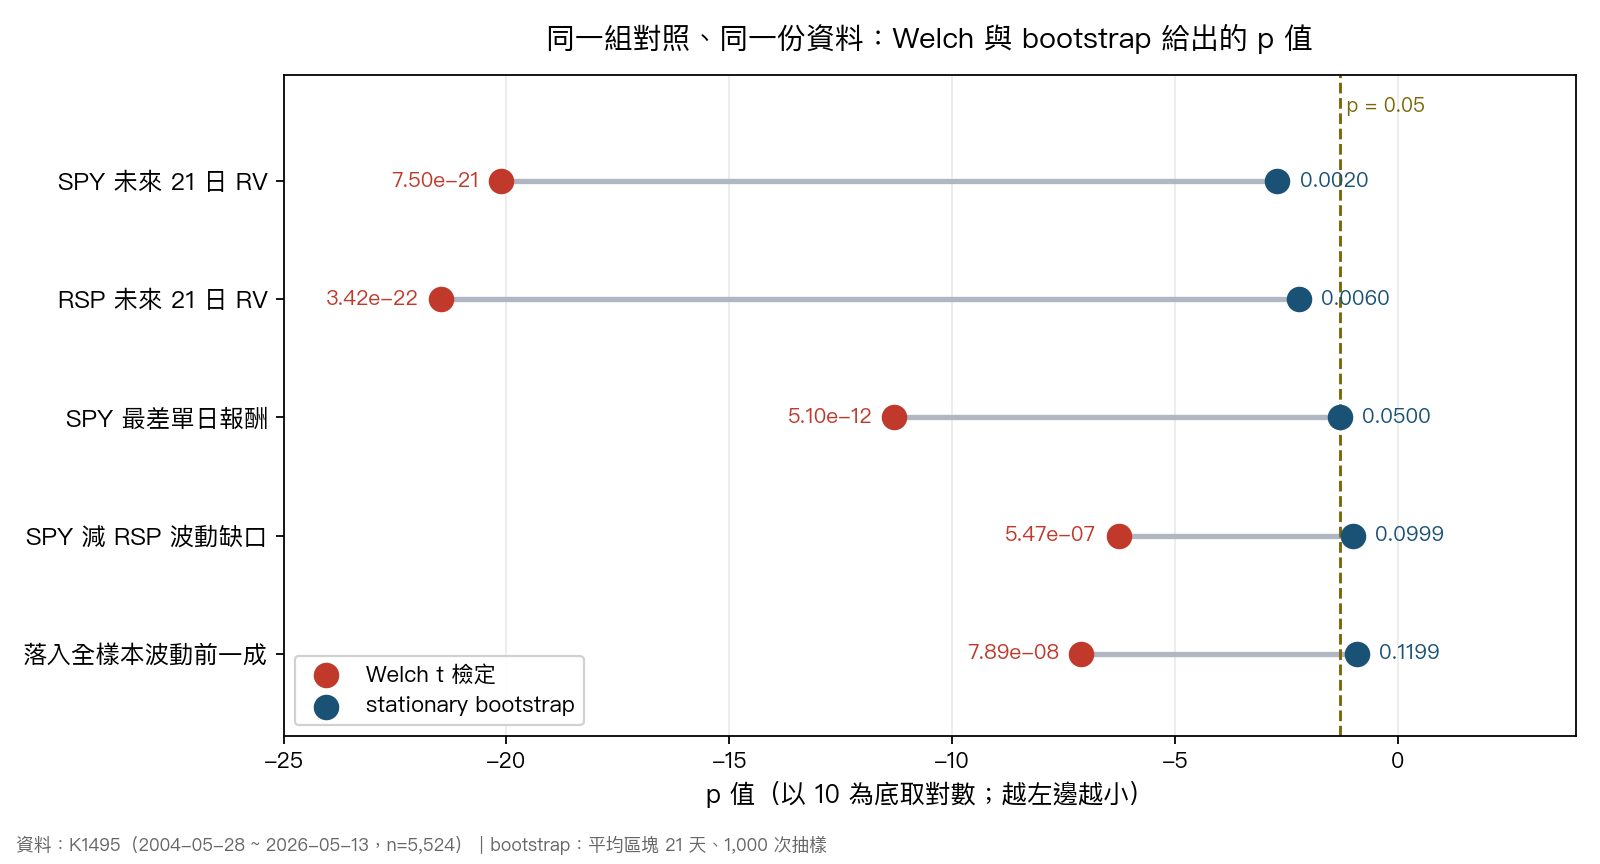
五個檢定並排,左邊是 Welch t 檢定的 p,右邊是 stationary bootstrap(平均區塊長度 21 天、1,000 次抽樣)的雙尾 p:
| 檢定 | 高 regime | 非高 regime | Welch t | Welch p | bootstrap p | bootstrap 95% 區間 |
|---|---|---|---|---|---|---|
| SPY 未來 21 日 RV | 0.1816 | 0.1441 | 9.469 | 7.50e-21 | 0.0020 | [0.0095, 0.0739] |
| RSP 未來 21 日 RV | 0.1945 | 0.1532 | 9.801 | 3.42e-22 | 0.0060 | [0.0111, 0.0806] |
| SPY 最差單日報酬 | −0.0222 | −0.0186 | −6.942 | 5.10e-12 | 0.0500 | [−0.0081, −0.0001] |
| SPY 減 RSP 波動缺口 | −0.0129 | −0.0090 | −5.020 | 5.47e-07 | 0.0999 | [−0.0083, 0.0007] |
| 落入全樣本波動前一成 | 0.1371 | 0.0850 | 5.386 | 7.89e-08 | 0.1199 | [−0.0076, 0.1327] |
左半邊看起來像五個一模一樣的結論:t 統計量的絕對值全部超過五,p 值全部小到需要用指數表示。如果只看 Welch,這五條都是「極度顯著」,沒有任何理由把它們分開對待。
右半邊把它們排成了三層:兩條穩健(0.0020、0.0060),一條在門檻上(0.0500),兩條不顯著(0.0999、0.1199)。最後兩條的 95% 區間跨過零。
Welch 對五個檢定給出一致的答案,bootstrap 給出有層次的答案。 兩者不可能都對。
為什麼 Welch 在這裡會飽和
t 檢定的標準誤是用樣本數算的,而它假設觀測彼此獨立。
這份資料的目標變數是「未來 21 天的實現波動率」。今天的目標值與明天的目標值,共用了 21 天裡的 20 天。相鄰兩個觀測不是兩份獨立的證據,是同一份證據挪了一格。5,524 個日期在日曆上是 5,524 個,在資訊量上遠遠不到。
標準誤的分母被高估,標準誤就被低估,t 統計量被推高,p 值被推低。推低的幅度不是溫和的:從 0.0020 推到 7.50e-21。
stationary bootstrap 的做法是整段整段地重抽(平均區塊長度設 21 天,剛好對上視窗長度),讓重抽出來的樣本保留原本的自相關結構。它不需要知道有效樣本數是多少,只需要不破壞它。
這件事在一般讀者版裡是以「考慮到 21 天視窗互相重疊、樣本並不獨立,我們用區塊重抽樣重算信賴區間」一句話帶過的。那句話是對的,但它沒有讓人看見代價的大小。代價的大小就是這張表的左右兩欄。
第三種方法給了同一個答案
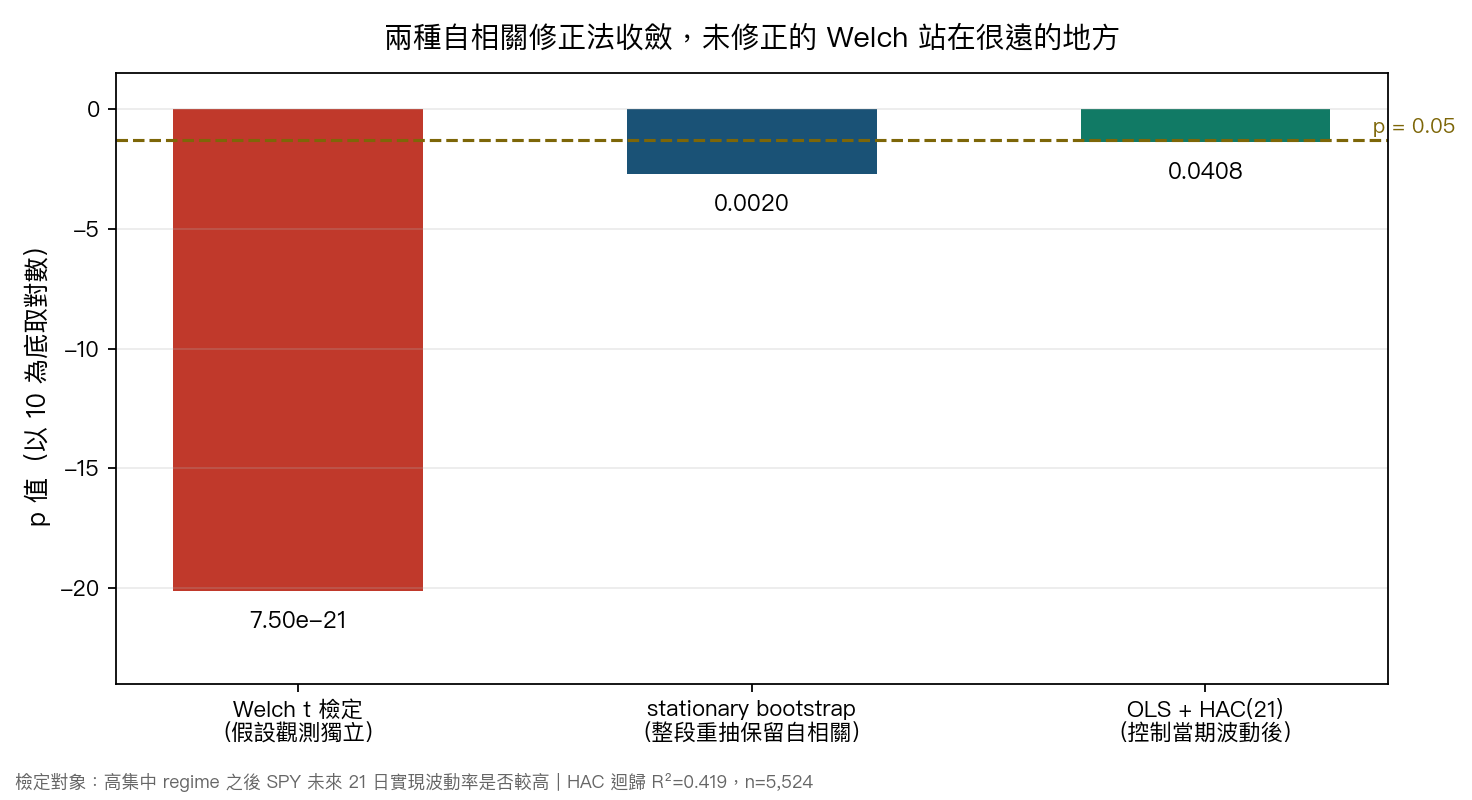
如果只有兩種方法對打,很難判斷該信誰。這份實驗還跑了第三條路:把當期 21 日波動率、集中度 pulse 本身、高 regime 標記一起放進 OLS,用 HAC(21) 修正重疊造成的殘差自相關。
高 regime 標記的係數是 0.02027,t = 2.045,p = 0.0408。
這個 p 值與 bootstrap 那一欄同級,與 Welch 差了好幾層樓。 兩種原理完全不同的自相關修正方法(區塊重抽與 HAC 標準誤)收斂到同一個量級,而未修正的 Welch 站在很遠的地方。 這是判斷該信誰的實際依據:兩個獨立的修正方式互相印證,而不是因為 bootstrap 比較新潮。
同一條迴歸還帶出一個前一篇提過但值得研究讀者再看一次的細節:集中度 pulse 當成連續變數放進去,係數是 −0.302,t = −0.942,p = 0.346,完全不顯著。有條件資訊的是「越過第 80 百分位」這個狀態,不是 pulse 的線性大小。整條迴歸的 R² 是 0.41896,而其中絕大部分來自當期波動率那一項(係數 0.6387,t = 8.276),波動的自我延續本來就是主力,regime 標記提供的是那之外的增量。
bootstrap 那一欄也不是真相
把 bootstrap 當成正確答案是這篇文章最容易被誤讀的地方,所以要寫清楚兩個限制。
第一,那些 p 值有解析度下限。抽樣次數是 1,000 次,而五個 p 值分別是 0.001998、0.005994、0.04995、0.0999、0.11988——把它們乘上 1,001,得到的是 2、6、50、100、120 這五個整數。這說明報出來的 p 是 (超出次數 + 1) / (抽樣次數 + 1) 的形式。 所以 0.0020 要當成「在 1,000 次抽樣的解析度下,它已經貼著能表達的下限」來讀 ,把它當成「機率是千分之二」會過度解讀。真值可能更小,這份實驗測不出來。(這一段的算式是我從五個數字反推的,正本裡沒有寫出公式;反推能對上五個整數,但要更確定得回去看實驗碼。)
第二,平均區塊長度 21 天是一個選擇,不是資料告訴我們的。區塊選得越長,保留的自相關越多,區間越寬、p 值越大。選 21 是因為對上目標視窗長度,這個理由是合理的,但不是唯一合理的。這份實驗沒有做區塊長度的敏感度掃描,所以「0.0999 與 0.1199 這兩條不顯著」這個判定本身,也帶著對區塊長度的依賴。
可以帶走的一條
當一份研究的目標變數是滾動視窗算出來的(未來 N 日波動率、未來 N 日報酬、任何 N 日累積量),而樣本數以「交易日」計,那麼未經修正的 t 檢定 p 值幾乎一定會小得不像話。那個數字的大小主要由視窗長度決定,效果強度只佔一小部分。
實務上的判準很簡單: 看到一個小到需要用指數表示的 p 值,先問目標變數的視窗長度是多少。 如果視窗不是只有一天,那個 p 值在被自相關修正之前不能當證據用。修正之後還活著的,才是結論——K1495 這五條裡活下來的是前三條。
資料與可複現資訊
- 對應實驗:K1495(
experiments/k1495/k1495_results.json,date_run 2026-06-14,seed 42) - 資料來源:yfinance 日調整收盤價,SPY 與 RSP,2004-05-28 至 2026-05-13,5,524 個交易日
- 集中度代理:SPY 減 RSP 的 21 日累積對數報酬差;高 regime 定義為 expanding 第 80 百分位(只用 t 以前的歷史)
- 目標:隔天起算、往後二十一個交易日的實現波動率;推論方法:Welch t 檢定、stationary bootstrap(平均區塊 21、1,000 次)、OLS 搭配 HAC(21)
- 實驗判定:PARTIAL_PASS
- 結論面的一般讀者版本:〈集中度警報響起時,等權重指數震得比大盤還兇〉
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊