波動率的「長記憶」大多是假象:市場變盤如何騙過統計模型
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
高波動之後常常還是高波動,低波動之後也常常還是低波動。看過盤的人都有這個直覺:波動會賴著不走。學術上給這個現象一個名字,叫「長記憶」。
「長記憶」的意思是,今天波動的高低,對很久以後還留著影響力,衰退得很慢。量化的方式是估一個叫 d 的參數,d 越接近 0.5,代表這種慣性越強。在日頻資料上估出來的 d 常常落在 0.4 到 0.6,看起來波動的記性很好。
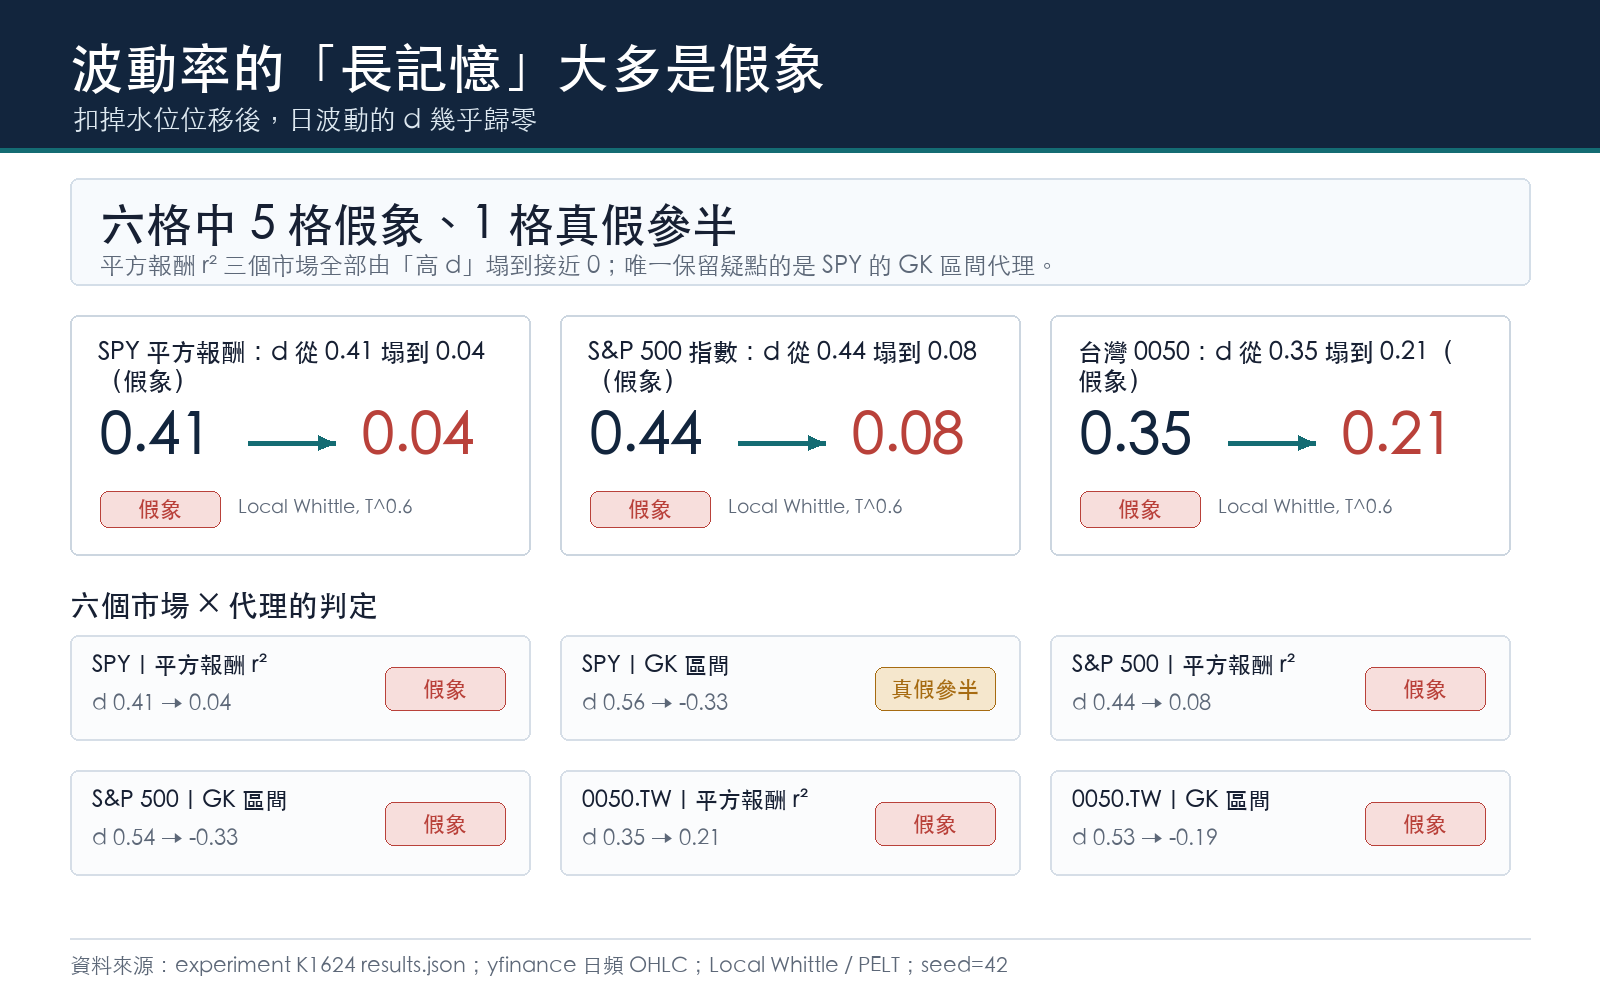
這次分析想問一件很簡單的事:這個記性是真的,還是被別的東西假裝出來的。答案偏向後者。六個「資產 × 波動代理」的格子裡,五格判定為假象,一格是真假參半。
一個長得幾乎一樣的冒牌貨
能製造出「長記憶」外觀的,不只長記憶本身。另一個機制叫「水準位移」,指的是波動的平均水位整段跳一次,然後停在新的高度一陣子。金融海嘯、COVID、升息循環,都會讓市場的常態波動水準換一個檔位。
把幾段水位不同的資料接起來,再用長記憶的尺去量,尺會誤讀。它看到資料「很久都維持在偏高的地方」,就以為是慣性造成的,其實只是中間換過幾次水位。這就像把好幾段不同海拔的路接成一條,再說「這條路一路緩慢下坡」,實際上是每隔一段就出現一個台階。
分辨這兩者,商業上跟科學上都有差。假設波動有真長記憶,就會偏好 ARFIMA 這類把分數整合寫死的模型;把它當成「短記憶加上偶爾換水位」,用的又是另一套工具。選錯,預測就建在錯的地基上。
怎麼拆穿它
流程分三步。先在三種頻寬下估出 d。再用 PELT 這個變點偵測法,找出資料裡的水位跳動點。最後把每一段的平均扣掉,重新估一次 d,記成 d(扣位移)。如果扣完之後 d 掉到 0 附近,代表那份「慣性」根本住在那幾次跳水位裡,跟長記憶無關。
下表是六個格子的結果。d 是原始估計(Local Whittle),位移數是偵測到的水位跳動次數,d(扣位移) 是扣掉每段平均後重估的值。
| 資產 | 波動代理 | d(原始) | 位移數 | d(扣位移後) | 判定 |
|---|---|---|---|---|---|
| SPY | r²(平方報酬) | 0.41 | 18 | 0.04 | 假象 |
| SPY | GK 區間 | 0.56 | 67 | -0.33 | 真假參半 |
| S&P 500 指數 | r²(平方報酬) | 0.44 | 22 | 0.08 | 假象 |
| S&P 500 指數 | GK 區間 | 0.54 | 72 | -0.33 | 假象 |
| 0050.TW | r²(平方報酬) | 0.35 | 5 | 0.21 | 假象 |
| 0050.TW | GK 區間 | 0.53 | 26 | -0.19 | 假象 |
平方報酬那一欄最乾脆:三個市場扣掉位移後 d 全部塌到 0 附近,判定假象。這正好在時間與市場兩個維度上,複製了 Granger 與 Hyung(2004)在絕對報酬代理上的發現。
假象怎麼消失的
最直接的證據,就是把水位位移扣掉之後,記性沒了。SPY 的平方報酬,d 從 0.41 掉到 0.04;S&P 500 指數本身從 0.44 掉到 0.08;台灣 0050 從 0.35 掉到 0.21。原本看起來很強的慣性,扣掉那幾次換水位就幾乎歸零。
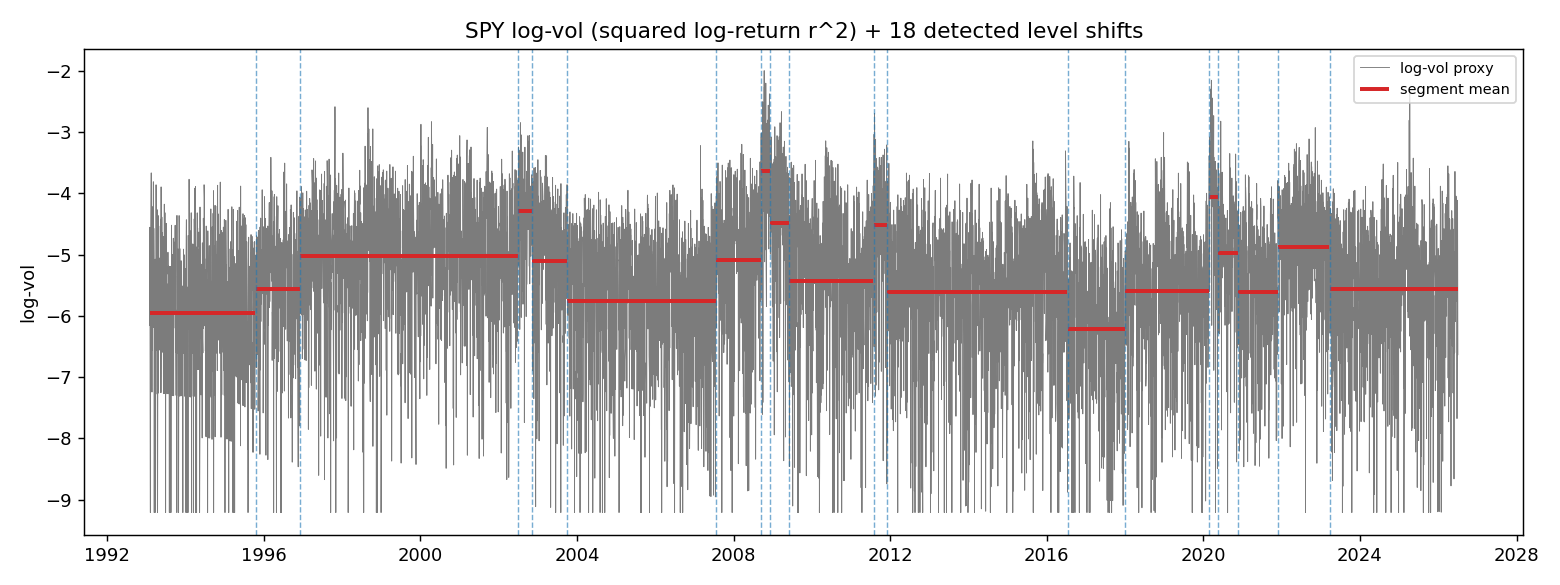
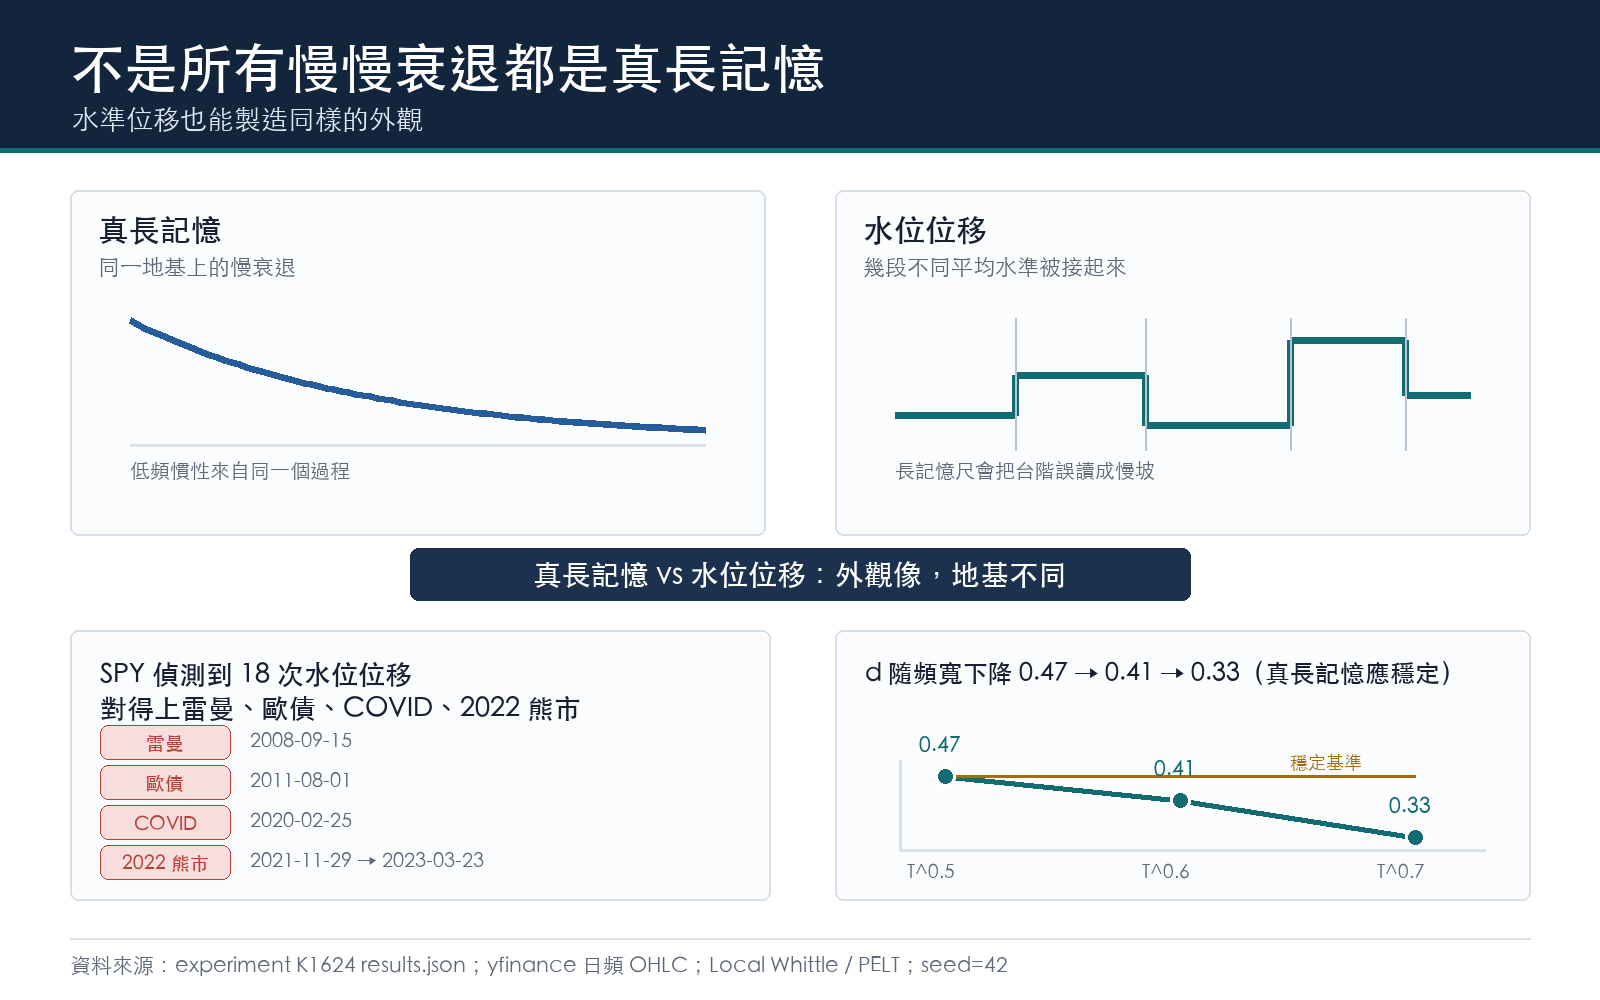
上圖把 SPY 的日波動攤開,紅色橫線是每一段的平均水位。這 18 次位移對得上真實事件:2008-09 雷曼倒閉、2011-08 歐債、2020-02 COVID 開跌、2022 熊市。整條線並沒有一路平滑衰退,而是一段一段換檔。
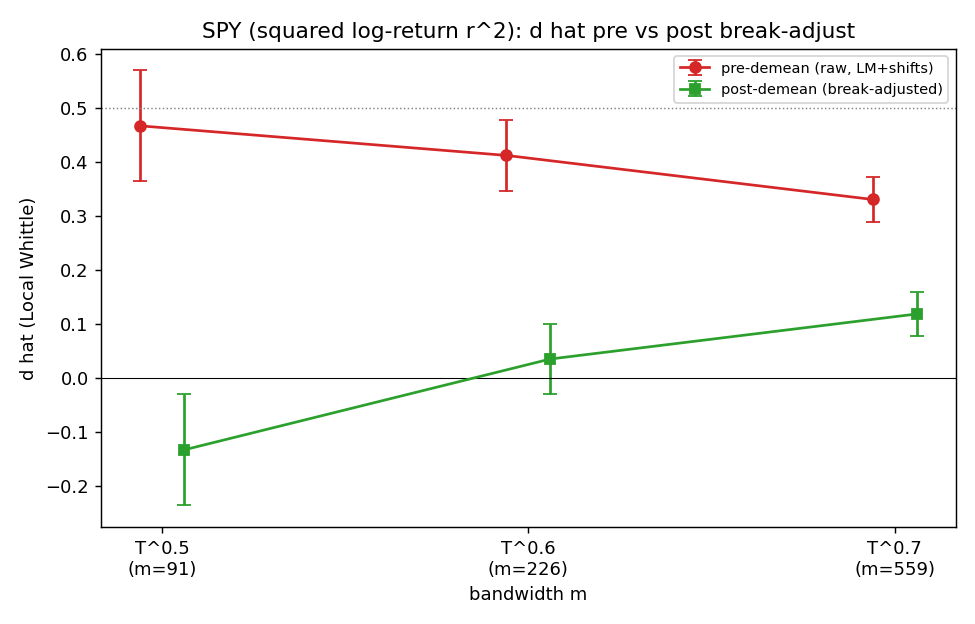
另一個招牌特徵是 d 會隨著測量頻寬變小。SPY 平方報酬的 d 在三個頻寬下是 0.47、0.41、0.33,一路往下。真長記憶的 d 應該穩定,會隨頻寬滑動的通常是假象。上圖的綠點就是扣掉位移後的 d,直接塌進 0 附近。
這次分析還加了一道保險。真長記憶的資料本身也會被變點偵測誤切,所以光看「d 掉了多少」會冤枉真長記憶。做法是拿真長記憶當對照假設,模擬 200 條路徑跑同一套流程,比對真實統計量落在哪裡。平方報酬那幾格的觀測值遠在拒絕區內,判定站得住。
拿去預測會怎樣
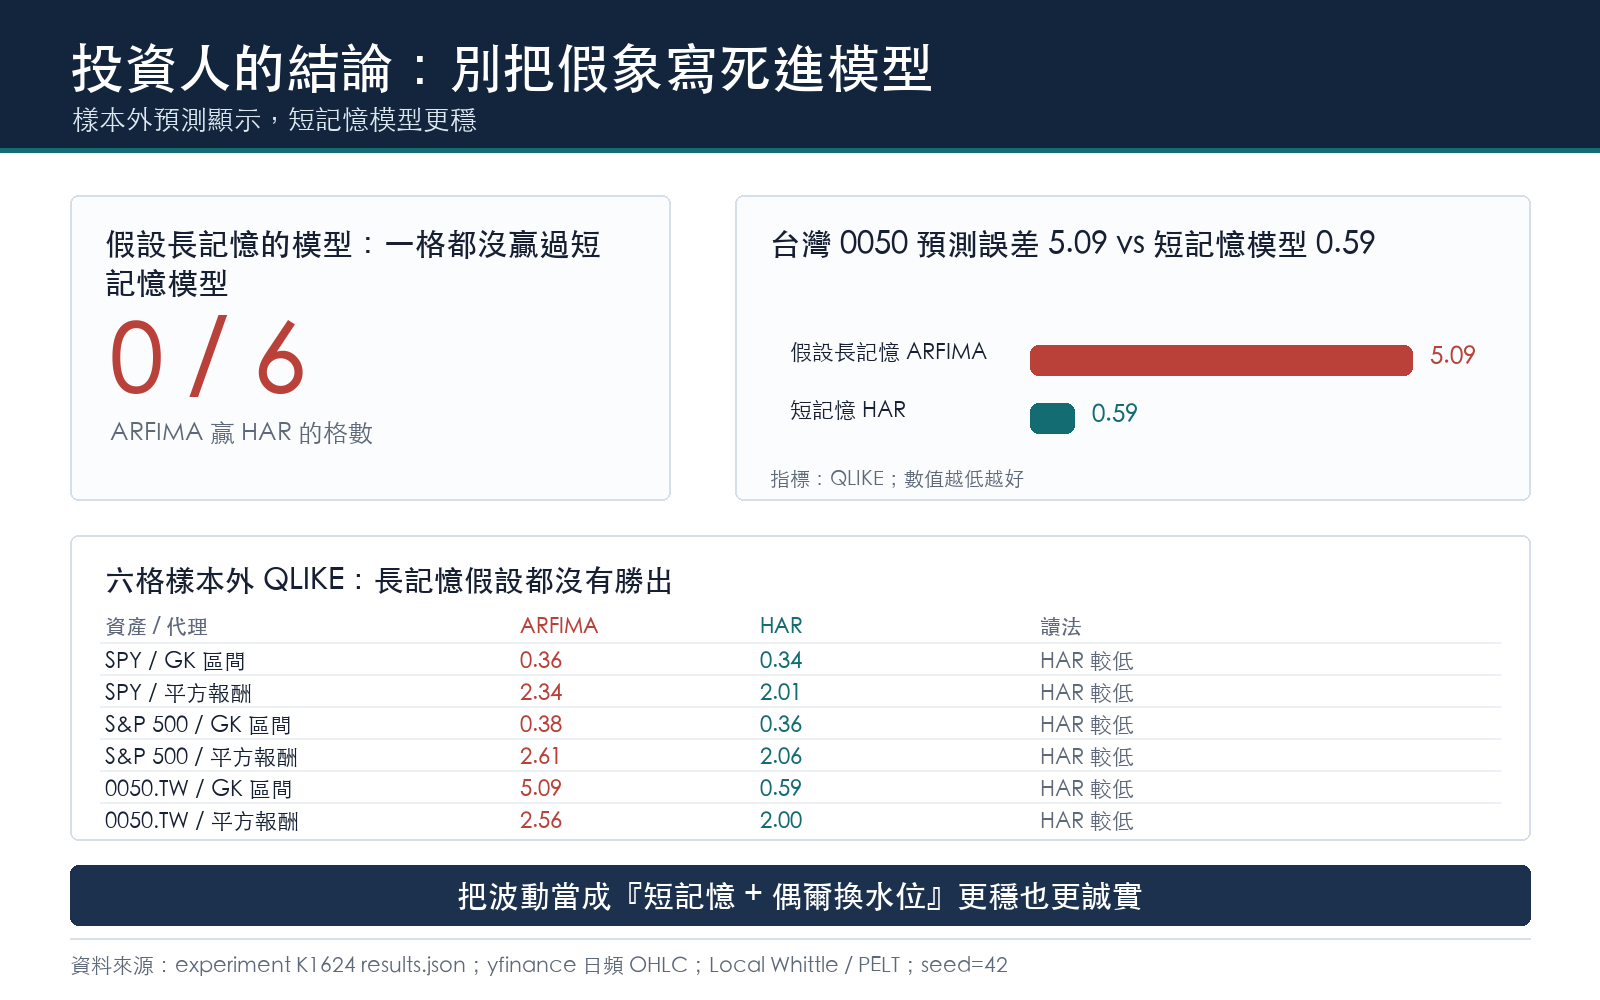
如果波動真有長記憶,用假設長記憶的模型(ARFIMA,把慣性寫死的那種)預測應該最準。這次分析用固定的樣本外視窗、逐月重估,把它跟只吃短期資訊的波動率預測模型(HAR)對打。結果假設長記憶的那個一格都沒贏過對手。在三個平方報酬格子上還顯著更差,經過嚴格的多重檢定校正後,統計強度分別是 10.7、13.2、13.3,全部遠超顯著門檻。
最誇張的是台灣 0050 的區間代理,假設長記憶那個模型的預測誤差衝到 5.09,短記憶模型只有 0.59。硬把分數整合套上去,靠近 d 等於 0.5 的邊界時,預測會偶爾爆量。結論很一致:假設波動有真長記憶去建模,買不到任何好處,還可能挨一記重傷。短記憶的 HAR 才是穩的那一個。
老實說,不是全部都假
六格裡有一格例外。SPY 的 GK 區間代理判為真假參半:扣掉位移後 d 是 -0.33,顯著高於真長記憶的虛無帶(約 -0.49),代表位移確實存在;但 Shimotsu 檢定的另外兩項沒有跟著確認,所以不能說它純粹由位移造成,還保留了一點微弱的真長記憶成分。
還要誠實交代一件事:變點偵測在真長記憶底下本來就容易多切,這是這類檢定的已知毛病,這次分析靠重抽樣模擬去校準、壓下這個偏誤。平滑一點的區間代理比較靠近判定邊界,結論的把握度不如平方報酬那幾格。正確的講法是「大多是假象」,不能簡化成「全部都是假的」。
給讀者的一句話
「這波動會持續很久」的直覺,很多時候是被少數幾次市場變盤騙出來的。真正在發生的,比較像波動水位偶爾整段換檔:平常穩定,遇到大事件跳一個檔位,再穩定一陣子。那條慢慢衰退的長記憶曲線,只是這個換檔過程投射出來的影子。
對做預測的人,這是很實際的差別。當你以為在抓一條有慣性的長記憶,其實是在追幾次換水位,套上把慣性寫死的模型就會建在流沙上。把波動當成「短記憶加上偶爾換水位」來處理,這次分析的樣本外證據顯示更穩,也更誠實。
資料來源
本文為 VolPred 內部研究(實驗代號見文章標籤)。資料為 yfinance 日頻 OHLC、收盤對收盤對數報酬,樣本涵蓋 SPY(1993 起,8,413 天)、S&P 500 指數 ^GSPC(1985 起,10,455 天)、台灣 0050.TW(2009 起,4,282 天)。兩個波動代理:平方報酬 r² 與 Garman-Klass 區間變異數。長記憶估計用對數週期圖回歸與 Local Whittle,水位位移用 PELT 變點偵測,判定經真長記憶情境的重抽樣模擬校準,隨機種子固定 42。方法上呼應 Granger 與 Hyung(2004)在絕對報酬代理上的結果。完整數字對應本文的實驗結果檔。
懶人包圖組
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊