K1696:控制 ^MOVE 之後,利差波動率的增量 t 全數落在 −1.54 到 +0.64
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
K1696:控制 ^MOVE 之後,利差波動率的增量 t 全數落在 −1.54 到 +0.64
摘要
K1696 問的是一個窄但可以被證偽的問題:10 年-2 年公債利差 自己的已實現波動率 ,在 ^MOVE 之外還有沒有剩餘的預測力?
實驗把 TSV21 定義為利差日變動的 21 日年化標準差,套進 SPY、HYG、IWM 三檔資產與 h ∈ {1, 21, 63} 三個 horizon,共 9 格。每一格都跑四個模型:AR(1) 基準(M0)、只加 TSV21(M1)、只加 log MOVE(M2)、兩個都加的 nested 模型(M3)。
結果是 NULL,而且 verdict_scope 明寫 in_sample_only。M1 單變量最強的一格是 SPY h=1 的 t = +1.93,沒有跨過預先登記的 2.0 門檻;放進 M3 之後,TSV21 的 HAC t 全部落在 −1.54 到 +0.64 之間,多數還翻了號。verdict_counts 是 cells 9、n_m1_sig 0、n_m3_positive 0、n_m3_subsumed 9。
樣本外沒有跟上一句對稱的結論,因為這裡缺一把可用的尺。M3 對 M2、M3 對 M0、M2 對 M0、M1 對 M0 四組都是 nested 配對,在擴張窗 + QLIKE 的組合下沒有有效的檢定程序(見第四節),oos_incremental_status 因此記為 INCONCLUSIVE_NO_VALID_EXPANDING_WINDOW_QLIKE_NESTED_TEST,那四組統計量只留作方向性診斷。
唯一做得成推論的是非巢狀的 M1_vs_M2 家族。9 格一起做 Holm-Bonferroni(FWER 0.05),2 格顯著,兩格都在 h=1:SPY 的 t = −3.680(p_holm = 0.001978)、HYG 的 t = −3.916(p_holm = 0.000848)。負號代表只放 TSV21 的 M1 損失低於只放 log MOVE 的 M2。這個家族在 JSON 裡標成 inference_role = secondary_oos_inference、feeds_verdict = false,不改變 NULL。
Codex gpt-5.6-sol xhigh(fresh independent)於 2026-09-01T15:30:30Z 覆核,verdict PASS,blocking defects 0。
一、為什麼會想問這件事
殖利率曲線的 水準 是教科書級的領先指標(Estrella & Hardouvelis 1991, doi:10.1111/j.1540-6261.1991.tb02674.x)。曲線的 形狀變化速度 則少有人拿來當波動率預測因子。
直覺是這樣走的:當 10y-2y 利差每天大幅跳動,代表市場對 Fed 路徑或衰退機率正在快速重新定價。這種宏觀重定價照理會外溢到股票、高收益債與小型股的變異數。
問題在於,債券市場已經有一個現成的、直接的隱含波動率指數:^MOVE。若 TSV21 想成立為獨立因子,它必須在 MOVE 之上還有東西。K1696 把這句話寫成 nested 檢定,而不留在敘事層。
VolPred 過去的 K1488 已經確認 MOVE 對 SPY 波動率有領先性,K1054 處理 MOVE 與 VIX 在降息路徑上的外溢。K1696 補的是另一個軸:曲線形狀的抖動,是不是 MOVE 之外的第二條管道。
二、資料與模型設定
| 項目 | 設定 |
|---|---|
| 利差 | FRED DGS10 − DGS2,2006-01-03 → 2026-08-06,共 5,153 個交易日 |
| 價格序列 | 2003-01-02 → 2026-08-07 |
| TSV21 | 利差日變動的 21 日標準差 × √252 |
| 目標 | 前瞻 (t, t+h] 的年化已實現變異數,取 log 後迴歸 |
| 資產 | SPY、HYG、IWM,各自獨立估計,不做跨資產 pooling |
| horizon | h = 1, 21, 63 |
| 基準 | M0:常數 + 落後已實現變異數(log_rv) |
| 對照 | M1 = M0 + TSV21;M2 = M0 + log MOVE;M3 = M0 + log MOVE + TSV21 |
| 迴歸標準誤 | Newey-West,bandwidth = max(NW rule, ⌈1.5h⌉);實際落在 h=1 用 6–7、h=21 用 32、h=63 用 95 |
| 樣本外 | 擴張視窗,訓練列須滿足 j+h < i |
| 損失 | QLIKE = actual/pred − log(actual/pred) − 1 |
| DM bandwidth | canonical floor = max(h−1, canonical automatic lag),floor 之後只受 n−1 的數學上限,再乘 HLN 小樣本修正 |
| OOS 推論角色 | nested(M1_vs_M0、M2_vs_M0、M3_vs_M0、M3_vs_M2)= diagnostic-only;non-nested(M1_vs_M2)= secondary |
九格的迴歸樣本數落在 1,065 到 1,790 之間,樣本外評估日數落在 813 到 1,538 之間。三檔資產的可得期間不同,各自獨立建 panel。
所有預測變數在合併前都做過 .shift(1),前瞻標的嚴格只用 (t, t+h] 視窗。這兩件事在主程式跑之前先用 toy data 做過單元測試。
三、樣本內:控制 MOVE 之後,訊號塌掉
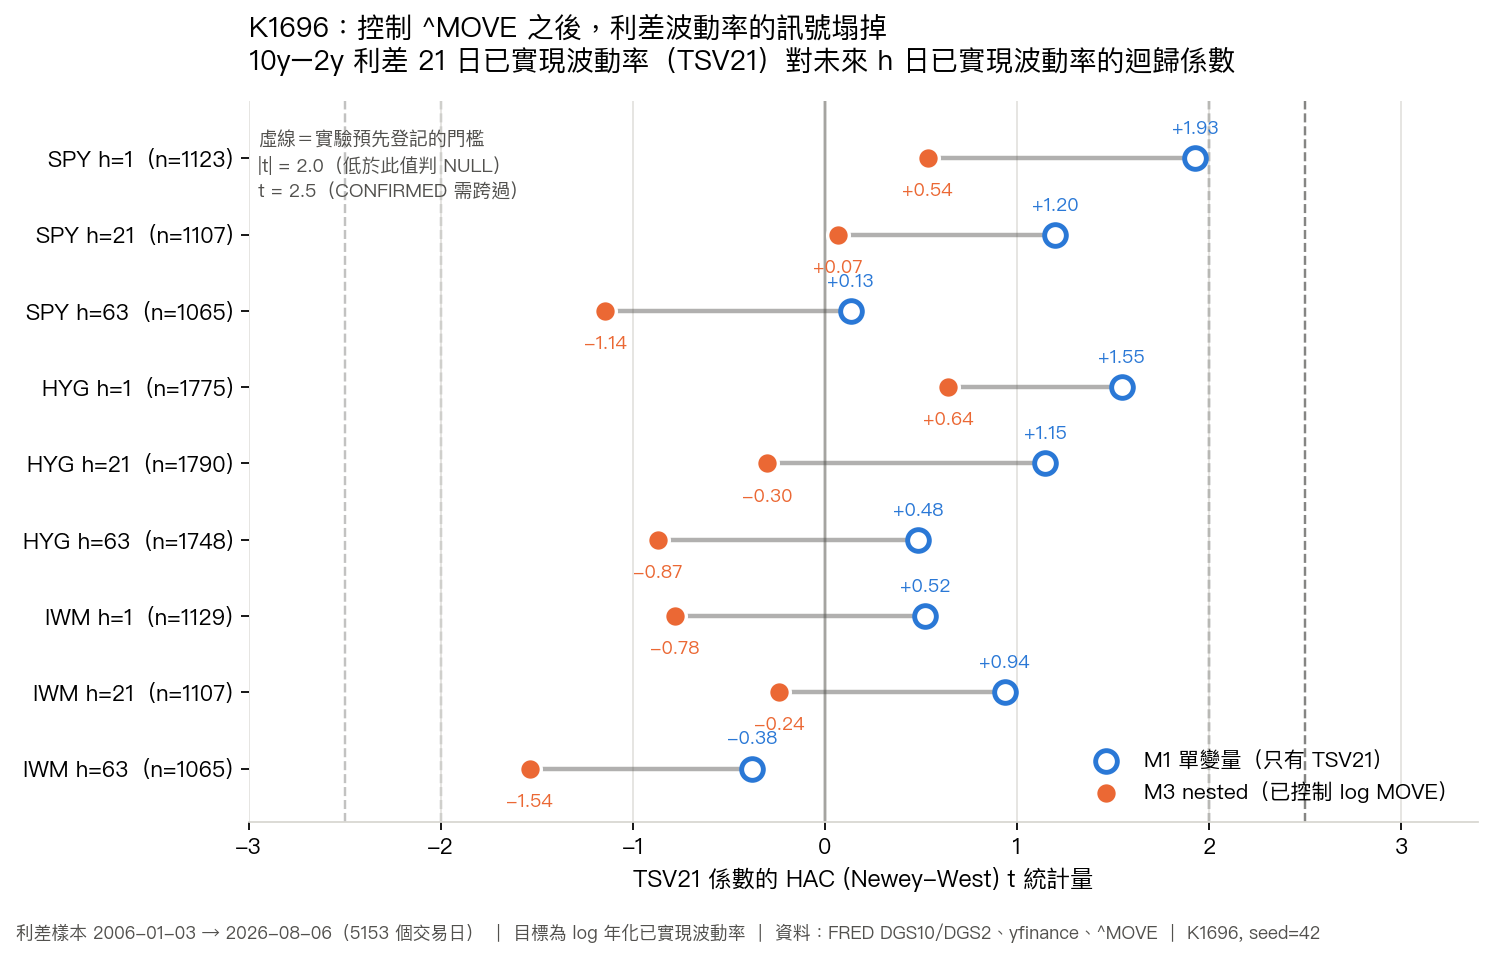
| Cell | n | TSV21 t(M1 單變量) | TSV21 t(M3 nested) | log MOVE t(M3) |
|---|---|---|---|---|
| SPY h=1 | 1123 | +1.93 | +0.54 | +2.12 |
| SPY h=21 | 1107 | +1.20 | +0.07 | +1.71 |
| SPY h=63 | 1065 | +0.13 | −1.14 | +2.10 |
| HYG h=1 | 1775 | +1.55 | +0.64 | +2.36 |
| HYG h=21 | 1790 | +1.15 | −0.30 | +2.89 |
| HYG h=63 | 1748 | +0.48 | −0.87 | +2.20 |
| IWM h=1 | 1129 | +0.52 | −0.78 | +2.55 |
| IWM h=21 | 1107 | +0.94 | −0.24 | +2.03 |
| IWM h=63 | 1065 | −0.38 | −1.54 | +2.48 |
圖上每一條橫線就是 MOVE 吃掉的量。空心圓是 TSV21 單獨進場的 t,實心圓是同一格加進 log MOVE 之後的 t,九條線全部往左收。
SPY h=1 從 +1.93 掉到 +0.54,HYG h=1 從 +1.55 掉到 +0.64。M1 裡唯一為負的是 IWM h=63;控制 MOVE 之後,SPY h=63、HYG h=21、HYG h=63、IWM h=1、IWM h=21 全部翻成負值。
同一張表的最右欄是 MOVE 自己的 t:9 格有 8 格超過 2.0,只有 SPY h=21 的 +1.71 例外。同一組迴歸裡,一個變數穩定顯著、另一個穩定塌陷,這比單看 TSV21 的 p 值更能說明誰是主導變數。
判定門檻在跑資料之前就寫死了,而且只吃樣本內的 nested HAC t:NULL 的條件是 n_m3_positive == 0 且 n_m1_sig == 0;CONFIRMED 要求 M3 裡至少一格的 TSV21 單尾 t > 2.5 且沒有任何一格 subsumed;SUBSUMED_BY_MOVE 要求 M3 每一格的 |t| < 2.0 且單變量至少有一格顯著。verdict_definitions._inputs 明寫沒有任何 OOS DM 統計量進入任何一層。
這份資料的 n_m1_sig = 0,所以 SUBSUMED_BY_MOVE 的條件其實不成立(它要求單變量有證據),落點就是 NULL:訊號本來就弱,而且在控制 MOVE 之後每一格都低於 2.0。
R² 的增量說同一件事。SPY h=1 從 M2 的 0.0604 加到 M3 的 0.0607,HYG h=21 從 0.5762 到 0.5764。以 1,100 到 1,800 筆樣本的規模,這種第四位小數的增益沒有解釋意義。
唯一看起來像有東西的是 IWM h=63:R² 從 0.3344 跳到 0.3639。但那一格的 TSV21 係數是 −0.859,t = −1.54,方向與「曲線抖動預告更高波動率」的假說相反。
四、樣本外:先講為什麼少了一把尺
想問的問題是「在 M2 之上加 TSV21,樣本外 QLIKE 會不會下降」。這個問題在本設計下沒有有效的檢定程序,理由寫在 $.methods.nested_qlike_policy:
- M2 ⊂ M3。在 nested 的虛無假設下兩個模型的預測重合,但大模型仍然在估一個真值為零的多餘係數,參數估計噪音會進到 loss differential,普通 DM/HLN 的虛無分布因此非標準。HLN 因子做的是小樣本 rescale,它修不了 nesting。
- Clark-West 是為 MSPE 推導的;本實驗報的損失是 QLIKE,CW 的調整項在這個一般損失下沒有經過驗證的對應物。
- Giacomini-White 要求固定估計記憶的 rolling scheme;本實驗的 refit 是擴張窗。
實驗採的處置是 choice = a_remove_from_formal_verdict、formal_nested_test = not_performed。四組 nested 配對(M1_vs_M0、M2_vs_M0、M3_vs_M0、M3_vs_M2)搬進 dm_qlike_nested_diagnostics,欄位名就叫 hln_scaled_t_diagnostic,同層的 inferential_p_value 是 null、valid_nested_null_inference 是 false。
下表因此只能當方向性讀數:
| Cell | n_eval | M2 QLIKE | M3 QLIKE | M3_vs_M2 診斷 t | DM floor lag |
|---|---|---|---|---|---|
| SPY h=1 | 871 | 4.5346 | 4.5751 | +0.486 | 10 |
| SPY h=21 | 855 | 0.3254 | 0.3857 | +1.687 | 27 |
| SPY h=63 | 813 | 0.3257 | 0.5192 | +1.179 | 62 |
| HYG h=1 | 1523 | 4.6159 | 4.5996 | −0.323 | 12 |
| HYG h=21 | 1538 | 1.3423 | 1.4058 | +1.487 | 32 |
| HYG h=63 | 1496 | 1.5857 | 1.4972 | −1.074 | 62 |
| IWM h=1 | 877 | 3.0847 | 3.2777 | +2.645 | 10 |
| IWM h=21 | 855 | 0.2691 | 0.3162 | +1.818 | 27 |
| IWM h=63 | 813 | 0.2870 | 0.4221 | +1.157 | 62 |
七格的 M3 平均 QLIKE 高於 M2,兩格較低(HYG h=1、HYG h=63)。同樣的排法,M1 對 M0 有八格較高,唯一較低的是 HYG h=1(4.2770 → 4.2671)。這兩個計數是損失層級的描述,不附任何 p 值;IWM h=1 那個 +2.645 沒有「跨過 1.96」的意思,因為這裡沒有可用的 1.96。
這一節與本文的早期版本有一處必須點名的差異:早期版本把 M3_vs_M2 的 DM-HLN 當成正式檢定,用它宣告「加了 TSV21 之後顯著較差」。那個推論身分已被撤回:verdict_definitions._retired.NULL_OOS 記著「Retired 2026-09-01」,處置是 choice = a_remove_from_formal_verdict,統計量本身也因為 DM bandwidth 改採 canonical floor 而重算。上表的九個值取自現行 canonical JSON,身分是診斷,以本文為準。
五、唯一的樣本外推論:非巢狀的 M1_vs_M2
M1 與 M2 互不包含,nesting 的問題不存在,DM/HLN 的常態近似可以用。實驗把 9 格當成一個家族,交給 volpred.stats.inference.holm_step_down 做 Holm-Bonferroni step-down,FWER 0.05、n_tests 9。
| Cell | t(M1 vs M2) | p_raw | p_holm | Holm 0.05 |
|---|---|---|---|---|
| HYG h=1 | −3.916 | 0.0000942 | 0.000848 | 顯著 |
| SPY h=1 | −3.680 | 0.000247 | 0.001978 | 顯著 |
| IWM h=1 | −1.961 | 0.0501 | 0.351 | 不顯著 |
| IWM h=21 | +1.711 | 0.0874 | 0.524 | 不顯著 |
| SPY h=21 | +1.611 | 0.1075 | 0.538 | 不顯著 |
| SPY h=63 | +1.067 | 0.2865 | 1.0 | 不顯著 |
| IWM h=63 | +1.005 | 0.3154 | 1.0 | 不顯著 |
| HYG h=21 | −0.897 | 0.3699 | 1.0 | 不顯著 |
| HYG h=63 | −0.557 | 0.5773 | 1.0 | 不顯著 |
n_significant_holm_0p05 = 2,n_significant_raw_0p05 也是 2:Holm 在這裡沒有殺掉任何原本顯著的格,兩格的 raw p 都遠低於 0.05/9。
方向的讀法固定在 loss_differential_definition = QLIKE_first_minus_QLIKE_second,direction.negative_t = first_model_lower_loss。M1 排在前面,所以負 t = M1 的 QLIKE 較低。交叉驗證:SPY h=1 的 M1 平均 QLIKE 是 4.0677、M2 是 4.5346;HYG h=1 是 4.2671 對 4.6159。兩格都與 t 的符號一致。
這句話能講到哪裡,必須講死。
它說的是:在 h=1、SPY 與 HYG 兩格,「只加 TSV21」的模型樣本外 QLIKE 低於「只加 log MOVE」的模型。這是兩個非巢狀對手的相對比較。
它不說 TSV21 有預測力。M1 對 M0 那一欄,九格有八格的 M1 平均 QLIKE 更高,只加 TSV21 相對於什麼都不加,多數格是往上走的。贏過 M2 與贏過 M0 是兩件事,這份資料只支持前者,而且前者本身也已被 remediation 限定為 secondary。
它也不跨 horizon。h=21 與 h=63 的六格 p_holm 從 0.524 到 1.0,全部不顯著,而且四格的 t 還是正號(M2 損失較低)。IWM h=1 的 p_raw = 0.0501 卡在門檻邊,Holm 之後 0.351,不能算。
5.1 bandwidth 敏感度:真正站得住的是一格
lag_sensitivity 對同一家族跑了五個 bandwidth 情境:legacy_h_minus_1、canonical_helper、canonical_floor、two_x_canonical_floor、four_x_canonical_floor。
| 情境 | SPY h=1 t / p_holm | HYG h=1 t / p_holm | Holm 顯著格 |
|---|---|---|---|
| legacy_h_minus_1(bw 1) | −5.141 / 0.0000027 | −5.498 / 0.00000041 | SPY、HYG、IWM |
| canonical_helper(bw 10 / 12) | −3.680 / 0.001978 | −3.916 / 0.000848 | SPY、HYG |
| canonical_floor(bw 10 / 12) | −3.680 / 0.001978 | −3.916 / 0.000848 | SPY、HYG |
| two_x_canonical_floor(bw 20 / 24) | −3.245 / 0.009741 | −3.627 / 0.002667 | SPY、HYG |
| four_x_canonical_floor(bw 40 / 48) | −2.709 / 0.055043 | −3.212 / 0.012099 | HYG |
stable_significant_cells_across_all_scenarios 只有 HYG_h1。cells_with_holm_decision_flip 是 IWM_h1 與 SPY_h1。JSON 自己寫了 claim_policy:只有五個情境都成立的格能撐起 lag-robust 的 secondary OOS 主張,翻轉的格降級成對 bandwidth 敏感的診斷。
照這條政策,能寫進結論的是一格——HYG h=1。SPY h=1 在 baseline bandwidth 下顯著,但 bandwidth 拉到四倍時 p_holm 走到 0.055,屬於降級的那一類。這一段之所以要寫出來,是因為只報 baseline 的 2/9 會讓讀者高估這件事的穩固程度。
六、防呆與外部覆核
| 檢查項 | 狀態 |
|---|---|
所有預測變數 .shift(1) | 在 build_panel() 強制 |
| 前瞻標的嚴格用 (t, t+h] | 主程式前以 toy data 單元測試驗過 |
| OOS 訓練列 j+h < i | 在 oos_expanding() 強制 |
| seed = 42 | np.random.seed 與 default_rng 都設 |
| 三檔資產不 pool 成 iid | 各自獨立 panel 與檢定 |
| QLIKE 方向 | 委派 volpred.stats.model_evaluation.qlike_pointwise |
| 迴歸 HAC bandwidth ≥ ⌈1.5h⌉ | h=1 用 6–7、h=21 用 32、h=63 用 95 |
| DM bandwidth 不被 n//4 截短 | floor 之後只留 n−1 的數學上限 |
| nested DM 不得餵 verdict | verdict_definitions._inputs 只吃樣本內 t,並有 OOS poison 負向控制 |
| Holm 委派 canonical helper | volpred.stats.inference.holm_step_down |
Codex gpt-5.6-sol xhigh(fresh independent)在 2026-09-01T15:30:30Z 給出 PASS,blocking_defects 為空陣列,覆核紀錄在 experiments/K1696/review_k1696_remediation_codex_20260901.md,裁決檔把 9 個產物的 sha256 逐一釘死。
2026-09-02 的 experiments/K1696/remediation_20260902.md 另外做了一次重跑比對:8,602 個數值葉節點逐一相同、零差異,兩張圖的 bytes 完全一致,certify PASS,裁決仍然綁定成立。
驗證 NULL 的實驗特別需要這一層。當結論是「什麼都沒有」,最可能的替代解釋是程式寫錯而不是世界如此;把 lookahead、損失函數方向、bandwidth 三件事鎖死,才輪得到談經濟意義。第四節那條「拒絕做一個做不成的檢定」的決定,屬於同一類自律。
七、這個 null 能講到多遠
先說不能講的。K1696 沒有證明利差波動率無用。它證明的是:在這段日頻資料、三檔美股 ETF、三個 horizon、線性模型、且已經控制 log MOVE 的條件下,TSV21 的增量係數在樣本內與零無異。
scope_limitations 有三條,逐條照抄意思:
- 四組 nested 配對的 OOS DM/HLN 是 diagnostic-only。擴張窗 + 一般損失(QLIKE)沒有有效的 nested 推論程序,那些統計量沒有 p 值解釋,沒有任何顯著性主張建立在上面。因此這是一份樣本內 nested-HAC 裁決,樣本外證據是描述性的。
- NBER 衰退期認定(USREC)沒有拉,
storage/macro也沒有快照,衰退期的 lead/lag 分析留給後續。 - 迴歸表測的是 TSV21。TSV63 只出現在時間序列圖,沒有任何係數或預測比較的主張。
再補幾個沒測到的方向:資產只有三檔,加 TLT 或 VXX 會補上利率與 vol-of-vol 兩個角落。頻率只有日頻,週頻或月頻的慢速外溢沒有排除。非線性設定(例如以利差絕對值分 regime)也還沒碰。
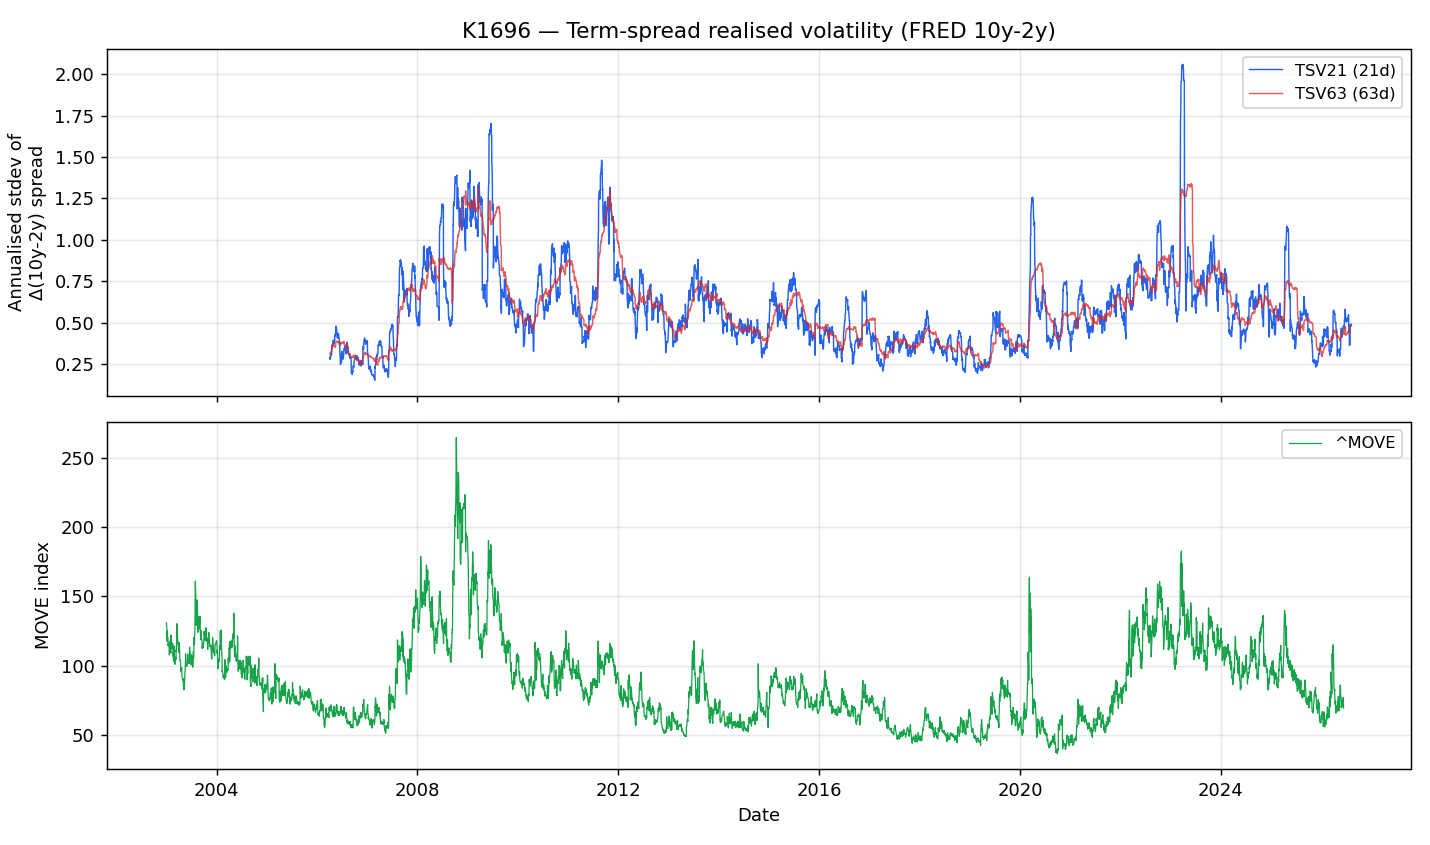
時間序列圖上,TSV21 與 MOVE 在 2008–2009、2020 與 2022–2023 三段同時放大,但兩條線的最高點不在同一年:MOVE 的峰在 2008–2009,TSV21 的峰在 2023。
共同驅動力顯然存在,只是 MOVE 把它表達得更完整。nested 迴歸的塌陷與這張圖看到的重疊是同一件事的兩種呈現。
八、實務上的一句話
相關但被涵蓋的宏觀變數,最容易通過「看起來有道理」這道門檻。K1696 的用途是把這一類候選人擋在門外,而且是用預先寫好的門檻擋,不是事後看 p 值決定。
第二個用途比第一個更難學:當一個比較沒有有效的檢定程序時,正確的動作是把它記成 INCONCLUSIVE 並降級成診斷,而不是拿一個分布不對的統計量硬報 p 值。這篇的舊版就是這樣寫的,remediation 把它撤掉了。撤掉之後結論沒有變弱——verdict 本來就只吃樣本內的 t——變弱的只有原本不該有的那份把握。
九、可重現
uv run python experiments/K1696/K1696.py
腳本 deterministic,seed = 42。所有估計值、t 統計、DM 診斷、Holm 家族與樣本數都在 experiments/K1696/K1696_results.json;README 由 render_readme(result) 全量生成,不手改。本文引用的每個數字都取自該 JSON 的具名節點。
第三節的圖由 storage/article_charts/k1696_research/gen_k1696_research_charts.py 產生,執行時直接讀該 JSON。舊版第四節那張 OOS DM t 統計圖已移除:它把 nested 配對畫上 ±1.96 門檻,屬於被撤回的推論身分。
資料來源:FRED DGS10/DGS2(利差)、SPY/HYG/IWM 調整後收盤、^MOVE 指數收盤,來源檔的 sha256 記在 input_provenance.declared_sha256。方法引用:Diebold & Mariano 1995(doi:10.1080/07350015.1995.10524599)、Harvey, Leybourne & Newbold 1997(doi:10.1016/S0169-2070(96)00719-4)、Giacomini & White 2006(doi:10.1111/j.1468-0262.2006.00718.x)、Clark & West 2007(doi:10.1016/j.jeconom.2006.05.023)。實驗代號 K1696,原始代號 K1544,2026-07-12 因 K-id 衝突改號,研究結果未變。
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊