同一組預測,兩個檢定給出相反的顯著結論——巢狀模型為什麼不能用 DM
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
K1719 問的是一個結構清楚的問題:亞洲六個市場的波動預測,加進「前一個當地交易日的上游市場資訊」之後會不會變準。上游的定義按時區排成階梯,日本收在最上游(基準模型不含任何外部市場,階梯版加進 SPY 與 VIX),台灣的階梯版加進日本,東南亞四個市場的階梯版再加進台灣。
結論那一面已有一篇給一般讀者的版本(〈隔夜美股的震盪,真會傳染給亞洲嗎?二十年數字只認一個市場〉)。這一篇只談那份結果裡的一件方法論的事,因為它在日本那一列表現得特別乾淨。
同一組預測,兩個檢定吵起來
| 市場 | QLIKE 改善 | Clark-West t | DM t | DM 雙尾顯著性 |
|---|---|---|---|---|
| 日本 | +7.6693 | 11.5883 | −2.0557 | 0.0399 |
| 印尼 | +0.0986 | 0.3242 | −0.2582 | 0.7963 |
| 新加坡 | −0.4534 | 0.1381 | 0.8164 | 0.4143 |
| 台灣 | −0.6563 | 0.2733 | 1.6050 | 0.1086 |
| 泰國 | −0.2565 | −0.1760 | 0.7130 | 0.4759 |
| 馬來西亞 | −0.2272 | −0.2784 | 0.5025 | 0.6154 |
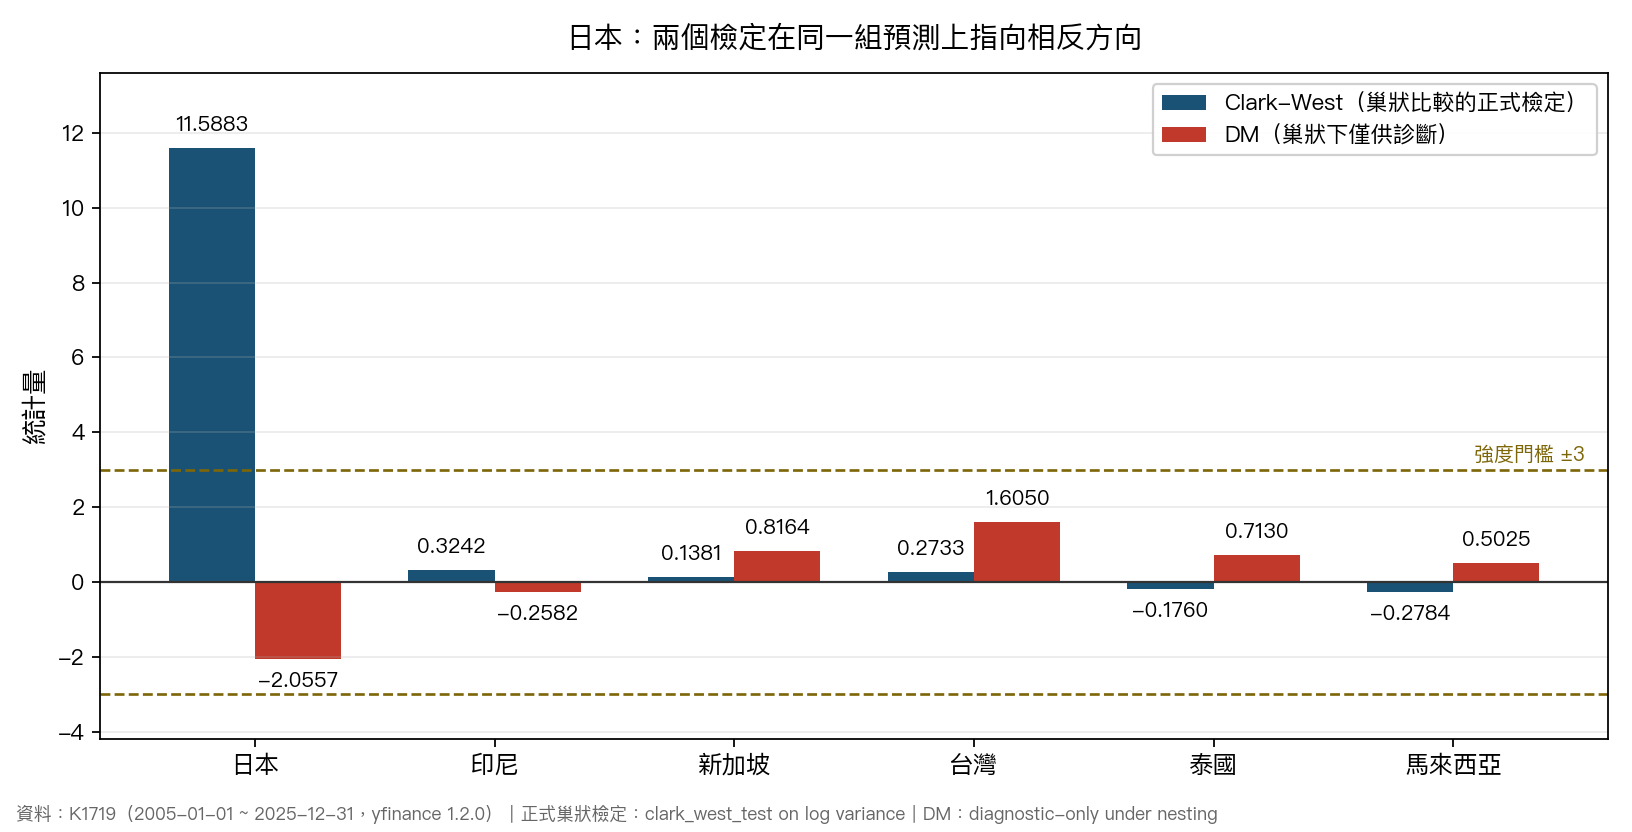
看日本那一列。Clark-West 統計量 11.5883,單尾顯著性小到需要用指數表示(表格後的資料段有精確值),這是壓倒性支持「加了 SPY 與 VIX 的大模型有增量預測資訊」。同一組預測、同一段樣本、同一個目標,Diebold-Mariano 統計量是 −2.0557,雙尾顯著性 0.0399, 在常用門檻下也算顯著,方向卻是反的 。
如果只看 DM,結論會是「加上游資訊讓日本的預測變差了,而且統計上站得住」。如果只看 Clark-West,結論會是「增量資訊強得驚人」。同時看 QLIKE 又會發現階梯版改善了 7.6693——實際的預測誤差是降低的。
這不是矛盾,是巢狀比較的已知性質
三個結論指向兩個方向,但真正該被丟掉的只有 DM 那一個。
關鍵在於這兩個模型是 巢狀 的:階梯版包含基準版的全部項,再多加幾項。在「多加的那幾項其實沒有預測力」這個虛無假設下,大模型仍然要花樣本去估那幾個係數,估計誤差會讓它的樣本外均方誤差 比小模型還大 。所以 DM 統計量在虛無下不是以零為中心,它系統性地偏向小模型。用它做巢狀比較,會把本來有增量的模型判成沒有,甚至判成顯著更差。
Clark-West (2007) 的做法是在損失差裡加一個調整項,把上述估計誤差的期望值扣掉,讓統計量在虛無下回到以零為中心。所以巢狀比較要看它,不看 DM。
這份實驗自己就是這樣標的:正本裡 DM 那一欄註明「在巢狀情況下僅供診斷」,正式的巢狀檢定寫的是 Clark-West。 這一列不是實驗出錯留下的髒數字,是刻意留著的對照組 ,而它剛好構成一個很乾淨的教學案例:在增量資訊最強的那個市場上,DM 錯得最明顯。
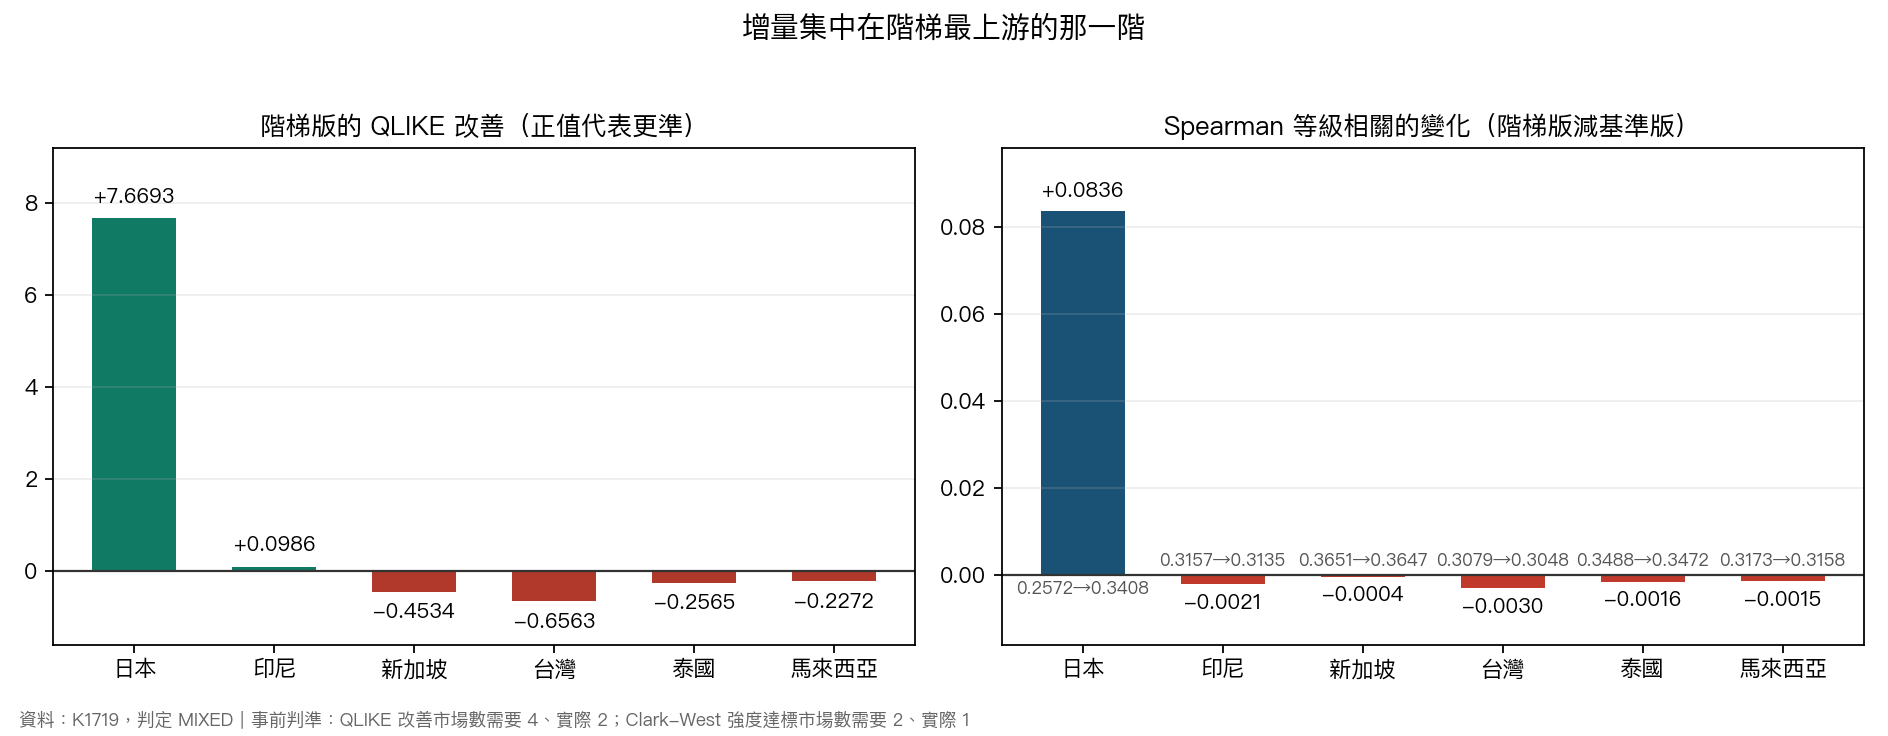
值得一提的是,DM 判日本「顯著變差」而 QLIKE 顯示階梯版實際更準,這兩件事之間沒有衝突——DM 用的是均方誤差、QLIKE 是另一個損失函數,而且 DM 的偏誤方向本來就會壓低大模型。日本的 Spearman 等級相關也支持階梯版:基準版 0.2572,階梯版 0.3408,是六個市場裡唯一明顯上升的。其餘五個市場的階梯版等級相關都是小幅下降。
事前訂死四項判準,事後一項都沒放寬
日本那一列的證據很強。研究誠實在這種時候才會被考驗:要不要把「日本成功」寫成整份實驗的結論?
這份實驗事前訂了四項成功判準,事後的實際值是:
| 判準 | 要求 | 實際 |
|---|---|---|
| QLIKE 改善的市場數 | 4 | 2 |
| Clark-West 統計量絕對值超過 3 的市場數 | 2 | 1 |
| 東南亞面板的 Clark-West 統計量絕對值超過 3 | 需要 | 否 |
| 整體判定 | 通過 | 未通過 |
東南亞四個市場合起來做的面板檢定,Clark-West 統計量 0.1843,雙尾顯著性 0.8538,樣本 3,567 筆,完全沒有訊號。整份實驗的判定是 MIXED,不是 PASS。
一個市場拿到極強證據,沒有讓事前的門檻鬆動。 這件事寫出來比它聽起來重要:判準是在看到結果之前訂的,看到結果之後才決定「幾個市場算成功」,就等於用資料選門檻,那份顯著性也就不再是它宣稱的那個意思。
至於為什麼只有日本吃得到,日本是階梯的最上游,它的基準模型不含任何外部市場,所以加進 SPY 與 VIX 是從無到有;其他五個市場的基準模型已經含了上游資訊,階梯版只是再多加一階,增量自然小得多。這一層在一般讀者版裡講過,這裡只補上它與判準設計的關係:階梯的第一階與後面幾階本來就不該期待同樣的效果量,而事前判準要求「四個市場都改善」,某種程度上是一個偏嚴的設定。這是設計上可以討論的地方,但要討論也應該在看到結果之前。
可以帶走的一條
比較兩個模型之前先問一句:後者是不是包含前者?是的話,DM 不能當正式檢定用,要換 Clark-West 或其他針對巢狀情形的方法。這個錯誤不會讓程式報錯,它會回一個看起來很正常、甚至很顯著的統計量——K1719 的日本那一列就是它的樣子。
資料與可複現資訊
- 對應實驗:K1719(
experiments/k1719/k1719_results.json),判定 MIXED,種子 42 - 資料來源:Yahoo Finance via yfinance 1.2.0,2005-01-01 至 2025-12-31;快照檔
k1719_source_snapshot.csv,SHA-256 開頭e2b64d8f - 標的:日經 225、台灣加權、新加坡海峽時報、印尼綜合、馬來西亞綜合、泰國 SET,另用 SPY 與 VIX 作為上游
- 目標變數:每日收盤對收盤對數報酬的平方;預測目標為對數變異數,評估在變異數尺度
- 滾動視窗 756 日,最少訓練觀測 504 筆;訊號一律在各市場本地交易時序上計算並落後一期後才做日期合併
- 正式巢狀檢定:Clark-West (2007) MSPE-adjusted,HAC 落後 16 期;DM 在巢狀下僅供診斷
- 日本的 Clark-West 單尾顯著性精確值:2.362721794074841e-31
- 東南亞面板:統計量 0.1843,雙尾顯著性 0.8538,n=3,567,四個市場
- 結論面的一般讀者版本:〈隔夜美股的震盪,真會傳染給亞洲嗎?二十年數字只認一個市場〉
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊