模型評比最怕只看練習題:訓練分數升到 0.84,實戰誤差反而多 13.8%
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
模型評比最怕只看練習題:訓練分數升到 0.84,實戰誤差反而多 13.8%
一個預測模型在練習題上拿到 84 分,另一個只有 58 分。你會選哪一個?
先別急。如果前者到了真正的考題,錯得反而更多,那 84 分不是能力證明,只代表它更會記住練習題。這次的小型實驗正好留下這種清楚的反差:多加兩項市場路徑特徵後,訓練資料的解釋分數從 0.5752 升到 0.8413 ;到了 17 次真正往前預測,誤差分數卻從 0.331166 增加到 0.376813 。這項分數越低越好,因此複雜版本實際上差了 13.8% 。
這不是要宣布複雜模型永遠沒用。樣本很小,結果還不足以下定論。它比較像一份完整的驗收示範:一個漂亮的訓練分數,要經過哪些關卡,才有資格被稱為預測能力。
兩個模型差在哪裡
研究使用 SPY 的五分鐘盤中價格,把每個交易日的價格擺動整理成隔日要預測的波動程度。資料期間是 2026-01-15 至 2026-04-06,共 55 個有效交易日。前 37 天劃為訓練窗口,後段產生 17 次一步向前的預測。模型需要先累積 22 天資料來建立月度摘要,再把今日特徵接到隔日答案,因此訓練窗口內真正能估計分數的只有 14 筆配對 ,不是 37 筆。
簡單版本只看三種歷史摘要:前一日、最近一週與最近一個月的波動。複雜版本在同一套基礎上,再加入兩項「價格先前怎麼走過來」的摘要。直覺很合理:同樣的終點,先一路上漲再回落,可能和一路平穩抵達留下不同訊息。
複雜版本還要替兩項新特徵選擇記憶長度。研究列出 8 種候選速度,兩兩配成 64 組 ,再從訓練資料中挑出誤差最低的一組。所有選擇只讀取前 37 天窗口內的 14 筆有效配對;後面的 17 個答案沒有回頭參與挑選。時間順序合法,但資料量與選項數的落差已經埋下風險:14 筆配對要同時挑 64 組設定,很容易選中一個特別迎合這段資料的組合。
練習題上,複雜版本看起來大勝
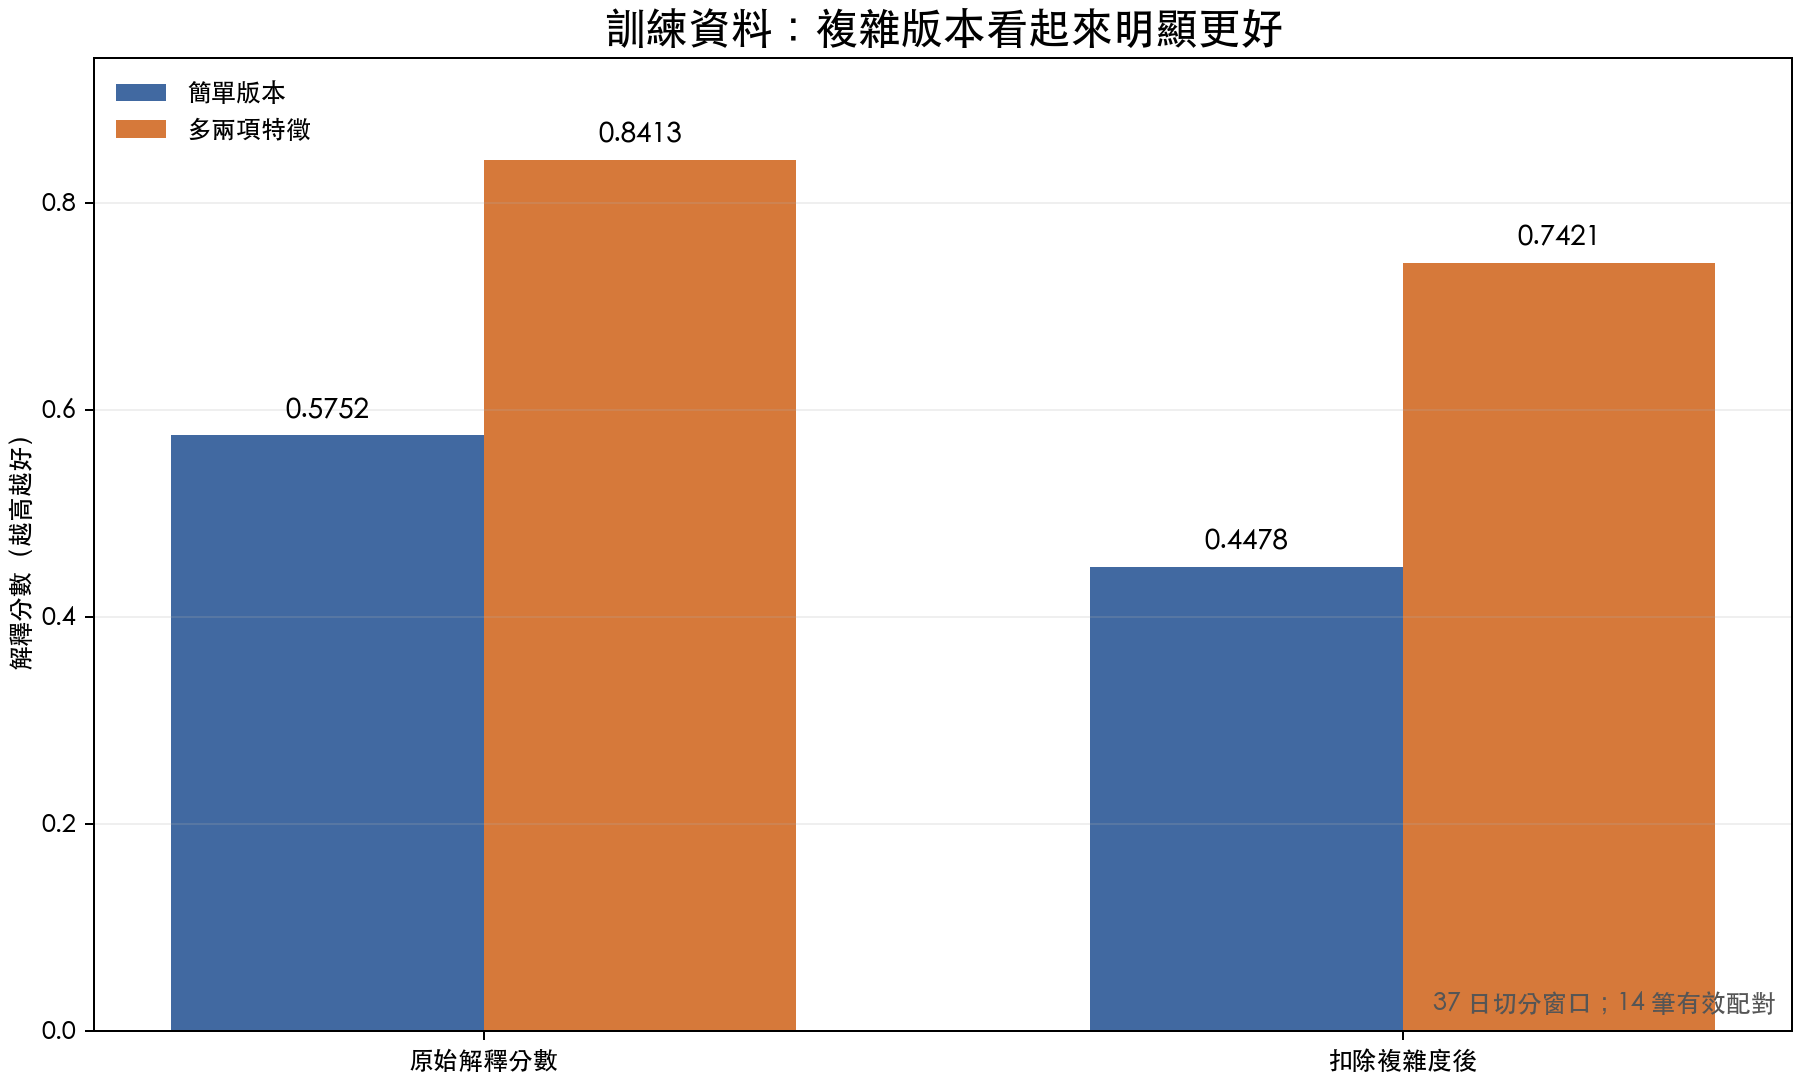
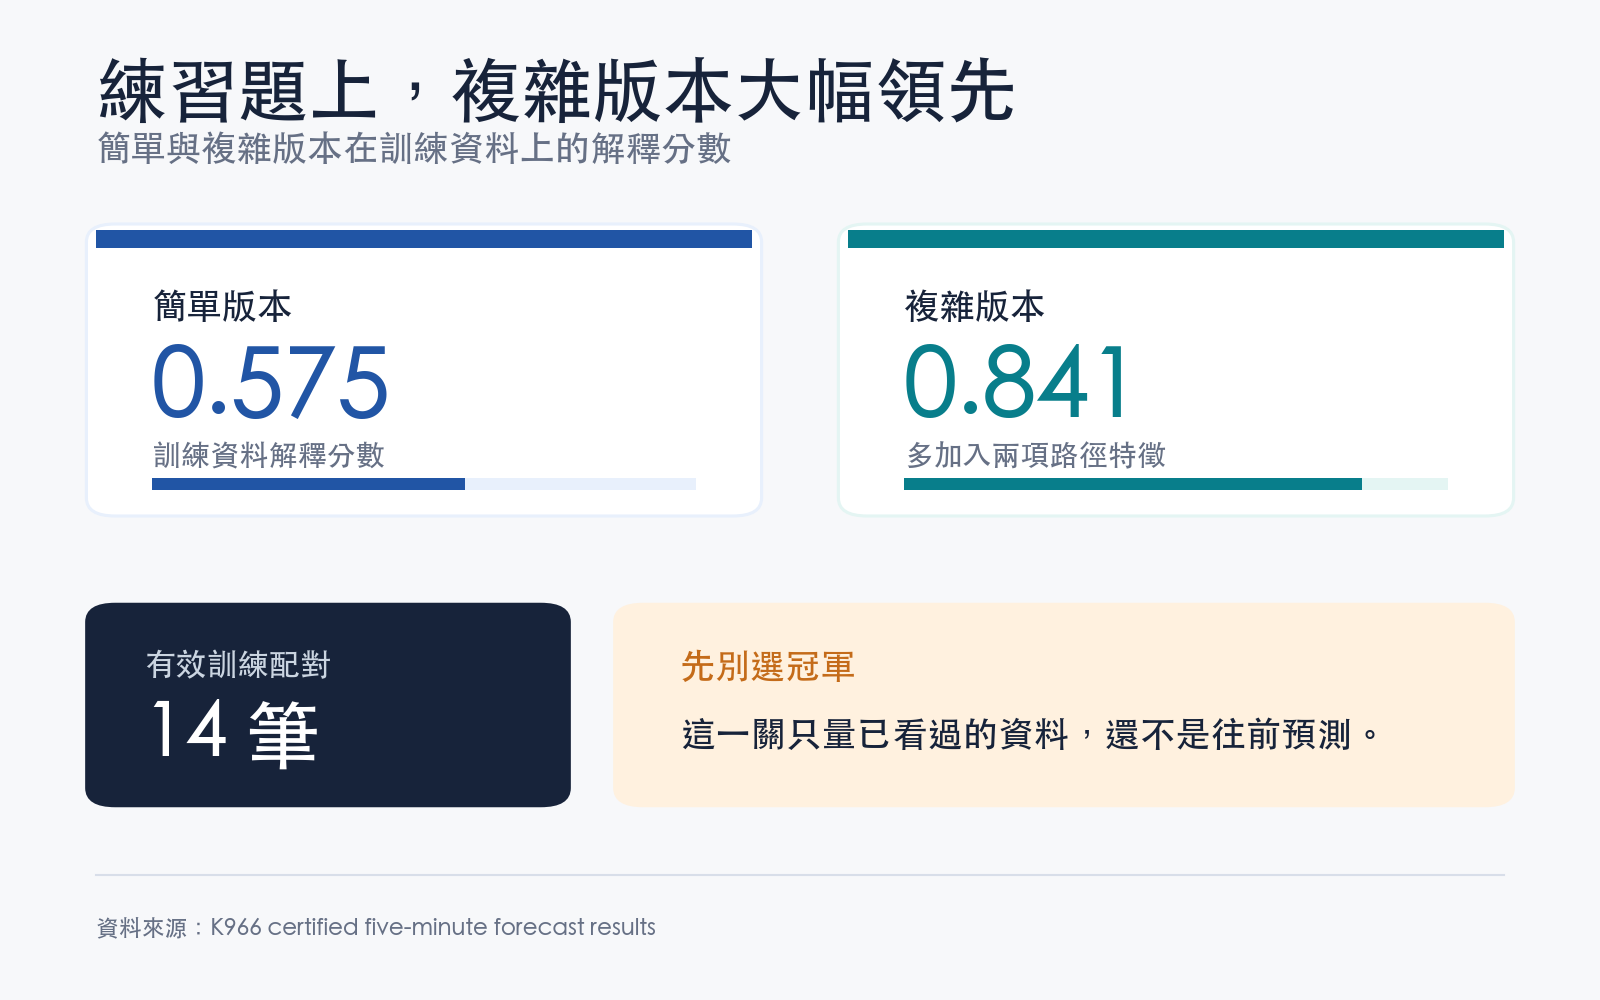
圖中的兩組柱子分別是原始分數與扣除額外複雜度後的分數。簡單版本是 0.5752 與 0.4478 ;複雜版本升到 0.8413 與 0.7421 。即使先扣掉「多放兩項特徵」帶來的自然優勢,複雜版本仍然漂亮得多。
問題正出在「挑最好」。如果只試一個設定,偶然貼合雜訊的機會有限;如果試 64 組,再把最漂亮的一組端出來,最高分本來就會偏高。這不等於研究偷看答案。它說明另一種更常見的陷阱:流程完全守時序,仍可能因為小樣本與大量選擇而過度配適。
訓練分數因此只能回答「模型能不能解釋已看過的資料」。它不能回答「明天能不能預測得更準」。後一題必須交給模型沒有參與挑選的資料。
真正考題上,排名翻轉
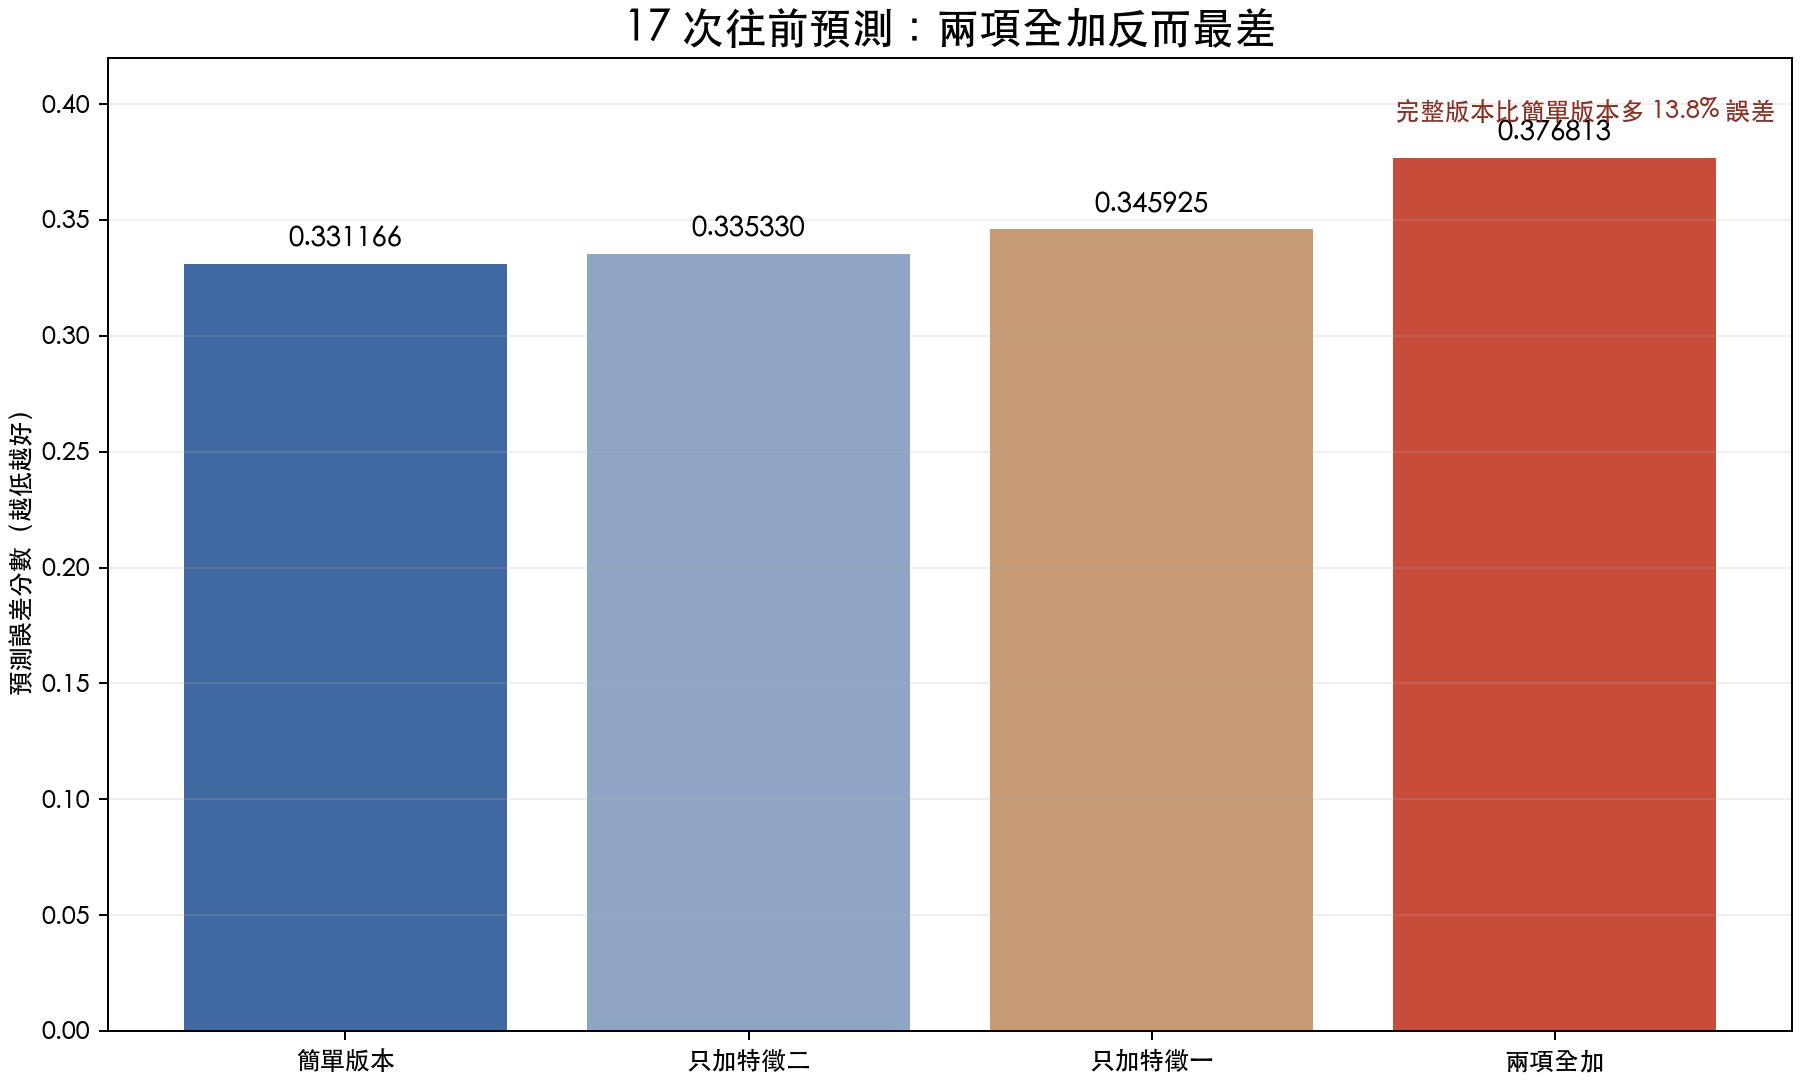
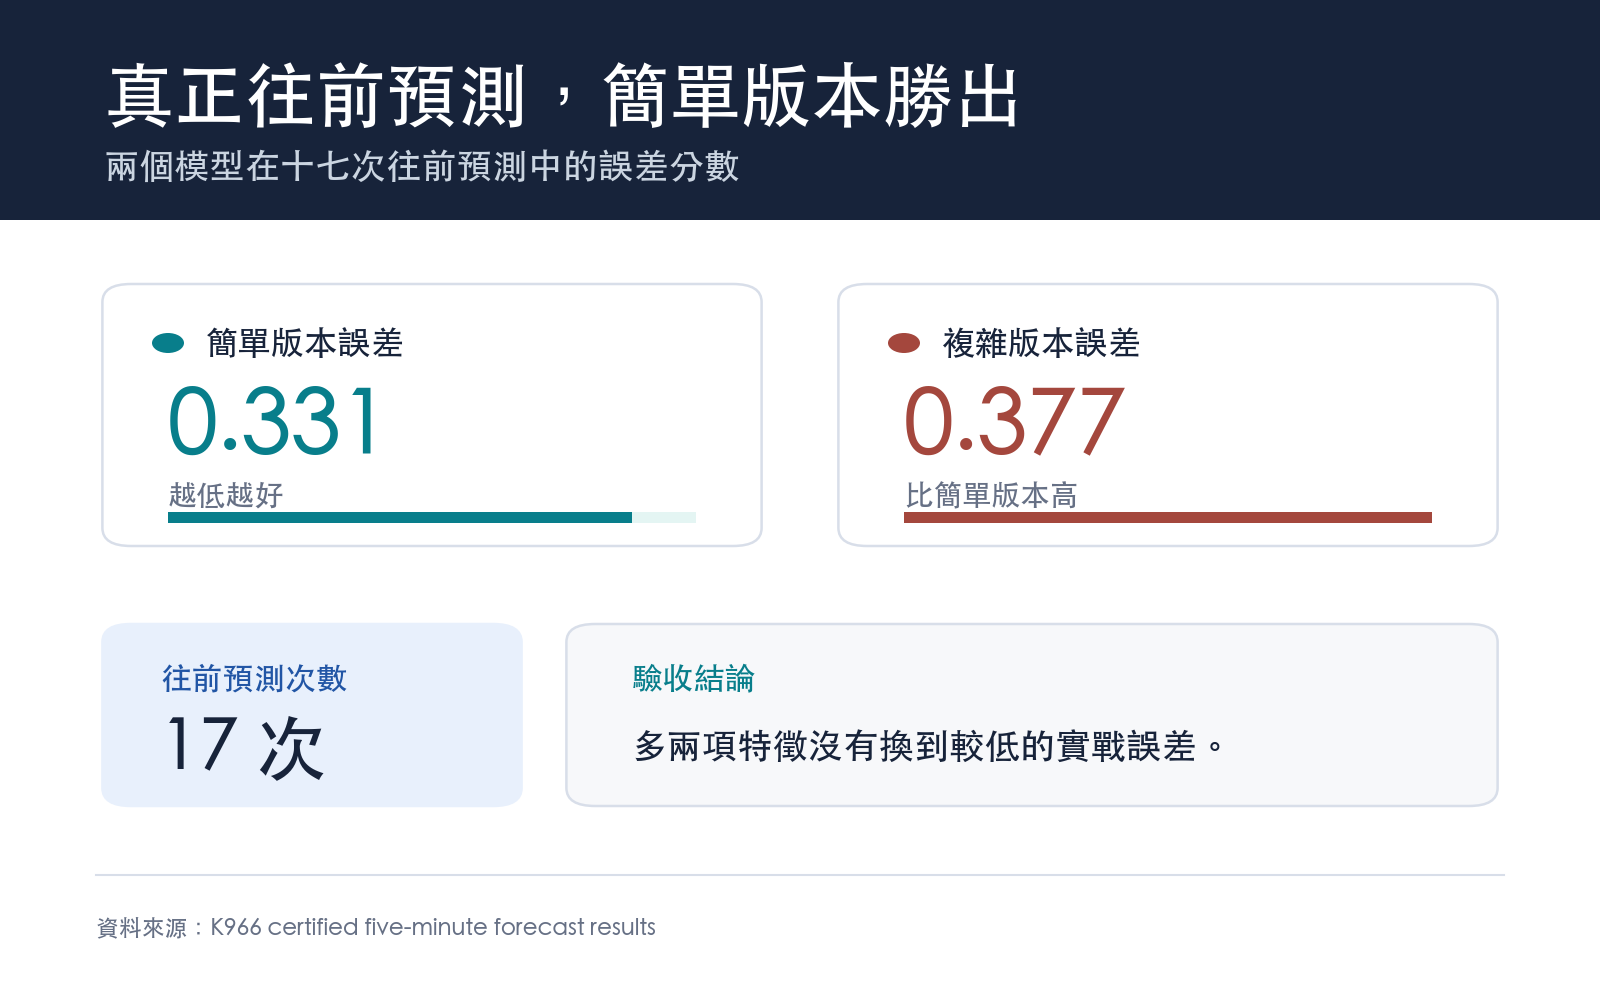
後段的 17 次預測採用同一把量尺,分數越低越好。簡單版本得到 0.331166 。只加第二項新特徵的版本是 0.335330 ,只加第一項的是 0.345925 ,兩項全加的版本則升到 0.376813 ,成為四者最差。
完整版相對簡單版多出 13.8% 誤差。這個比例的算法是 0.376813 ÷ 0.331166 - 1,不是拿兩個訓練分數相減,也不是投資報酬率。它只描述同一批 17 次預測、同一種誤差量尺上的相對差距。
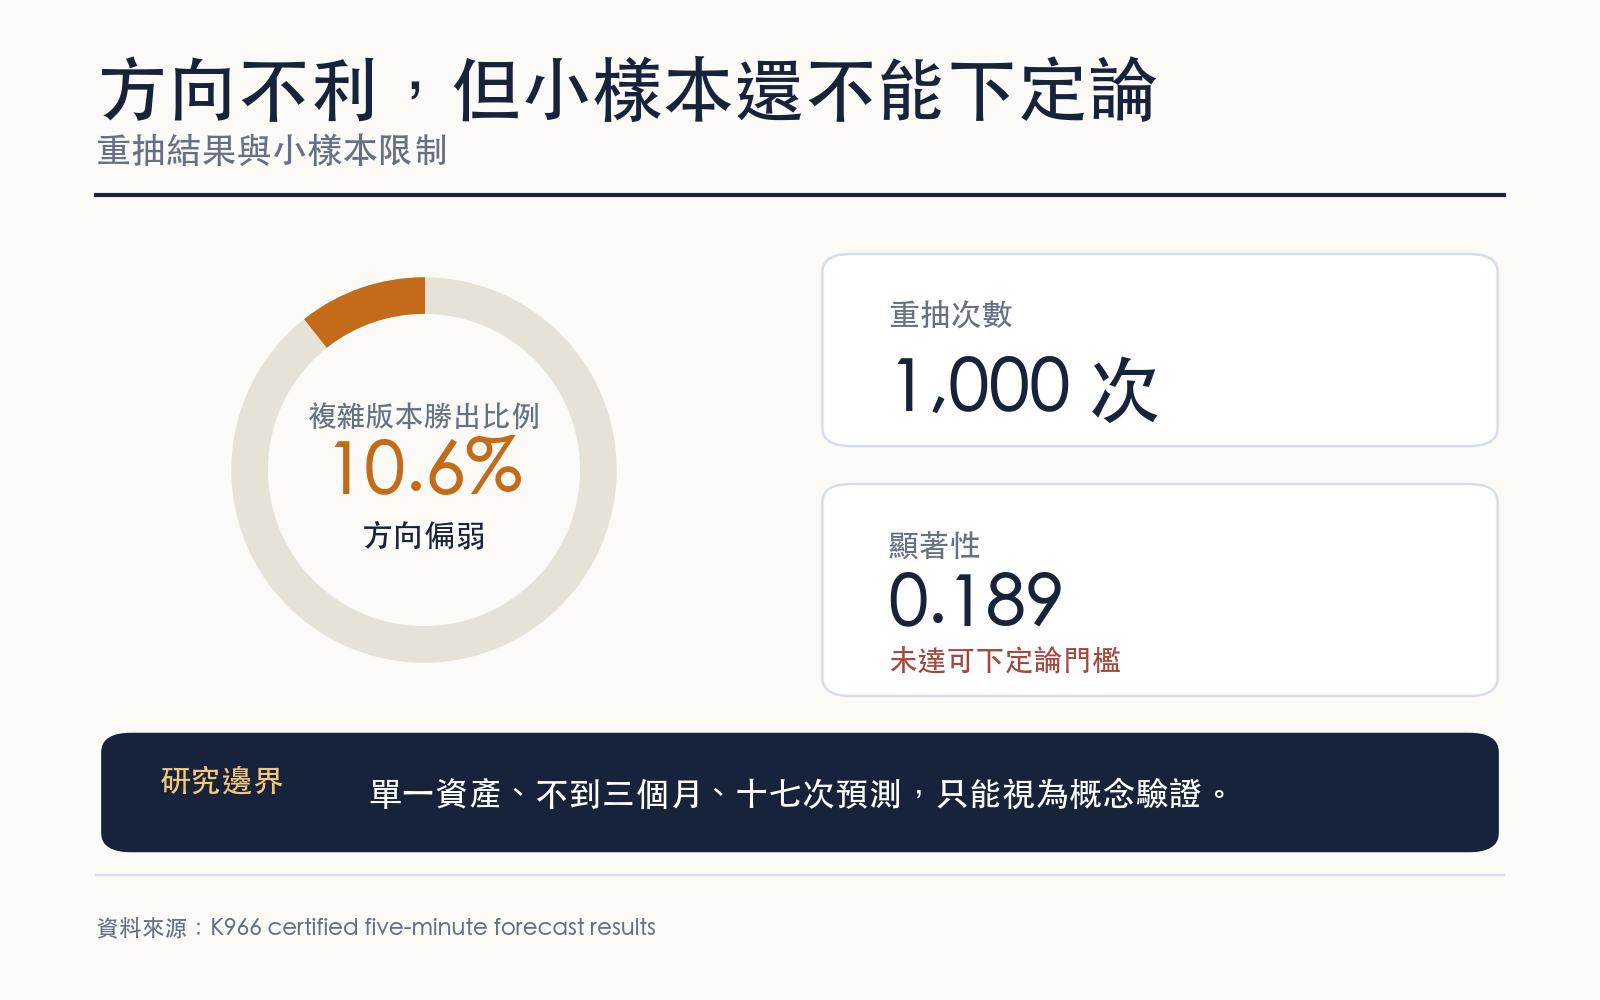
研究也把這 17 次結果重新抽取 1,000 次,固定隨機種子為 42。複雜版本只有 10.6% 的重抽樣本勝過簡單版本;兩者平均差距的合理範圍約為 -0.097942 到 0.029993 ,範圍仍跨過零。另一項兩模型比較的統計強度是 -1.3714 ,顯著性是 0.1892 ,同樣沒有達到可下定論的門檻。
這兩句必須一起讀。方向上,現有資料明顯不支持複雜版本;證據強度上,17 次預測又太少,還不能宣告它在更長期間必然失敗。誠實結論是「這次沒有通過驗收」,不是「這類方法已被永久否定」。
一張模型成績單至少要有四欄
第一欄是訓練成績。它能協助找明顯無法描述資料的模型,但不能單獨決定冠軍。
第二欄是選擇次數。看過多少特徵、多少參數組合、多少模型版本,都會增加挑中偶然高分者的機率。這次只有 14 筆有效訓練配對,卻要比較 64 組設定,這個比例應先亮黃燈。
第三欄是真正往前的測試。資料必須在選模型時完全沒被看過,而且每次預測只能使用當時已知資訊。這次的 17 次預測符合時間順序,所以排名翻轉不能用偷看答案解釋。
第四欄是證據邊界。資產只有 SPY,期間只有不到三個月,樣本外只有 17 次。資料來自五分鐘價格,研究也沒有測不同年份、其他資產或更長的市場環境。任何外推都必須等更大的前向樣本。
怎麼讀下一張漂亮的模型圖
看到「準確率提升」或「解釋力大增」時,可以先問三個問題:這是訓練資料還是沒看過的資料?研究總共試了多少種設定?測試期有多少次真正獨立的預測?
如果文章只給第一個數字,模型可能只是把練習題背熟。如果它同時交代選擇範圍、時間順序與失敗結果,你才看得到完整成績單。
這次的 0.84 很漂亮,但 17 次往前預測沒有替它背書。對模型評比來說,承認「更複雜、卻沒有更準」不是壞消息。它替後續研究省下錯誤自信。真正值錢的標準,在於下一段資料仍能站得住。
資料來源:yfinance 的 SPY 五分鐘盤中價格,期間 2026-01-15 至 2026-04-06,共 55 個有效交易日;前 37 日是訓練切分窗口,扣除 22 日月度摘要與一步位移後有 14 筆有效估計配對,後段形成 17 次一步向前預測。重抽檢查共 1,000 次,隨機種子固定為 42。本文是小樣本概念驗證,不構成投資建議。
懶人包圖組
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊