把市場拆成四層開關:贏了兩狀態切換,也贏了教科書模型,卻沒贏過一行老公式
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
市場的波動有個很固執的習慣:抖起來會連抖好幾天,安靜下來也能安靜好幾週。
要把這個習慣寫成模型,最流行的講法是「兩種狀態」,平靜期跟恐慌期,中間偶爾切換一次。看盤的人說「市場進入高波動階段」,講的就是這個。
1990 年代有另一派講法:波動的記憶不只一層。有些力量幾天就換一次臉,例如新聞、財報、當沖的追價;有些要幾個月甚至幾年才翻一次,例如利率循環、資金鬆緊。把好幾個速度不同的開關疊在一起,波動看起來就會像現實中這樣忽快忽慢。這套講法叫多重碎形。
機制聽起來有道理,能不能真的把明天猜得更準,是另一回事。所以我們把它實作出來,跟五個對手排在同一條跑道上,跑了 1,948 個交易日。
跑道怎麼設
標的五檔:美股大盤 SPY、科技股 QQQ、黃金 GLD、長天期公債 TLT、台灣市值型 0050。價格取自本站本地快取,起點 2016-01-04。
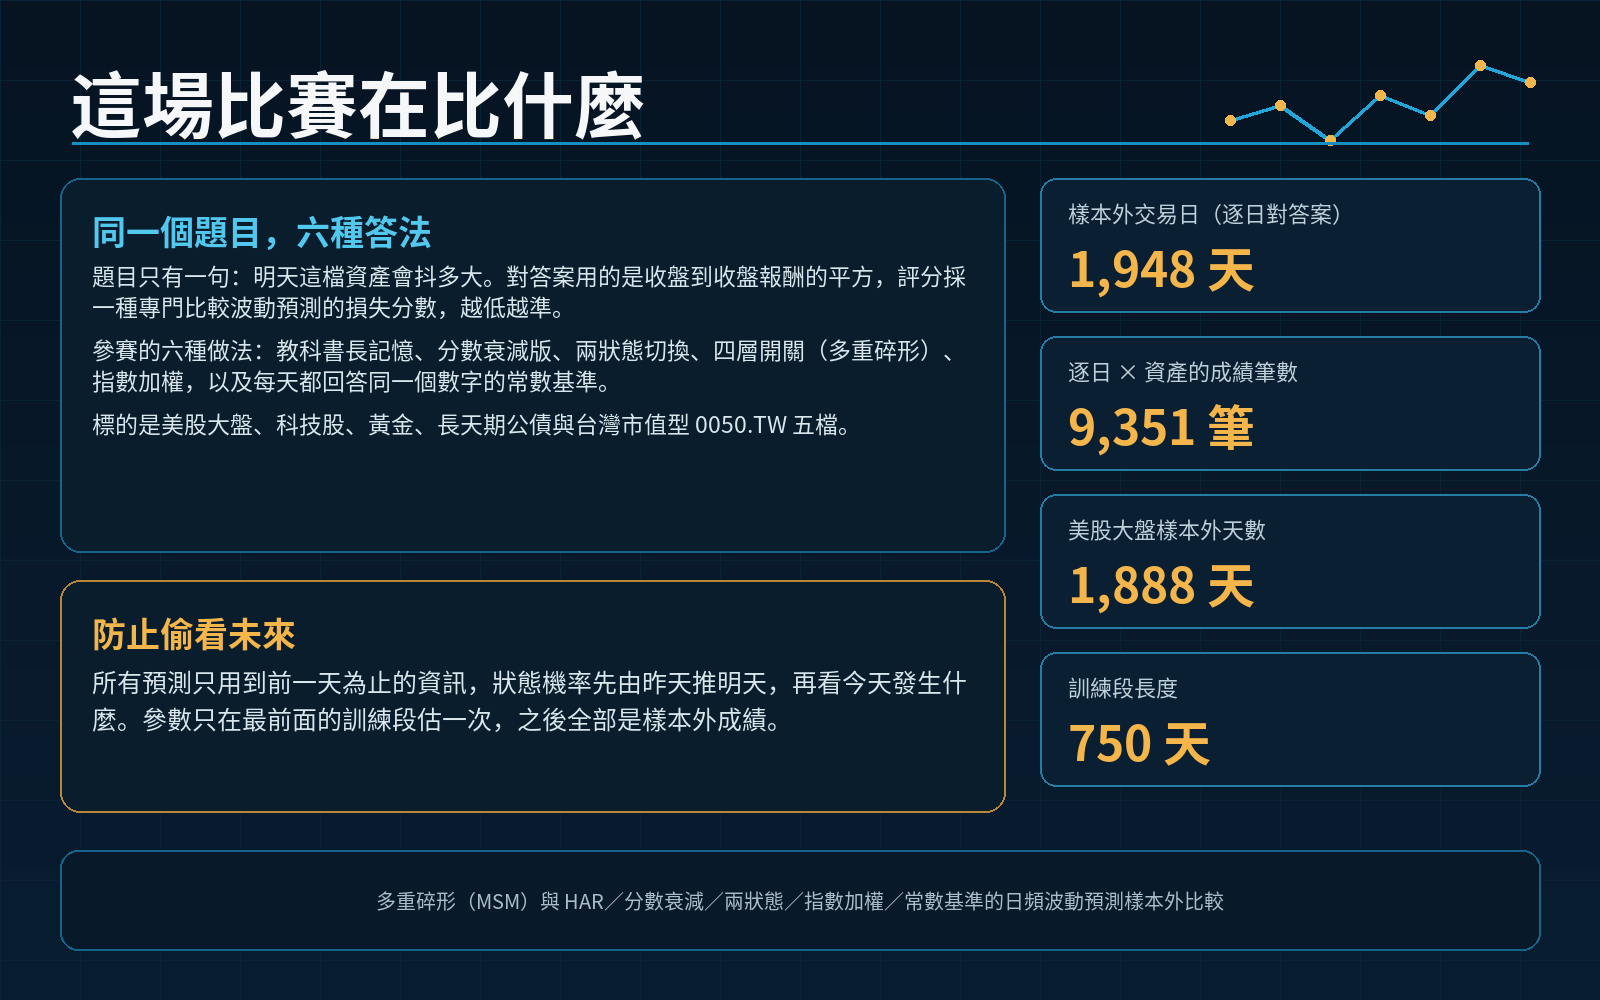
每個模型每天只回答一個問題:明天這檔會抖多大。對答案用的是「收盤到收盤報酬的平方」,評分採一種專門比較波動預測的損失分數,數字越低越準。
防作弊的部分寫死在程式裡:所有預測只能用到前一天為止的資訊,狀態機率也是先用昨天的推明天,再看今天發生什麼。參數只在最前面 750 天的訓練段估一次,之後的成績全是樣本外。美股四檔各有 1,888 天成績,台灣 0050 有 1,799 天,合計 9,351 筆逐日對答案。
六個參賽者:
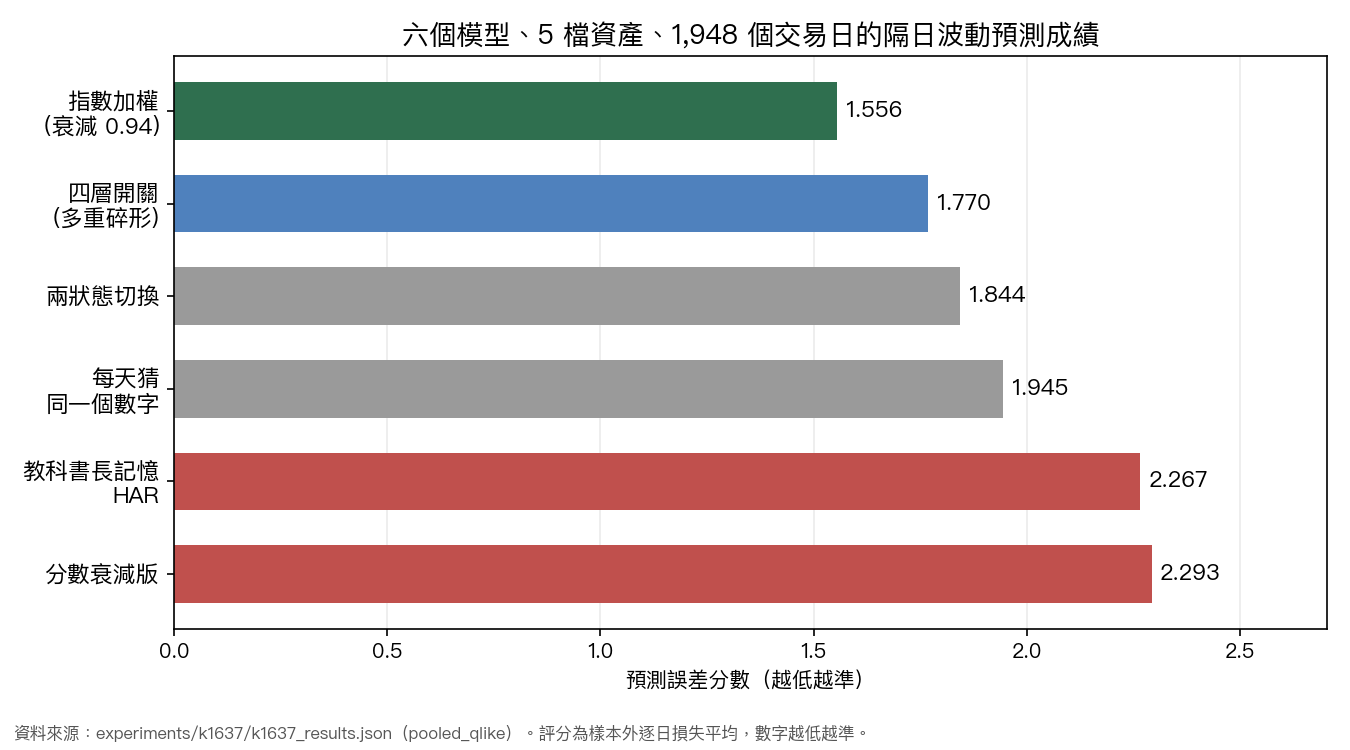
| 做法 | 一句話說明 | 誤差分數 | 對教科書模型 |
|---|---|---|---|
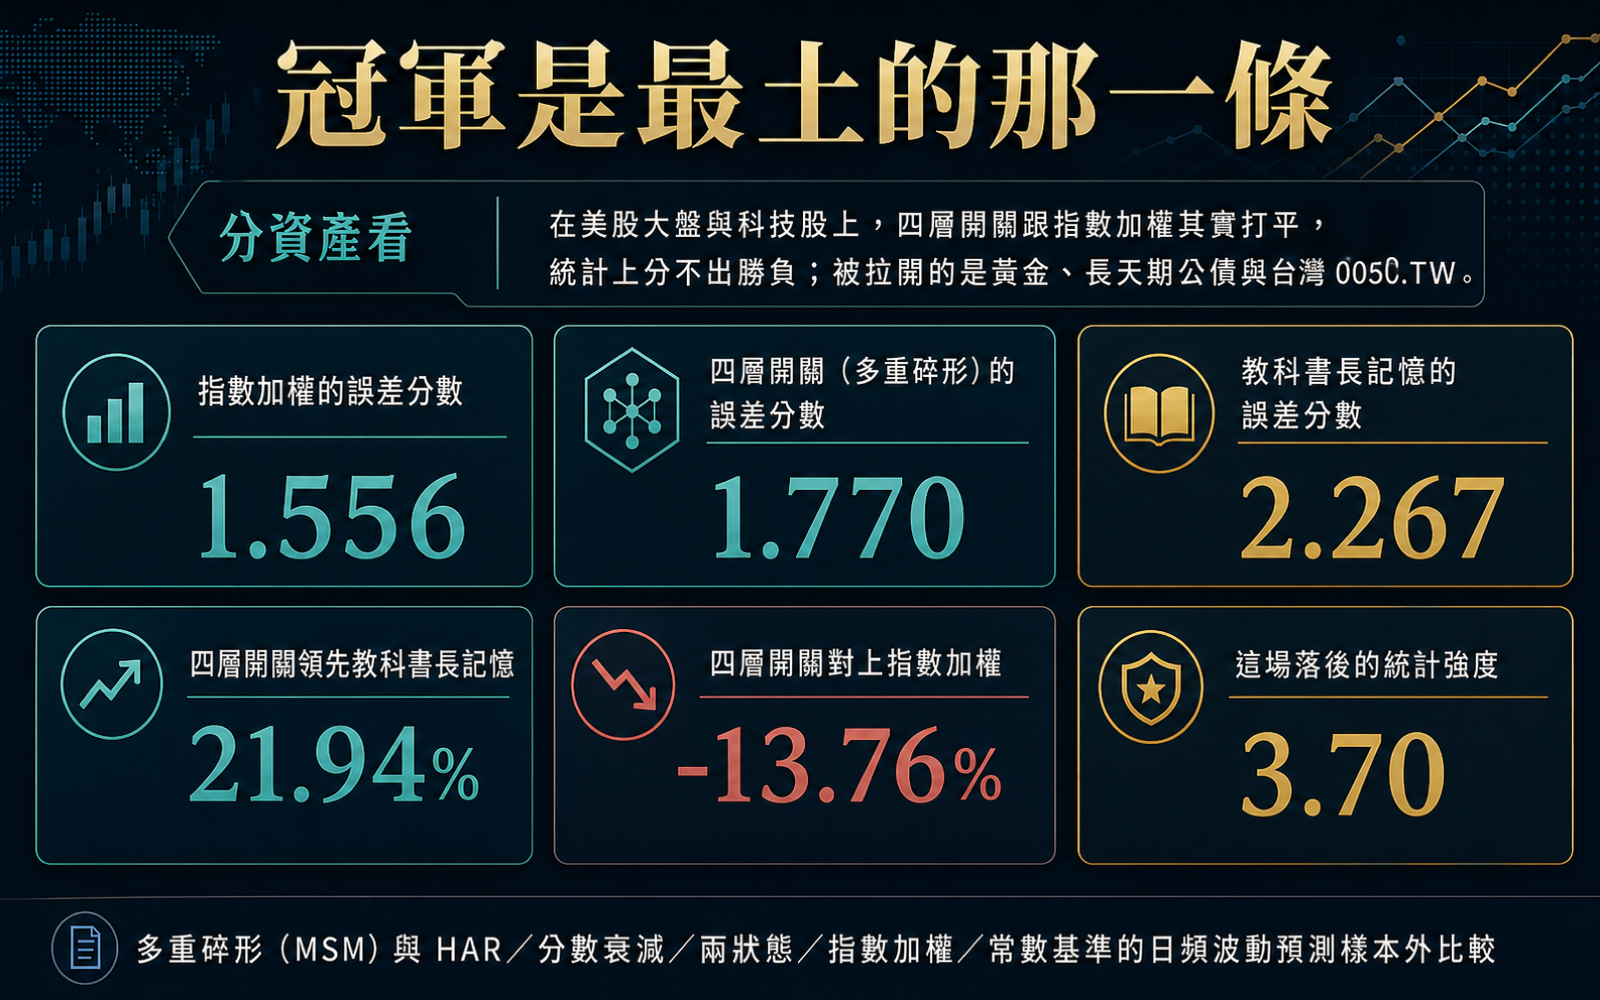
| 指數加權 | 昨天權重最高,越久以前越輕,記憶半衰期大約兩週 | 1.556 | 準 31.38% |
| 四層開關(多重碎形) | 四個速度不同的開關疊起來,共 16 種組合 | 1.770 | 準 21.94% |
| 兩狀態切換 | 只有平靜、恐慌兩檔,來回跳(只有美股兩檔真的在切換,另外三檔擬合退化,預測近乎固定值) | 1.844 | 準 18.67% |
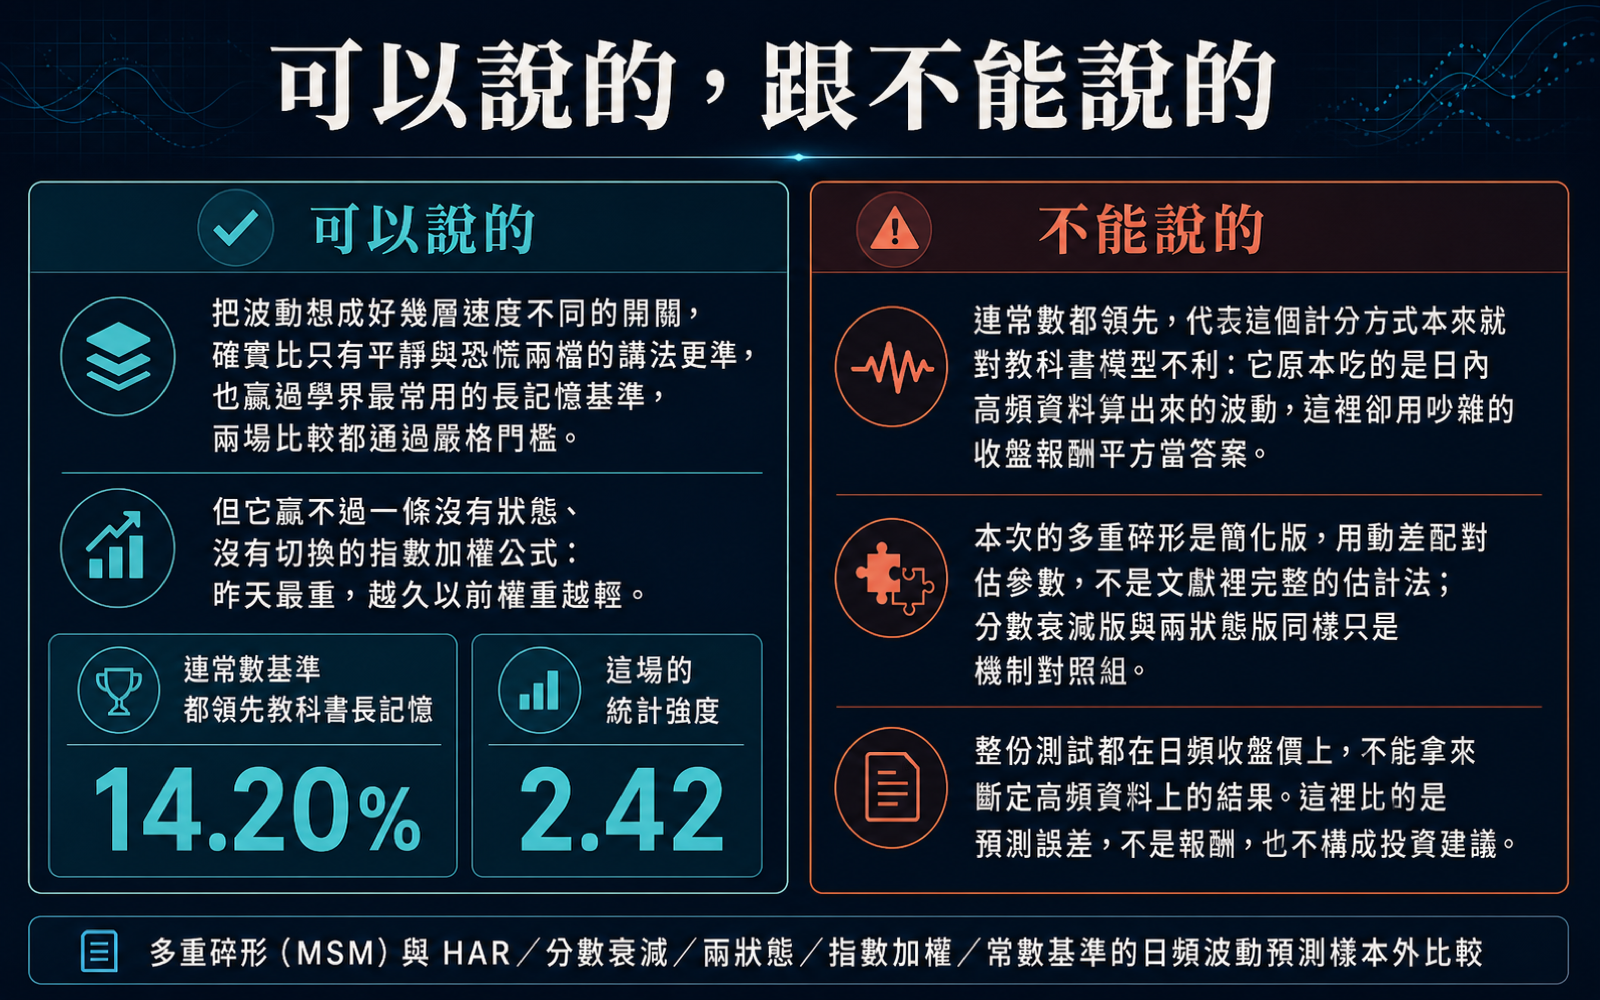
| 每天猜同一個數字 | 拿歷史平均當明天的答案 | 1.945 | 準 14.20% |
| 教科書長記憶 | 昨天、上週、上個月三段平均加權,學界最常用的基準 | 2.267 | 基準 |
| 分數衰減版 | 讓昨天的影響力以分數次方慢慢淡出 | 2.293 | 差 1.16% |
好消息:在兩檔美股 ETF 上,多層開關確實比兩檔開關準
四層開關贏了兩狀態切換 4.02%,統計強度 3.34、顯著性 0.0008,通過這份研究自己訂的嚴格門檻(統計強度要大於 3)。
這個五檔合計的數字要拆開看。兩狀態切換只在美股大盤 SPY 與科技股 QQQ 上真的在切換,四層開關在這兩檔分別贏 12.93% 與 11.29%(統計強度 7.21 與 4.69)。黃金 GLD、公債 TLT 與 0050 上,兩狀態模型擬合退化:狀態之間幾乎沒有持續性,或其中一個狀態只吃到一小撮沒有漲跌的訓練日,預測最後近乎一個固定的數字。對這個近乎固定的對手,四層開關在公債贏 11.65%(統計強度 3.25),在黃金與 0050 反而輸 5.84% 與 7.52%(統計強度 4.97 與 4.99)。
它也贏了教科書那條長記憶基準 21.94%,統計強度 7.32。
「市場只有平靜和恐慌兩種狀態」這個很常見的簡化,在美股兩檔上被比下去了;另外三檔上,這份資料沒有給它一個像樣的對手。多幾層速度不同的記憶,確實把美股兩檔的隔日波動猜得更準一些。
壞消息:一條 1990 年代的老公式把它們全壓在下面
冠軍是指數加權,也就是 1990 年代 RiskMetrics 風險系統採用的那組固定設定。一行遞迴算式,沒有狀態、沒有切換、沒有記憶結構,只是讓昨天最重、越久以前權重指數式變輕,記憶半衰期大約兩週。
它把四層開關壓下去 13.76%,統計強度 3.70,同樣過門檻。
這條公式攤開來只有一行:明天的估計 = 今天的估計 × 一個固定的衰減比重 + 今天報酬的平方 × 剩下的那點比重。沒有訓練、沒有挑參數、沒有重估,用試算表就能跑。
分資產看更清楚:
| 標的 | 樣本外天數 | 四層開關 | 指數加權 | 差距 | 統計強度 |
|---|---|---|---|---|---|
| 美股大盤 SPY | 1,888 | 1.643 | 1.578 | 落後 4.12% | 1.01(分不出勝負) |
| 科技股 QQQ | 1,888 | 1.553 | 1.540 | 落後 0.85% | 0.42(分不出勝負) |
| 黃金 GLD | 1,888 | 1.958 | 1.539 | 落後 27.17% | 3.35(過嚴格門檻) |
| 長天期公債 TLT | 1,888 | 1.419 | 1.236 | 落後 14.74% | 2.12(顯著性 0.034,未過嚴格門檻) |
| 台灣 0050 | 1,799 | 2.301 | 1.901 | 落後 21.05% | 3.49(過嚴格門檻) |
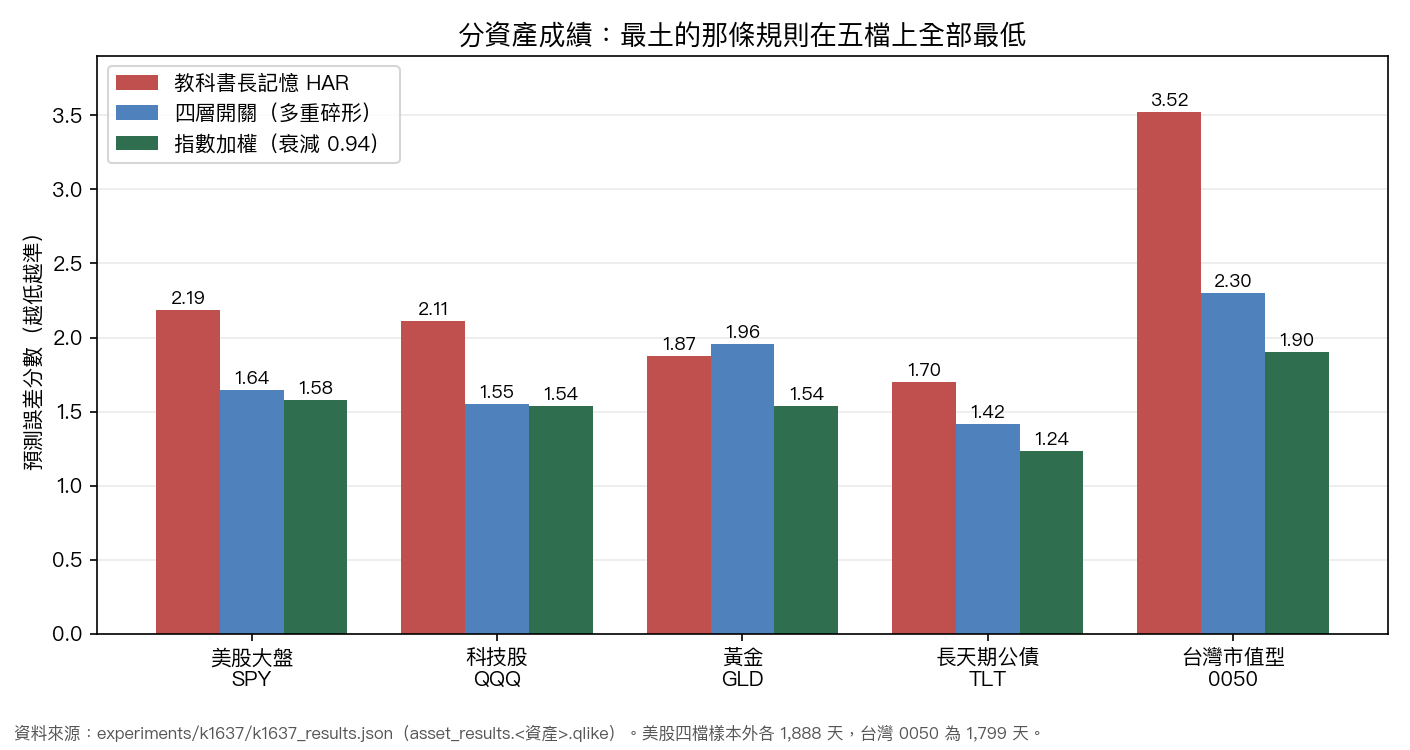
在兩檔美股 ETF 上,四層開關跟指數加權其實打平,統計上分不出勝負。真正被拉開的是黃金、公債跟台灣這三檔。
模型自己招了:它在哪裡沒學到東西
這類多層記憶模型會估出每一層開關「多久翻一次」。把估出來的機率換算成平均間隔,各檔資產的長相差很多。
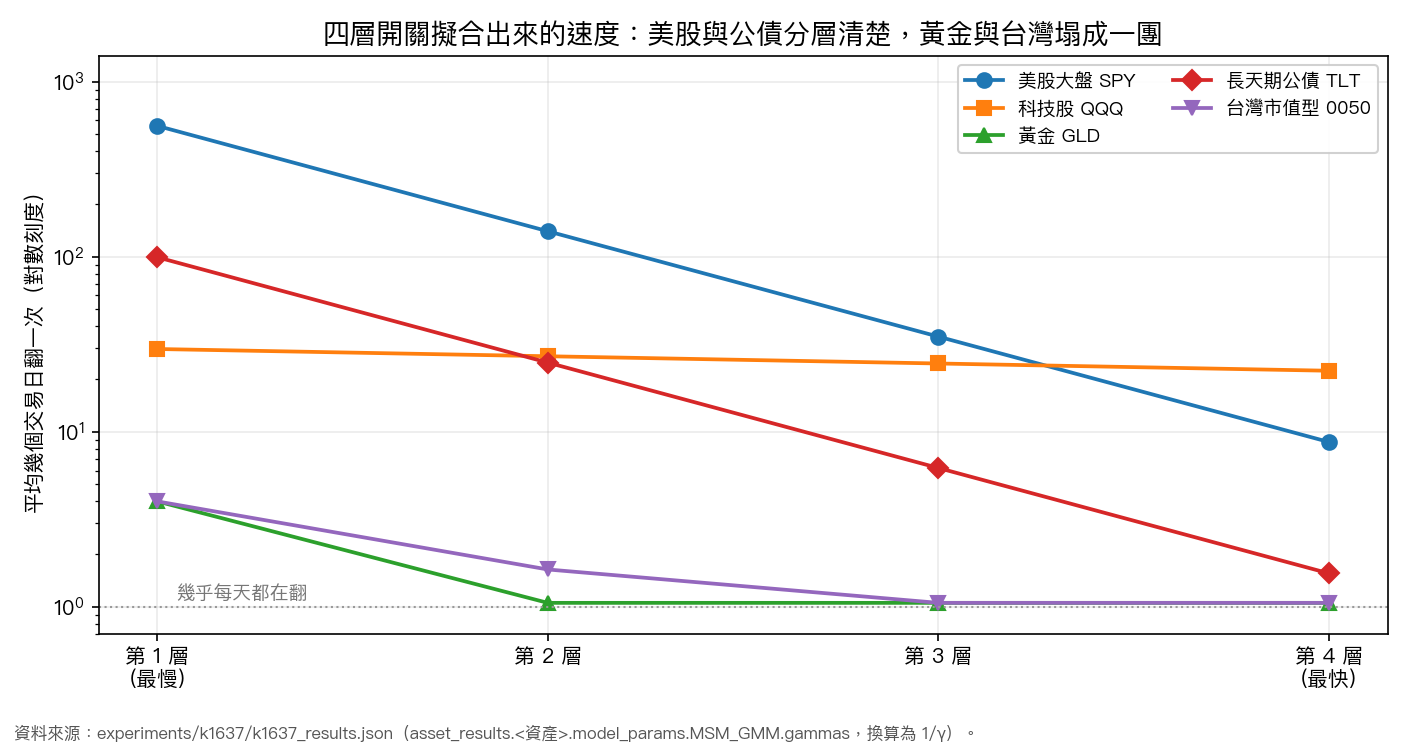
美股大盤那組最漂亮:四層分別約 559、140、35、9 個交易日,從兩年多的慢循環到一週半的快循環,層次分明。長天期公債也有結構,約 99、25、6、2 天。
科技股 QQQ 的四層全部擠在 22 到 30 天之間,等於沒分層。黃金跟台灣 0050 更極端,有三層直接貼到參數上限,換算下來幾乎每天都在翻,那已經不是多重時間尺度,比較像雜訊。
擬合退化的那幾檔,正好就是它輸最多的那幾檔。兩件事對得上,不過一份實驗還不足以把它當成定論。
這場比賽最有價值的設計,是兩條笨基準
這個實驗刻意放了兩條沒人會當真的對照組:一條是前面那個指數加權,另一條更誇張,每天都回答同一個數字,也就是歷史平均。
結果連「每天猜同一個數字」都贏了教科書長記憶模型 14.20%(統計強度 2.42、顯著性 0.015,沒有通過大於 3 的嚴格門檻,只能當提示)。
這件事比「誰是冠軍」更重要。它說明題目的設定本身就對教科書模型不利:那套方法原本吃的是日內高頻資料算出來的波動,這裡卻拿吵得要命的「收盤報酬平方」當答案,等於叫它在爛麥克風前面唱歌。
本站另一份用「當日最高最低價區間」當答案的實驗,同一族的教科書模型就變成贏家。同樣的模型、不同的計分方式,排名可以整個翻過來。
所以下次看到「我們的模型比業界標準準 22%」這種說法,先問三件事:對手是誰、有沒有放笨基準當測謊機、答案是怎麼算出來的。
這篇不能推到哪裡去
這裡的多重碎形是簡化版,用動差配對估參數,不是文獻裡完整的估計法;分數衰減版跟兩狀態版同樣是機制對照組,不是套件級實作。兩狀態版在三檔資產上擬合退化,所以這篇對「兩狀態模型」的結論只涵蓋美股大盤與科技股。
整份測試都在日頻收盤價上,沒有碰高頻資料,所以不能拿來斷定多重碎形在高頻上也沒用。
還有一件更基本的:這比的是預測誤差,不是報酬。預測比較準跟賺比較多,在本站過去的實驗裡一再被證明是兩件事。本文不構成投資建議。
三句帶走
想對明天的波動有個粗略概念,指數加權那種「近期權重最高、大約兩週半衰期」的算法,到現在都很難被打敗。
看到模型評比先看對手名單,沒有笨基準的排行榜參考價值有限。
多層記憶這類機制目前的價值在解釋市場長什麼樣,不在幫你多賺一段。
資料來源:本站本地價格快取。SPY/QQQ/GLD/TLT 為 2016-01-04 至 2026-07-02,各 2,639 個交易日;台灣 0050 為 2016-01-04 至 2026-07-03,共 2,550 個交易日(含本站台股資料清理流程)。樣本外評估自 2018-12-27 起算,台灣 0050 自 2019-01-29 起算。全文數字皆由實驗結果檔以程式取出,隨機種子 42。
懶人包圖組
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊