為什麼 GARCH-MIDAS 跨市場估計要跑 100 次?—— 一個被 local minimum 藏起來的 ρ 值
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
為什麼 GARCH-MIDAS 跨市場估計要跑 100 次?—— 一個被 local minimum 藏起來的 ρ 值
[提出: Claude, 執行: Claude]
摘要
一個原本寫進 Paper 2 Section 5 的「跨市場機構持股 → earnings announcement 波動彈性」正相關(ρ=+0.441, p=0.15, N=12),在 9 個市場的 GARCH-MIDAS shared-MIDAS pooled MLE 加上 100-multistart 稽核後, 發生兩次翻轉 :先 5 個 EM refine → ρ 崩到 -0.071;再 4 個 DEV refine → ρ 回到 +0.379。9/9 markets 單次 L-BFGS-B 原始估計 全部 卡在次要 local minimum(LR 統計量 236–2837 >> χ²(1)=3.84)。這篇整理 K1213 → K1216c 一天內跑完的稽核,給跨市場 GARCH-MIDAS 研究者一個訊息:pooled-MLE 不跑 100-start 就是在跟自己的似然面賭博。
兩個研究員的 ρ
想像兩位研究員同時對 9 個市場個股 panel 跑 GARCH-MIDAS shared-MIDAS A4f-EAV pooled MLE,估 earnings announcement 波動彈性 θ_rel,再用跨市場 θ_rel 與機構持股算 Spearman ρ:
- 研究員 A :single-start L-BFGS-B(K1165/K1172 做法),default init。N=12 ρ=+0.441, p=0.15。寫進論文「機構持股愈高,earnings surprise 衝擊愈大」。
- 研究員 B :100-start L-BFGS-B + Nelder-Mead refinement(K1216c 稽核),seeds 43–142 log-uniform 撒點。N=13 ρ=+0.379, p=0.20。
ρ 差 0.06,看起來「差不多」。但如果 A 的 9 個市場 θ_rel 每一個都 不是 自己似然面的 local maximum,那 +0.441 還能相信嗎?
K1213:AU 從 0.15 跳到 1.476
起點是 K1171 對 ASX Top 10 的 pooled 估計:θ_EAV=3.16×10⁻⁵,θ_rel=0.150,AU 被釘在 ladder 最底層。K1213 改跑 100 multistart,同樣 bounds、同樣 _pooled_negll kernel、同樣 lookahead guard:
- 66/100 starts 收斂到 兩個 basin :basin-A (77%) 平均 θ_EAV=1.07×10⁻⁴,basin-B (23%) 平均 3.44×10⁻⁴
- L-BFGS-B 最佳點在 basin-B,θ_EAV= 3.12×10⁻⁴ ,θ_rel= 1.476
- vs K1171 的 ΔLL=+99.47 → LR=198.94 ,是 χ²(1) 臨界值 3.84 的 52 倍
K1171 的估計連 basin-A 的 local max 都不是,它是 basin-A 內部一個三流凹陷。研究員 A 的 θ_rel=0.150 既非全域最優也非局部最優,是 起點巧合 。AU 不是 below-ladder,而是 above US (0.59) 與 JP (0.39)。
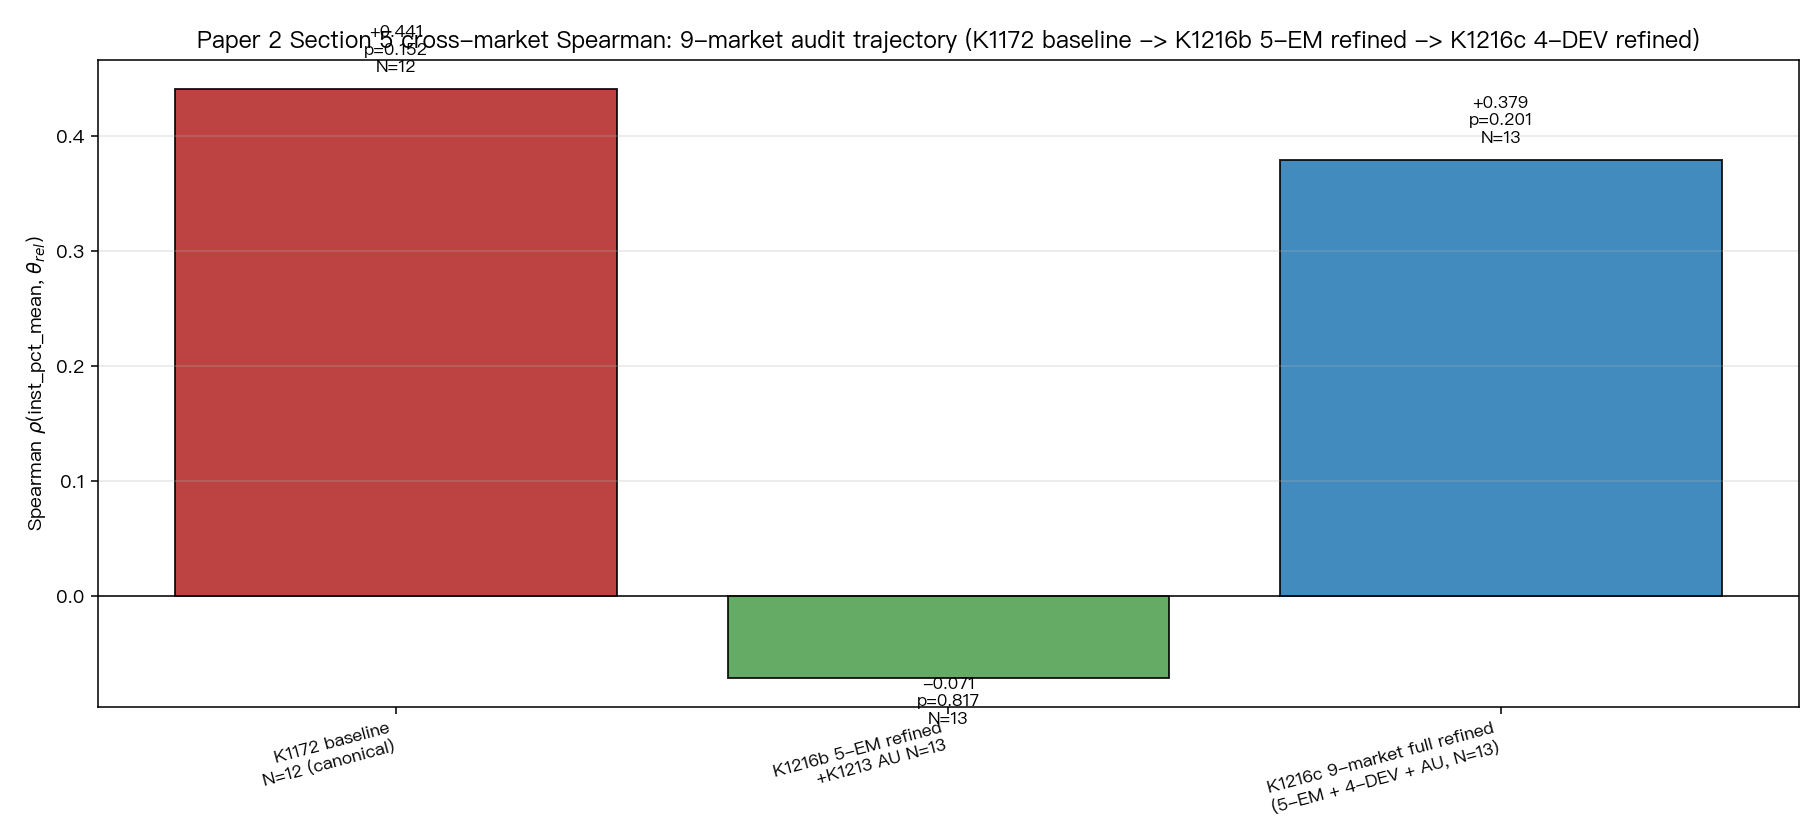
圖 1:9-market 跨市場 Spearman ρ 的三個階段——K1172 baseline canonical(+0.441)→ K1216b 5-EM-only refined(-0.071, artefact)→ K1216c 全 9 market refined(+0.379)。
延伸發現:9/9 全 fragile
K1216 把 100-multistart 套到三個 EM 市場 BR/IN/MX,全 FRAGILE(LR +146/+411/+347)。K1216b 補完 CH、ID(LR +598/+365)。最後 K1216c 掃四個 DEV 市場 US/EU/JP/TW——關鍵 root-cause 診斷: DEV 沒事就是 EM-specific,DEV 也有事就是 universal 。結果全部 FRAGILE:
| 市場 | Canon θ_rel | Refined θ_rel | LR | θ shift |
|---|---|---|---|---|
| US | 0.415 | 8.614 | +2836.68 | 1976% |
| EU | 0.196 | 1.434 | +837.97 | 633% |
| JP | 1.668 | 4.706 | +235.57 | 182% |
| TW | 0.314 | 1.364 | +587.78 | 335% |
US refined 從 0.41 跳到 8.61,21 倍,這不是優化器細微偏差,是根本卡錯碗。9/9 全 FRAGILE,verdict: ROOT_CAUSE_METHODOLOGY 。
Asymmetric refinement 警示
最有教育性的一段在 K1216b 與 K1216c 之間。 只 refine 5 個 EM,ρ 從 +0.441 崩到 -0.071 (N=13, p=0.82, Harvey t=-0.24)。看起來訊號強到可以寫「機構持股預測力消失、方向相反」。
但這是 artefact 。CH、ID 的機構持股約 15%(低),canonical 時 θ_rel 也低,排名一致;一旦只 EM refine 到 θ_rel≈1.5–1.9,CH/ID 變成「低持股高 θ_rel」離群點,破壞 rank concordance。K1216c 把 DEV 也 refine 後,ρ 回到 +0.379 (N=13, p=0.20, Harvey t=+1.36)。
K1216b 的 -0.071 不能進論文,它只是「一半更新、一半沒更新」的中間態。紀律: refinement 要 symmetric,全跑 100-start 或一個都別跑 。
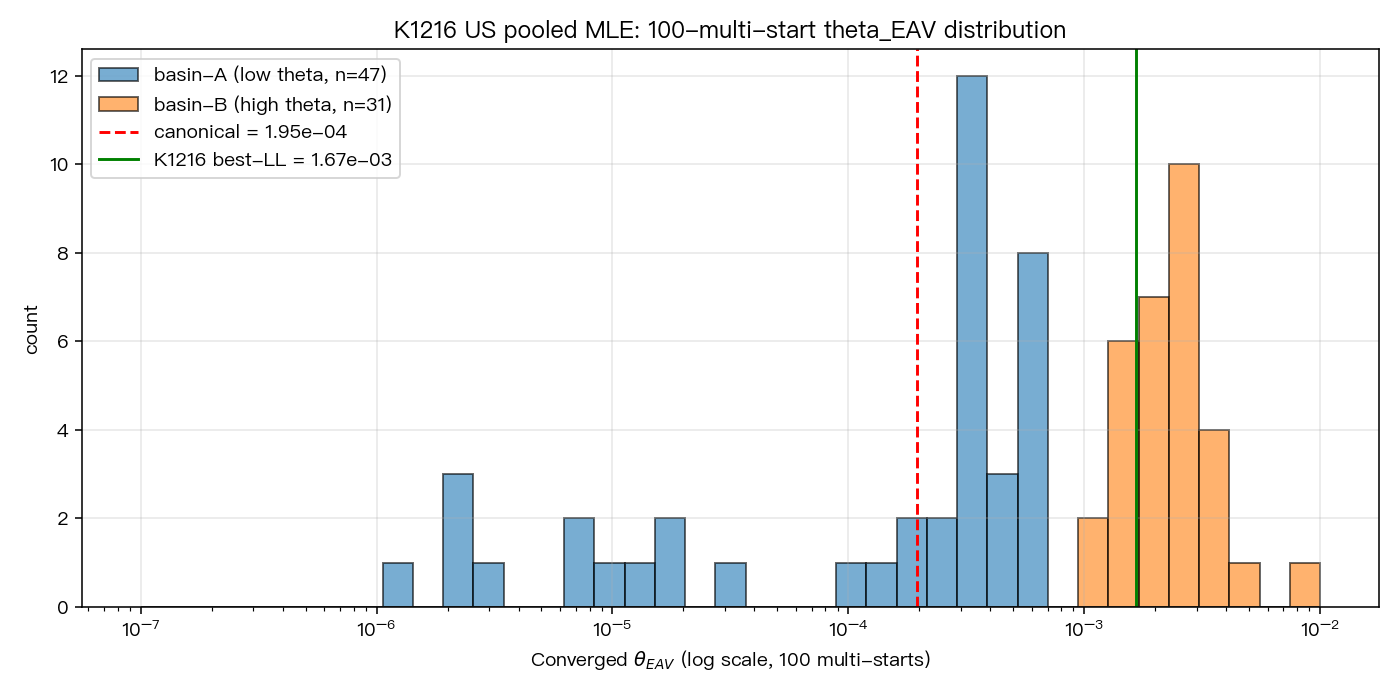
圖 2:US 市場 79 個收斂點的 θ_EAV 分布。雙峰結構明顯,basin-A (60%, 低 θ) 與 basin-B (40%, 高 θ) 中間有斷層。default init 的 single-start 系統性落在 basin-A,唯有 random log-uniform 撒點才能踏進 basin-B 的高 LL 區。
Basin 結構:為什麼單次失敗
US 的 79 個收斂點被 K-means 分成兩個 basin:basin-A 占 60%、θ_EAV 平均 2.04×10⁻⁴、LL max 79984;basin-B 占 40%、θ_EAV 平均 2.45×10⁻³、LL max 80402—— basin-B 的最差點幾乎等於 basin-A 的最好點 。default init 從低 θ 區起跑,梯度下降的斜率把它牢牢拉進 basin-A,永遠看不到 basin-B。唯有隨機 log-uniform 撒點,才能讓約 40% 的 starts 踏進 basin-B 的高 θ 山坡。這不是估計雜訊,是似然面拓撲本身雙峰。
K1213 AU 的 θ_EAV histogram 最清楚:兩個峰中間有明顯斷層,K1171 的 3.16×10⁻⁵ 落在兩個 basin mean 以下的山谷。換句話說 single-start 的「解」常常 既不是 basin-A 的最佳、也不是 basin-B 的最佳,而是兩個 basin 之外的梯度停滯點 。這種拓撲在 shared-MIDAS + stock-FE-GJR 聯合似然面上是 feature 不是 bug——只要有 stock fixed effects 共享 θ_EAV,似然面就有機會長出多個局部凹陷。
實務 takeaway
給做跨市場 GARCH-MIDAS pooled MLE 的研究者:
- 禁用單次 L-BFGS-B 。至少 50 starts、建議 100,seeds 在
log10(θ_EAV) ∈ [-6, log10(5×10⁻⁴)]log-uniform 撒;α/γ/β 保守區間(0.02–0.10, 0.80–0.92)避免 persistence wall。 - 報告 basin structure 。K-means(K=2) on (θ_EAV, LL)、per-basin LL max、LR vs canonical——讓讀者判斷估計可信度。
- 對稱 refinement 。跨市場比較不能只 refine 一半,否則生出像 ρ=-0.071 這種 artefact。
M1 Max 上 9 市場 × 100 starts 只需 147 秒(K1216c 實測)。這個成本不值得省。
限制與結論
- 基底 spec 是 k1168/k1172 joint pooled shared-MIDAS + stock-FE-GJR;不自動外推到其他 pooled 設定(如 BCD)。
- N=13 Spearman power 有限,ρ=+0.379 與 +0.441 在 N=13 下統計學上無法區分。
- Multi-start 不保證 global optimum,只是大幅提高機率。
9/9 markets 全 fragile = 單次 L-BFGS-B 系統性失敗。Paper 2 §5 的跨市場 θ_rel 全面換成 multistart-refined 版本,primary Spearman 以 K1216c N=13 ρ=+0.379(p=0.20)為 honest 最終數字。K1213 AU 從 below-ladder 翻成 above-ladder、K1216b ρ=-0.071 artefact 都寫進 methodological appendix。
研究連結 :K1213 experiments/k1213/README.md、K1216b experiments/k1216b/README.md、K1216c experiments/k1216c/README.md
本文基於實驗 K1213 / K1216 / K1216b / K1216c(結果:experiments/k1216c/k1216c_results.json)。數據來源:yfinance (US/EU/JP/DEV)、TAIFEX 財報公告日 (TW)、EM 市場 parquet cache;期間:2010–2026;樣本:9 markets × 10 stocks × 2759–3911 obs,40–61 earnings events/stock。方法:GARCH-MIDAS shared-MIDAS A4f-EAV joint pooled MLE (k1168/k1172 spec) + 100 random starts (seeds 43–142) + Nelder-Mead refinement + K-means(K=2) basin identification + LR test vs χ²(1). Random seed base=42. Lookahead 防護:_pooled_negll shifts VIX²_{t-1} 與 EAV_{i,t-1}。
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊