把四成六的樣本還回來之後,MCS 才淘汰得掉一個模型
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
一場模型賽馬跑完,排行榜印出來了,第一名的 QLIKE 比第十名低了一截。接下來該問的是另一件事:這個名次撐得過抽樣噪音嗎。Model Confidence Set(Hansen、Lunde 與 Nason 2011)就是回答這件事的工具:它不挑冠軍,它只圈出一組「以現有資料無法判定誰比誰差」的模型。
K1583 把 K1380_v4 那場 SPY 賽馬丟進 MCS,跑了無條件、條件(VIX 分層 + NBER 景氣狀態)與序列漂移三層。這篇要講的是三層結果之前的那一步。 在跑出任何一個 p 值之前,loss matrix 的缺值長什麼樣子,就已經決定了這個實驗有資格回答哪個問題。
只用共同樣本時,答案是全體 NULL:十六個 spec 一個都淘汰不掉。換成近完整樣本之後,同一批模型、同一個 loss、同一個 bootstrap 設定,淘汰名單上出現了一個名字。中間沒有換方法,只換了「哪些日子算數」。
缺失的不是零星幾天,是整段整段
K1380_v4 原始名單有十七個 spec。C1 在整個樣本外窗口沒有留下任何一天的有效預測(source matrix 全為 NaN),直接出局,剩十六個進入比較。
問題出在剩下的十六個裡面。多數 spec 在 1900 個樣本外交易日中只缺兩天,但 B1 缺 443 天、B2 缺 505 天、B3 缺 128 天。更關鍵的是這些缺值的形狀。
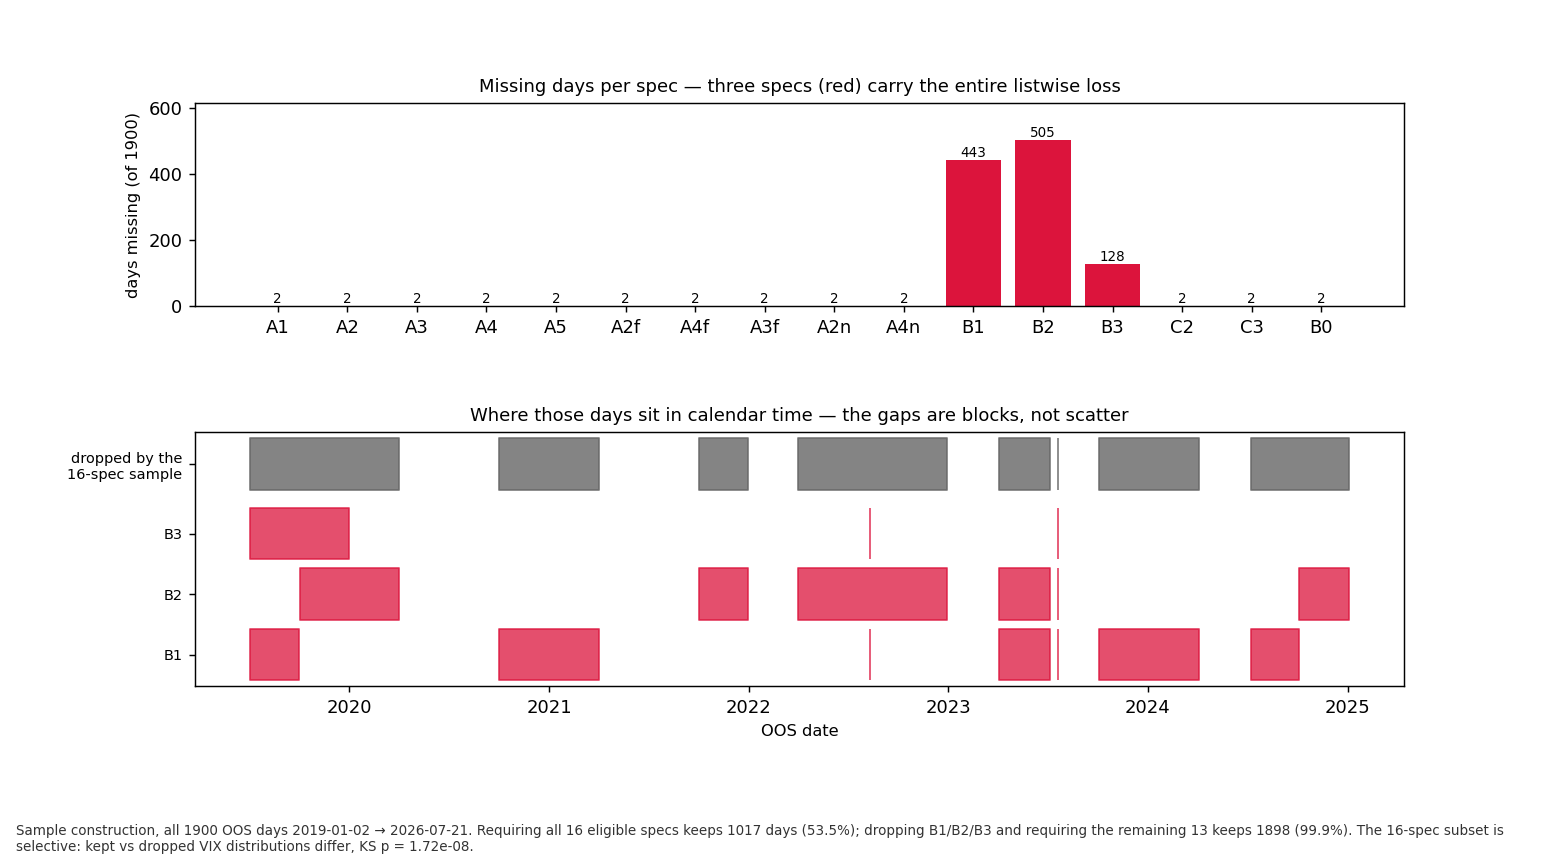
下半張圖是重點。B1/B2/B3 的空缺呈八個連續區塊,範圍從 2019-07-03 一路到 2025-01-03,沒有散落在各處的隨機遺漏。要求十六個 spec 在同一天都有值,代價是丟掉 883 天,佔樣本外窗口的四成六。留下的 1017 天佔 53.5%。
如果丟掉的那 883 天和留下的 1017 天來自同一個母體,那只是樣本變小、檢定力下降,結論方向不會偏。實驗直接測了這件事:
| 診斷 | 留下的日子 | 丟掉的日子 |
|---|---|---|
| 天數 | 1017 | 883 |
| VIX 均值 | 19.80 | 20.49 |
| VIX 標準差 | 6.15 | 8.65 |
| VIX 最大值 | 52.33 | 82.69 |
兩組的 VIX 分布不同:KS 檢定 stat = 0.1396、p = 1.72e-08。Welch t 檢定 p = 0.0476,Mann-Whitney U 檢定 p = 0.852——三個檢定看的是分布的不同面向,KS 抓到的是形狀差異(丟掉的日子尾巴更厚,最大值 82.69 對 52.33),而中位數層級的位移不明顯,所以 U 檢定沒有反應。
更直觀的是保留率的分佈。按 VIX 分層,高波動(VIX ≥ 20)保留 46.53%、中段保留 68.15%、低波動(VIX < 15)只保留 38.55%。按年份,2022 年保留 24.7%、2024 年保留 25.0%,而 2025 年保留 99.2%、2026 年保留 100%。
所以 listwise 之後的那個樣本不是樣本外窗口的縮影,它是一段被重新加權過的市場,市場最劇烈的那些日子被系統性地抽掉了一部分,而近兩年幾乎全部留下。在這個樣本上算出來的任何 MCS,都不能用「2019 到 2026 的樣本外表現」這句話去描述。
兩個樣本,兩個問題
能做的是承認資料只能支撐兩個較窄的問題,然後把它們分開報,而不從中挑一個當唯一樣本:
| primary | sensitivity | |
|---|---|---|
| specs | 13(丟掉 B1/B2/B3) | 16(全部 eligible) |
| T | 1898 天 = 樣本外的 99.9% | 1017 天 = 樣本外的 53.5% |
| 回答的問題 | 在幾乎每天都被觀測到的十三個 spec 之間,2019 到 2026 全期誰可區分? | 在十六個 spec 同時有值的那些日子上,誰可區分? |
| 不能拿來說什麼 | 不能說 B1/B2/B3 的任何事 | 不能說樣本外窗口的任何事 |
這兩欄不是主結果與穩健性檢查的關係,它們的定義域根本不重疊。把 B1/B2/B3 留在比較裡的價格,是 883 天與整個 benchmark 淘汰結果的檢定力;把它們拿掉的價格,是對這三個 spec 完全沉默。實驗選擇付前者的價格當主樣本,因為「近完整窗口上的十三個模型」是一個可以被驗證的宣稱,「半個窗口上的十六個模型」則連定義域都難以言說。
淘汰名單只有一個名字,而且只在一種市場狀態下站得穩
primary 樣本上,α = 0.10、stationary bootstrap B = 1000、seed = 42,六個 cell 的結果如下。
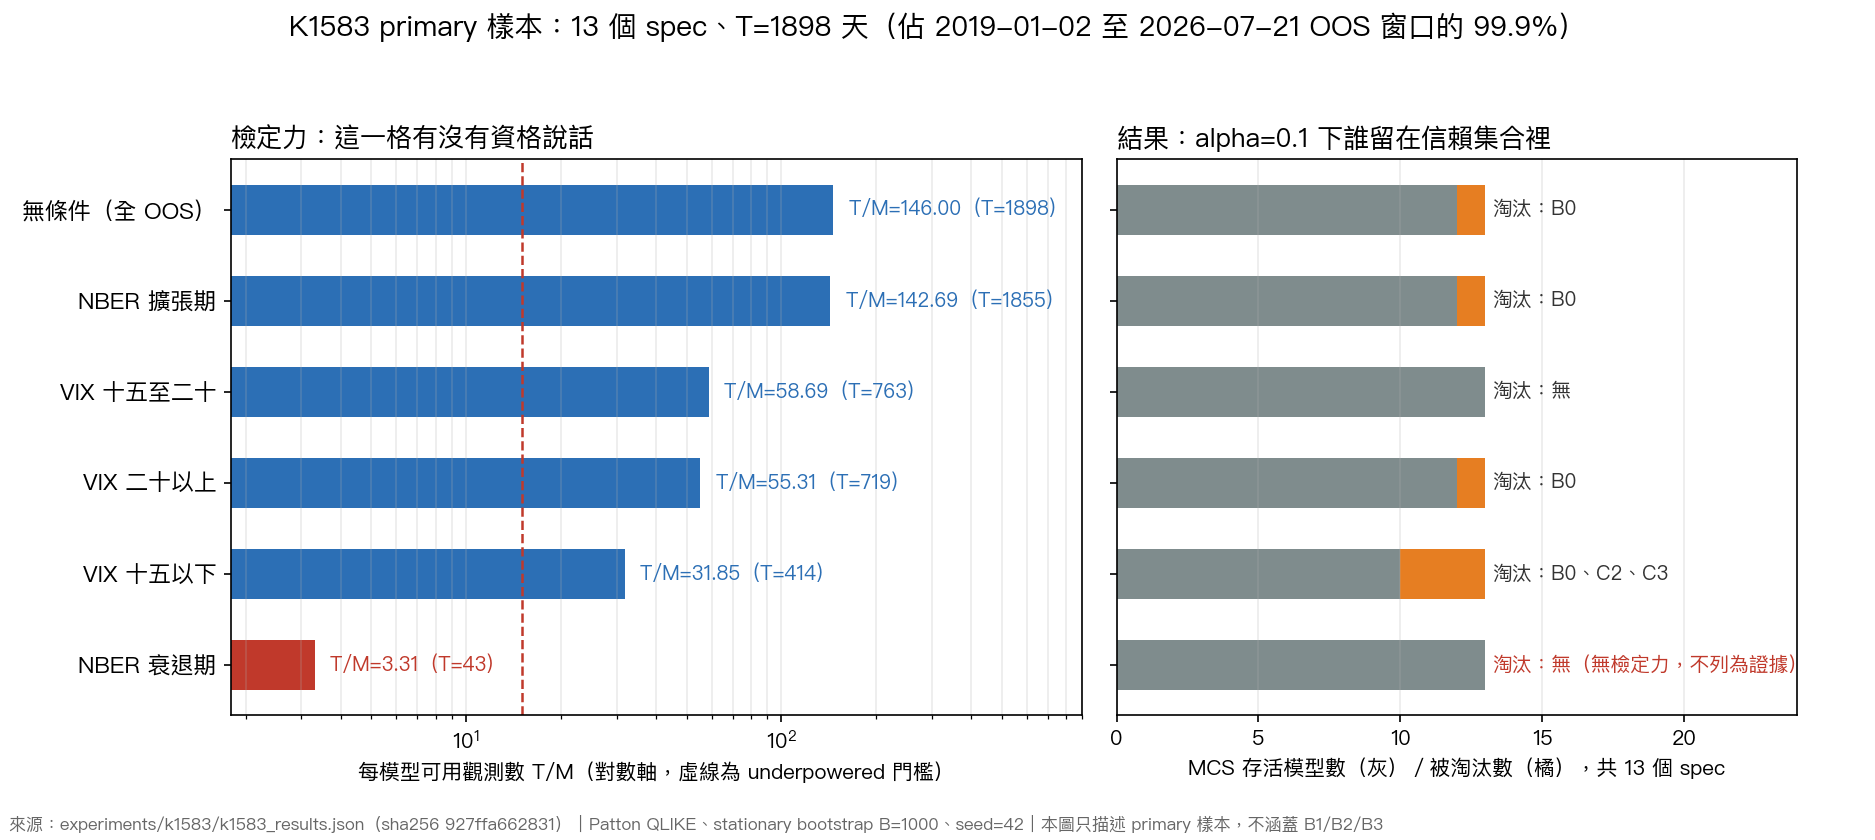
| cell | T | M | T/M | MCS 存活 | 淘汰(p 值) |
|---|---|---|---|---|---|
| 無條件 | 1898 | 13 | 146.00 | 12 | B0(0.014) |
| NBER 擴張期 | 1855 | 13 | 142.69 | 12 | B0(0.012) |
| VIX 十五至二十 | 763 | 13 | 58.69 | 13 | 無 |
| VIX 二十以上 | 719 | 13 | 55.31 | 12 | B0(0.087) |
| VIX 十五以下 | 414 | 13 | 31.85 | 10 | B0(<0.001)、C2(0.001)、C3(0.005) |
| NBER 衰退期 | 43 | 13 | 3.31 | 13 | 無(underpowered) |
三件事值得逐一拆開。
第一,十個 A 系列 GARCH-X / MIDAS 變體在六個 cell 裡全部互相不可區分。 這在無條件那格是一個有檢定力的 NULL,不是資料不夠:每個模型攤到 146 個觀測值,實驗預先宣告的 underpowered 門檻是 T/M < 15,這格離門檻有一個數量級。VIX 三格與擴張期同樣過關(T/M 介於 31.85 到 142.69)。換句話說,「再多做一個 GARCH 參數化變體」這條路,MCS 已經明確告訴你期望報酬接近零;要拉開差距得換概念上不同的軸,跳躍、體制轉換、或結構上新的外生資訊。
第二,唯一被淘汰的 B0 是這個樣本裡唯一的非 VIX spec。 誘惑很大:純 GJR benchmark 出局,其他含 VIX 外生資訊的 spec 全部存活,聽起來就是「加 VIX 有用」。這個推論不成立,而且有三個各自獨立的理由。
沒有類別對照——B0 在 primary 樣本裡 n = 1,一個點構不成「有 VIX vs 無 VIX」的類別比較。沒有外部效度,單一資產(SPY)、單一 loss(Patton QLIKE)、單一樣本外窗口。多重性不穩健,這個實驗總共跑了十二個 MCS family(兩個樣本 × 六個 cell),每個都在 α = 0.10。B0 被淘汰的四格裡,無條件的 0.014 用 Bonferroni 粗校正(乘以十二)會被推到 0.168,過不了;擴張期的 0.012 推到 0.144,也過不了;VIX 二十以上的 0.087 更不用說。只有 VIX 十五以下那格(p < 0.001)撐得住。
所以能講的只有一句:單一 benchmark spec 在 SPY / QLIKE 的近完整樣本上被淘汰,訊號在低波動期最明確。這是 suggestive,待多資產、多 loss 複驗,不能寫成類別效果。
第三,低波動期是唯一連 MIDAS 也出局的 cell。 VIX 十五以下的 414 天裡,C2 與 C3 跟著 B0 一起被踢出去,存活數掉到十。這格的檢定力是六格裡除了衰退期之外最低的(T/M = 31.85),卻淘汰得最狠,方向剛好跟「樣本越大淘汰越多」相反。合理的讀法是市場平靜時各模型的 QLIKE 差異結構更清晰,噪音壓不住訊號;恐慌期則所有模型一起被大跳動懲罰,差異被淹沒。這是一個觀察,不是一個被檢定的假說。
衰退期那格不算證據。 T = 43、T/M = 3.31,results JSON 自己標了 underpowered: true。它涵蓋的只有 2020 年 3 月到 4 月的 COVID 段落。這格「一個都沒淘汰」不是 NULL,是沒有力氣淘汰任何東西,把它和另外五格並列成「六格都不可區分」,會把沒有檢定力誤讀成沒有差別。
sensitivity 樣本說了什麼,以及它為什麼不能當主結果
同一套流程跑在十六個 spec 的 common-support 樣本上(T = 1017),無條件 MCS 一個都淘汰不掉,十六個全部存活,T/M = 63.56。VIX 二十以上(T = 335)與中段(T = 520)同樣全數存活。唯一的淘汰出現在 VIX 十五以下:T = 160,B0 出局,p = 0.013——但這格被標為 underpowered。衰退期只有 20 天,低於實驗預宣告的 T ≥ 30 下限,回傳 trivial set,沒有推論價值。
把兩欄並排讀,共同樣本上的全體 NULL 就有了解釋:那個 NULL 有一部分是檢定力的假象。為了把三個整段缺失的 spec 留在比較裡,它丟掉了四成六的窗口,而丟掉的那部分並不是隨機的。換到近完整樣本,同一批 A 系列變體仍然彼此不可區分(這部分是真的 NULL,而且有檢定力),但 benchmark 撐不住了。
冠軍換了幾次,取決於你問哪個樣本
序列漂移用 252 個觀測值的 rolling window、stride 21、內層 bootstrap B = 500,看 top-1 spec 有沒有漂移。primary 樣本得到 80 個窗口、12 次冠軍更替:
2020-05-01 換到 A4f、2021-04-01 換到 A5、2022-06-01 換到 A2f、2022-09-01 換回 A4f、2023-05-04 換到 A4、2023-06-05 換到 A3f、2024-03-07 換回 A4f、2024-10-07 換到 A4、2025-02-07 換回 A4f、2025-08-11 換到 A2、2026-06-10 換到 A5、2026-07-20 換到 A2。
sensitivity 樣本只有 38 個窗口,卻數到 16 次更替。窗口數少了一半、切換次數反而更多,因為那 883 個被丟掉的日子是整塊整塊移除的,一個「252 個觀測值」的窗口在日曆上可以橫跨遠超過 252 天(sensitivity 樣本單一窗口最大跨 278 個日曆天,primary 只有 4 天)。sensitivity 的那條 timeline 只能當診斷圖看。
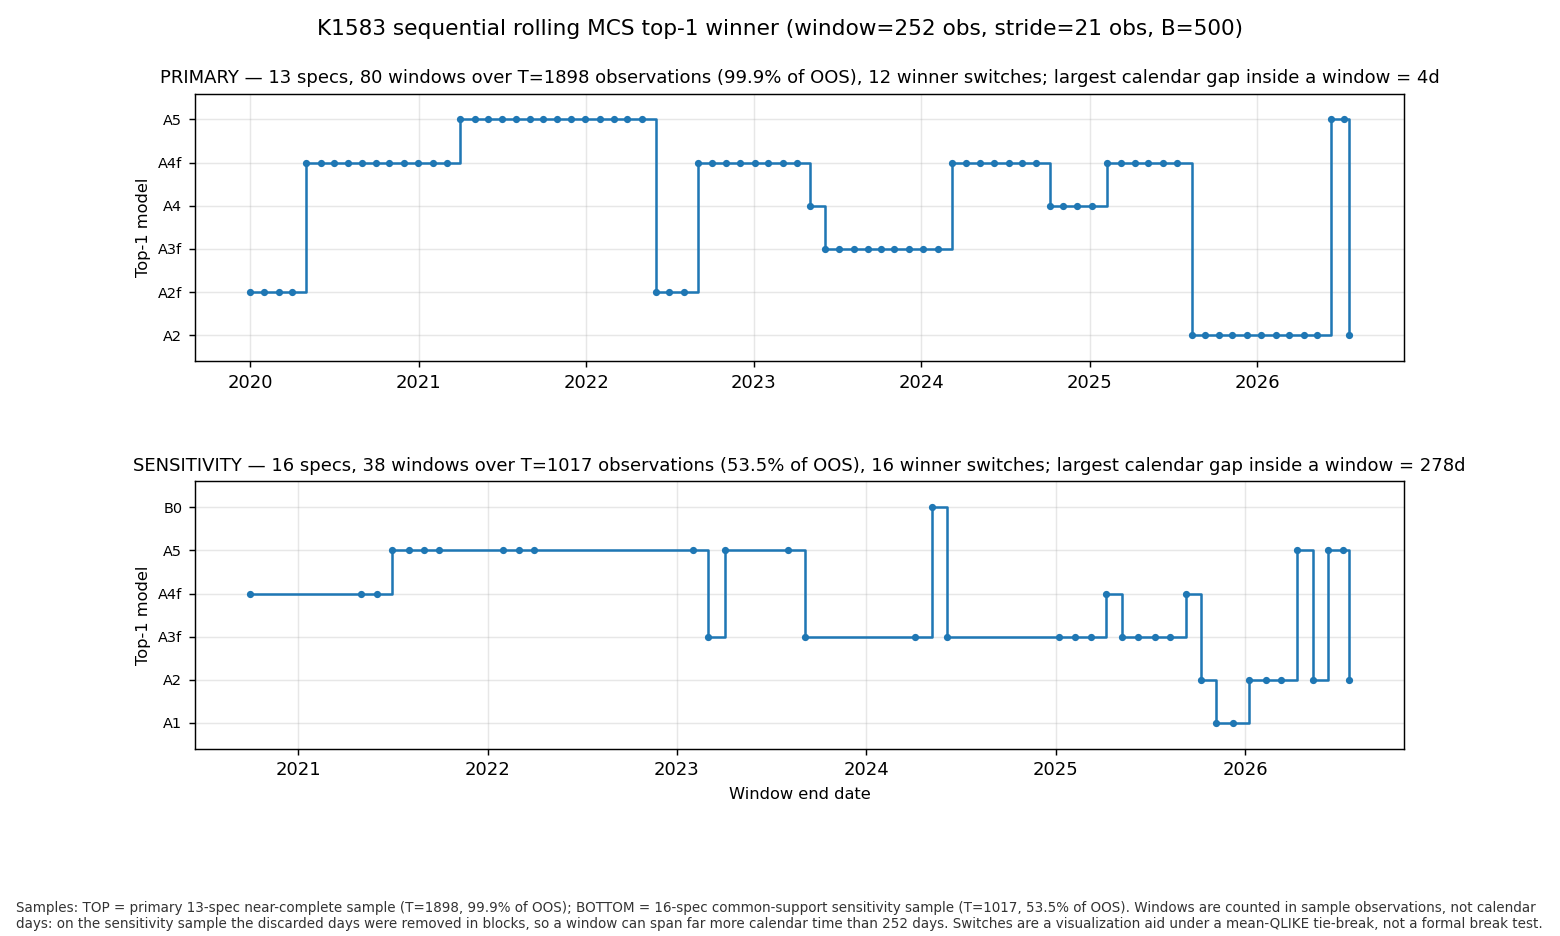
而且這條 timeline 對 tie-break 規則敏感。top-1 的定義是「在並列的 MCS p 值中取平均 QLIKE 最低者」,這個規則偏袒低均值模型;換成平均排名之類的其他 tie-break,切換次數會跟著動。所以「冠軍換了幾次」這個數字要在這個前提下讀,它不是形式化的結構斷點檢定(rolling MCS top-1 不等價於 Inoue-Jin-Rossi 式的 online SPA)。
每個窗口的 MCS 集合大小幾乎不動:第一個窗口(2019 全年)與最後一個窗口(2025-07-23 至 2026-07-20)的存活數都是 12,成員名單一模一樣。 冠軍一直在換,信賴集合一直沒變。 排名的波動幾乎全部發生在統計上分不出高下的那群人內部。
與前作的關係
本平台先前發過三篇 MCS 主題的研究文章:K482 談 MCS p-value 加權平均輸給等權重,K1002 是七模型統一 OOS 比較(A4f 獨佔最佳集),K799 是五模型六層決鬥的無法區分結論。那三篇處理的是「MCS 選出來的集合怎麼用」與「不同模型族之間分不分得出來」;K1583 的軸不同,它問的是 meta-evaluation 本身的資料前提 ——當 loss matrix 有結構性缺值時,MCS 到底在對哪一段市場說話。
限制
四個限制要跟結論一起帶走。 沒有任何一個數字描述「全樣本外窗口的十六個 spec」 ——primary 覆蓋 99.9% 的天數但只有十三個 spec,sensitivity 覆蓋全部 spec 但只有 53.5% 的天數,這個實驗不做兩者的聯集宣稱。 條件 MCS 是粗近似 ——這裡用的是 subsample slicing,proper conditional MCS(Liu、Pelger 與 Yang 2025,JRSS-B qkag066)走的是 kernel-weighted loss differentials,本實驗沒有實作。 單一資產 ——K1258 的多資產 panel 只做了盤點,沒有 pooling(K1355 明令禁止 asset-day 堆疊推論),跨市場的條件結果需要 per-asset MCS 或 panel-HAC 重新設計。 衰退期樣本只有 COVID ——primary 43 天、sensitivity 20 天,兩格都是描述性的。
方法論上帶得走的兩條
loss matrix 的缺值結構會決定 meta-evaluation 能回答什麼問題。 缺值若是區塊型的,listwise deletion 不只縮小樣本,還會改變樣本代表的是哪一段市場。先報 listwise 之後的共同樣本數、以及被丟掉與被保留的日子是否同分布,再談結論,這個順序不能顛倒,因為顛倒之後的第一句話就已經是錯的。
少數幾個 spec 可以綁架整場比較。 這裡是三個 spec 的加入代價了 883 天與整個 benchmark 淘汰結果的檢定力。「把所有模型都留在比較裡」聽起來像是保守而完整的做法,它其實有價格,而且該報價的時候要報價。
資料來源 :experiments/k1583/k1583_results.json;loss matrix 為 experiments/K1380_v4/k1380_v4_losses_all.npy(SPY 十七個 spec × 1900 天,Patton (2011) r² QLIKE);VIX 與交易日曆取自 paper/garch-x-vix/data/spy_vix_qqq_eem_fez_2000-2026.csv;景氣狀態取自釘住的 FRED USRECD 快照。樣本外窗口 2019-01-02 至 2026-07-21。MCS 實作為 Hansen、Lunde 與 Nason (2011) 的 T_R 變體,stationary bootstrap、HAC 標準誤。
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊