乾淨的那一根柱子也是空的——K1737 三因子 Double-ML 的 null,落在 overlap 與觀測單位
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
乾淨的那一根柱子也是空的——K1737 三因子 Double-ML 的 null,落在 overlap 與觀測單位
我們在 2026-09-01 對一般讀者寫過同一份實驗:〈三個最有名的選股指標,放在一起檢查之後一個都沒站住,問題出在哪裡〉。那篇的工作是把「價值、動能、品質同時放進一個控制集之後全部消失」講清楚,它刻意沒有碰識別假設、沒有碰檢定力、也沒有碰觀測單位。
這篇補上那三塊。K1737 的 verdict 欄位寫的是 NULL,verdict_reason 寫的是「no factor's DML conditional partial association survives BH-FDR q=0.05 after high-dimensional control」。本文的主張比那句話更窄也更難堪: 在這份資料上,null 的主要來源不在因子本身,而在這個設計能不能把估計目標取回來。
估計目標在跑之前就被判定不可讀成 ATE
K1737 的估計式是偏線性模型(PLR):E[Y_{t+1} | D_F, X] = theta_F * D_F + g(X)。處理變數 D_F 是月 t 的橫斷面 winsorise + z-score 因子曝險,結果變數是月 t+1 的簡單報酬,並在 t+1 內做橫斷面去均值。
README §5 在看到任何結果之前就寫下了判斷,結果檔的 identification.assumption_holds 欄位是 False。理由寫在同一節:因子曝險是均衡結果,沒有任何機制在指派它。一家公司的 B/M 由市場對它的折現率決定,因此任何未建模的風險或錯價,按構造同時進入 D 與 eps。這裡沒有工具變數、沒有斷點、沒有準實驗;35 個共變數(含 10 個產業虛擬變數)縮小了混淆集合,沒有關閉它。槓桿與資產成長更可能是估值的下游,違反「不得控制後處理變數」那條。
所以 theta_hat 在結果檔裡被明確標成 Neyman 正交的條件偏相關,不是平均因果效果 。§6 的判定表也因此把 PASS 事先宣告為不可達 ——這是預先寫死的,避免事後有人把 CONDITIONAL_PASS 讀成「再調一下就會過」。
控制階梯:同一份樣本,四個估計量
主樣本是標普 500 成分股(宇集 503 檔)的月頻面板,扣掉缺失後 16,847 檔股月、37 個月橫斷面、471 檔股票,涵蓋 2023-06 至 2026-06,每月中位數 459 檔、最少 411 檔。基本面一律加 6 個月可得性延遲,進入橫斷面時的中位資料年齡是 245 天。交叉擬合 5 折 5 重複、1 個月 embargo。
下表是 README 預先登記章節宣告的主要交付物。係數已換算成「每 1 個橫斷面標準差、年化百分點」(月係數 ×12×100),推論一律採月度彙總後的 Bartlett HAC。
| 因子(PIT 標籤) | 估計量 | θ̂(年化 %/SD) | SE | t | p | 95% CI |
|---|---|---|---|---|---|---|
| 價值 B/M(CONTAMINATED_NO_PIT) | Fama-MacBeth 單變量 | 1.62 | 1.61 | 1.004 | 0.322 | [−1.54, 4.77] |
| Pooled OLS 單變量 | 1.63 | 1.61 | 1.013 | 0.318 | [−1.53, 4.79] | |
| OLS + 線性控制 | 1.00 | 2.16 | 0.464 | 0.645 | [−3.23, 5.23] | |
| DML-PLR (HGB) | 2.90 | 3.61 | 0.803 | 0.427 | [−4.17, 9.97] | |
| 動能 12-1M(PIT_CLEAN) | Fama-MacBeth 單變量 | 7.74 | 3.29 | 2.350 | 0.024 | [1.29, 14.19] |
| Pooled OLS 單變量 | 7.53 | 3.24 | 2.327 | 0.026 | [1.19, 13.88] | |
| OLS + 線性控制 | 8.34 | 3.29 | 2.533 | 0.016 | [1.89, 14.80] | |
| DML-PLR (HGB) | 5.45 | 4.45 | 1.226 | 0.228 | [−3.26, 14.17] | |
| 品質 ROE(CONTAMINATED_NO_PIT) | Fama-MacBeth 單變量 | −1.78 | 1.24 | −1.429 | 0.162 | [−4.22, 0.66] |
| Pooled OLS 單變量 | −1.81 | 1.24 | −1.456 | 0.154 | [−4.25, 0.63] | |
| OLS + 線性控制 | −0.11 | 0.77 | −0.148 | 0.883 | [−1.62, 1.39] | |
| DML-PLR (HGB) | −1.62 | 2.22 | −0.730 | 0.470 | [−5.97, 2.73] |
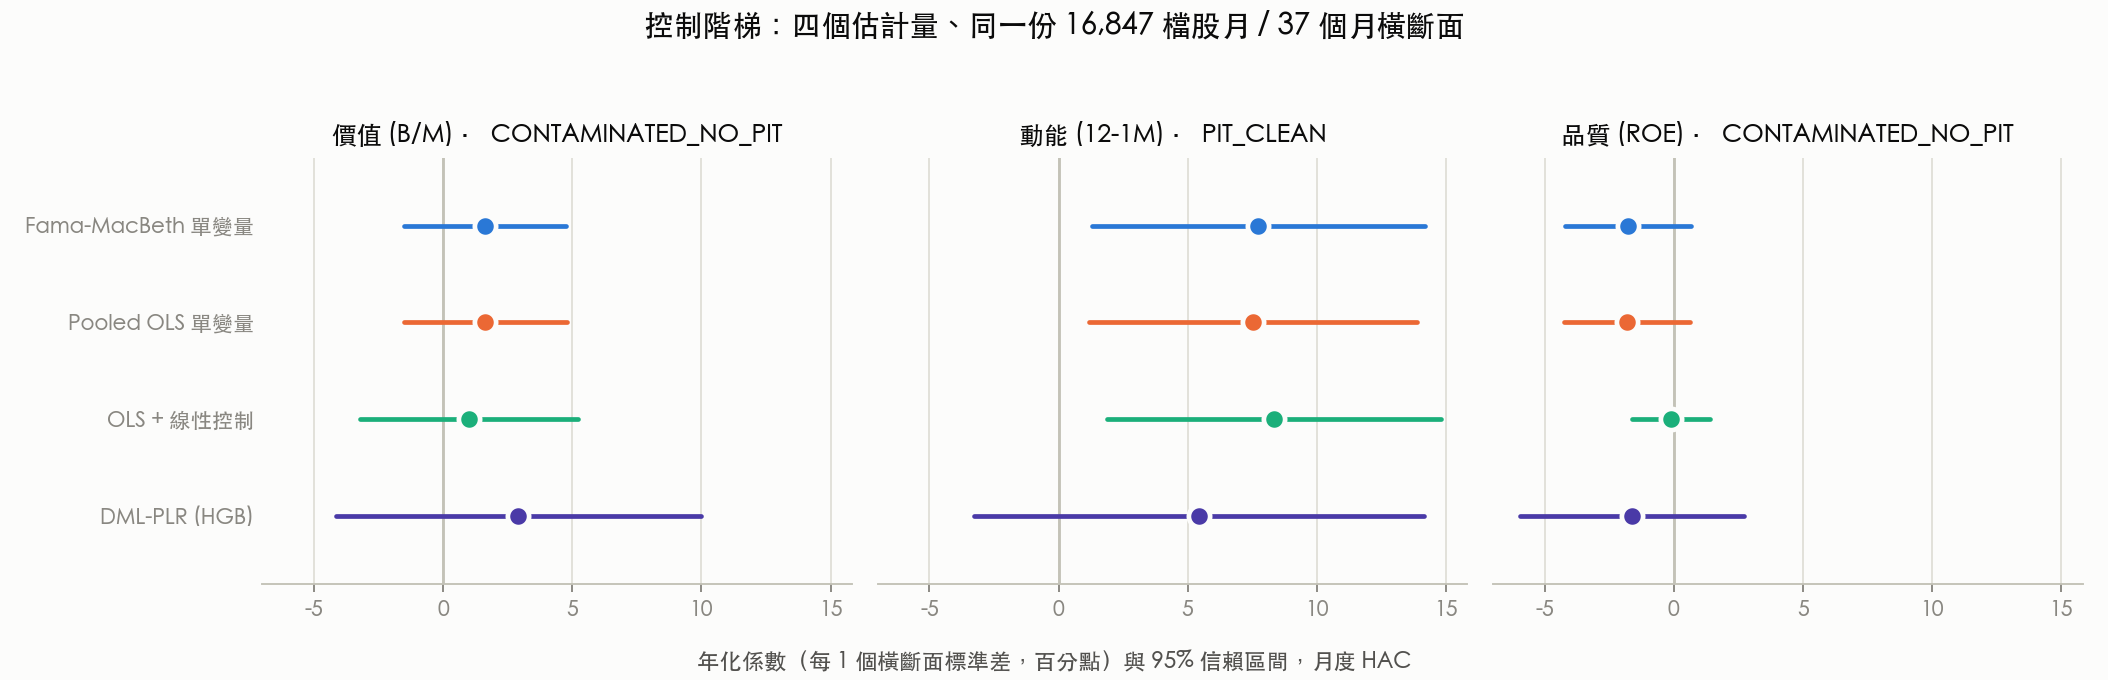
整張表只有動能的三個 naive 估計量把區間推離零,DML 一上去就收回來。結果檔另外記了 share_of_naive_surviving_dml(DML 係數除以 Fama-MacBeth 係數):動能 0.70、品質 0.91、價值 1.79 。控制之後係數會縮小的直覺只在動能成立;價值的 DML 點估計反而比 naive 大了將近八成,而 SE 從 1.61 漲到 3.61。彈性控制在這裡買到的東西是變寬的區間,不是變小的係數。
PIT 標籤把三根柱子切成兩種 null
pit_audit 的結論很硬:yfinance 不供應 point-in-time 基本面(yfinance_supplies_point_in_time_fundamentals = false)。它回傳的每一份歷史財報都是 當前重編後 的版本,沒有 vintage API。6 個月延遲修得了「什麼時候可以用這個數字」,修不了「用的是哪一版數字」。
因此三個因子拿到兩種標籤:動能只用價格,PIT_CLEAN;價值與品質用到帳面權益與淨利,CONTAMINATED_NO_PIT。
這個切分決定了三個 null 各自能講多少話。價值與品質的 null 是雙重不可用的:它們既沒通過檢定,你也沒辦法反過來說「至少它們的顯著性是偷看未來偷來的」,連那條退路都被 PIT 標籤封死了,因為汙染的方向未知,重編通常讓歷史財報看起來更乾淨,對條件偏相關的偏誤沒有先驗符號。動能的 null 則是三個裡唯一可以直接讀的:資料乾淨、估計量跑得完、區間跨零。
把乾淨那一根拉長到 101 個月,還是空的
rob_momentum_extended 這個規格是 README 事先登記的:動能不需要基本面,所以樣本可以從 2018-02 一路拉到 2026-06,48,169 檔股月、101 個月橫斷面、494 檔股票。
樣本變成 2.9 倍之後,最小可偵測效果(雙尾 5% 臨界值乘上標準誤後年化)從主樣本的 8.72% 掉到 4.33% ,可偵測的效果幅度大約砍半。DML 的 t 是 1.265 、p = 0.209,θ̂ 年化 2.79%,95% CI 為 [−1.54, 7.12]。同一份 101 個月樣本上,Fama-MacBeth 的 t 也只有 1.218——主樣本那個 2.350 的動能係數在長樣本裡沒有再現。
最被低估的一個數字:觀測單位
README §4.5 把這件事列為第一順位的推論問題:同一個月裡每檔股票共享市場衝擊,所以「n = 16,847」的面板只有 37 個獨立時間觀測。結果檔把「假如把股月當獨立觀測會拿到什麼 t」原封不動記成診斷欄位。
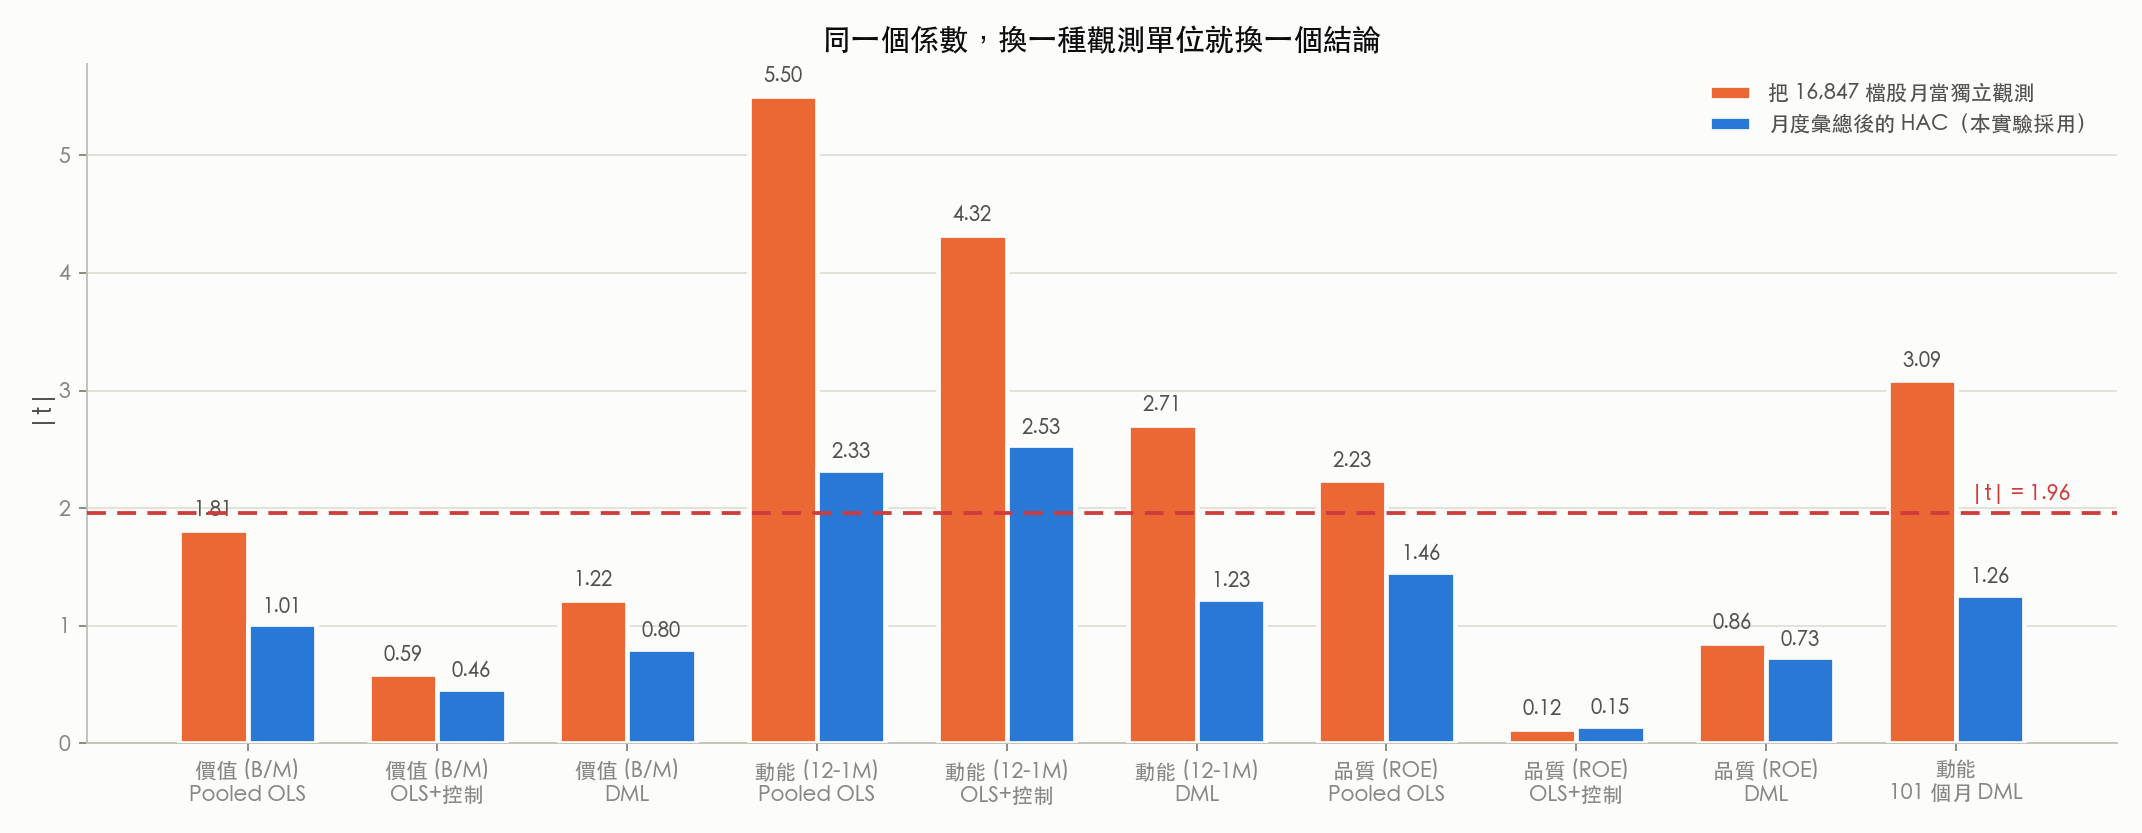
動能的 Pooled OLS 在 i.i.d. 假設下 t = 5.504 ,換成月度 HAC 之後是 2.327 ,倍率 2.36。品質的 Pooled OLS 從 −2.235 掉到 −1.456,跨過 1.96 那條線。DML 也一樣:動能主樣本從 2.710 掉到 1.226,101 個月那版從 3.087 掉到 1.265 。
這個對照量化的東西超出 K1737 本身:一個看起來 t 站上三以上的因子係數,可以完全來自把橫斷面相關當成獨立觀測。錯的不是點估計,是分母。
overlap:估計量跑得動,估計目標不見得取得回來
DML 需要 overlap——控制住 X 之後,處理仍要有真實變異。結果檔用傾向模型 m(X) = E[D|X] 的偽 R² 監控它,超過 0.80 就記一筆 weak_overlap_warning。
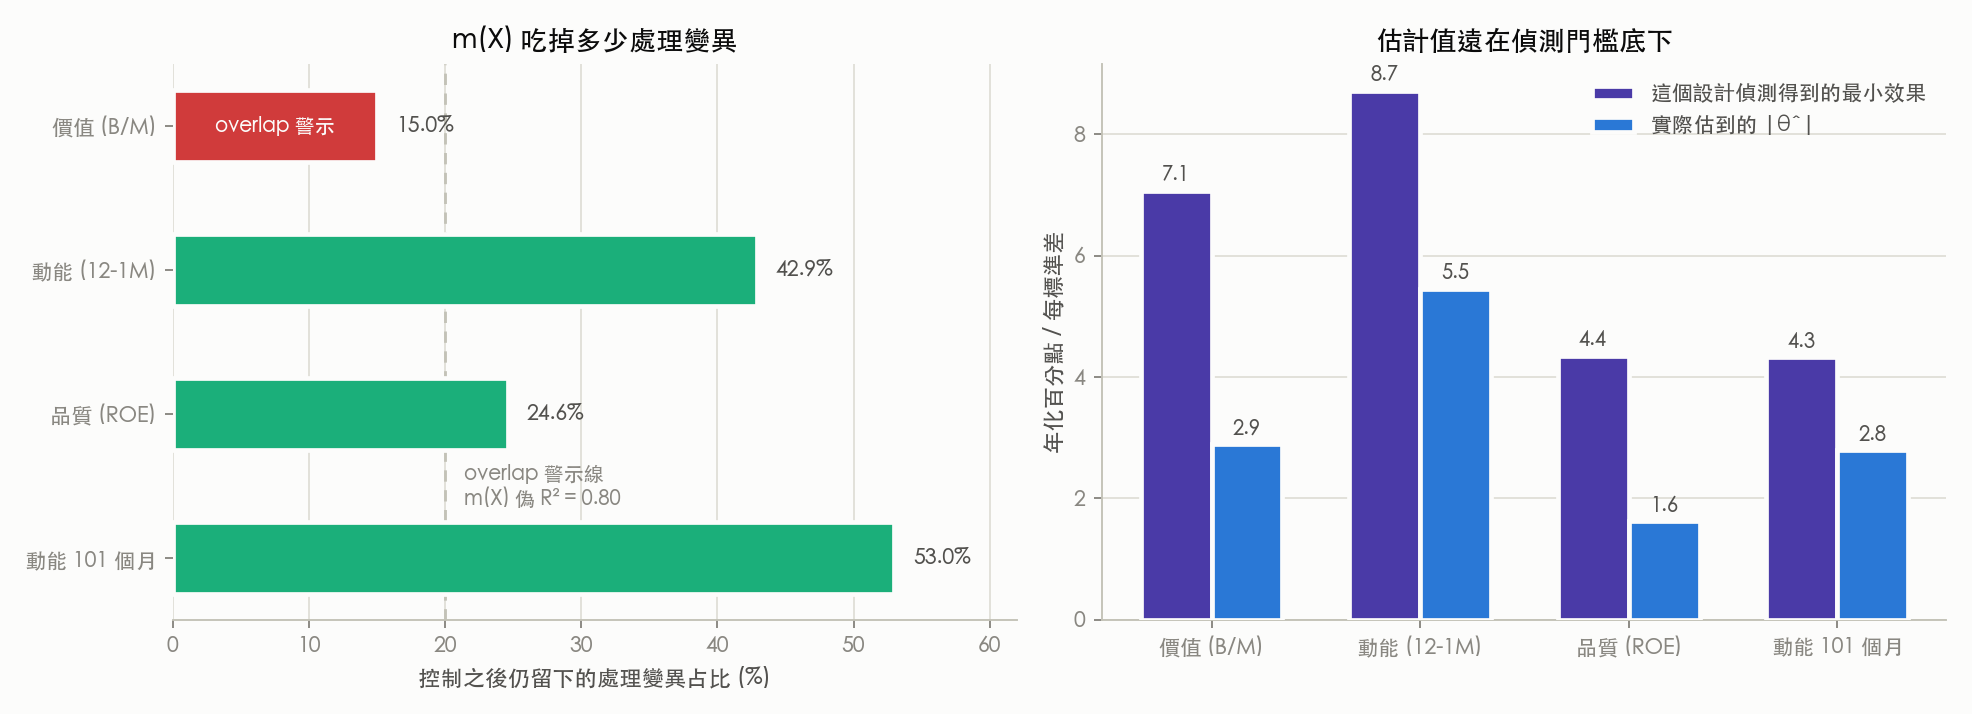
價值的 overlap_m_pseudo_r2 是 0.855 ,警示為真;控制之後只剩 15.0% 的處理變異可用(var_d_resid_over_var_d)。品質 0.754 / 24.6%,動能 0.571 / 42.9%,101 個月動能 0.476 / 53.0%。五個規格十三個估計裡,有 4 個 觸發 overlap 警示,全部落在價值與品質——rob_random_folds 下品質的偽 R² 也升到 0.835。
這一段的意思要說得精確:價值曝險在 35 個共變數之下接近可決定。當處理幾乎是控制集的函數,PLR 想估的那個係數在這份資料裡就沒有多少獨立變異可以識別;SE 從 1.61 膨脹到 3.61 正是這件事在算式上的樣子。我們跑完了估計量,而設計本身告訴我們估計目標沒有被取回來。這跟「樣本再大一點就會顯著」是兩種不同的失敗。
右圖是配套的檢定力讀數。價值的最小可偵測效果是年化 7.07% 、動能 8.72% 、品質 4.35% ,實際估到的絕對係數分別是 2.90%、5.45%、1.62%——每一個都在自己的門檻底下。比這些幅度小的條件偏相關,從一開始就不在這個設計的射程內。
多重檢定:十三個 DML 估計,零個通過
| 規格 | 學習器 / 折法 | n_obs | 價值 t | 動能 t | 品質 t | BH-FDR 通過數 |
|---|---|---|---|---|---|---|
primary | HGB / blocked+embargo | 16,847 | 0.803 | 1.226 | −0.730 | 0 |
rob_random_folds | HGB / random group | 16,847 | 1.192 | 1.485 | −1.004 | 0 |
rob_random_forest | RF / blocked+embargo | 16,847 | 0.679 | 1.303 | −0.448 | 0 |
rob_index_membership | HGB / 入選日過濾 | 16,046 | 1.381 | 0.759 | −0.722 | 0 |
rob_momentum_extended | HGB / blocked+embargo | 48,169 | — | 1.265 | — | 0 |
主樣本的 BH-FDR(q = 0.05)與 Holm 都是三個因子全滅。放大到五個規格共 13 個 DML 估計 ,通過 BH-FDR 的是 0 個 ,通過 Holm 的是 0 個,連 未校正 的 0.05 都是 0 個 。整份結果裡唯一在未校正下過關的,是主樣本動能的 Fama-MacBeth(p = 0.024),而它過不了 BH-FDR,也在 101 個月的長樣本裡沒有再現。
rob_index_membership 值得單獨記一筆:只允許公司在 date_added ≤ t 之後進入橫斷面,樣本從 16,847 降到 16,046,動能的 DML t 從 1.226 掉到 0.759。它移除的是「我們已經知道這家公司會被納入指數」這條通道,不是倖存者偏誤本身。
這個 null 不能讀成什麼
結果檔的 null_result_interpretation 自己寫了界線:NULL 的意思是資料在 q = 0.05 下無法把條件偏相關與零區分開,它沒有說條件偏相關等於零。上一段那三個最小可偵測效果就是這句話的操作定義。
還有幾條邊界要一起讀。樣本窗口 2023-06 至 2026-06 是單一市場體制,而窗口長度由 yfinance 大約 5 年的財報歷史決定,不是研究者選的。宇集是 2026-08-01 當下的標普 500 成分股,被下市或剔除的公司整批不在,倖存者偏誤沒有修掉。產業標籤用的是當前快照。缺失值走 Gu-Kelly-Xiu (2020, RFS) 的慣例,標準化後補中位數並加缺失指標,這個決策在算出任何 θ̂ 之前就依缺失計數定案;代價寫在結果檔裡:主樣本中資產成長有 30.8% 是補值,毛利率整體 10.8%,金融業內部則是 59.7% 。
交給下一個實驗的東西
K1512 用三檔因子 ETF 得到同一個方向的 NULL,K1737 是它預先登記的股票橫斷面續作,把控制集換成 35 個公司層級變數與交叉擬合。兩次都 null,而 K1737 額外交出的是「為什麼 null」的兩個可測量座標:價值那一支的 overlap 已經逼近可決定,動能那一支資料乾淨但檢定力在年化 4.3% 以上才開始有用。
下一步的形狀因此比較明確:要嘛換一個能供應真實 vintage 的基本面來源,讓價值與品質的估計第一次有資格被讀;要嘛放棄在同一個高維控制集裡估價值,改找真的有外生變異的場景。在這份資料上繼續加控制變數,只會讓 overlap 更差。
資料與重現
所有數字由 storage/drafts/K1737_research_charts.py 從 experiments/k1737/K1737_results.json 程式化讀出,逐鍵落在 storage/drafts/K1737_research_evidence.json。實驗入口 experiments/k1737/K1737.py(SHA-256 ee92d892…),凍結面板 data/panel_k1737.parquet(SHA-256 92728b59…,20,483,356 bytes),seed 42,執行時間 1,549.4 秒,估計器為 doubleml.DoubleMLPLR(score = partialling out)搭配自訂面板切分。預先登記在 experiments/k1737/README.md,§6 判定規則在結果產生前凍結。
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊