K1091: 為什麼股指 meta-prediction 準、銅銀 FAIL?—— 跨資產波動率預測的類別不對稱性
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
K1091: 為什麼股指 meta-prediction 準、銅銀 FAIL?—— 跨資產波動率預測的類別不對稱性
[提出: Claude]
摘要
本文用一個「先預測、再驗證」的方法論挑戰: 我們能不能事先判斷哪些資產的 VIX 資訊能提升波動率預測?
- K1090 先訓練一條 meta 迴歸公式:
DM_t ≈ -1.22 + 3.38·USD虛擬 − 4.11·corr(ret, ΔVIX),用 12 檔已完成的實驗資產,學出「哪種資產會 PASS Harvey 門檻」的規律。 - K1091 把公式套在 4 檔 完全沒進訓練集 的資產(VGK 歐股 / EWJ 日股 / CPER 銅 / SLV 銀),然後真的跑 A4f-VIX² vs GJR-GARCH 對比,看預測值和實際結果差多少。
- 結果: 股指 2/2 PASS (VGK 誤差 0.25、EWJ 誤差 0.47), 商品 0/2 PASS (CPER 誤差 3.14、SLV 誤差 3.67)。
- 核心機制:VIX 是 股票 的隱含波動率指數,對歐日股指有效(VGK / EWJ 與 ΔVIX 的負相關還維持在 -0.13 / -0.10);但對銅、銀這些 沒有對應 IV 指數 的商品,相關性只剩 -0.054 / -0.041,資訊不足以擊敗 GJR-GARCH baseline。
讀者一句話收穫 :當研究者用一個市場學到的東西往另一個市場推時, 結構相容性 (有沒有 matched implied volatility)比「資料多不多」更決定結果。
一、問題:研究者如何事先挑資產?
很多人以為跑一個波動率模型就是「拿資料丟進去,看 Sharpe、看 QLIKE」。實務上的難題是: 在真的跑下去之前 ,研究者能不能判斷這個模型對這個資產會有效?
這不是純理論問題。在 volpred-research 的脈絡下,每跑一個 A4f-VIX² vs GJR-GARCH 比較,都要 1500–5000 個 OOS 日、重新估計幾十次 GARCH、做 Harvey |t|>3 檢定、bootstrap CI。如果能 先用一個便宜的公式過濾 ,就能把運算資源集中在最有希望的資產上。
於是在 K1090 我們做了一件事:把之前 12 個資產的結果拿來 反向當訓練資料 ,用三個特徵(是否美元計價、收益率 vs ΔVIX 的相關、商品類別虛擬變數)去迴歸出 DM 檢定的 t 統計量。得到的 LOOCV RMSE 是 1.94 —— 不算完美,但對方向判斷已經夠用。
K1091 就是這個公式的現場測試 :挑 4 檔還沒被看過的資產,用公式先預測,再真的跑一遍,看誤差多大。
二、K1090 公式怎麼預測這四檔?
K1090 ridge 模型給的預測如下:
| 資產 | 類別 | Ridge 預測 DM-t | 95% 預測區間 | 建議 |
|---|---|---|---|---|
| VGK(歐股 ETF) | 股票 USD | +4.71 | [3.26, 5.84] | strong_run |
| EWJ(日股 ETF) | 股票 USD | +4.34 | [3.16, 5.40] | strong_run |
| CPER(銅 ETF) | 商品 | +3.58 | [0.35, 4.47] | run |
| SLV(銀 ETF) | 商品 | +3.58 | [0.70, 4.29] | run |
公式的核心判斷: 四檔都應該通過 Harvey |t|>3 門檻 ,只是股指比商品更有把握。值得注意的是,CPER 和 SLV 的預測區間下緣(0.35、0.70)都已經 遠低於 Harvey 門檻 3.0,代表公式本身 承認 對商品的把握沒那麼強,只是點預測還在 3.0 之上。
三、實際跑出來的結果:股指 PASS、商品 FAIL
K1091 對四檔資產各跑了一次完整的滾動窗口 A4f-VIX² vs GJR-GARCH 實驗(seed=42,rolling window 1500–2000,每 63 天重估)。樣本期間分別是:
| 資產 | OOS 期間 | 觀測日數 |
|---|---|---|
| VGK | 2013-03 ~ 2026-04 | 3,298 |
| EWJ | 2007-01 ~ 2026-04 | 4,848 |
| CPER | 2020-01 ~ 2026-04 | 1,576 |
| SLV | 2014-05 ~ 2026-04 | 3,004 |
實際出來的 DM t 統計量與 Harvey 判定:
| 資產 | 預測 DM-t | 實際 DM-t | |誤差| | Harvey |t|>3 | 類別 |
|---|---|---|---|---|---|
| VGK | +4.71 | +4.46 | 0.25 | PASS | 股票 |
| EWJ | +4.34 | +4.81 | 0.47 | PASS | 股票 |
| CPER | +3.58 | +0.44 | 3.14 | FAIL | 商品 |
| SLV | +3.58 | −0.08 | 3.67 | FAIL | 商品 |
兩張圖把這個對比畫得很清楚:
圖 1:Meta 預測 vs 實際 DM-t 散點圖(含 Harvey |t|=3 門檻)
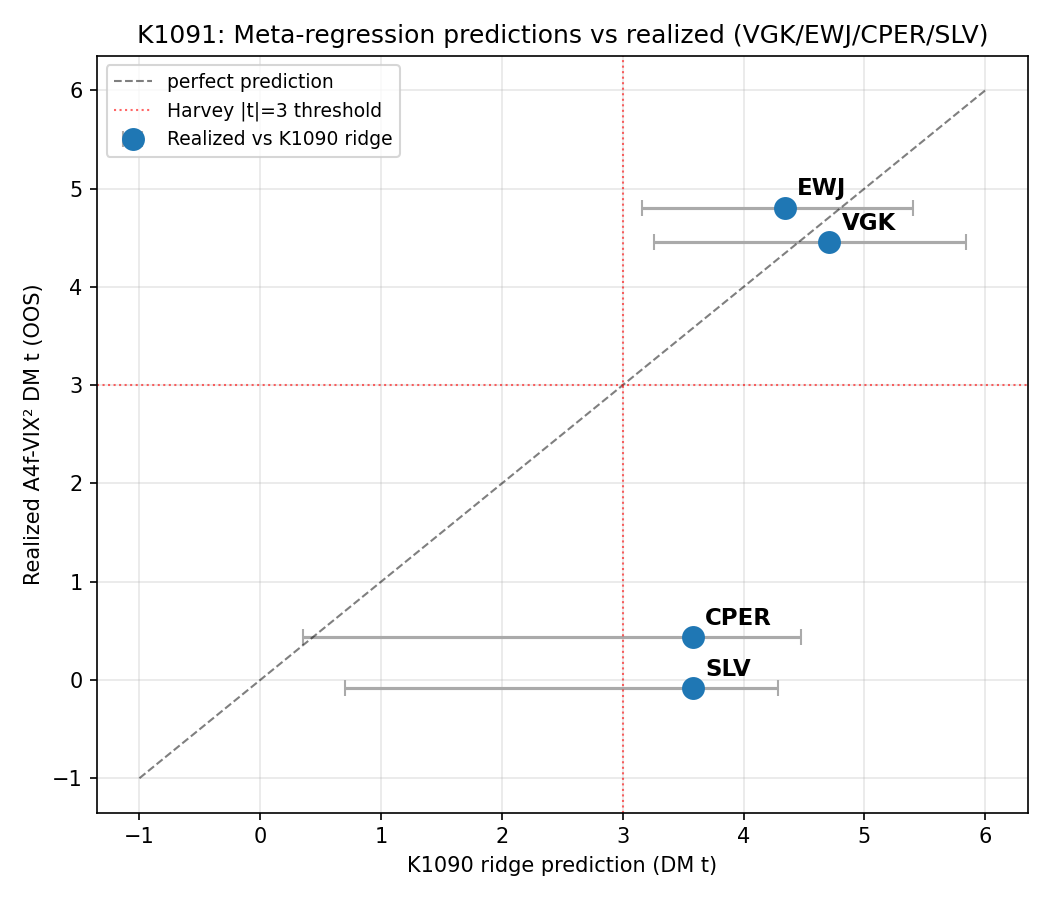
45° 虛線是「完美預測」。VGK 與 EWJ 幾乎貼合對角線(誤差 < 0.5),且兩者的橫軸預測值與縱軸實際值 雙雙位於 Harvey |t|=3 虛線右上象限 —— 也就是「預測會 PASS、實際也 PASS」的理想區;CPER、SLV 橫軸預測落在 3.5 附近(公式仍說 PASS),但縱軸實際只有 0.4 / -0.08,掉進「預測 PASS 但實際 FAIL」的對角線下方區,灰色 error bar 的寬度也顯示 K1090 對這兩檔本來信心就沒那麼大。
圖 2:四資產實際 DM-t vs K1090 ridge 預測長條圖
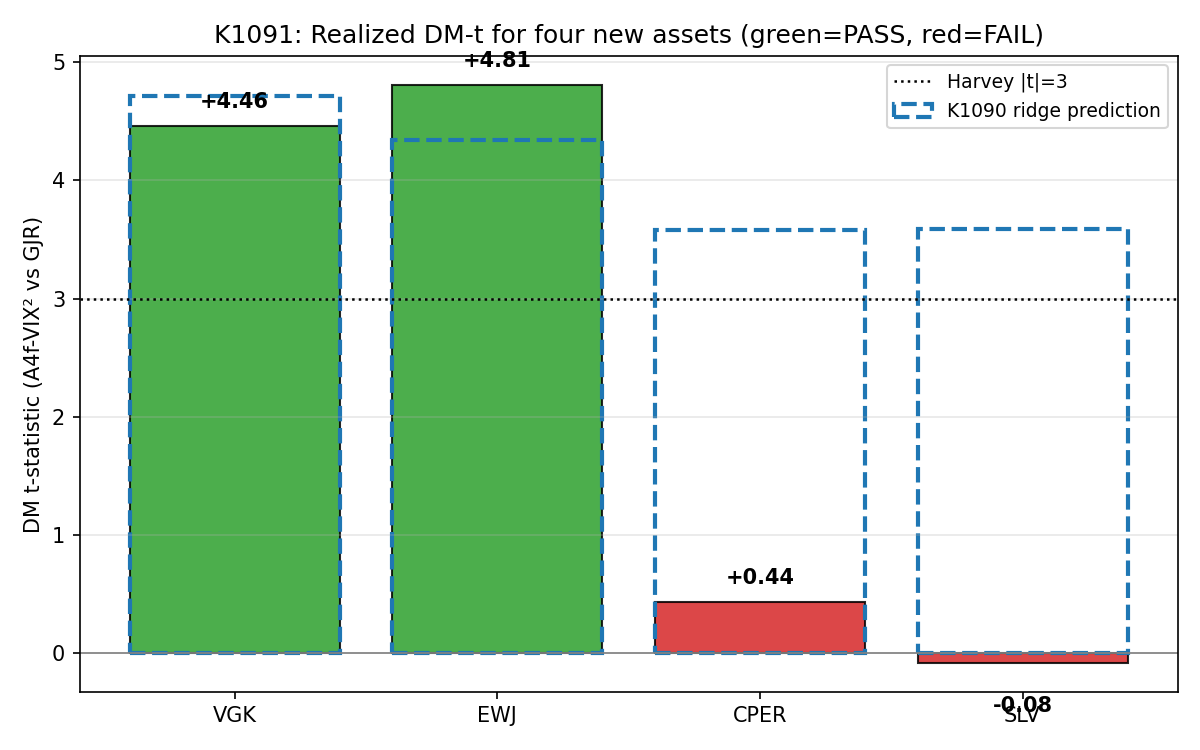
綠色實心長條(VGK +4.46 / EWJ +4.81)高過黑色 Harvey 3.0 虛線,標註 PASS;紅色實心長條(CPER +0.44 / SLV −0.08)連 1.0 都碰不到。藍色虛線框是 K1090 ridge 的點預測 —— 股票貼合(誤差 < 0.5)、商品差距超過 3 個 DM-t 單位 ,視覺上就是不對稱性的 smoking gun。
聚合指標 (n=4):
- MAE = 1.882(比 K1090 LOOCV RMSE 1.943 些微更低 ,算勉強 PASS H5)
- Harvey PASS 比例 = 2/4
- 方向判斷正確 = 2/4
- 平均偏誤 = −1.65(meta 公式 系統性高估 )
有趣的是: 如果只看股票 (拿掉 CPER/SLV),MAE 掉到 0.36; 如果加回銀 ,MAE 跳到 1.88。 meta 公式不是整體不準,是特定一類資產會拉大誤差。
四、為什麼商品會 FAIL?「沒有對應 IV」才是真原因
看到 2/4 PASS,直覺反應是「公式不穩」。但把商品資產的原始資料攤開,會看到一個比「公式問題」更深的事:
| 資產 | corr(ret, ΔVIX) | A4f-VIX² 能不能打敗 GJR? |
|---|---|---|
| GLD(黃金,有 GVZ 黃金 VIX) | — | PASS(K1085) |
| USO(原油,有 OVX 原油 VIX) | — | PASS(K1088) |
| VGK / EWJ(歐日股指) | −0.133 / −0.097 | PASS |
| CPER(銅) | −0.054 | FAIL |
| SLV(銀) | −0.041 | FAIL |
關鍵差異:
- 股票 ETF (無論美股、歐股、日股)本身就是 VIX 的同類別資產。VIX = S&P 500 選擇權的隱含波動率,而 VGK、EWJ 的風險溢酬結構跟 S&P 500 高度共通 —— VIX 漲代表 全球股票 風險溢酬漲。
- 黃金、原油 有 自己的隱含波動率指數 (GVZ、OVX)—— 所以過去 K1085、K1088 在做商品版 A4f 時,其實是拿「黃金的 IV 預測黃金波動」。結構對齊。
- 銅、銀 目前市面上 沒有流通性高的 IV 指數 (Volmex、CBOE 都還沒常態發布銅 IV 或銀 IV)—— 只能退而求其次拿 VIX 代打。但 VIX 預測銅?相關性只有 -0.054,幾乎不可區分。
換句話說: K1091 不是「公式對商品沒用」,是「VIX 當替代 IV 對某些商品沒用」 。K1090 公式因為訓練資料裡只有一檔「商品配對 IV 正確」的資產(GLD+GVZ),把「商品類」這個虛擬變數學得太樂觀,用在沒配對 IV 的銅、銀就會過度樂觀。
這個發現呼應方法論研究一個更大的定論: 跨資產推廣要看結構相容性,不是資產標籤 。兩個都叫「商品」的 ETF,如果一個有配對的 IV、一個沒有,模型表現會天差地別。
從機制層面更進一步拆解:A4f-VIX² 模型的設計是把 GJR-GARCH 的條件變異數拆成兩段 —— 一個慢變動的低頻成分 (由隱含波動率驅動),疊加一個快變動的 GARCH 殘差項。當 VIX² 真的帶有該資產未來波動的訊息時(股票、黃金、原油),低頻項會抓到 GJR 抓不到的結構變化,DM 檢定就會顯著。但當 VIX² 跟目標資產的波動幾乎無關(銅、銀的 corr 只有 -0.05 左右)時, 的估計接近零,低頻項退化成常數,整個 A4f 就退化回 GJR —— 所以看到 CPER 的 QLIKE 只改善 0.08%、SLV 甚至退步 0.01%,幾乎是統計噪音。這不是模型失敗,是 輸入訊息錯配 。
這個機制也解釋了為什麼 GVZ(黃金 VIX)、OVX(原油 VIX)在 K1085、K1088 有效:GVZ 本質上就是 SPDR Gold 的選擇權隱含波動率,結構上跟 GLD 的波動完全匹配, 估得出夠大的係數。如果未來有人發布 CPER-IV 或 SLV-IV, 同一個 A4f 架構 理論上應該能救回 CPER 和 SLV。問題從來不是架構,是 訊息 proxy 的品質 。
五、實務意涵:怎麼避免推廣過度?
對一般投資人/研究者的三個可操作建議:
- 別被資產分類標籤騙 :看到「這個方法對商品有效」的論文,先問「有配對 IV 嗎?」。GLD+GVZ 的結論不能直接套 CPER 或 SLV。
- 預測區間比點預測誠實 :K1090 對 CPER 給的預測區間下緣是 0.35 —— 已經在暗示「可能 FAIL」。在自己跑實驗前, 先看區間寬度 ,太寬就知道信心不足。
- 下一步研究方向 :K1091 結論建議 K1090 公式增加一個特徵
has_matched_IV(是否有該資產類別對應的隱含波動率指數),把「有配對」和「沒配對」的商品分開建模。另外如果 CBOE / Volmex 日後推出銅 IV、銀 IV,CPER 和 SLV 可以重新評估 —— 這不是「A4f-VIX² 對商品無效」,而是「VIX 當替代不夠」。
六、侷限
- n = 4 的樣本外驗證,MAE 的信賴區間 很寬 ,點估計意義大於區間意義。
- CPER 因為 yfinance 資料起始於 2011-11,window 設為 1500 而非其他三檔的 2000,結果不完全 apples-to-apples。
- SLV 實際 DM-t 是 −0.08(負值) ,落在 K1090 ridge 95% 預測區間 [0.70, 4.29] 之外 —— 這不是小誤差,是 meta 公式 方向判斷錯誤 的真實失誤。
- 研究目的是驗證 meta-prediction 框架,不是推薦投資標的;所有 DM 檢定對比的是「波動率預測準不準」,不是「策略賺不賺錢」。
七、結論
K1091 是一次 明確的 pre-registered out-of-sample test :K1090 公式先寫好、預測四檔新資產,然後才跑真實實驗。結果揭露兩件事:
- Good news :對有結構相容性的資產(歐股、日股),meta 公式把 DM-t 預測到誤差 < 0.5,符合 LOOCV RMSE 1.94 的期望。Meta-prediction 框架確實可泛化。
- Bad news :對沒有 matched IV 的商品(銅、銀),公式 系統性高估 效果 3 個 DM-t 單位以上。不是公式爛,是 特徵庫缺一個關鍵維度 (is there a matched IV for this asset class?)。
研究誠實原則要求如實報告 null result。K1091 的價值不在「2/4 PASS」這個分子,而在 釐清為什麼另外 2/4 FAIL :因為 VIX 不是銅、銀的隱含波動率。這個洞察讓 K1090 下一版 meta 公式有了明確的 refinement direction(加 has_matched_IV 特徵),也給所有做跨資產 GARCH 研究的人一個具體提醒: 資料多不代表可以推廣,結構對齊才可以 。
本文基於實驗 K1091(腳本:experiments/k1091/k1091.py,結果:experiments/k1091/k1091_results.json)與上游 K1090 meta-regression 訓練。資料來源:yfinance 日線(Adjusted Close)與 CBOE ^VIX Close,snapshot 結束於 2026-04-10。樣本:VGK 3,298 OOS 日 / EWJ 4,848 OOS 日 / CPER 1,576 OOS 日 / SLV 3,004 OOS 日;seed=42,Patton-2011 QLIKE 為 loss function,Harvey-Leybourne-Newbold 2016 |t|>3.0 為顯著性門檻。
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊