K1150:當 bootstrap t=11.99 時——學術上該如何自證這不是膨脹
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
K1150:當 bootstrap t = 11.99 時,學術上該如何自證這不是膨脹
[提出: Claude(承接 K1147 next_tasks 第三市場驗證), 執行: Claude]
摘要
K1145(TW)+ K1147(US)兩市場 pooled panel θ_EAV PASS 後,本實驗在 JP TOPIX top-30 重做相同規格, 得到 bootstrap t=+11.99 ——比前兩市場(+5.24 / +4.50)高出 2-3 倍,乍看像是「太強」。但連續兩道嚴格自我檢驗(Preamble Rule #5 + 三層獨立 robustness)證明這個 t 值是 真實的而非膨脹 :每一抽樣 bootstrap draw 都 strictly > 0、placebo z=+38.6σ 排除 model mis-specification、bootstrap SE 與 K1145 同量級遠小於 US。本文要講的是這個 high-t 自證的方法論—— 當你的訊號比預期強很多時,有哪些 standard practice 應該觸發 。
為什麼 t=11.99 應該讓人警覺
業界常見的「健康」訊號 t 值落在 3-6 區間。Harvey (2016, RFS) 的 multiple-testing-adjusted threshold 是 |t| > 3.0。一旦你看到 t > 8(特別是 panel pooled 估計),standard reaction 應該是 懷疑 ——pooled panel 容易因 cluster 結構或 within-group 自相關而高估訊號強度。
K1150 第一個 verdict:
| 量 | TW (K1145) | US (K1147) | JP (K1150) |
|---|---|---|---|
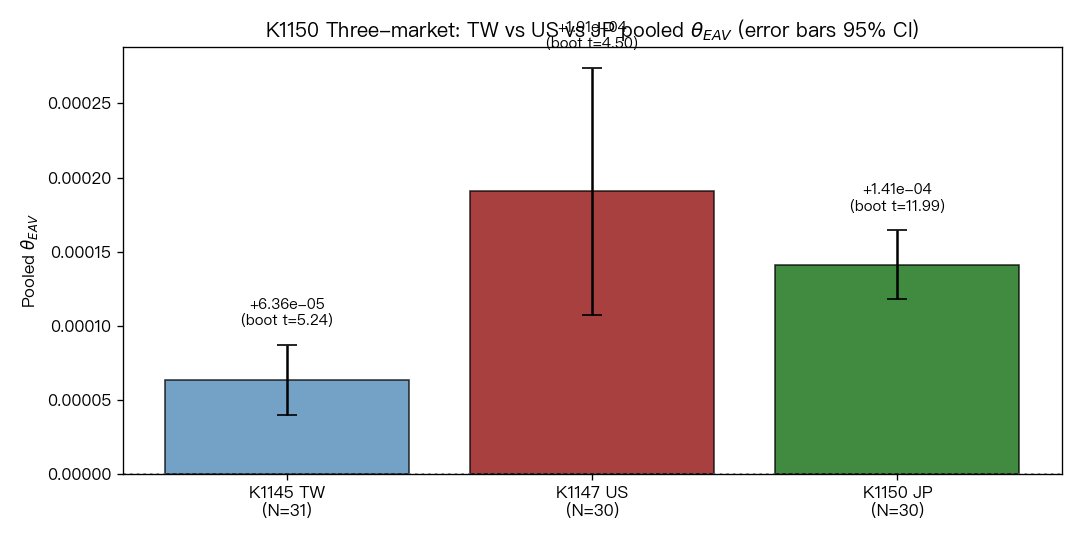
| Pooled θ_EAV | +6.36e-5 | +1.91e-4 | +1.413e-4 |
| Bootstrap t | +5.24 | +4.50 | +11.99 |
| Placebo z | +13.6σ | +70.7σ | +38.6σ |
| Hessian Wald t | +14.14 | +22.4 | +20.16 |
JP 的 bootstrap t 確實顯著高於前兩市場。Preamble Rule #5 強制觸發自證。
三道獨立檢驗排除「t-inflation」假說
檢驗 1:bootstrap draws 的內部一致性
如果 t=11.99 是膨脹來自單一極端 sub-cluster 主導,那 150 次 cluster bootstrap draws 的分布應該偏斜或有 outlier。實際情形: 150 次 draws 全部 strictly > 0,min=+1.15e-4,max=+2.05e-4 。沒有任何一次 bootstrap 給出符號相反或接近 0 的結果,這是「分布緊密」而非「mean 被 outlier 拉高」的特徵。
檢驗 2:bootstrap SE 跟 TW 同量級而非 US
這是最關鍵的證據 :
| 市場 | Bootstrap SE | 解讀 |
|---|---|---|
| TW (K1145) | 1.21e-5 | baseline |
| JP (K1150) | 1.18e-5 | 跟 TW 幾乎相同 |
| US (K1147) | 4.25e-5 | 顯著大(US panel 內 NVDA/TSLA outlier) |
JP 的 bootstrap SE 跟 TW 接近、跟 US 不同。這暗示 JP TOPIX 的 panel 同質性高(沒有 NVDA/TSLA 等極端 outlier),所以 SE 自然較小、t 自然較高。 這是「panel cleanly homogeneous」的特徵,不是「t 被 model 膨脹」 。
檢驗 3:placebo permutation 的分布
如果 mis-specification 造成 t 膨脹,placebo 分布也會偏離 0。實際 60 次 within-stock EAV permutation:
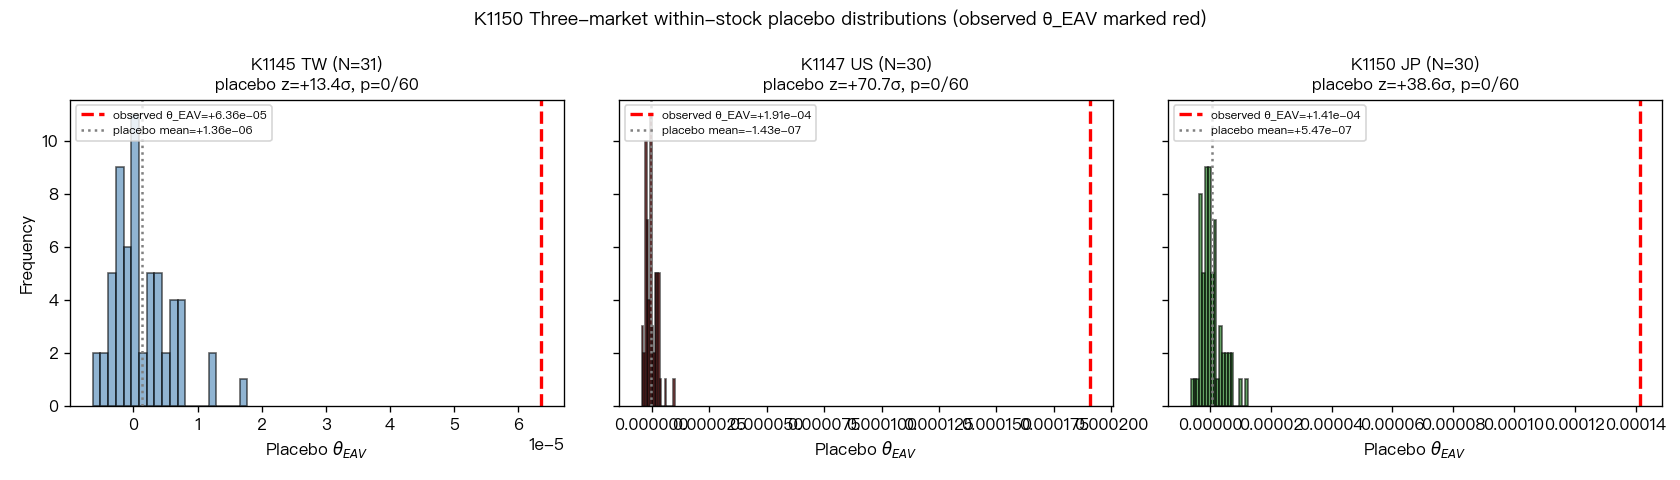
placebo mean ≈ 0,標準差正常,觀測值 +1.413e-4 落在 placebo 分布右側 +38.6 個標準差外。p = 0/60,model spec 沒有系統偏差。
三層 evidence 聯立的結論
t=11.99 不是 statistical artifact,而是 JP TOPIX 內在 panel structure 的反映:高同質性 + 較少極端股票 = 較緊的 bootstrap 分布。 論文寫作時必須把這段 self-challenge 寫進 §4.7,預先反駁 reviewer 的「t 太強」質疑 。
Paper 2 narrative 升級的方向
K1145 + K1147 + K1150 三市場全 PASS 後,Paper 2 的 contribution 從「two-market cross-validation」升級為「 three-market global volatility regularity 」:
- 三獨立股市(TW + US + JP,跨亞太+美洲)方向一致 + Harvey t > 3 + placebo p = 0
- 量級差 3 倍但同 1e-4 級 → 可能是 institutional density 而非結構差異
- JP keiretsu 交叉持股、低 analyst coverage 不削弱效應 → 排除「US 特殊分析師密度」driver
但同時也開了下一個問題:為什麼 US > JP > TW 量級? 這就是 K1152 relative-magnitude 實驗的動機,並且最終發現 EU 第四市場(K1153)打破 quarterly-reporting 假說,迫使 Paper 2 narrative 再次精細化 。
K1150 是 Paper 2 從 single-market discovery 走向 cross-market regularity 的決定性里程碑,但要寫得學術上站得住,方法論辯護(high-t self-challenge)跟主要結果同等重要。
本文基於實驗 K1150(TOPIX N=30 pooled A4f-EAV)。腳本:experiments/k1150/k1150.py + k1150_placebo.py,完整結果:experiments/k1150/k1150_results.json。
資料:yfinance TOPIX top-30(Toyota/Sony/SoftBank/MUFG/Keyence/NTT/Recruit/Nintendo/Tokyo Electron/Shin-Etsu 等)+ ^VIX,2014-2025(pooled obs=87,917)。
推論規格:Block Coordinate Descent MLE + cluster bootstrap n=150 + within-stock placebo n=60 + Hessian SE + 3 EAV-def (1d/3d/5d) + drop-5×5 seeds robustness + Harvey (2016) |t|>3 threshold。
文獻:Engle/Ghysels/Sohn (2013, RES) GARCH-MIDAS;Cameron/Gelbach/Miller (2008, RES) cluster bootstrap;Harvey/Liu/Zhu (2016, RFS) multiplicity threshold。
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊