兩個都有用的指標,加在一起卻沒更厲害
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
兩個都有用的指標,加在一起卻沒更厲害
有一道問題一直存在:當你手上有兩個對未來都有預測力的訊號,把它們合在一起,效果應該更好吧?
從直覺上看,答案很明顯。但市場資料給出的答案,有時候跟直覺背道而馳。
兩個指標,各自的角色
這次的研究對象是預測美股短期波動率。我們選了兩個來自不同角度的訊號:
波動率風險溢酬(VRP) 是選擇權市場的隱含資訊。它等於選擇權定價隱含的「未來預期波動率」,減掉過去實際發生的波動率。當市場參與者願意為保險支付更高溢酬,這個數字就會偏高,暗示未來波動可能上升。它屬於 前瞻性 的訊號。
半變異數(Semivariance) 則看的是歷史。它把過去的報酬拆成上漲部分和下跌部分,分別計算各自的波動貢獻。換言之,它衡量市場在壞日子裡究竟有多亂。這是一個 回顧性 的訊號,著眼於非對稱的下行風險。
兩個性質不同、角度不同。直覺告訴我們:合在一起,應該更完整。
各自的證據
在 SPY(標普 500 ETF)上,用 2005 年至 2022 年的資料訓練模型,然後在 2023 年後的樣本外做預測,結果如下:
| 模型 | 說明 | SPY OOS R² |
|---|---|---|
| M1 基線 | 只用過去波動率 | 0.017 |
| M2 VRP | 加入選擇權訊號 | 0.143 |
| M3 半變異數 | 加入下行/上行非對稱 | 0.149 |
| M4 組合 | VRP + 半變異數合併 | 0.158 |
| M5 全廚 | 加入 VIX 等更多特徵 | 0.199 |
| M6 GJR-GARCH | 純統計時序模型 | -0.355 |
| M7 Ridge 回歸 | 全特徵正規化 | 0.198 |
有幾點值得停下來看:
VRP 單獨預測 R² 從 0.017 跳到 0.143,提升幅度明顯。半變異數單獨預測 R² 達到 0.149,比 VRP 還高一點。這說明兩者各自都有真實的預測資訊。
更有力的證據來自交叉測試(encompassing test):在 SPY 上,光看 VRP 是否還能從半變異數中「吸收到新資訊」,答案是肯定的;反過來,半變異數也能從 VRP 中吸收到新資訊。兩個訊號互相不可取代,都各有獨立貢獻。
在 QQQ(納斯達克 100 ETF)上,情況稍有不同:半變異數對 VRP 有更強的覆蓋力,但 VRP 反過來對半變異數的覆蓋力就弱了。
GJR-GARCH 的 R² 是負數 ,說明這個純時序模型在日頻預測上,竟然比什麼都不加的基線還差,是這一批模型裡表現最差的。
合在一起之後
M4(VRP + 半變異數組合)的 SPY OOS R² 是 0.158,確實比 M2(0.143)和 M3(0.149)都高。數字上有改善。
但接下來的統計測試給了一個冷水。
對每兩個模型之間的損失差,用 Diebold-Mariano 檢定加上 block bootstrap(每塊 21 天,重複 10,000 次)做嚴格的統計推斷。結果:
- 組合 vs 基線:p = 0.897(SPY),p = 0.591(QQQ)
- 組合 vs 純 VRP:p = 0.724(SPY)
- 組合 vs 純半變異數:p = 0.782(SPY)
所有比較的 p 值都遠高於 0.1,完全無法拒絕「兩個模型無差異」的虛無假設。數值上的改善,在統計層面是噪音。
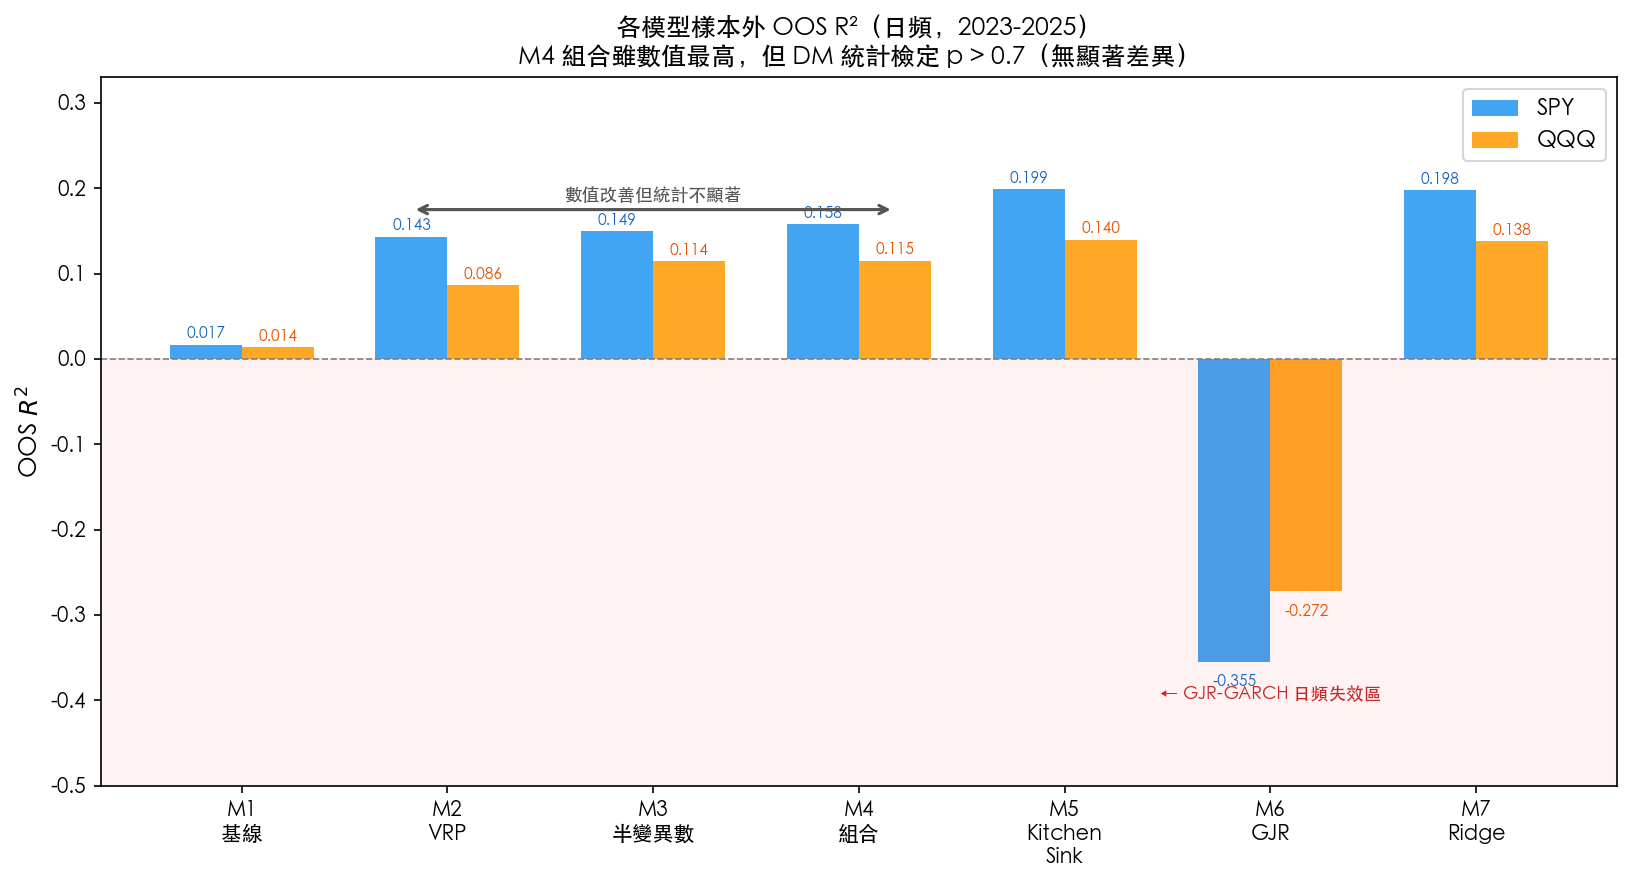
圖中可以看到,從 M2 到 M3 到 M4,R² 確實逐步往右走,但差距都在誤差範圍內。而 M6 的 GJR-GARCH 那兩根柱子沉到負數區,視覺上非常突出。
為什麼會這樣
這個現象有個學術名稱: 日頻維度的詛咒 。
兩個訊號雖然各自有獨立資訊,但每一天的報酬波動本身非常嘈雜。把更多特徵加進去,需要從資料中估計更多參數;每增加一個參數,就需要從有限的樣本中吸收更多估計誤差。
兩個獨立訊號帶來的「新資訊增益」,被「估計參數增加帶來的噪音成本」所抵銷。這不是訊號本身的問題,是日頻資料的密度和特徵數量之間的基本限制。
在 21 天的月頻預測上,組合模型的 R² 達到 0.474(SPY),比單一訊號更高;但同樣的,統計差異仍不顯著(DM p > 0.69)。頻率稍長後訊號更穩定,但仍然沒有突破統計門檻。
這個結果告訴我們什麼
「有預測力」和「應該加進模型」是兩件事。
一個指標能獨立預測未來,不代表把它加進一個已經有用的模型後,整體預測力就能顯著提升。估計噪音、參數代價、共線性,都是實際的成本。
對於實際應用,這個結果更傾向於「選一個較好的單一訊號,保持模型精簡」,而不是「把所有有用的東西都堆進去」。在日頻預測上,模型的複雜度本身就是敵人。
這也是金融資料探勘的一個常見陷阱:看到樣本內表現隨特徵增加而提升,就以為樣本外也會更好。這次的實驗結果,是一個直接的反例。
本文分析基於實驗 K450(腳本:experiments/k450/k450_vrp_semivar_combined.py,結果:experiments/k450/k450_vrp_semivar_combined_results.json)。資料來源:yfinance(SPY、QQQ、VIX),期間 2005-2025,OOS 樣本 2023 年起共 808 個交易日。結果反映 null result,呈現研究誠實原則。
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊