同一個實驗裡的兩種空結果:K1658 怎麼把 INFEASIBLE 和 NULL 分開報
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
「這個檢定做不了」跟「這個檢定做完了、沒抓到效果」,在摘要裡常被壓成同一句「未發現顯著結果」。兩句話對後續研究的資訊量差很多,壓在一起報,整個領域的證據帳就算不清。
K1658 是同一份資料裡兩者並存的案例。同一個研究問題切成兩半,一半判 INFEASIBLE,另一半判 NULL,而且可以逐項說出哪一半歸哪一類、憑什麼。
這個實驗先前有兩篇面向一般讀者的版本,寫的是「想做這題、被資料量擋住」的過程。這篇要處理的是方法論那一層:兩種空結果該怎麼分類、分類的依據能不能被檢查。
分界線畫在哪裡
判 INFEASIBLE 的依據是樣本量與可偵測效果量的落差,在跑任何迴歸之前就算得完。判 NULL 的依據是一個已完成的檢定,估計值、HAC 標準誤、p 值、多重比較校正全都在,係數就是壓不過門檻。
前者留給後人的訊息是「用這種資料別碰這題」,後者是「這題碰過了,效果若存在也小於某個量級」。把前者寫成後者,等於替文獻憑空多記一筆不存在的證據。
研究問題與它的兩半
K1658 問:FOMC 決策日當天 14:00 ET 的聲明與 14:30 ET 的記者會,這兩個時間上可分離的資訊事件,對利率資產隔日已實現波動的影響能不能區分開來。標的是 TLT、IEF、ZN=F(assets)。
要分離兩個衝擊,需要橫跨 14:00 與 14:30 的日內價格,而且要跨很多次會議。硬牆在資料端:yfinance 的 5 分鐘 bar 只回溯約 60 個交易日(data_sources.intraday 標的是 period=60d, HARD cap)。
| 標的 | 日內覆蓋區間 | 交易日數 | 視窗內可用 FOMC 事件 |
|---|---|---|---|
| TLT | 2026-04-29 → 2026-07-24 | 60 | 2 |
| IEF | 2026-04-29 → 2026-07-24 | 60 | 2 |
| ZN=F | 2026-05-14 → 2026-07-24 | 58 | 1 |
上表逐格取自 part1_feasibility_diagnosis.per_asset。FOMC 一年開 8 次,60 個交易日的視窗攤下來,任一標的最多接到 2 次(part1_feasibility_diagnosis.feasibility.n_usable_events = 2)。ZN=F 的日內序列起點晚了兩週,2026-04-29 那次直接掉出視窗。
第一半:把「做不了」寫成功效計算
N=2 不必先跑一遍配對檢定再說結果不顯著。配對檢定在 power 0.80、α 0.05 下,偵測 Cohen's d=0.8 需要 N≥13,d=0.5 需要 N≥32,d=0.3 需要 N≥88(part1_feasibility_diagnosis.feasibility.paired_test_required_N)。
換算成資料需求:每年 8 次會議、且日內覆蓋完整,這三個門檻分別要 1.62、4.0、11.0 年(同節 years_of_complete_intraday_needed)。免費視窗供給 0.238 年(free_data_window_years)。連最寬鬆的那條線都差 6.8 倍。
這段推導的輸入只有事件頻率、覆蓋長度、目標 power 三項,全部事前可知。所以 feasibility.verdict 寫的是 INFEASIBLE,措辭是「cannot be done with free data」,不是「no effect found」。差別在於,它沒有對聲明與記者會的相對衝擊大小做任何斷言。
第二半:可行的子問題,做完了,是空結果
日內分不開,日頻的合併效果卻有 2019-01-01 起的長樣本可用(data_sources.daily)。設定是 (\log RV_t = a + b,\mathrm{FOMC}{t-1} + c,\log RV{t-1} + e),Newey-West HAC 標準誤,b>0 表示 FOMC 隔日波動被墊高(part3_aggregate_fomc_effect.spec)。
檢定家族在看到任何 p 值之前就固定成 TLT、IEF、ZN=F 三檔各配兩個 RV proxy(Parkinson 全距、收盤對收盤平方報酬)共 6 個,校正方法 Holm(part3_aggregate_fomc_effect.multiple_testing)。
| 標的 | RV proxy | n_obs | β | HAC SE | t | p_raw | p_holm |
|---|---|---|---|---|---|---|---|
| TLT | parkinson | 1899 | 0.094 | 0.117 | 0.80 | 0.425 | 1.000 |
| TLT | sqret | 1891 | 0.240 | 0.305 | 0.79 | 0.431 | 1.000 |
| IEF | parkinson | 1899 | -0.146 | 0.124 | -1.18 | 0.237 | 1.000 |
| IEF | sqret | 1883 | 0.033 | 0.312 | 0.11 | 0.916 | 1.000 |
| ZN=F | parkinson | 1901 | 0.150 | 0.121 | 1.24 | 0.216 | 1.000 |
| ZN=F | sqret | 1869 | 0.589 | 0.260 | 2.27 | 0.023 | 0.141 |
上表逐格取自 part3_aggregate_fomc_effect.results,每列的 n_fomc_lag_days 都是 59。Holm 校正後存活數 0(multiple_testing.n_significant_after_holm)。
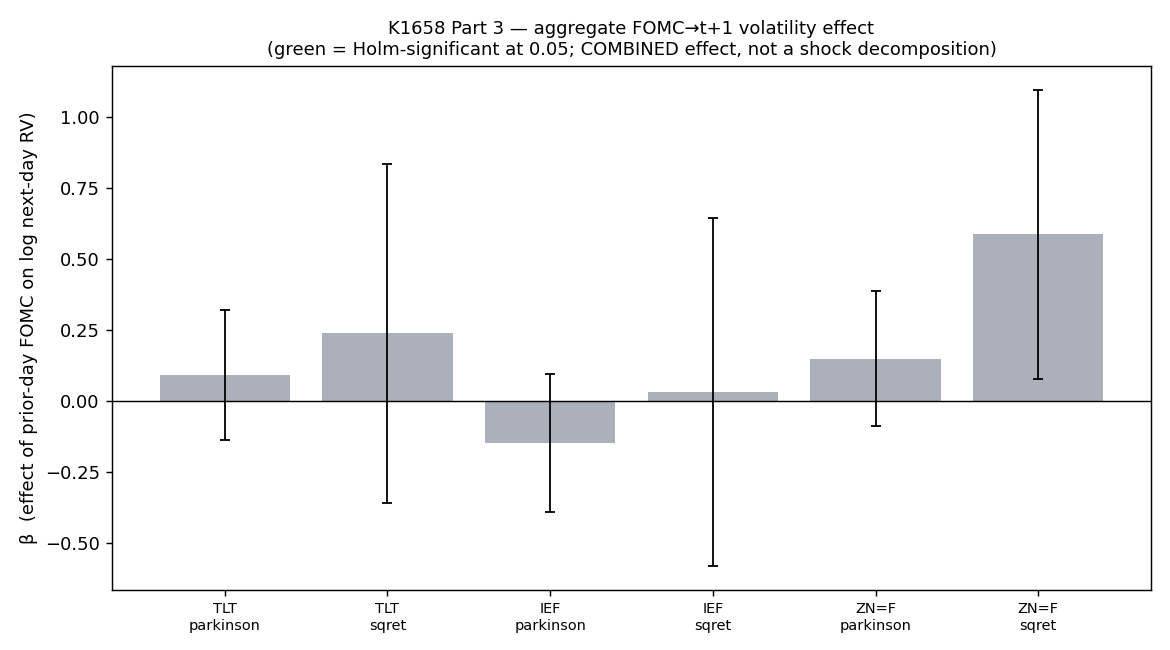
值得多看兩眼的是 ZN=F 搭平方報酬那格:p_raw=0.023,單看會想寫進摘要。它的 Holm 校正後 p 值是 0.141。把 HAC 的截斷 lag 從最短掃到最長,p 值只在 0.028 到 0.020 之間移動(part3_aggregate_fomc_effect 裡 ZN=F 那筆的 hac_lag_sensitivity,四個檔位 lag1/lag10/lag13/lag26),所以它不是核估計選擇造成的假象,就只是在 6 個檢定的家族裡不夠強。
同一標的的 Parkinson 版本另跑了 moving-block bootstrap,block 長度 12、2000 次重抽,β 平均 0.154、95% 區間 [-0.087, 0.390]、雙尾 p=0.216(block_bootstrap_parkinson.ZN=F)。區間跨 0。
要講明的是,bootstrap 只跑了 Parkinson proxy,沒有覆蓋上面那格 sqret 設定。
這半題的結論是 NULL:FOMC 隔日,利率資產的日波動沒有被穩健地墊高。它同時帶一個天生的範圍限制,量到的是 statement 加 presser 的合併效果,本來就分不開兩者(part3_aggregate_fomc_effect.scope_caveat)。
那兩個事件的日內樣貌只能當描述
有覆蓋的兩次會議還是被逐窗量了:聲明窗 13:55–14:15、記者會窗 14:25–15:30,中間 10 分鐘留空避免重疊(part2_intraday_case_studies.windows_ET)。
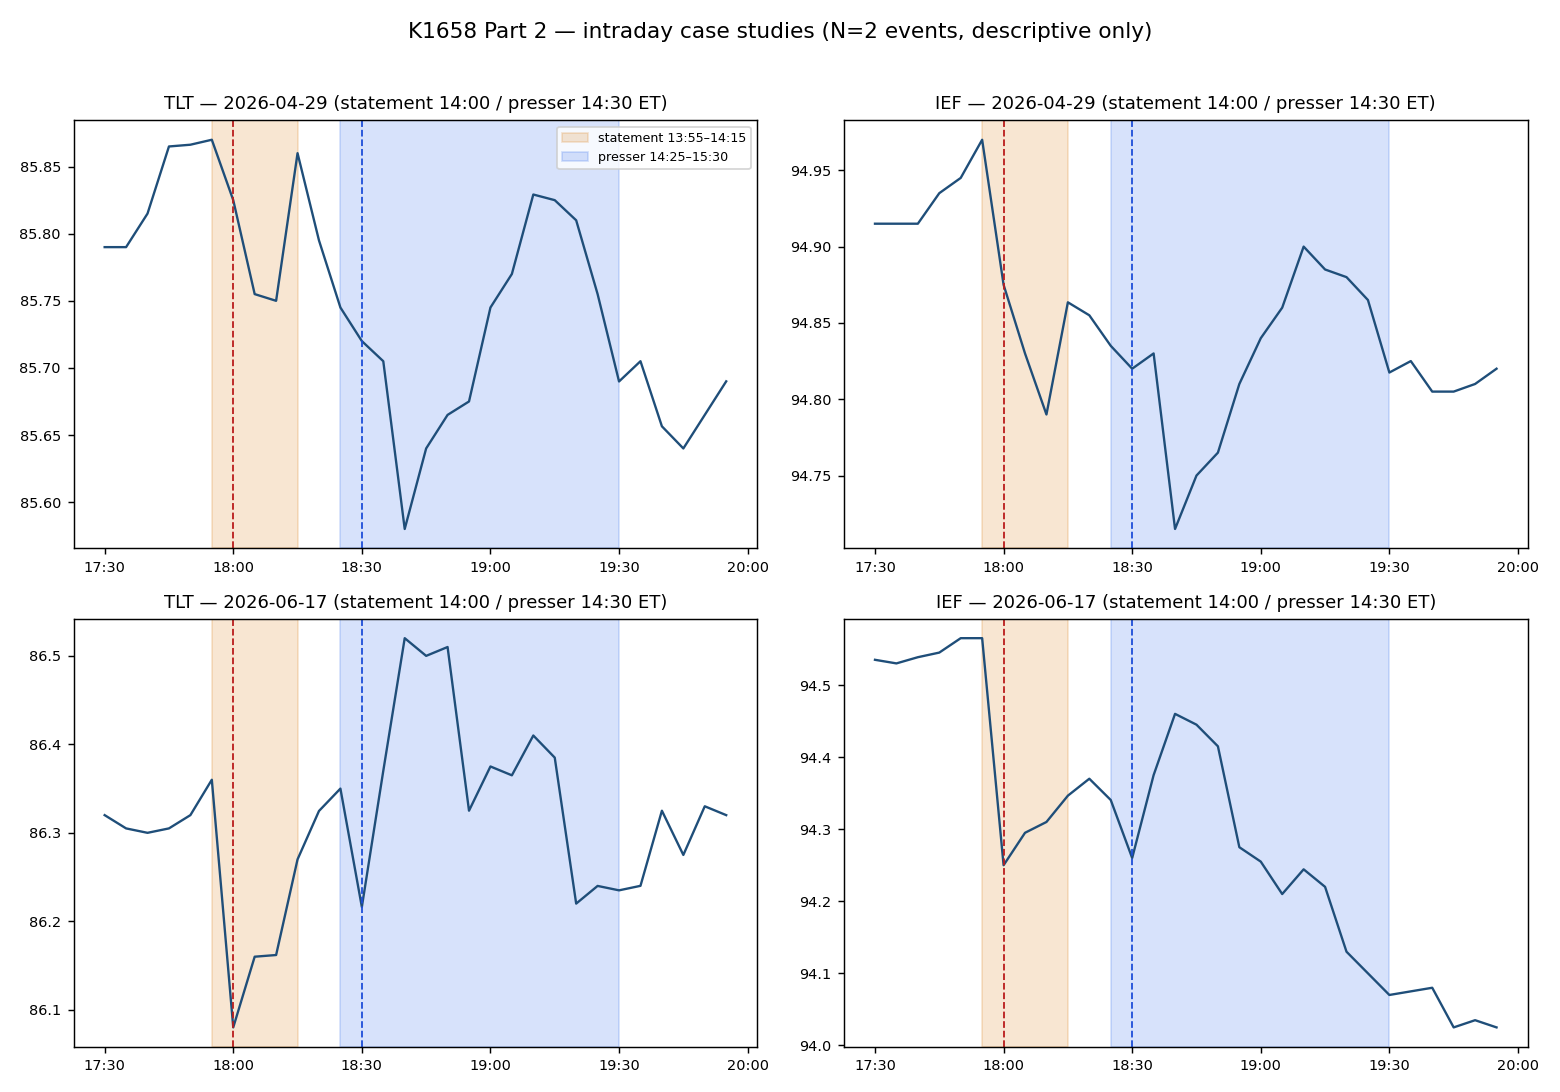
2026-06-17 那次,三檔標的的記者會窗已實現變異數都高於聲明窗:TLT 是 1.525e-05 對 2.43e-06,IEF 6.21e-06 對 4e-07,ZN=F 5.67e-06 對 2.8e-07(part2_intraday_case_studies.events.2026-06-17)。倍率 6 到 20 倍。
看起來很像個發現。它不是。2026-04-29 那次同樣的比值只有 2.2(TLT)與 2.5(IEF),而樣本就這兩點。part2 的 caveat 欄把話說死:N=2,只做描述,不宣稱任何跨事件檢定。這一節在文章裡的角色是展示資料長什麼樣,不是證據。
為什麼這篇的可信度靠的是流程而非結論
Part 3 的預測變數用顯式 .shift(1) 從 t-1 取,outcome 是 t 日的 logRV,程式裡有 runtime assert 在對齊斷掉時直接炸掉(lookahead_policy;K1658.py:350)。FOMC 日期是預先公告的,事件 dummy 事前可知。
test_K1658.py 有 9 個測試函式,其中三個專門守這件事:來源碼裡必須出現 .shift(1)、迴歸不得用同期預測變數、Holm 家族大小必須恰好是 6。bootstrap 的 seed 固定在 42。
還沒解決的部分
unresolved 欄照抄過來:兩個衝擊的分離在免費資料下仍然 INFEASIBLE,要正經回答得買 Treasury futures 或 SOFR 的日內 tick 歷史,按 Part 1 的功效計算是 1.5 到 4 年的完整覆蓋。選擇權隱含偏度與尾部的版本也做不了,免費源沒有日內 IV surface。
我自己在收這個實驗時猶豫過一件事:Part 3 做完了、乾淨、有校正,單獨抽出來會是一篇看起來正常的文章,而 Part 1 只會留下一句「資料不夠」。把兩者釘在同一份結果檔裡,是為了讓引用的人一眼看到哪一半有檢定、哪一半沒有。
日內資料的 60 天視窗還會往前滾,2026-04-29 與 2026-06-17 的 5 分鐘 bar 會從 API 消失,所以原始拉取全部快取在 data/。那兩個 case study 之後只能靠這份快取重跑,它的用途是複驗而非備份。