K1678:同一批 525 組配對,標籤那半邊 t 打到 4.13,注意力那半邊最多 1.26
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
摘要
K1678 的問題只有一句:在被 SEC 事後標記為操縱交易的那些股票日期裡,公眾注意力異常升高的那幾場,接下來會不會更慘?
答案是不會。8 格預先登記檢定(2 個 horizon × 4 個 outcome)的 HAC t 統計量全部關在 −1.258 到 +0.754 之間,Bonferroni 校正後 p 值 8 格都是 1.0,BH q 值 7 格 0.7716、1 格 0.9154,strict_primary_pass_count 與 fdr_only_positive_count 都是 0。
單看這段,它就是又一個 null。真正讓這題可以單獨寫的,是同一份配對樣本吐出的第二組數字:把注意力這個維度整個拿掉,只比事件日與同一檔股票的對照日,8 格的 t 有 4 格越過 Harvey 的 3.0 門檻,最高的 H=5 左尾跌幅到 4.129;隔日 RV 的事件均值 506.73 對上對照均值 142.94,倍數 3.55。
一份樣本,兩個維度,一邊 t>4、一邊貼著零。下面把這個解離拆開講。
一、為什麼要花篇幅寫一個沒過的檢定
null result 最常見的死法是被一句「樣本不夠」打發掉。這句話多數時候無法反駁,因為 null 本身不帶功效資訊:估計值貼零,可能因為效應真的沒有,也可能因為設計太鈍,測不出任何東西。
K1678 的結構剛好把這兩種可能分開。它的迴歸同時產出兩個東西:注意力落差的交互項係數(預先登記的 8 格判決家族),以及事件日減對照日的截距(次要診斷)。兩者吃同一批配對、同一組事件日叢集、同一套 HAC 設定。截距那一半打出 4.129,代表這個設計對「有效果的東西」是看得見的。交互項那一半打不出 1.3,就不能再推給樣本量。
換個說法:這份實驗自己內建了一個 positive control,而且那個 control 通過了。
二、設計:一份起訴書當弱標籤,一個免費代理當處理變數
| 元件 | 設定 |
|---|---|
| 事件標籤 | SEC 2026-04-20 提出的 comp26532 起訴書 附件 A;解析出 439 個表格區塊、412 個普通股代號、1,083 筆日期出現、1,079 組唯一股票日期 |
| 事件日期範圍 | 2021-05-26 → 2024-01-02 |
| 注意力代理 | Wikimedia Pageviews API,Pump_and_dump、WallStreetBets、Short_squeeze、Day_trading、Robinhood_Markets 五頁的 7 日瀏覽量,減去五個大盤/投資頁的 7 日瀏覽量,再取 126 日滾動 z 分數(最少 60 日基期) |
| 價格 | yfinance 日線,requested 414 檔、available 254 檔、missing 160 檔 |
| 配對 | 同一檔股票、偏好同一曆年、交易列距離 ≤252,用 6 個 t−1 特徵(ret1、ret5、log RV21、成交量 z、SPY 報酬、VIX z)挑 3 個對照日 |
| 樣本 | H=1:525 列 / 302 個事件日叢集 / 205 檔;H=5:345 列 / 242 個叢集 / 204 檔 |
| Outcome | RV、下行半變異 DSV(皆 ×10,000)、區間最大單日跌幅、最大向下開盤跳空(皆為百分點) |
| 推論 | 事件日叢集層級 HAC(H=1 maxlags=0、H=5 maxlags=4)+ moving-block bootstrap(block=10、reps=2000);Bonferroni 與 BH 校正涵蓋 m=8 |
lookahead 防護寫在程式裡:事件指標走 sec_event.shift(1);注意力 z 分數的滾動均值與標準差只用到 t−1;候選對照日若落在任何被標記事件的 max(10, H) 個交易列以內就剔除;同一檔股票的事件按 H 個交易列去叢集;同一個 SEC 事件日下的多檔股票先平均再進推論。seed=42。
有一層縮水必須先講。1,079 組標籤股票日期裡,只有 657 組在價格面板中找得到對應的交易日(可取得價格的股票本來也只涵蓋到 664 組)。掉的多半是薄量、下市或改名的小型股,也就是最可能被操縱的那群。yfinance 的現況可得性造就了這個存活偏誤,實驗選擇如實揭露而不補值。
三、解離長什麼樣子
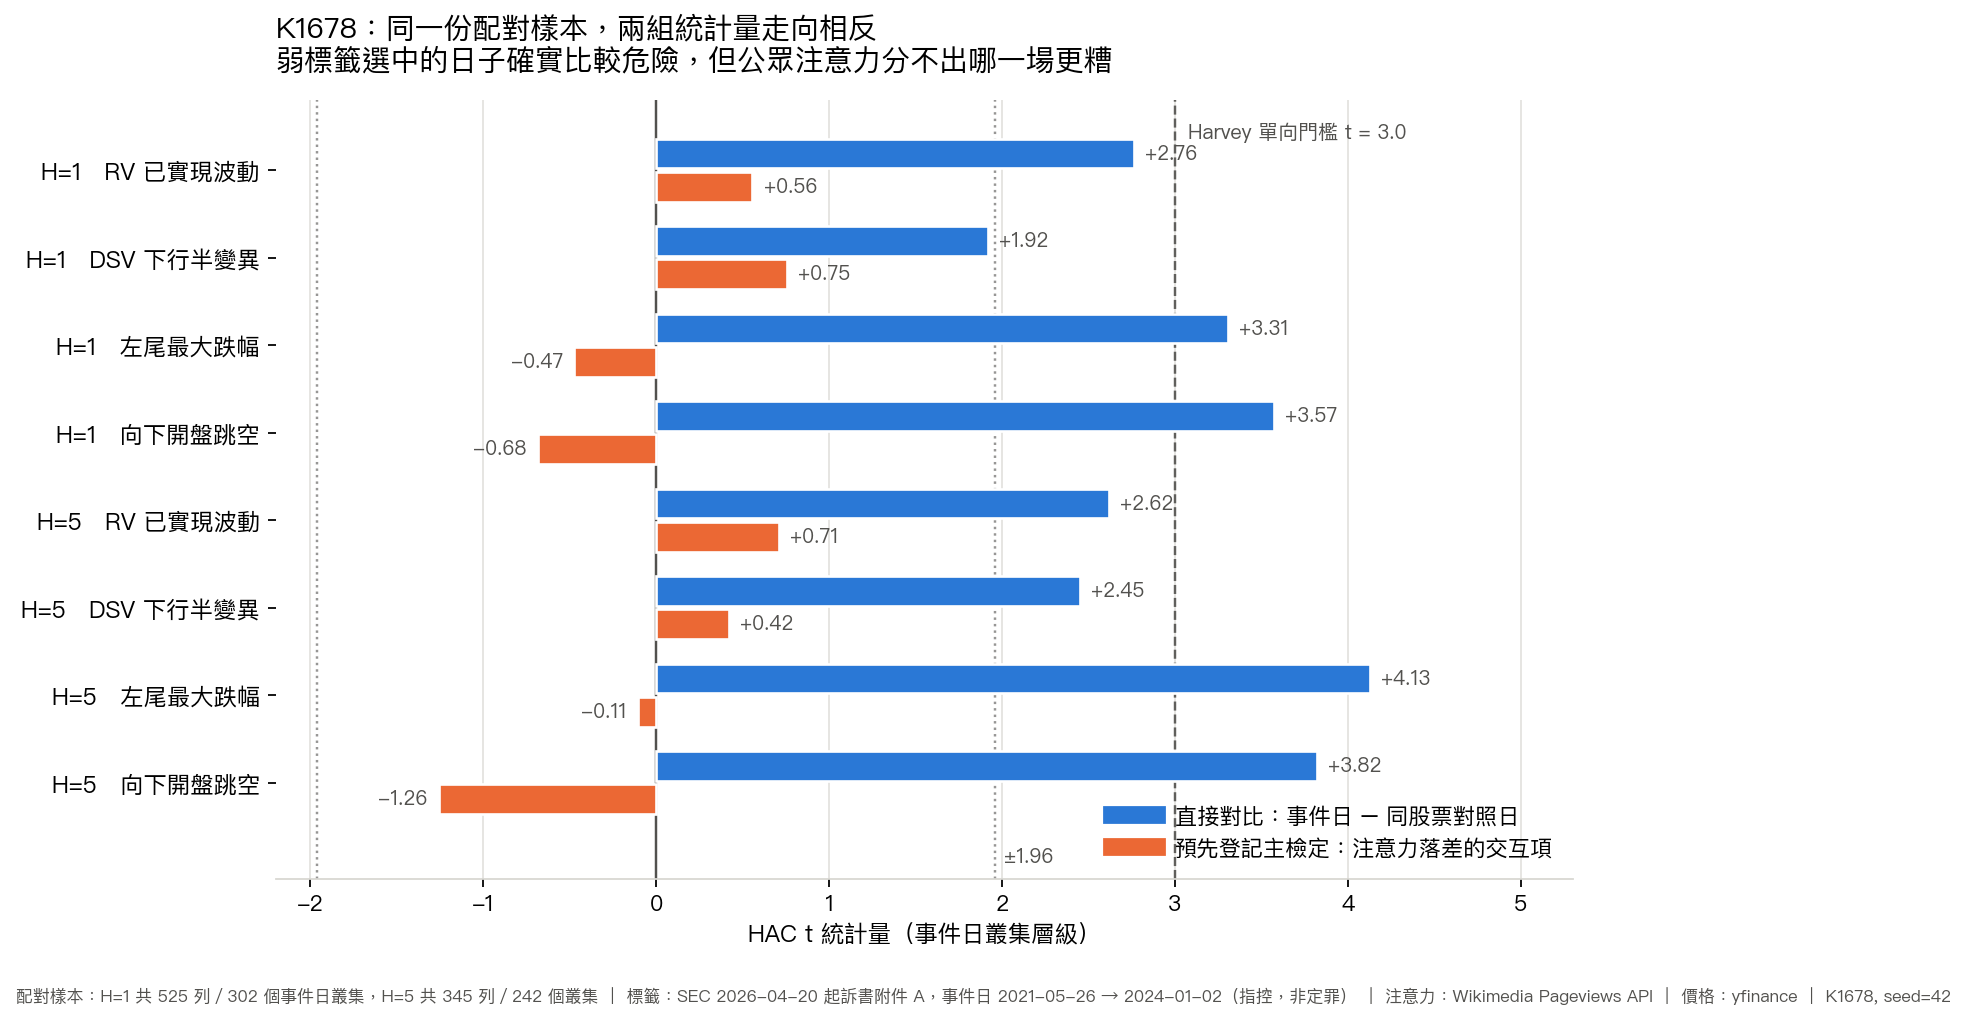
藍色是事件日減對照日的直接對比,橘色是預先登記的注意力交互項。兩排長條吃的是同一批配對。
| 格 | 事件均值 | 對照均值 | 直接對比 |t| | 交互項 t | 交互項 β(每 1 SD) |
|---|---|---|---|---|---|
| H=1 RV | 506.73 | 142.94 | 2.760 | +0.557 | +57.63 |
| H=1 DSV | 278.67 | 91.76 | 1.921 | +0.754 | +71.57 |
| H=1 左尾跌幅 | 7.383% | 4.573% | 3.305 | −0.473 | −0.359 |
| H=1 向下跳空 | 3.235% | 2.097% | 3.572 | −0.684 | −0.211 |
| H=5 RV | 301.54 | 102.59 | 2.618 | +0.710 | +33.72 |
| H=5 DSV | 173.13 | 56.91 | 2.448 | +0.419 | +13.86 |
| H=5 左尾跌幅 | 16.399% | 10.391% | 4.129 | −0.106 | −0.126 |
| H=5 向下跳空 | 7.058% | 4.644% | 3.819 | −1.258 | −0.798 |
左邊那一半很乾淨:8 格全部為正,7 格越過 1.96,4 格越過 3.0。H=5 的左尾跌幅差 6.507 個百分點,向下跳空差 2.546 個百分點。這份 2026 年才出爐的名單,確實挑中了一批事後看來風險偏高的日子。
右邊那一半同樣乾淨,只是乾淨在零附近。而且它連方向都沒站穩:RV 與 DSV 的 β 為正(H=1 分別是 +57.63、+71.57),左尾與跳空的 β 為負(−0.359、−0.211),8 格 4 正 4 負。若注意力真的存在一條放大通道,四個 outcome 是同一組報酬的不同切法,理應同號。它們沒有。
這裡要克制。直接對比是次要診斷,沒有多重檢定校正,也不能當因果。對照日只代表「這份起訴書沒有標記它」,不代表那天乾淨;污染只會把對比往零推,所以觀察到的差距如果有偏誤,方向是低估。日線 OHLCV 也看不到起訴書真正描述的機制(碎單快速拉抬、非善意限價單),它只能告訴我們這些日子的日線風險輪廓長什麼樣。
四、把交互項那一半追到底
換三種注意力定義
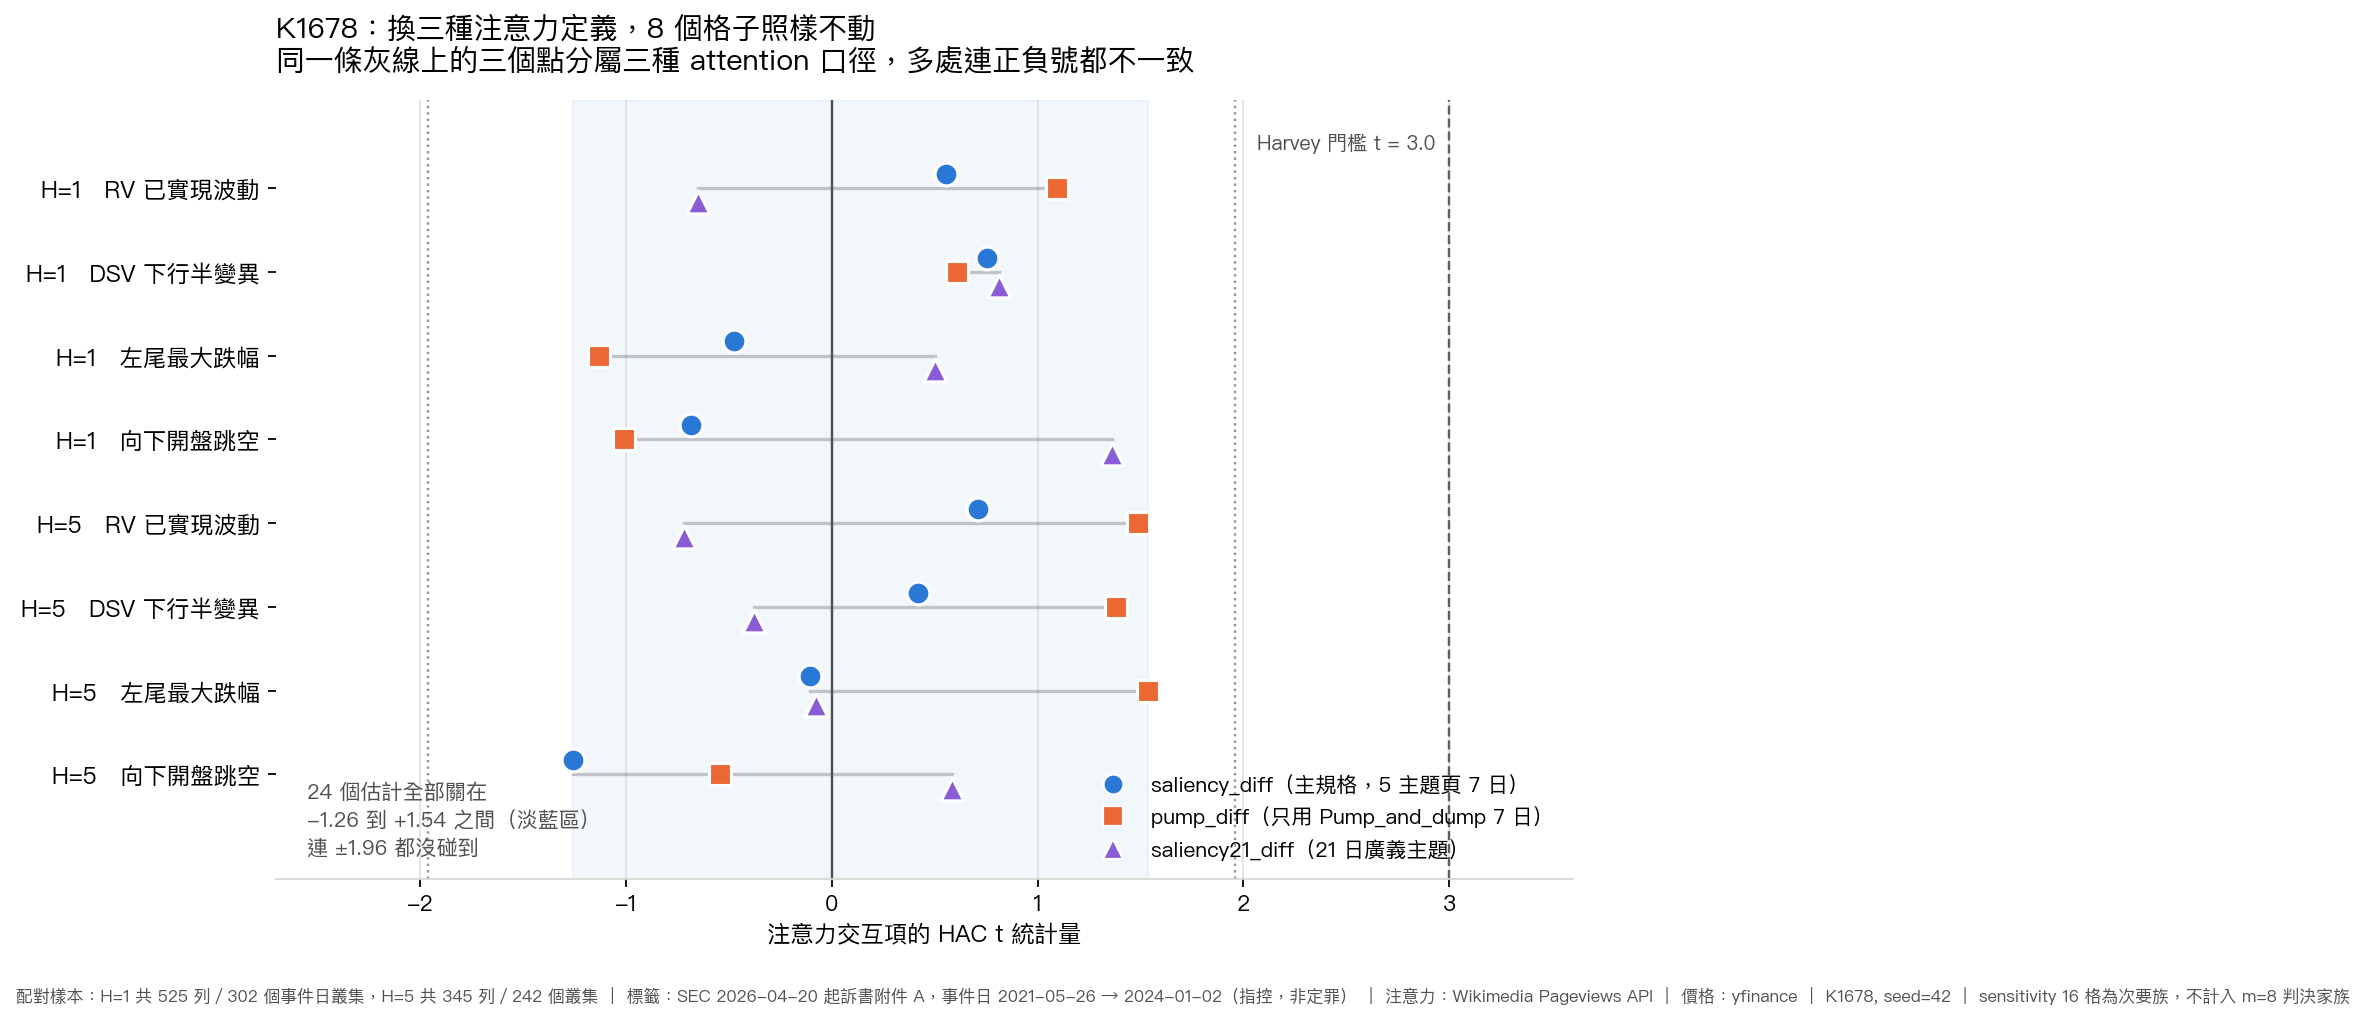
主規格之外,實驗另跑 16 格 sensitivity:pump_diff 只用 Pump_and_dump 單頁 7 日,saliency21_diff 改用 21 日的廣義主題窗。加上主規格共 24 個估計,全部落在 −1.258 到 +1.536 之間,最大的一個是 H=5 左尾跌幅配 pump_diff 的 1.536,離 3.0 還有很遠。
比 t 值更難看的是符號。8 格裡有 7 格在三種口徑之間出現正負號翻面。最誇張的是 H=1 RV:pump_diff 給 β = +119.07,saliency21_diff 給 β = −75.61,同一批日子、同一個 outcome,換一種算注意力的方式就換一個方向。一個真實的訊號不會這樣。
換一套推論方法
HAC 是漸近推論,在 302 個事件日叢集上不算特別站得住。實驗另外跑了 moving-block bootstrap,block=10、reps=2000,每格的 seed 由 SEED + 100 × horizon + outcome_index 決定(H=1 的四格是 142–145,H=5 是 542–545)。8 格的雙尾 p 落在 0.210 到 0.795,95% 區間全部包含 0。兩套獨立的推論方法收斂到同一個結論,比任一套自己說了算更有份量。
換 HAC bandwidth
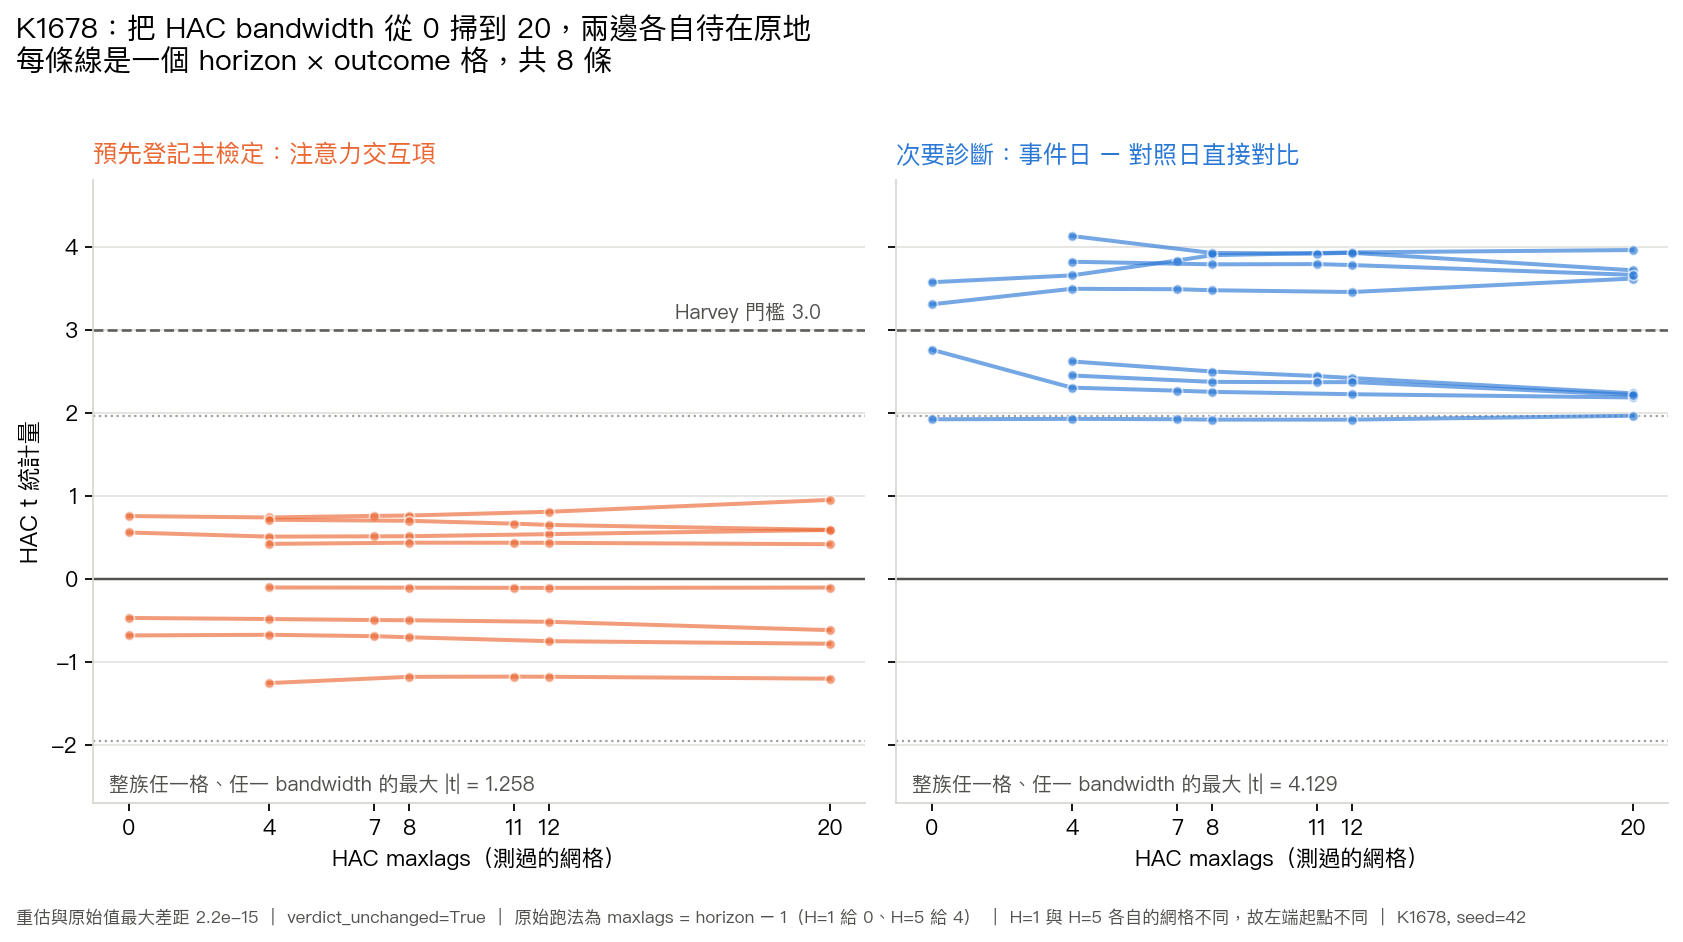
這一段是收尾覆核時補的,起因是一個真實的方法論負債:K1678.py 用 maxlags = horizon − 1,在 H=1 就退化成 0,等於只剩 White 異質變異穩健標準誤,沒有做序列相關修正。repo 的 canonical 規則要 max(h−1, ceil(h^(1/3)·n^(1/3))),對這份樣本是 H=1 給 7、H=5 給 11。這條規則在 K1678 跑完的隔天才機械化,而且它的 ratchet 只掃手寫 DM 迴圈,抓不到 statsmodels 的 cov_type="HAC" 呼叫,所以沒有任何 gate 擋下來。
處理方式是把它量出來,而不是假設 null 很安全。整個 {0, 4, 7, 8, 11, 12, 20} 網格重跑後:8 格主檢定在任一格、任一 bandwidth 的最大 |t| 是 1.258,達到 3.0 的格數是 0;16 格 sensitivity 最大 1.672;8 格直接對比最大 4.129,而且原本過門檻的 4 格在每一個測過的 lag 都還在門檻以上。重估值與原始儲存值的最大差距是 2.2e−15,verdict_unchanged 為 true。
五、這個 null 能承擔什麼
能承擔的很窄:在這一份起訴書倖存的樣本裡,市場層級的操縱/散戶主題公眾注意力,無法穩健解釋事件之間的事後風險差異。
不能承擔的比較多。它沒有說被指控的日子沒有崩盤風險,直接對比那一半正好相反。它沒有否定個股層級的搜尋量、社群貼文、新聞或投資人流量,Wikimedia 量的是整個市場在看什麼主題,不是誰在看哪一檔股票。它也沒有否定 Li 等人(JBF 2025)或 Chen 等人(JEF 2026)那條注意力與操縱/崩盤風險的機制,那些設計用的是完全不同的識別策略。
還有兩層限制在讀 p 值時必須帶著。標籤來自事後:起訴書 2026-04-20 才立案,所有事件日都在那之前,t 當下這個標籤並不存在,methodology_type 直接寫了 empirical retrospective proxy diagnostic; non-causal。這是回溯診斷,不是可交易訊號,也不該被讀成任何即時警報。其次,定義樣本的案件與提供假說的案件是同一件,所以這些 p 值是條件於這一個案件的,不是母體層級的發現機率。附帶一提,附件 A 是民事起訴的指控,不是定罪。
六、我從這一題帶走的東西
一個 null 的資訊量,取決於它旁邊有沒有一個會亮的燈。
K1678 的直接對比原本只是次要診斷,寫在 verdict 家族之外、沒有多重檢定校正,地位很低。但它意外成了整篇最有用的東西:因為它亮了,「設計沒力」這個解釋就被關掉,交互項的零才變成一個關於世界的陳述,而不是關於樣本的陳述。
VolPred 這邊之前測免費注意力代理已經連摃三次(K1554 的 Stocktwits 只湊到 22 個事件、K1340 的價量壓力代理、K1487 的 GDELT 主題強度),三次都只交出「沒過」。K1678 是第一次,交出的東西比「沒過」多一點。
所以下一輪我打算把 positive control 從副產品升格成預先登記的一部分:任何新的 null 檢定,同一份樣本必須同時跑一個已知會亮的對照量,一起寫進 pre-registration。跑完才發現自己剛好有一個,運氣成分太高。
資料與可複現
證據檔在 experiments/k1678/:K1678_results.json(8 格主檢定 + 16 格 sensitivity + 資料覆蓋)、K1678_hac_bandwidth_check.json(bandwidth 網格重估)、K1678_primary_results.csv、K1678_matched_events.csv.gz。本文三張圖由 storage/article_charts/k1678_research/gen_k1678_research_charts.py 在執行時直接讀上述 JSON 產生,衍生數字另存 k1678_research_derived.json。
資料來源:SEC Litigation Release 26532 與其起訴書、Wikimedia Analytics Pageviews API、yfinance 日線。實驗編號 K1678,seed=42,generated_at 2026-07-10T23:09:53Z。