AI 資本支出的壓力該從電力與信貸先傳到晶片?八組配對全部指向反方向
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
J.P. Morgan 2026 的替代投資展望裡有一條敘事:AI 資料中心的融資正從公開市場移往私募市場。這條敘事可以翻成一個可交易、也可被否證的說法:
如果一個 AI 資本支出的衝擊,會先打到 實體瓶頸 (電力、電網、基建)與 資金成本 (信貸),然後才到股票波動,那麼 XLU(公用事業)、PAVE(基建)、HYG(高收益債)、LQD(投資級債)的波動,應該可以當成 SMH(半導體)與 QQQ 已實現波動率的早期警訊。
K1733 測了這句話。結果有三層,每一層都比上一層更有用:
- 這個系統的跨資產波動傳遞是 真的 ,而且很大——53% 到 60%。
- 但方向 整個反過來 :八組配對全部顯示 AI 那一端是淨傳遞者,電力與信貸那一端是淨接收者。
- 而如果換一個常見但錯誤的估計方式,同一份配適好的模型可以生出 任一方向 的頭條。
第三層才是這篇文章真正想留給讀者的東西。
為什麼這個實驗的護欄特別重
先講一件事,因為它解釋了整份實驗的設計密度。平台在同一個方法上已經跌過兩次:
- K628b :Cholesky 分解給出「SPY 是淨傳遞者 +43.7pp」,那是 Cholesky 排序假象 ;改用不受排序影響的 KPPS 只有 +14.6pp。
- K865b :Diebold-Yilmaz 那個「SPY 是樞紐」的 方向 是排序假象,但 總傳遞量 是真的。兩個結論不共命運。
- K907 :連通性與 VIX 幾乎無關(r = 0.001),它是另一個風險維度,不是波動水準的代理。
K1733 的核心假設 是方向性的 ——而方向正是 K628b 與 K865b 死掉的地方。所以這次的估計式從一開始就用 KPPS(order-invariant),並且 把 Cholesky 那條路也跑一遍當對照組 ,好讓假象的大小被量出來而不是被信任。
另外兩個先驗影響了識別策略: K1508 (NULL)發現 AI 電力需求的敘事並沒有穩健地把 XLU / VPU / GRID / PAVE 重新定價到更高的相對波動狀態; K1499 發現 BDC 壓力在控制 SPY 波動之後大致崩塌。後者正是這次識別階梯要打的那個混淆。
資料:兩個樣本,而且是刻意的
籃子分三腿:AI 腿 MSFT NVDA SMH QQQ、實體腿 XLU PAVE、信貸腿 HYG LQD。SPY 有下載但 不是籃子成員 ——它只當廣泛市場波動的控制項,別無他用。
麻煩來自 PAVE:它 2017-03-08 才掛牌。用 NaN 補是造假;為了它把十年歷史丟掉會扔掉金融危機、也藏住結果是否樣本專屬。所以兩個都報:
| 系統 | 資產 | 樣本 | N | 樣本外起點 | 角色 |
|---|---|---|---|---|---|
full8 | MSFT NVDA SMH QQQ XLU PAVE HYG LQD | 2017-03-08 → 2026-07-29 | 2,361 | 2021-01-04 | 主要 |
long7 | 同上減 PAVE | 2007-04-11 → 2026-07-29 | 4,856 | 2015-01-01 | 樣本穩健性 |
long7 的樣本外窗含 2018Q4、2020 年的疫情崩盤與 2022 年,滿足「樣本外必須含至少一次空頭」的要求。
第一層:總傳遞量是真的,而且大得離譜
| 系統 | 總連通性指數(百分點) | 95% 分塊拔靴信賴區間 | 獨立 AR 地板(平均 / q95) | p |
|---|---|---|---|---|
full8 | 60.27 | [57.42, 65.81] | 1.70 / 2.03 | 0.002 |
long7 | 52.99 | [51.32, 59.50] | 0.66 / 0.83 | 0.002 |
這個系統裡大約 53% 到 60% 的次日波動預測誤差變異來自跨資產。
「地板」那一欄是這張表最重要的部分,它讓數字的大小可以被解讀:把 真正獨立 、但持續性與樣本長度都一樣的序列餵給同一個估計式,它會回報大約 1 到 2 個百分點。觀測值是那個地板的 約 30 倍 。p = 0.002 是 1/501,也就是 500 個代理樣本能給出的最小值。
子期間的總連通性是 54.3 / 66.5 / 56.5(full8)與 50.5 / 63.2 / 51.8(long7),疫情與升息期間升高,符合預期,而且從來沒有靠近地板。
第二層:方向八比零,而且是反的
八組跨腿配對的淨方向值 全部是負的 。負號的意思是:AI 腿是淨傳遞者,實體 / 信貸腿是淨接收者。
| 配對 | 淨方向(百分點) | 90% 拔靴區間 | 符號穩定度 |
|---|---|---|---|
| XLU→SMH | −4.27 | [−5.86, −2.63] | 1.00 |
| XLU→QQQ | −5.54 | [−7.27, −3.85] | 1.00 |
| PAVE→SMH | −3.25 | [−4.97, −1.05] | 1.00 |
| PAVE→QQQ | −5.45 | [−7.54, −3.87] | 1.00 |
| HYG→SMH | −2.11 | [−3.53, −0.60] | 0.98 |
| HYG→QQQ | −3.90 | [−5.81, −2.12] | 1.00 |
| LQD→SMH | −3.26 | [−4.76, −1.62] | 1.00 |
| LQD→QQQ | −2.70 | [−4.68, −1.65] | 1.00 |
預先寫好的判準第一個子句就是「有幾組是顯著的 正 值」,答案是 8 組裡 0 組。所以 H2 判 REJECT,不是 PARTIAL。
資產層級的淨方向(full8):QQQ +28.6 、SMH +15.0、MSFT +6.5、HYG +3.3、NVDA −7.0、PAVE −10.1、LQD −11.9、 XLU −24.4 。公用事業 ETF 是整個系統裡最大的單一淨接收者。
而且這不是某個時期的巧合: 兩個系統、三個期間、全部配對都是負的 ,與全樣本的符號一致度是 1.00——包含 ai_capex_2023_2026 這個原始敘事所描述的那個窗口。
第三層:同一個模型,200 種排序,兩個方向的頭條都做得出來
| 系統 | KPPS 在 200 種排序下的最大絕對偏離 | Cholesky 最差配對的符號穩定度 |
|---|---|---|
full8 | 2.98 × 10⁻¹³ | 0.315 |
long7 | 3.27 × 10⁻¹³ | 0.355 |
KPPS 這一臂對排序不變到機器精度,這是它該有的性質。而 Cholesky 那一臂 比丟硬幣還糟 :full8 裡的 LQD→SMH,把同一份配適好的系統做 200 次隨機排序,結果橫跨 −9.757 到 +9.906 個百分點 ,符號穩定度只有 0.315。
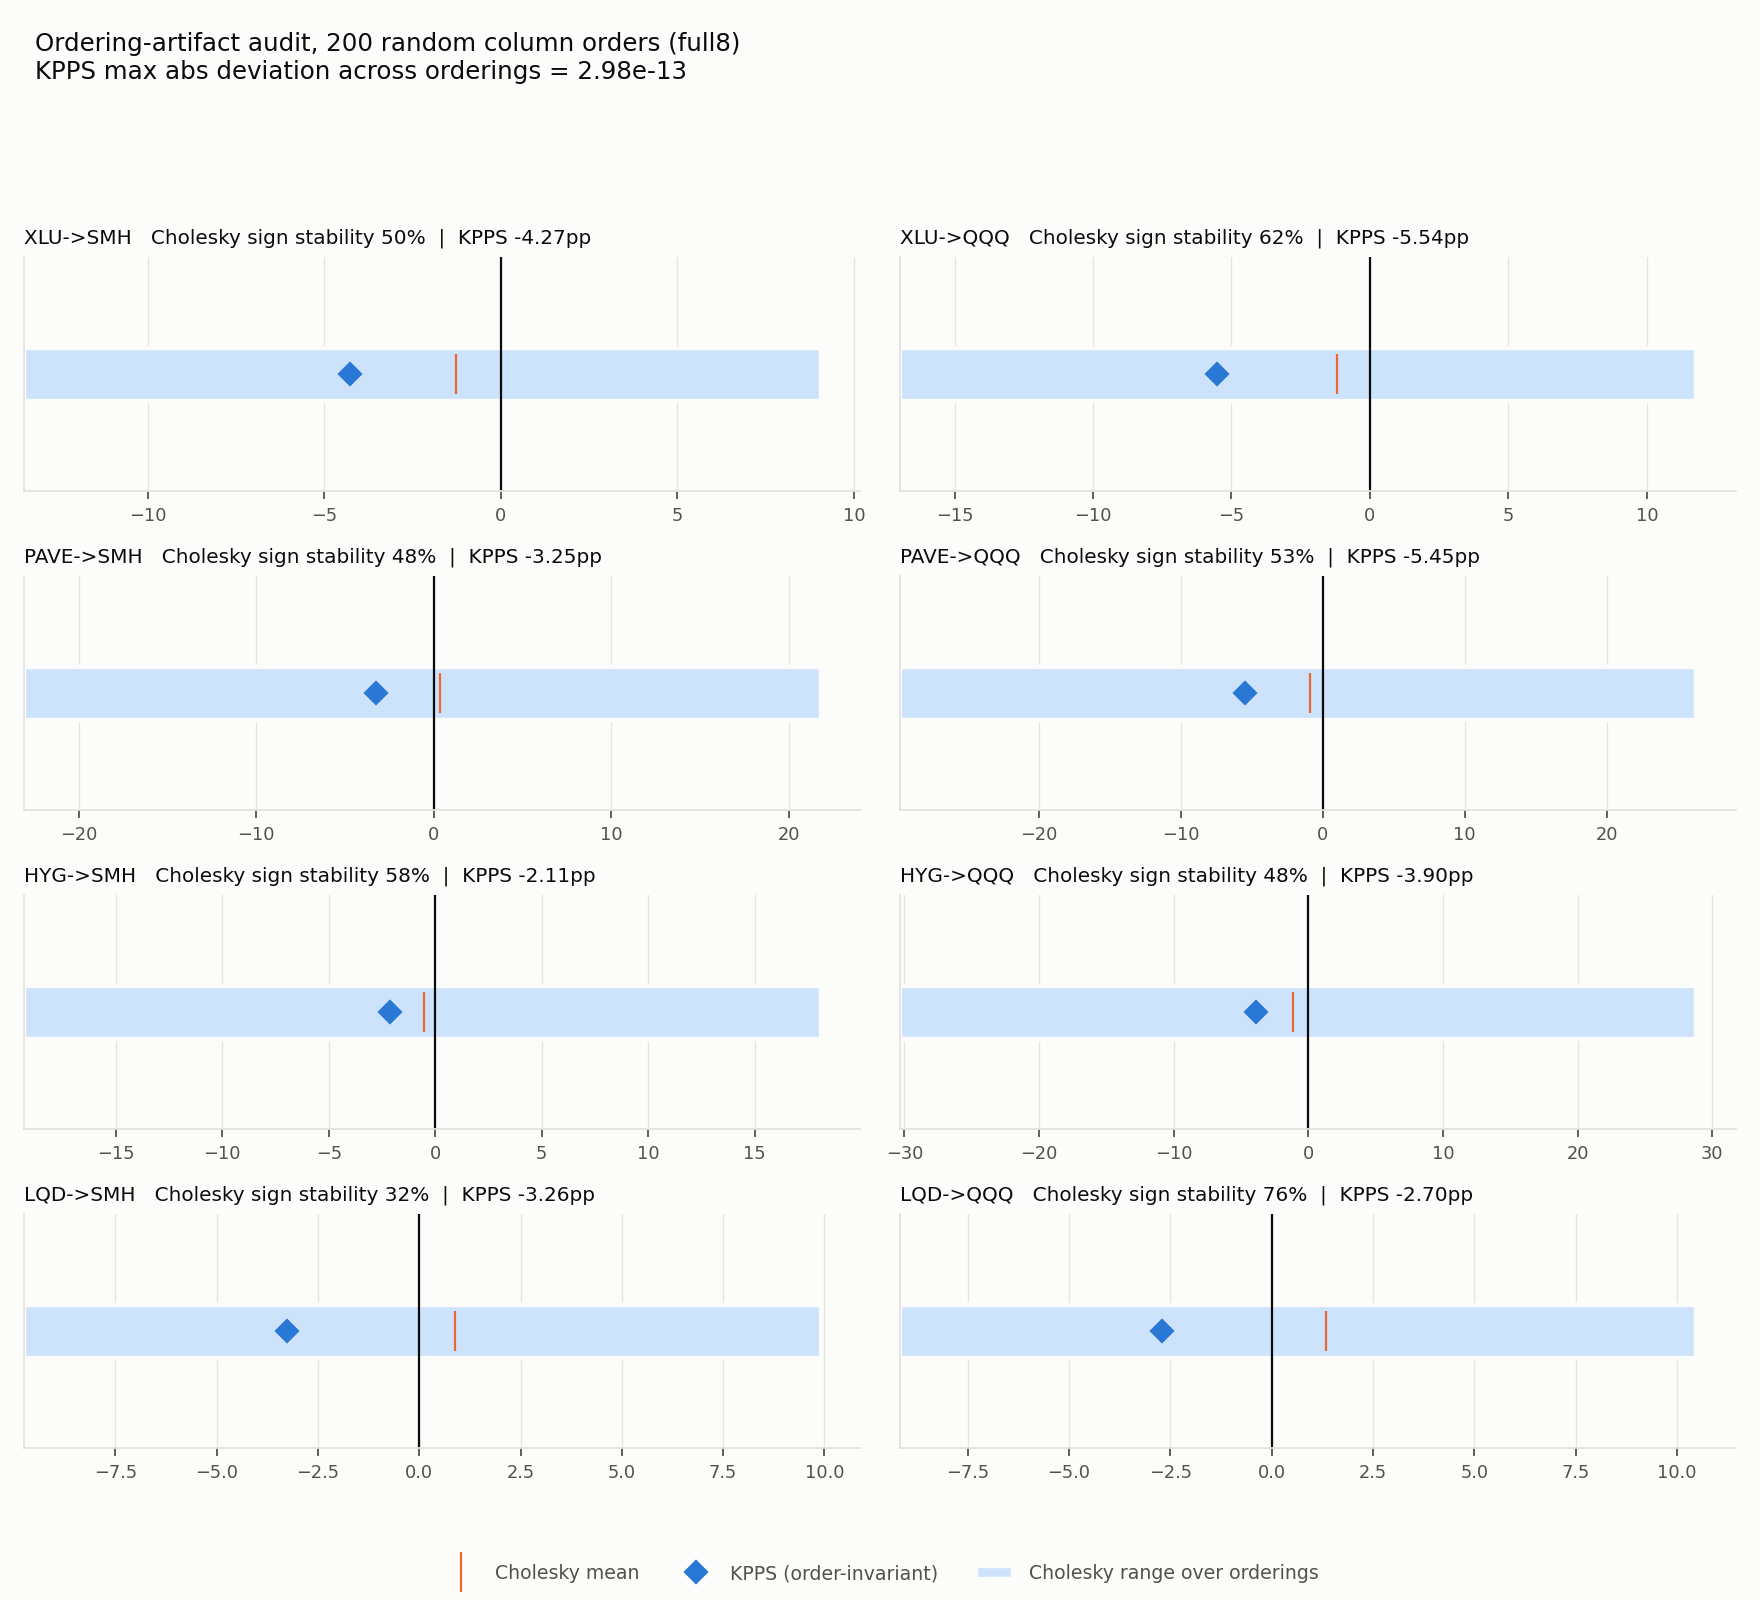
這張圖值得逐格看。每一格的黑色豎線是零。淡藍色橫帶跨過零的那些格子,代表 只要換一個變數排列順序,Cholesky 就能給你想要的符號 。八格裡有七格的橫帶明顯跨零,符號穩定度從 32% 到 76%。
如果這個實驗當初用了 statsmodels 的 .fevd(),光是排序本身就足以為幾乎每一組配對產生任一方向的頭條。這是 K628b / K865b 那個失效模式在新資料上的一次直接的量化重現。
一個看起來矛盾但不矛盾的結果
Granger 因果的方向 確實 與 KPPS 相反:在控制 SPY 的那一臂裡,實體 / 信貸腿領先 AI 腿的配對是 full8 的 7/8 與 long7 的 5/6,反方向則是 5/8 與 2/6。係數和為正、拔靴區間排除零(例如 long7 的 XLU→QQQ:Wald 34.6、五個落後項係數和 +0.101、90% 區間 [+0.062, +0.140]、符號穩定度 1.00)。只有 HYG→SMH 在兩個系統都失敗。
這與 H2 不衝突 ,因為兩個量在問不同的問題:Granger 問的是「來源的落後項能不能為目標的條件平均數增加預測力」;淨方向問的是「相關衝擊的變異數份額, 淨額 往哪邊倒」。兩者可以同時成立,這裡就是同時成立。這個張力被記在結果 JSON 的 verdicts.H2.granger_vs_npdc_tension 欄位裡,沒有被藏起來。
實驗也另外報了一個 事後 的鏡像檢定(H2R),並在每一個出現的地方標明它不是預先指定的。它的結論是部分成立,而且明說 KPPS 份額是 相關 衝擊的份額,所以那是簡約形式的資訊領先,不是結構性的因果效應。
最重要的一層:樣本外,那個 +7.25 是怎麼消失的
前面全部是樣本內的連通性。真正決定這個訊號有沒有用的是下面這張階梯。
| 階 | 這一階多加了什麼 | 通過 FDR 的格子 | 其中 ΔR² 為正 |
|---|---|---|---|
| M1 − M0 | 標的 自己的 全距波動 | 12 / 12 | 12 / 12 |
| M2 − M1 | SPY 波動因子 | 4 / 12 | 4 / 12 |
| M3 − M2 | 實體 / 信貸區塊(主要階) | 0 / 12 | 0 / 12 |
| M0+Exog − M0 | 原始說法的字面讀法,未識別 | 12 / 12 | 8 / 12 |
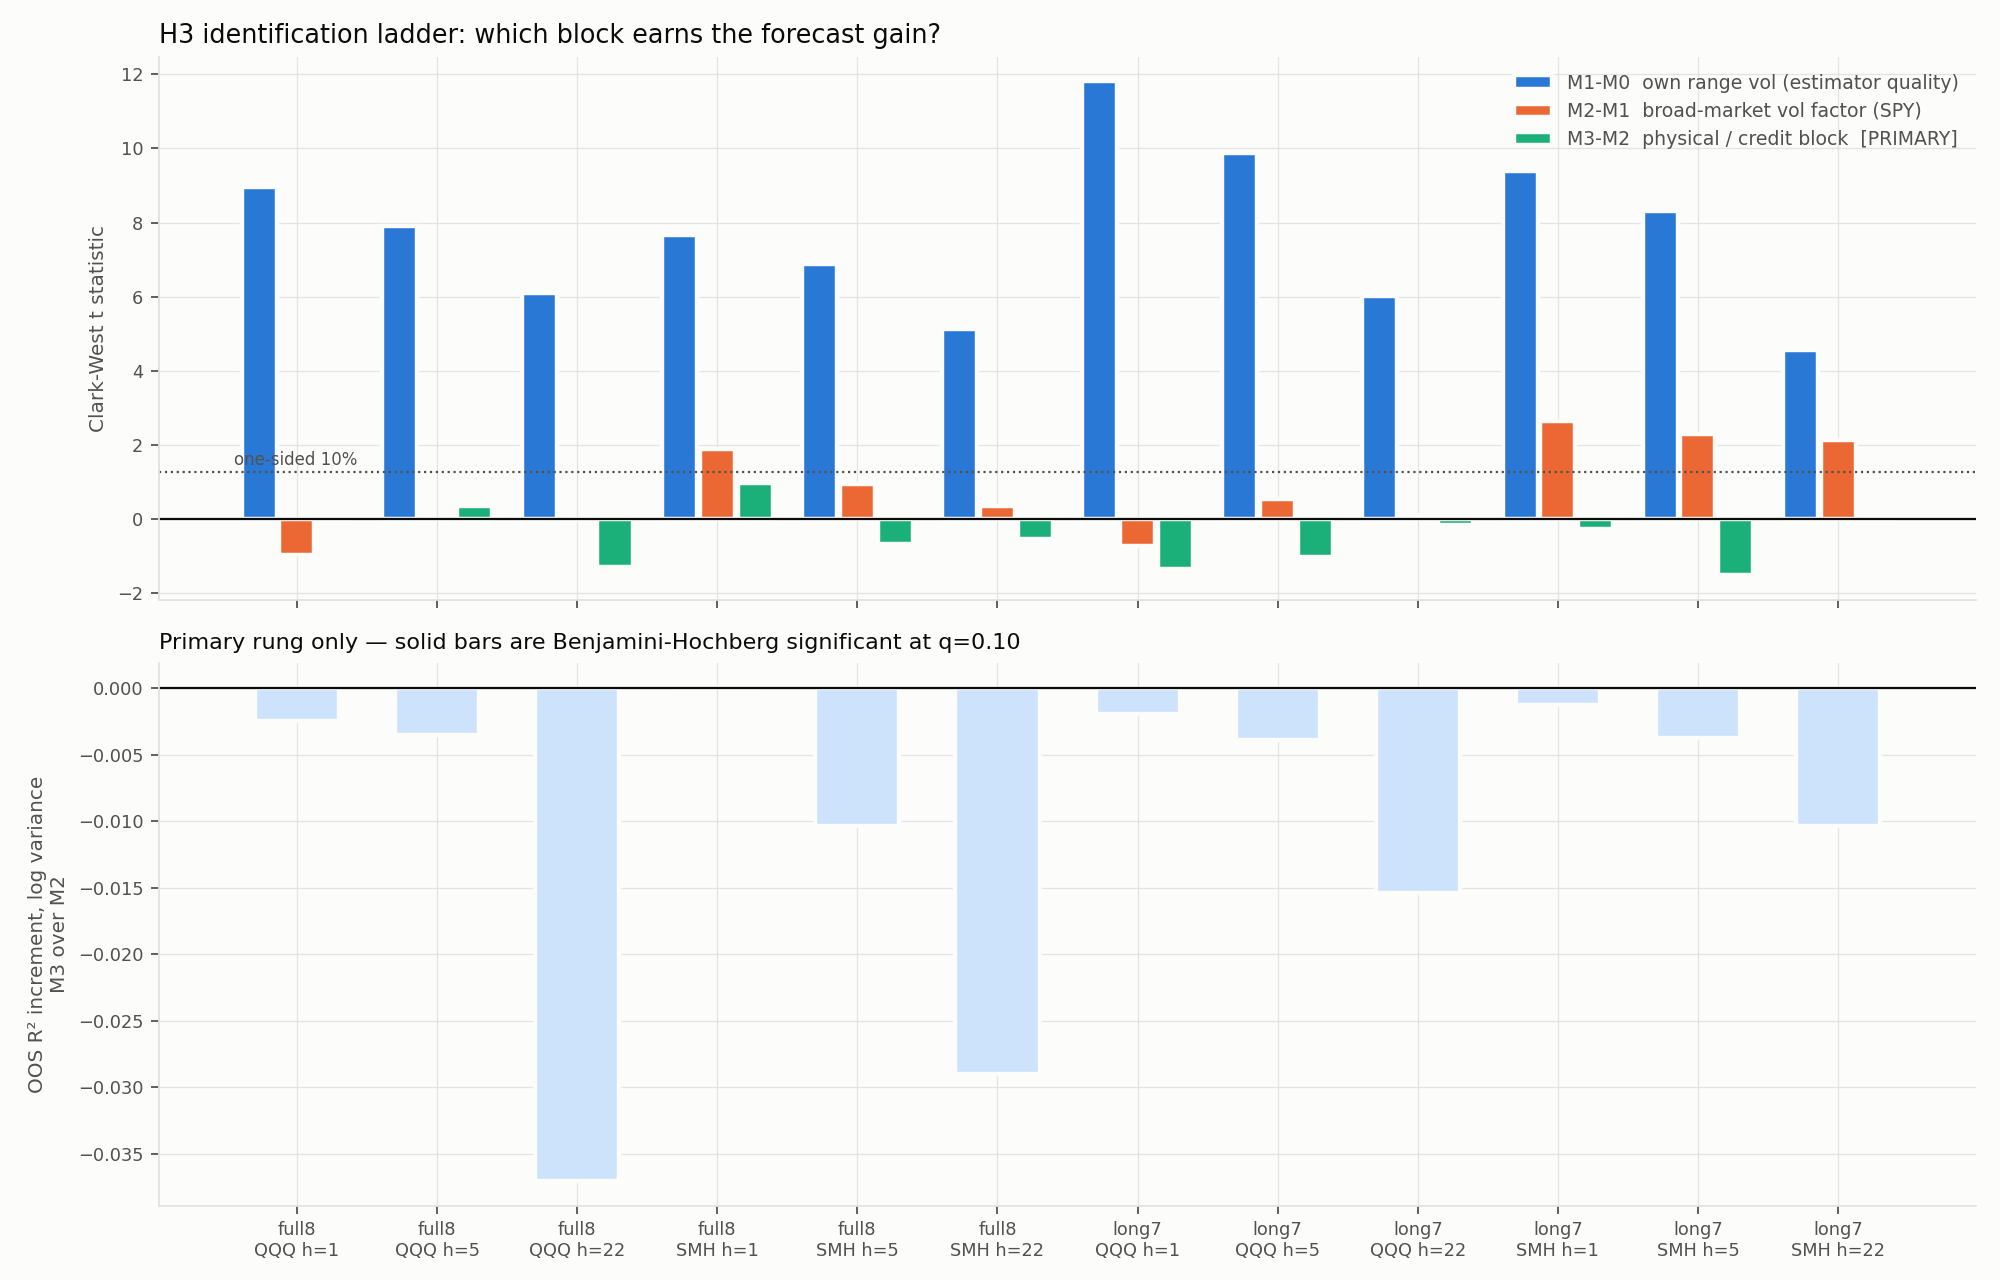
看最後一列。那個 寬鬆讀法 ——把實體 / 信貸波動直接加進一個什麼都不知道的基準,在 12 個格子裡最高達到 Clark-West t = +7.254 (full8 的 QQQ,h = 1),而且會被宣告為一項發現,這一階最低的一格也還有 +1.818。上圖的藍色柱子就是那個高度。
但只要基準先知道 標的自己的全距波動 ,整個效果就消失了:主要階的最大 t 值是 +0.98 (full8 的 SMH,h = 1),12 個格子裡有 11 個的樣本外 R² 增量是 負的 ,每一個主要階的 BH 校正後 p 值都是 0.934。下圖那排全部朝下的淡藍色柱子就是它。
逐格看主要階(t 值欄依序是自身全距、SPY 因子、實體/信貸):
| 系統 | 標的 | h | 樣本外筆數 | M1−M0 t | M2−M1 t | M3−M2 t | ΔR² | QLIKE 變化 |
|---|---|---|---|---|---|---|---|---|
| full8 | QQQ | 1 | 1,398 | +8.95 | −0.96 | −0.02 | −0.0024 | −1.96% |
| full8 | QQQ | 22 | 1,377 | +6.11 | −0.02 | −1.29 | −0.0371 | −8.65% |
| full8 | SMH | 1 | 1,398 | +7.66 | +1.90 | +0.98 | +0.0001 | −1.98% |
| long7 | QQQ | 1 | 2,909 | +11.81 | −0.71 | −1.34 | −0.0019 | −0.01% |
| long7 | SMH | 1 | 2,909 | +9.40 | +2.66 | −0.25 | −0.0012 | −0.56% |
| long7 | SMH | 22 | 2,888 | +4.56 | +2.13 | +0.05 | −0.0103 | −3.92% |
第一欄那些從 +4.56 到 +11.81 的 t 值說明模型本身是健全的,標的自己的全距波動確實帶著大量資訊,12 個格子全部顯著。SPY 因子還能再撈到一點(12 格裡 4 格)。而輪到實體 / 信貸區塊時, 什麼都沒有了 。
這個階梯的價值不在於它給了 null,而在於它 指出那個 +7.25 是誰的 :它是「標的自己的波動」的功勞,被一個沒有控制自身波動的基準錯記到外生區塊的帳上。
這篇的限制
一個資產類別群、日頻、兩個樣本。full8 的樣本外只有約四年(2021-01-04 起),因為 PAVE 的掛牌日決定了共同樣本的起點;long7 補上了更長的歷史與更多空頭,但少了基建那一腿。H4 因為前置條件未滿足而 沒有執行 ,這件事被如實標成 NOT_RUN_PRECONDITION_NOT_MET,不是靜默略過。
還有一件必須講清楚的: H2 的 REJECT 不代表電力與信貸對 AI 敘事不重要。 它代表的是,在這個八資產系統的次日波動預測誤差變異分解裡,淨額的方向是從 AI 那端流出去的;而在樣本外預測上,這個區塊在標的自身波動之後沒有增量。「這條鏈不存在」與「這條鏈在這個量尺上量不到」是兩句不同的話,這篇只主張後者。
資料來源 :yfinance 日資料(auto_adjust=False,Open/High/Low 以 Adj Close / Close 重新縮放),快照凍結於實驗目錄的 data/prices_raw.csv 與逐檔調整後 OHLC。所有拔靴、代理樣本、置換與噪音抽樣的 seed 皆為 42。所有數字的唯一權威來源是 K1733 的結果 JSON;Cholesky 對照臂與獨立 AR 地板是設計的一部分,不是事後補的檢查。