把區間當成預測目標,贏不了一個校準過的純量基準
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
近年有一批論文把金融時間序列當成 區間 來建模:每天的最高價與最低價本身就是一個區間,直接對區間建模、而非先壓成一個純量再預測。K1670 拿六個 ETF 檢驗這件事,verdict 是 NULL_NO_INTERVAL_EDGE。
結果檔對這個標籤的白話說明逐字寫著:區間值的 OHLC 模型,在樣本外的區間 MSE 上,沒有勝過一個校準過的純量 point-HAR 區間基準。
比什麼、跟什麼比
預測目標是每天相對前一日收盤的對數區間:[log(Low_t/Close_{t-1}), log(High_t/Close_{t-1})]。名目覆蓋率設 80%。
三個模型:
- point_har(基準) :用純量的對數 HAR 預測區間半寬,中心設為零,並校準到訓練段 80% 的包含率。
- center_radius_interval :OLS HAR 預測中心,加上對數 HAR 預測半徑,同樣校準到 80%。
- bounds_direct_interval :用落後的區間特徵,分別對下界與上界做 OLS 預測,同樣校準到 80%。
基準是刻意做強的。 結果檔的誠實註記裡明寫這一點:基準與兩個區間模型校準到同一個 80% 訓練包含率目標。這件事決定了這個 null 的意義,輸的對手不是一個隨手搭的稻草人。
標的是 SPY、QQQ、IWM、TLT、GLD、HYG,價格取自 yfinance(auto_adjust=True),起點 2005-01-01,最後一日 2026-07-09。初始訓練 1,000 列,每 21 列重配適,樣本外以擴展窗方式逐列推進。前瞻防護寫在方法欄:原始區間特徵一律 raw_signal.shift(1),第 i 列樣本外只用 work.iloc[:i]。
主要損失是區間 MSE(下界誤差平方加上界誤差平方),次要損失是 alpha = 0.20 的 interval score,對未包含實際區間另有懲罰。推論用 Diebold-Mariano、HAC h=1,跑在依日期叢聚的每日平均損失上, Harvey 通過的條件是挑戰者較佳且 t < −3 。
匯總結果:兩個模型都沒過
依日期叢聚的匯總,4,389 個樣本外日期(2009-01-27 到 2026-07-09):
| 模型 | 區間 MSE | 對基準的改善 | DM t | p | Harvey 通過 |
|---|---|---|---|---|---|
| point_har(基準) | 0.000371043 | — | — | — | — |
| center_radius_interval | 0.000370917 | +0.0340% | −0.3178 | 0.7507 | 否 |
| bounds_direct_interval | 0.000376040 | −1.3468% | +0.9024 | 0.3669 | 否 |
改善幅度是 0.034% 與 −1.35%,t 值是 −0.32 與 +0.90,門檻是 −3。
次要損失的方向還相反:interval score 上 center_radius 是 −0.0958%(較差,t = +1.5328、p = 0.1254),bounds_direct 是 +0.1000%(較好,t = −0.3139、p = 0.7536)。兩個損失函數各自把兩個模型排成不同的順序,而兩邊的 p 值都遠離顯著。
覆蓋率三者接近:基準 78.41%,center_radius 78.34%(低 0.075 個百分點),bounds_direct 77.80%(低 0.608 個百分點)。名目是 80%,三者都略低於名目,差距在同一個量級。
逐檔看:十二格裡有三格越過門檻,兩格方向相反
匯總掩蓋了個別標的的差異,所以逐檔的區間 MSE 比較值得單獨看(六檔 × 兩個模型 = 12 格):
| 標的 | center_radius 改善 / t | bounds_direct 改善 / t |
|---|---|---|
| SPY | +0.3775% / −1.6273 | −3.8095% / +1.2234 |
| QQQ | +0.6009% / −4.0813 | −0.6028% / +0.4283 |
| IWM | −0.4482% / +2.4177 | −1.2449% / +0.5526 |
| TLT | +0.2022% / −1.8704 | +0.6541% / −0.4784 |
| GLD | −0.3712% / +3.0309 | −0.9519% / +1.4100 |
| HYG | +0.1662% / −0.5653 | −9.9169% / +3.2299 |
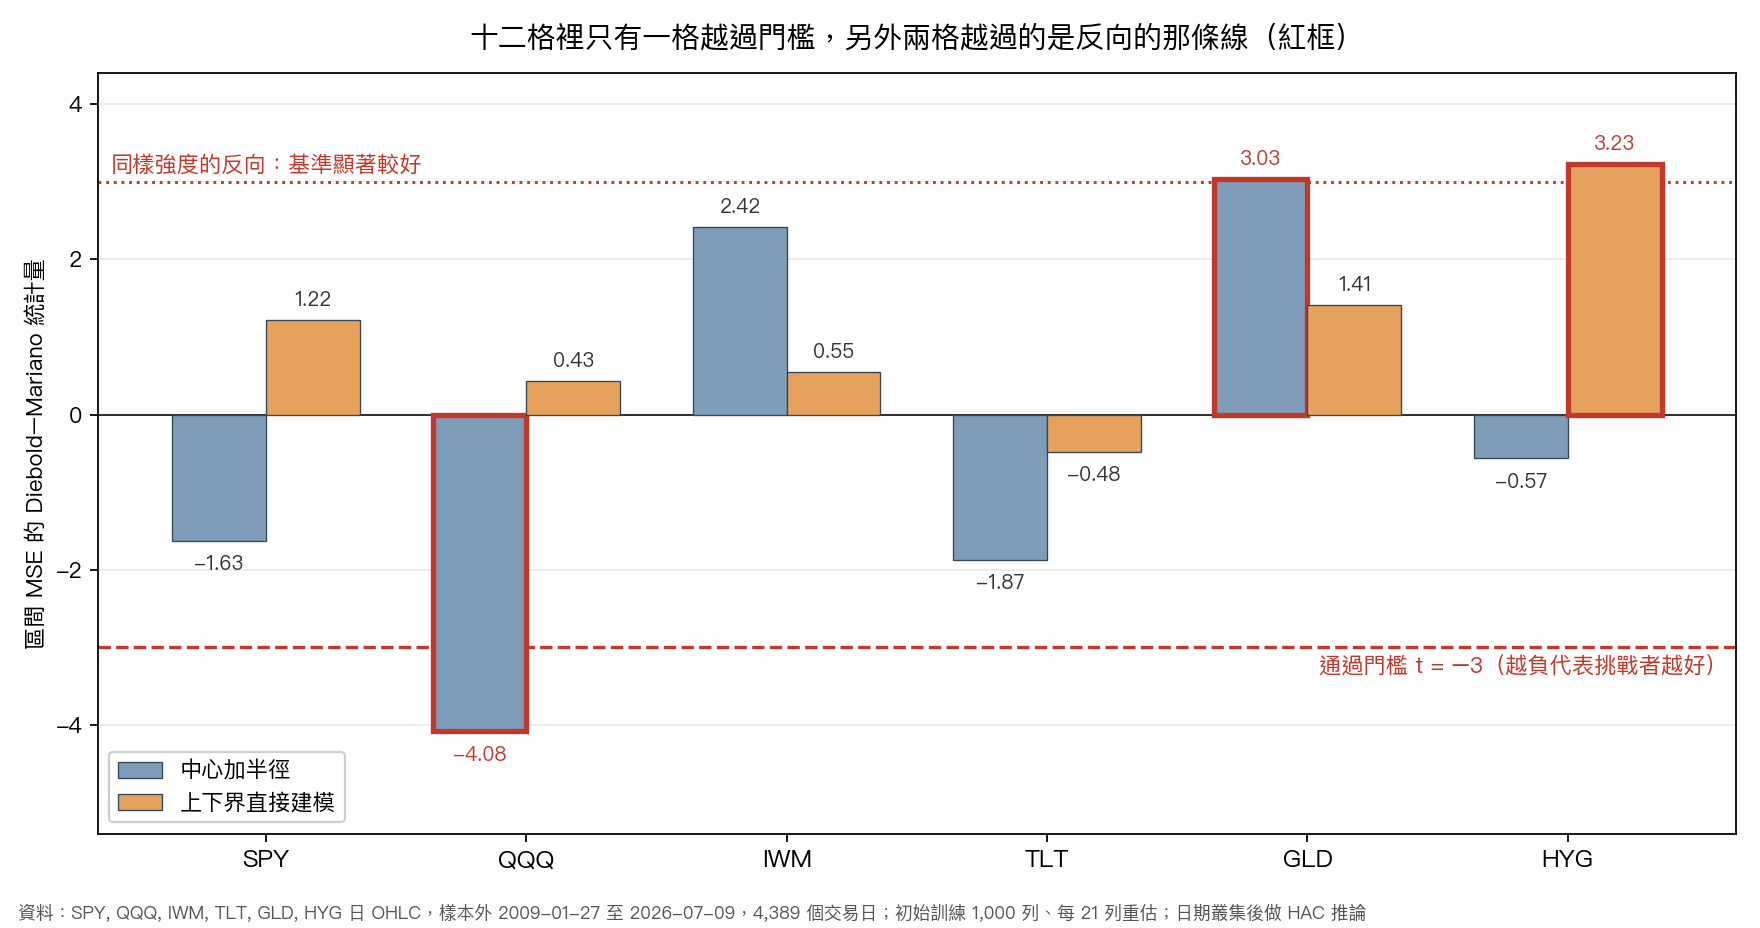
三格的 t 絕對值越過門檻強度:
- QQQ 的 center_radius (t = −4.0813、p ≈ 0.0000)是唯一一格
interval_mse_harvey_pass為真的格子,改善 0.6009%。 - GLD 的 center_radius (t = +3.0309、p = 0.0025)與 HYG 的 bounds_direct (t = +3.2299、p = 0.0012)方向相反,代表區間模型顯著 更差 ,其中 HYG 那一格差了 9.92%。
一格通過、兩格顯著地往反方向,這是十二次比較的結果。verdict_details.pass_models 是空陣列,因為判準看的是匯總,而匯總的 t 是 −0.3178。
HYG 的樣本外從 2011-05-02 開始、共 3,819 日,其餘五檔是 4,389 日——HYG 的價格序列從 2007-04-11 才有。
改善幅度本身的分布,與 t 值的分布不是同一件事:
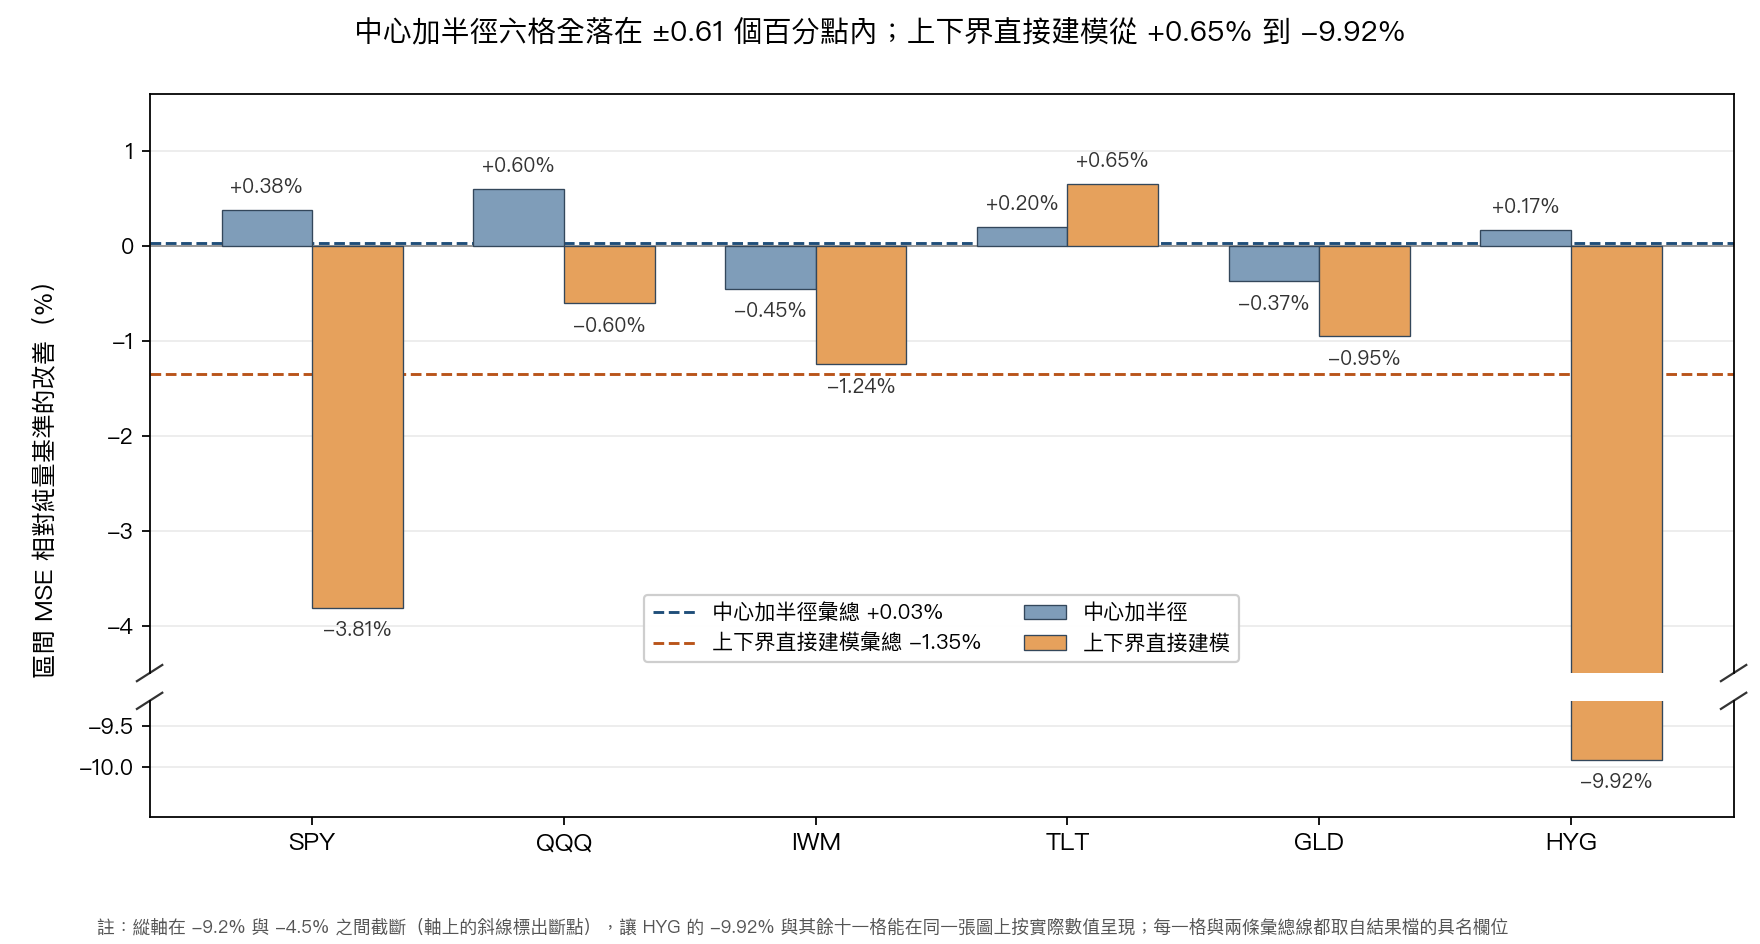
center_radius_interval 六格全部落在正負 0.61 個百分點以內,bounds_direct_interval 則從 +0.6541% 一路到 −9.9169%。兩個模型的差異不只在平均水準,也在離散程度,而匯總的 t 值同時受這兩件事影響。
三個模型的覆蓋率幾乎一樣,這件事本身是結果的一部分
校準的目標是 80% 訓練包含率。實際的樣本外覆蓋率,逐檔:
| 標的 | point_har | center_radius | bounds_direct |
|---|---|---|---|
| SPY | 0.7790 | 0.7753 | 0.7719 |
| QQQ | 0.7758 | 0.7744 | 0.7772 |
| IWM | 0.7856 | 0.7849 | 0.7740 |
| TLT | 0.7824 | 0.7854 | 0.7758 |
| GLD | 0.7831 | 0.7831 | 0.7851 |
| HYG | 0.7999 | 0.7976 | 0.7850 |
十八個讀數全部落在 0.772 到 0.800 之間,沒有一個到達 80% 的名目水準,而三個模型之間的差距最大只有 SPY 的 0.71 個百分點。
這個結果解釋了為什麼區間 MSE 的差距那麼小: 三個模型產生的區間寬度被校準到同一個目標,所以它們畫出來的帶子大小相近,剩下的差別只在中心與寬度怎麼隨時間變化。 區間建模若要贏,得在這個受限的空間裡贏,而那正是這個實驗的設計意圖。
樣本外覆蓋率系統性低於名目 80%,三個模型一致,這指向校準本身而非某個模型,訓練段的包含率被推到 80%(SPY 的 mean_train_coverage 是 0.7999),樣本外掉到 0.78 附近,是校準外推的常見行為。
這個 null 的檢定力上界
樣本量不是瓶頸。 每檔 3,819 到 4,389 個樣本外日期,橫跨 2009 到 2026 共十七年多,包含 2011、2018、2020、2022 幾次波動事件。在這個樣本量下,若區間建模真有 1% 以上的穩定優勢,DM 檢定看得到。
真正的上界在基準的強度與比較的口徑。 基準被校準到與挑戰者相同的包含率目標,所以這裡量的是「在包含率對齊之後,區間建模還能不能贏」,而不是「區間建模有沒有用」。一個未校準的基準會讓同一批數字看起來完全不同。
六檔標的共用同一段日曆期間 ,2020 年 3 月這種全市場事件會同時進入六個樣本,所以十二次比較不是十二個獨立的觀察。三格的 t 絕對值越過門檻強度(一格在通過方向,兩格在反向)這件事要放在這個相關結構裡讀。
結果檔的三條誠實註記本身就是範圍聲明:這是日頻 OHLC 的區間代理實驗,不是五分鐘已實現波動的複製;基準是刻意做強的; 區間包含率與區間 MSE 回答的是區間預測問題,不可以改寫成純量 RV 的 QLIKE 優劣 。
所以這個 null 的範圍是: 這六檔、這段期間、這個 80% 名目覆蓋、這兩個區間模型、以及一個同樣校準過的純量基準之下,區間建模沒有取得匯總層級的優勢。 它沒有證明區間值時間序列這個方向無效,也沒有回答換一個區間模型族、換一個損失函數或換一個覆蓋水準會怎樣。
為什麼「基準做強」會改變結論的意義
同一個實驗換一個弱基準,結論會反過來,而那個反過來的結論不會比較正確。
這裡的基準把中心固定為零、只預測半寬,然後把半寬乘上一個由訓練段包含率決定的倍數(SPY 的平均倍數是 2.4742)。它沒有用到區間的任何非對稱資訊,也沒有預測中心。它唯一做對的事是 校準 ——把帶子調到該有的寬度。
center_radius_interval 比它多了一整個中心預測模型,bounds_direct_interval 更是分別預測上下界。兩者都拿到了基準沒有的資訊,而匯總結果是 +0.034% 與 −1.35%。
所以這份結果真正說的是: 在區間寬度已經被校準對的前提下,額外預測中心與非對稱性所帶來的邊際資訊,在這個資料上接近於零。 一個沒有校準的基準會讓同樣的兩個模型看起來大勝,而那個勝利來自校準、不是來自區間建模。
接下來能做什麼
QQQ 那一格是唯一的正面訊號,而它現在的地位是「十二次比較裡的一次」。要把它變成結論,需要的是事前指定 QQQ 與 center_radius、換一段樣本外重測,而不是回頭在同一批結果裡強調它。
另一個方向來自兩個損失函數排序不一致這件事:區間 MSE 與 interval score 對同一組預測給出不同的優劣順序,代表這兩個指標在這個資料上量的不是同一件事。先釐清要優化哪一個,再談誰贏。
資料與程式 :experiments/k1670/K1670.py、experiments/k1670/K1670_results.json。
方法文獻 :結果檔的 references 欄列出多項,其中直接的動機來源是 Huarng, Yu and Li (2025)《A Dynamic Fuzzy Modeling Method for Interval Time Series and its Application to Financial Market Forecasting》(Journal of Forecasting 44(8))、2026 年同期刊的《A Fuzzy Framework for Realized Volatility Prediction》,以及 Martens, van Dijk and de Pooter (2009) 的 S&P 500 波動預測。