迷思實驗室|頂尖期刊的模型,搬回家就靈嗎?
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
一個很多人有的想法:登上頂尖期刊、被學界驗過的模型,直接拿來用,一定比土法煉鋼的老方法準。真的嗎?
我們挑了一個 2016 年登上《計量經濟學期刊》的明星波動率模型 HARQ,用美股 SPY、台灣 0050、台股加權指數三個市場,跨 2010 到 2026 十六年資料,實測了一次。
這個明星模型在賭什麼
先講白話。預測明天的波動,最常用的老方法叫 HAR:把過去一天、一週、一月的波動平均一下,往前推。夠簡單,也夠好用。
HARQ 多做一件事:它會估「今天這個波動數字,量得準不準」。量得特別不準的日子,就少信它一點,把權重調低。
這個巧思在高頻資料上很漂亮。當你手上有每分鐘的價格,「準不準」可以算得很穩。Bollerslev 等三位學者當年就是用高頻資料,證明 HARQ 比 HAR 準。
問題是,一般投資人手上沒有每分鐘的資料,只有每天的開盤、最高、最低、收盤四個數字。用這種粗顆粒資料去估「量得準不準」,這個估計本身會非常吵。搬到這裡,測量誤差加權還幫得上忙嗎?
三個市場,一致地小輸
結果很一致。
| 模型 | 這個模型多做了什麼 | SPY 預測損失 vs 基準 |
|---|---|---|
| HAR(基準) | 只用過去的波動平均 | — |
| HARQ | 加一個「測量誤差權重」 | −2.08% |
| HARQ-F | 三個時間尺度全加權重 | −11.67% |
| HARQ-smooth | 權重先平滑五天再用 | +0.63% |
(負號代表比基準差。SPY 的統計檢定 t 值只有 0.49,離嚴格門檻很遠。)
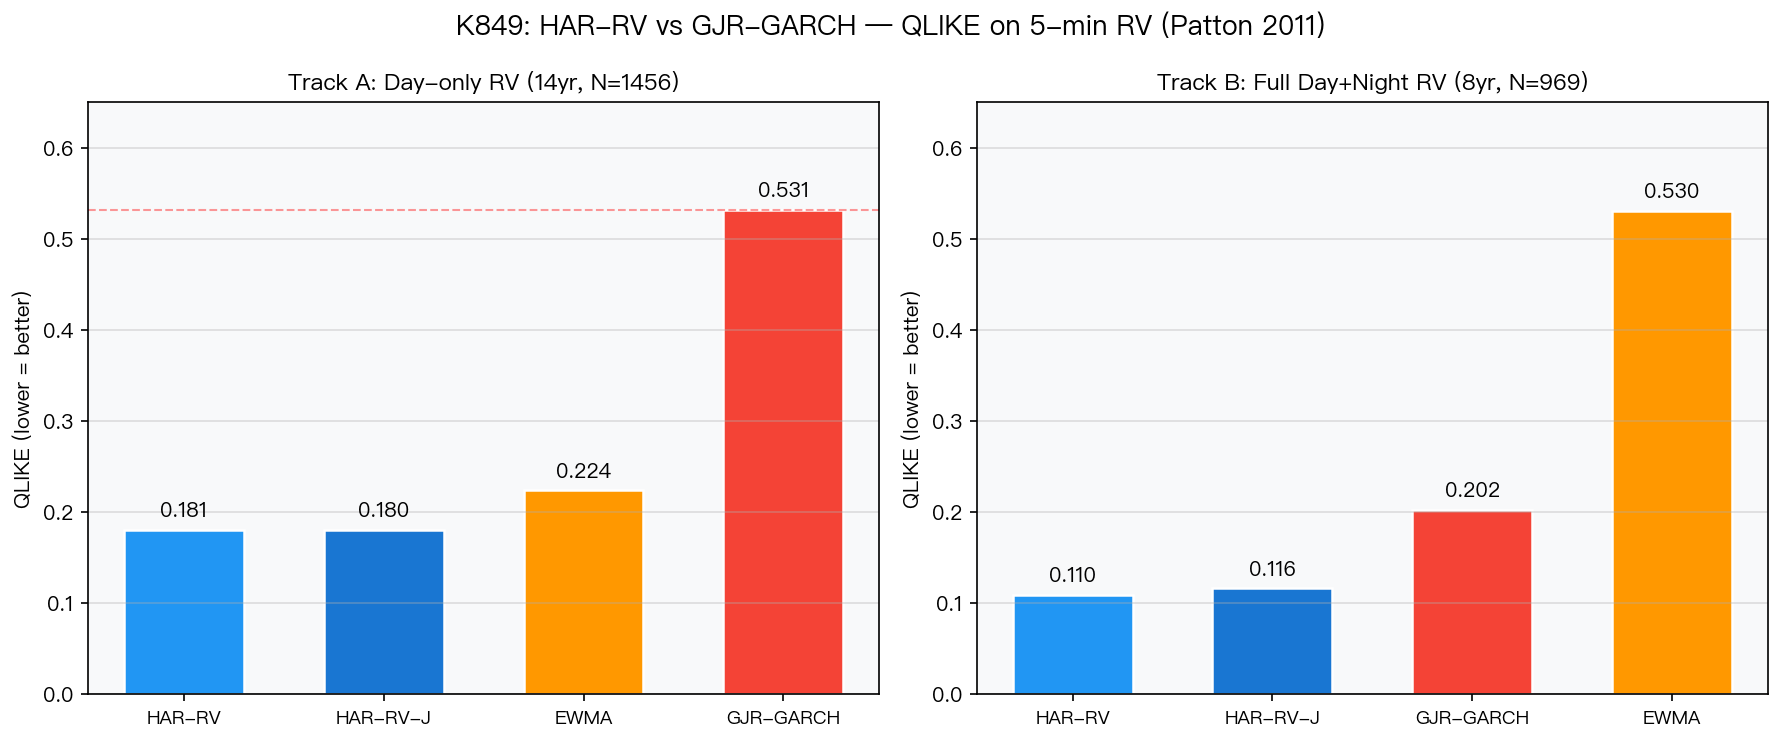
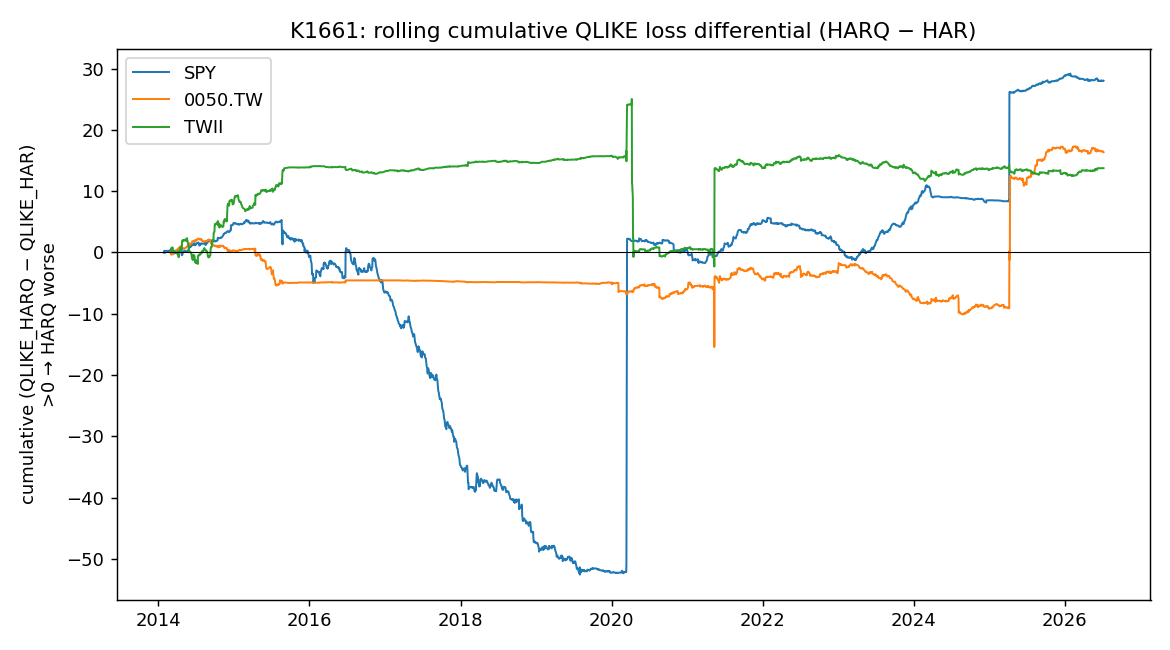
HARQ 在三個市場全部小輸 HAR:SPY 差 2.08%、0050 差 1.07%、台股指數差 1.22%。三個都是負的,但每一個的統計檢定都遠遠碰不到顯著門檻。
誠實說,這在統計上算「打平」(NULL):沒有證據說 HARQ 明確更差,只能說三個市場方向一致地偏差。這是提示,不是定論。
為什麼加權反而沒用
關鍵在一張圖。
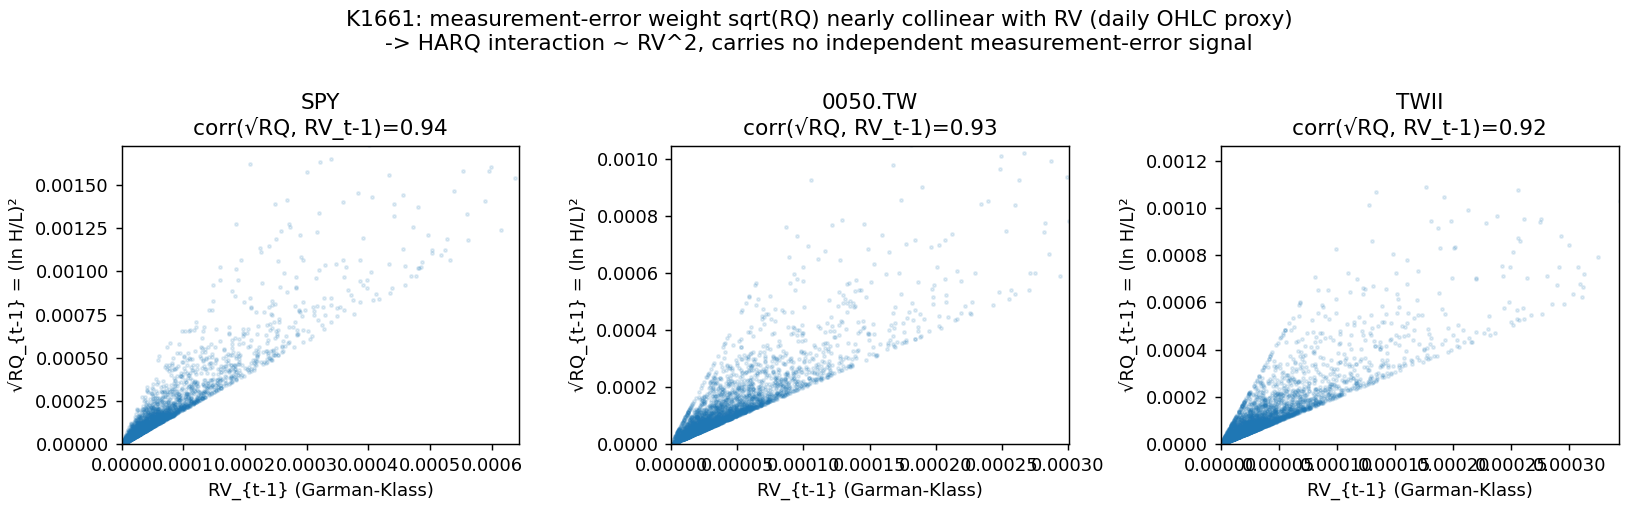
在日頻資料下,那個「測量誤差權重」跟前一天的波動幾乎是同一條線:SPY 兩者相關係數高達 0.938,三個市場都落在 0.92 到 0.94 之間。
權重跟波動重疊,加進去就等於沒帶新訊息,只是多塞一個很吵的參數。多一個參數要估,預測就多一分晃動,於是小輸。
還有兩個佐證。參數更多的 HARQ-F 輸得更慘:SPY 差 11.67%、台股指數差 19.84%。參數越多,在吵雜的資料上越容易被雜訊帶著走。
反過來,把權重先平滑五天、壓掉一些雜訊的 HARQ-smooth,SPY 就回到 +0.63% 的打平。這說明「吵」確實是主因之一。
帶走一句話
這次沒有推翻 HARQ。它在高頻資料上依然是好模型,我們早先用台指期高頻資料測,也看過它方向有利。
教訓在別處:一個模型的優勢,常常綁在它原生的資料頻率上。換了頻率,就得重新驗一次,不能看到頂刊光環就照搬。
省一句:便宜的老方法 HAR,在日頻 OHLC 這種一般人拿得到的資料上,一點都不輸貴模型。
資料來源:yfinance 日頻 OHLC,2010-01 至 2026-07,三資產各約 4000 個交易日、樣本外約 3000 日。實驗編號 K1661,程式與結果可複現。
懶人包圖組