六十六個檢定裡「顯著」出現二十二次,而事前寫下的那一格一次都沒中
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
有一個關於台股的說法,聽起來非常合理。
台積電是加權指數三分之一以上的權重,而金融股是資金面的溫度計。所以只要金控那邊先出現壓力,台積電的波動應該會跟著來,你等於拿到了一個提前的警報器。
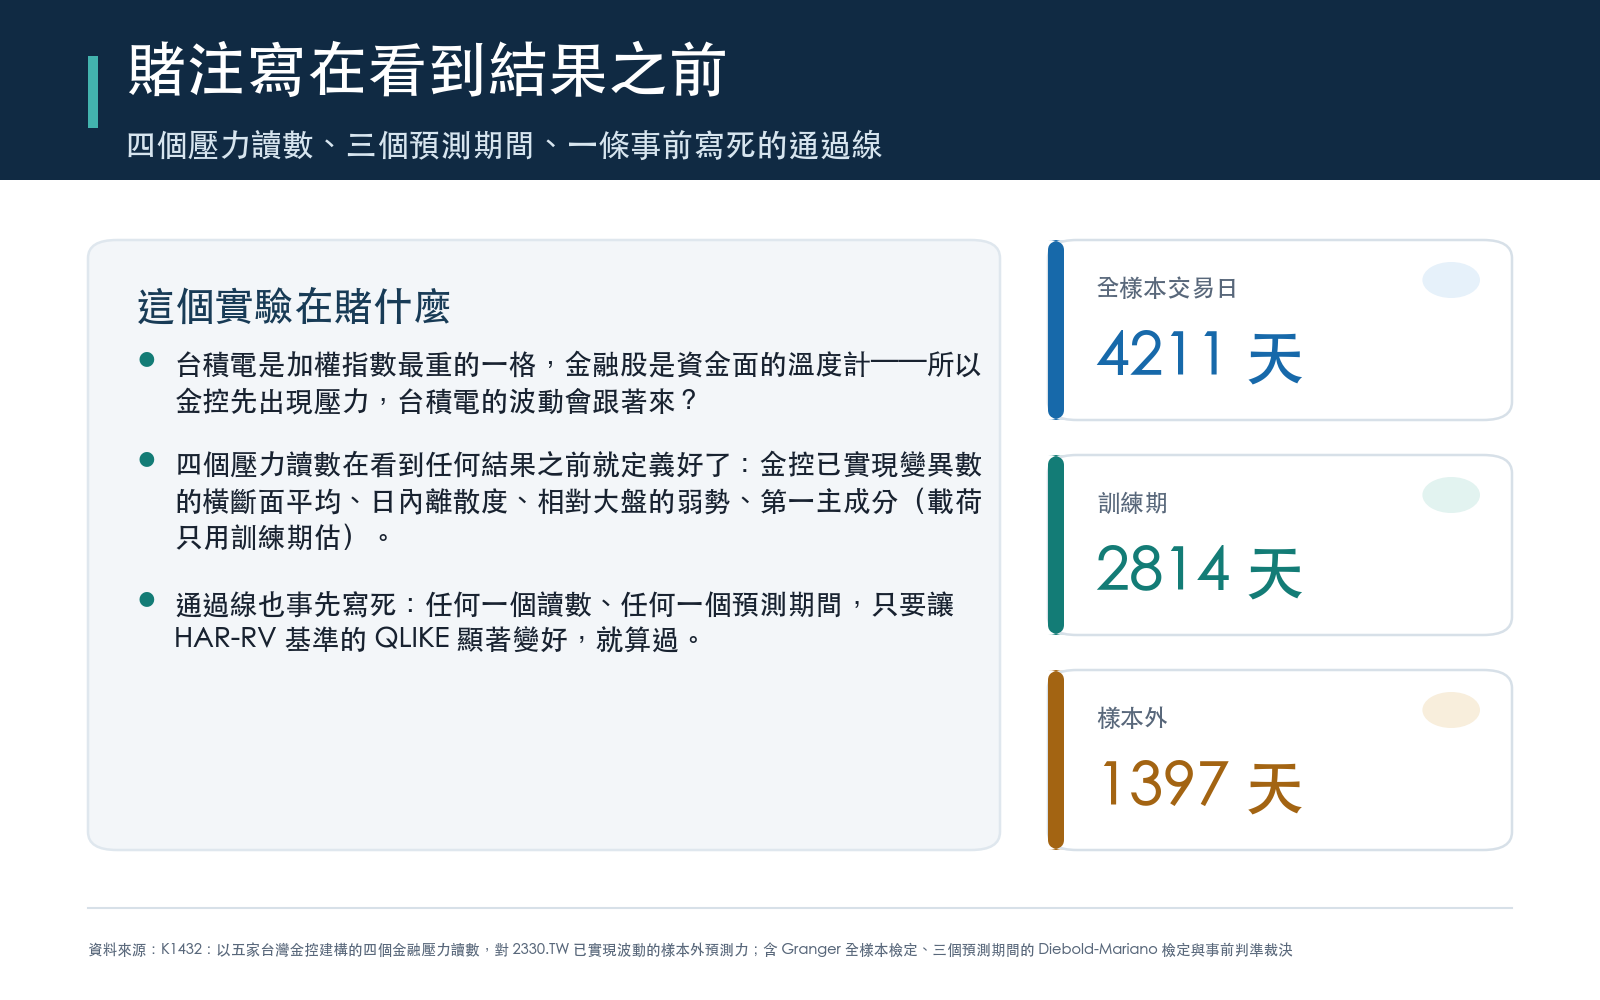
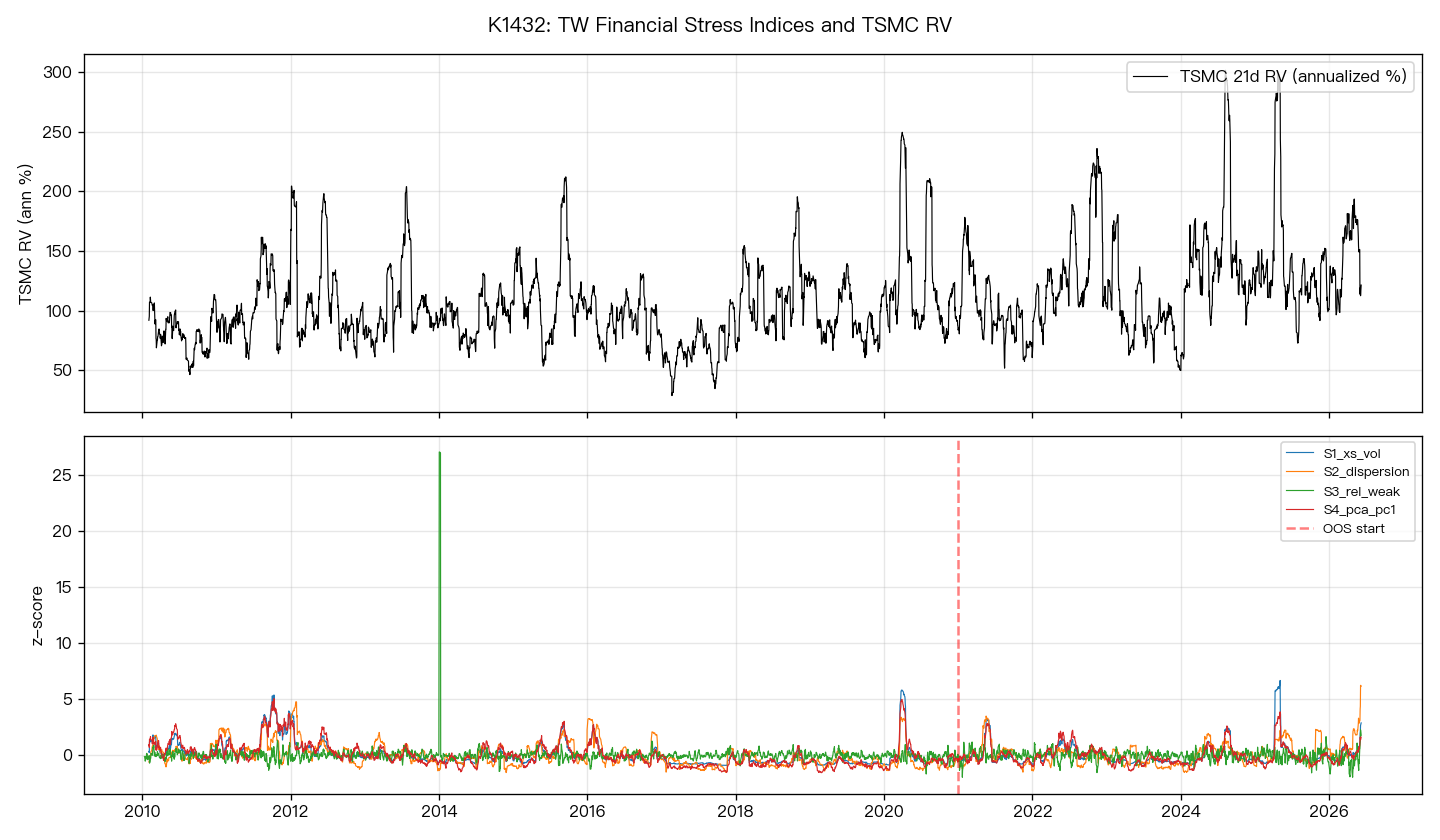
這個想法值得一測,而且測起來不貴。我們用 2010 年到 2026 年 6 月、共 4,211 個交易日的資料,拿富邦、國泰、中信、玉山、華南五家的日報酬,做出四種「金融壓力」讀數,再看它們能不能改善台積電未來波動的預測。
先講結論: 沒有。而且失敗的方式比失敗本身有意思。
先把賭注寫在紙上
這個實驗有一件事是在看到任何結果之前就決定好的,這也是它唯一值得你花時間讀的理由。
四個壓力讀數事先講清楚怎麼算:
| 代號 | 這個讀數在量什麼 |
|---|---|
| S1 | 五家金控二十一日已實現變異數的橫斷面平均 |
| S2 | 日內最高最低價報酬離散度的二十一日滾動標準差 |
| S3 | 金融股平均報酬減掉 0050 報酬的五日滾動平均 |
| S4 | 第一主成分分數絕對值的二十一日滾動值(載荷只用訓練期估) |
判準也事先寫死:以 Corsi 二〇〇九年那個業界標準的波動率模型當基準,四個壓力讀數裡只要有任何一個、在 1 日 / 5 日 / 10 日任何一個預測期間、用比例型誤差這把尺讓預測 顯著變好 ,就算過關。
訓練期是 2010 年到 2020 年底(2,814 天),樣本外是 2021 年起(1,397 天)。樣本外那一段從頭到尾沒有被拿去調任何參數。
事前那一格:零
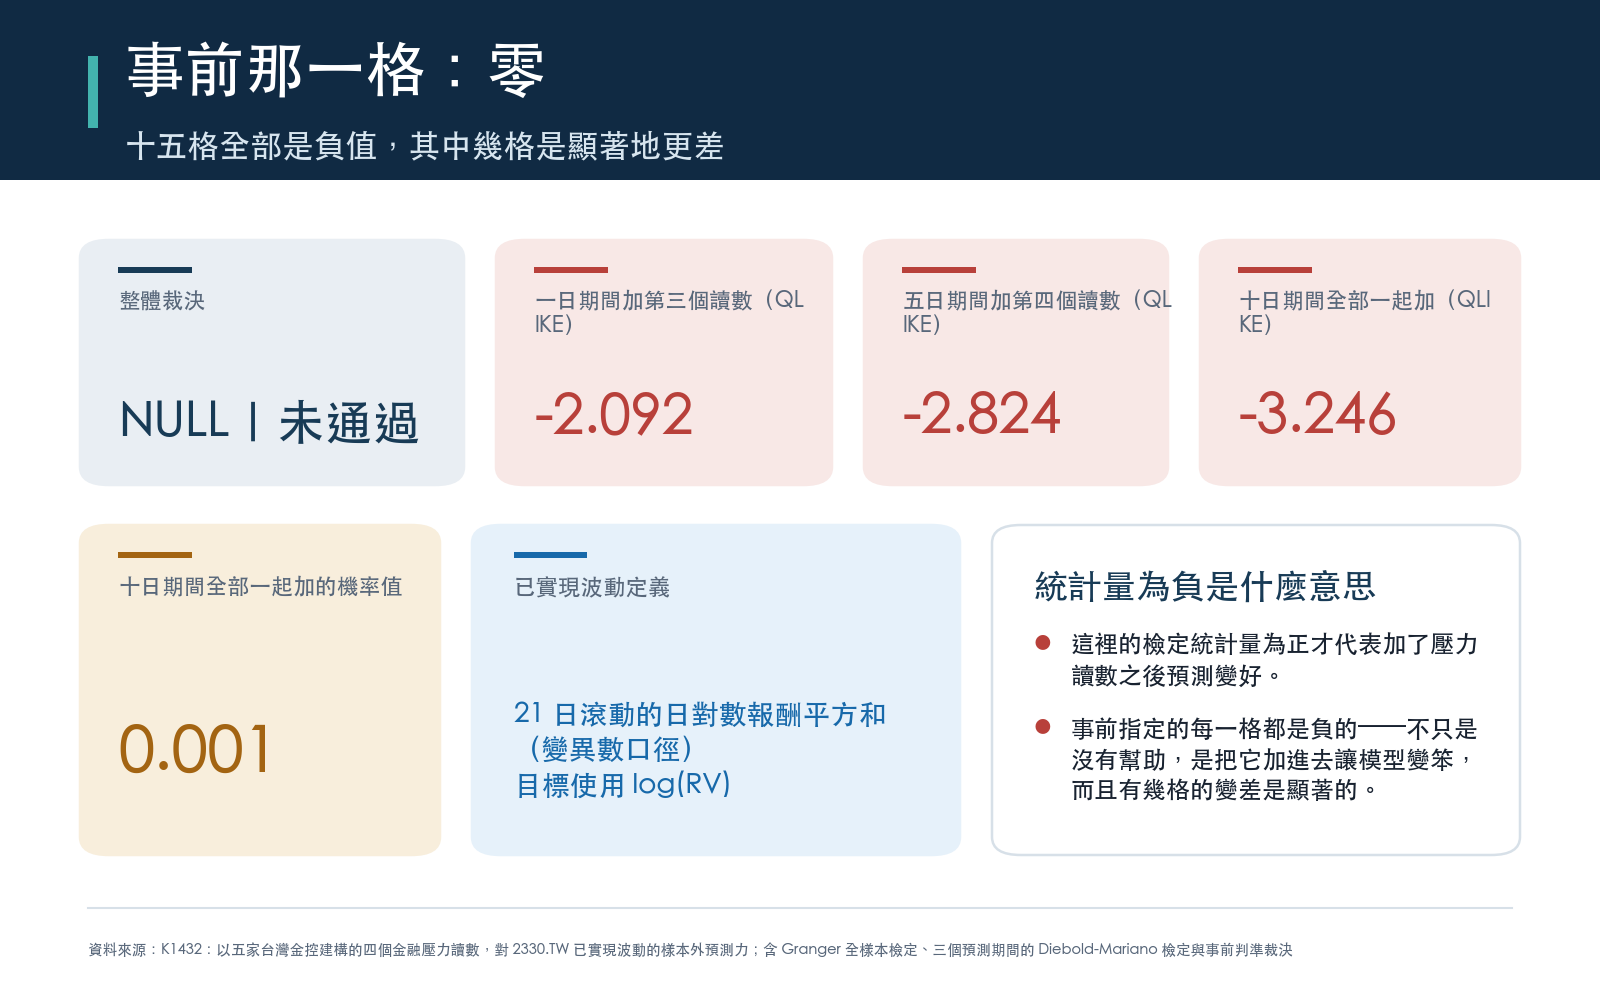
四個讀數、加上「四個一起放進去」這個組合,乘以三個預測期間,事前指定的那十五格,命中數是零。
不只是「不顯著」。 連方向是正的都沒有出現過一次。 十五格全部是負值,也就是把壓力讀數加進去之後,預測反而變差。
其中幾格還是「顯著地變差」:1 日期間加入 S3,比較統計量是 -2.092,機率值 0.0367;5 日期間加入 S4 是 -2.824,機率值 0.0048;10 日期間四個讀數一起加,是 -3.246,機率值 0.0012。
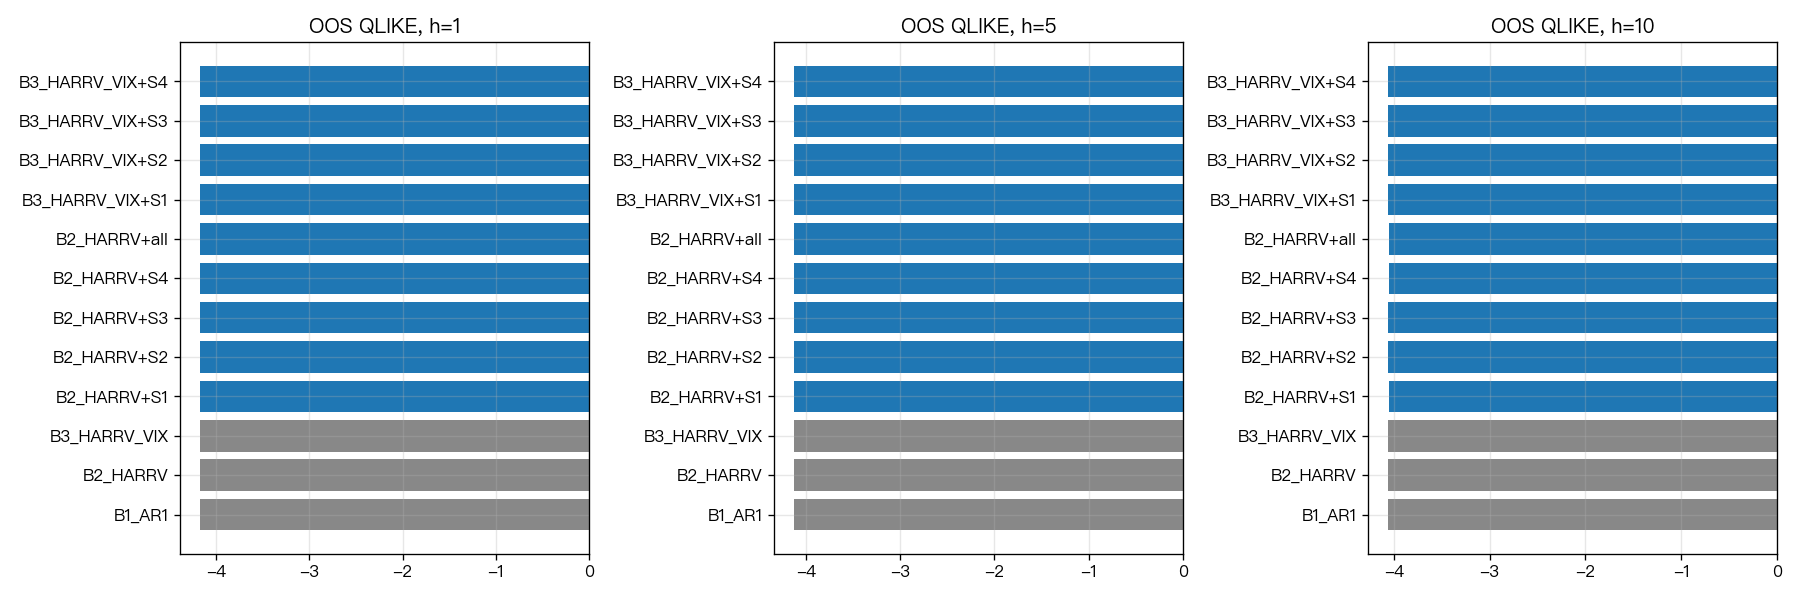
這是一個很乾淨的 NULL。加了資訊,模型變笨。
那另外二十二個「顯著」呢
這裡開始有趣。
整份實驗一共跑了 66 次正式的預測誤差比較(三個預測期間、兩把誤差尺、多組模型配對)。其中 機率值低於 0.05 的有 22 個。
二十二除以六十六,命中率三分之一。如果你只看「有幾個顯著」,這份實驗看起來成果豐碩。
但把方向一起看,故事完全不同:
| 那 22 個顯著在說什麼 | 個數 |
|---|---|
| 加了壓力讀數之後,模型顯著 變差 | 14 |
| 在「基準模型加恐慌指數」這個組合上,壓力讀數顯著 變好 | 5 |
| 單純是「基準模型加恐慌指數」比基準模型好 | 3 |
第三類根本不是壓力讀數的功勞,那只是 VIX 有用而已,這件事早就知道了。
第一類是壓力讀數在扣分。
真正需要小心的是第二類。
事後才看到的那五格
那五格全部來自同一個組合:S4(主成分讀數)加到「基準模型加恐慌指數」這個組合上。三個預測期間、兩把損失尺,一共六格,其中五格顯著:比例型誤差在 1 日是 +2.188、5 日是 +2.730、10 日是 +2.677;平方誤差在 5 日是 +1.964、10 日是 +2.233。唯一沒過的是 1 日的平方誤差,+1.335,機率值 0.1821。
如果我事前寫的判準是「S4 對『基準模型加恐慌指數』有沒有幫助」,這篇文章的標題現在會完全不一樣。
但我事前寫的不是那一個。
這就是預註冊在防的東西。 在一個有 66 格的表格裡,事後挑出一格說「你看這裡有訊號」,跟事前指定一格然後去驗它,是兩種完全不同強度的證據。前者在 66 格裡找到 22 個機率值小於 0.05,本來就是預期之內,單靠隨機,66 個獨立檢定平均也會冒出三到四個假陽性,而這些檢定彼此高度相關(同一組資料、同一批模型),冒出來的只會更多。
所以那五格不是結論,是一個 待驗的假設 。它值得被寫下來、被凍結、然後拿另一段還沒被看過的資料去測。在那之前,它的強度就是「有趣」,不是「成立」。
順帶一提,Granger 檢定過了
還有一個細節值得單獨拿出來講。
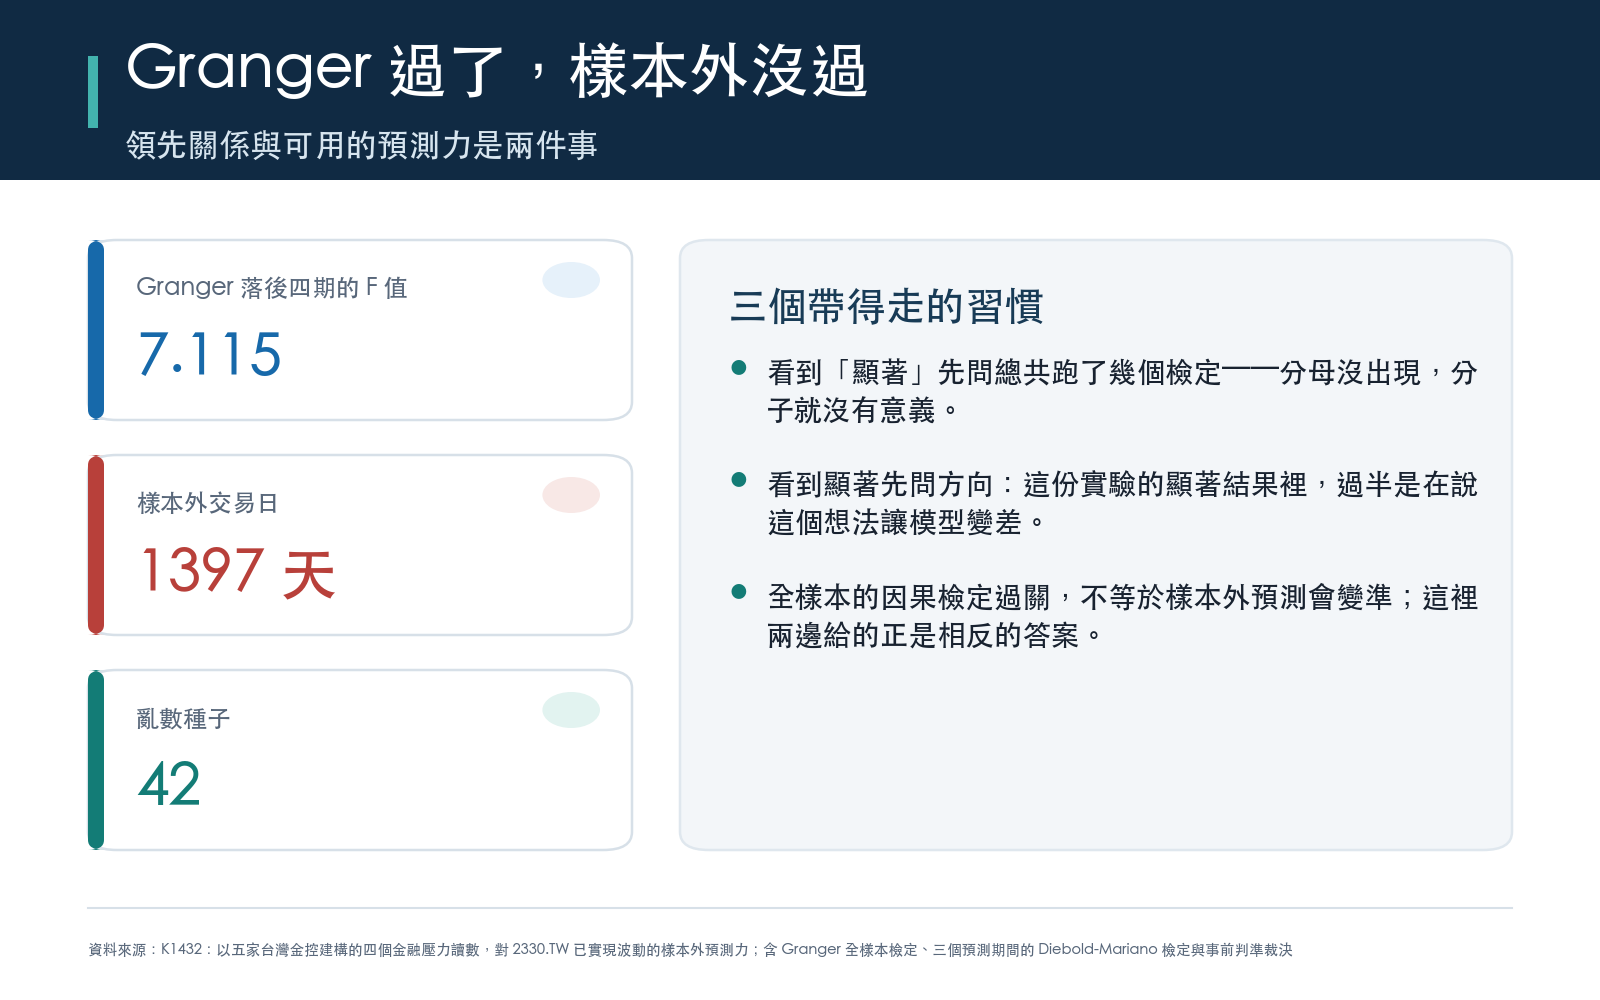
同一份資料做全樣本的 Granger 因果檢定,S1 在落後二到八期全部顯著:落後四期的 F 值是 7.115,機率值是 0.0000105。
一個看到這個數字的人,很容易寫出「金融壓力領先台積電波動,統計上高度顯著」這種句子。
它甚至沒有說錯。錯的是接下來那一步,把它當成「所以拿來預測會更準」。
Granger 檢定問的是「在同一段資料裡,加入過去值能不能減少殘差」,用的是全樣本、而且是樣本內。樣本外的誤差比較問的是「在一段從沒看過的資料上,預測誤差有沒有真的變小」。 這兩個問題可以一個答是、一個答否,而且經常如此。 這份實驗就是一個乾淨的例子:Granger 過了,樣本外的預測全面沒過。
對你的意思
不是「別看金融股」。金融股該看,只是它不是台積電波動的早期警報器,至少在日頻、用這四個讀數、在這 1,397 個樣本外交易日上不是。
比較耐用的是下面三個習慣:
- 看到「顯著」先問總共跑了幾個檢定。 分母沒有出現,分子就沒有意義。
- 看到顯著先問方向。 這份實驗二十二個顯著裡,十四個是在說「你這個想法讓模型變差」。
- 看到樣本內的因果檢定,再問一次樣本外。 領先關係與可用的預測力是兩回事。
那五格 S4 的訊號,我們會照規矩處理:寫成預註冊、凍結、等一段新的資料。有結果再回來講。
資料與方法
標的為 2330.TW,指數對照 0050.TW,恐慌指數代理 ^VIX,金融股為 2881 / 2882 / 2891 / 2884 / 2880.TW,資料源 yfinance。已實現波動定義為日對數報酬平方的二十一日滾動加總(變異數口徑),目標變數取對數。基準模型三個:一階自迴歸、Corsi (2009) 的長記憶波動率模型、以及在它上面加入恐慌指數對數值的版本。訓練期 2010-01-01 至 2020-12-31(2,814 天),樣本外 2021-01-01 至 2026-06-09(1,397 天)。預測誤差比較採用 Diebold 與 Mariano 的標準做法,異質變異穩健的截斷落後設為預測期間減一;兩把誤差尺分別是平方誤差與 Patton (2011) 提出的比例型誤差。亂數種子 42。事前判準與整體裁決(NULL)寫在 experiments/k1432/k1432_tw_financial_stress.py 第 525 至 563 行,結果檔為 experiments/k1432/k1432_tw_financial_stress_results.json。
懶人包圖組