原創新聞多的日子,之後五天波動會比較大嗎?十二格檢定沒有一格站得住
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
市場上有一種直覺:當天的新聞如果多半是原創報導、而不是同一則通訊社稿被幾十個網站轉貼,代表真的有事情在發生,接下來幾天的價格應該更不安分。這個直覺可以直接檢定,而且資料是公開的。
答案是沒有。四檔 ETF、三個波動指標、十二格檢定,最大的一個 t 統計量是 1.36,連未校正的 1.96 都沒碰到。
真正值得花時間的是它旁邊那件事。同一批資料,在三個看起來都說得過去的設定選擇下,可以生出 t = +2.13、p = 0.033 的正向結果。這篇文章要講的就是那三個選擇分別是什麼,以及看到別人的研究說「新聞能預測波動」時,你該先問哪幾個問題。
怎麼量的
新聞端是 GDELT 的美國英文媒體標題,關鍵字 stock market,期間 2024-01-02 到 2026-08-27,共 150,073 篇。併成交易日窗口後有 654 個,每個窗口的新聞篇數中位數是 212 篇。
價格端是 SPY、XLK、XLF、XLE 四檔 ETF。每檔看三個未來五日的指標:已實現波動(rv_fwd5)、下行半變異數(semivar_fwd5_down)、最大單日跳動(jump_fwd5)。四乘三等於十二格。
固定設定:亂數種子 42、HAC 落後 10 期、樣本外切點 2025-09-01。主分析排除了新聞回傳量被資料庫截頂的 115 個窗口(占 17.6%),剩 539 個。
十二格的結果
| 標的 | rv_fwd5 | semivar_fwd5_down | jump_fwd5 |
|---|---|---|---|
| SPY | -0.7761 | -0.6882 | -0.6047 |
| XLK | -1.3645 | +0.1064 | -0.8162 |
| XLF | +0.0462 | -0.1697 | +0.5217 |
| XLE | +0.0523 | +0.1393 | +0.1975 |
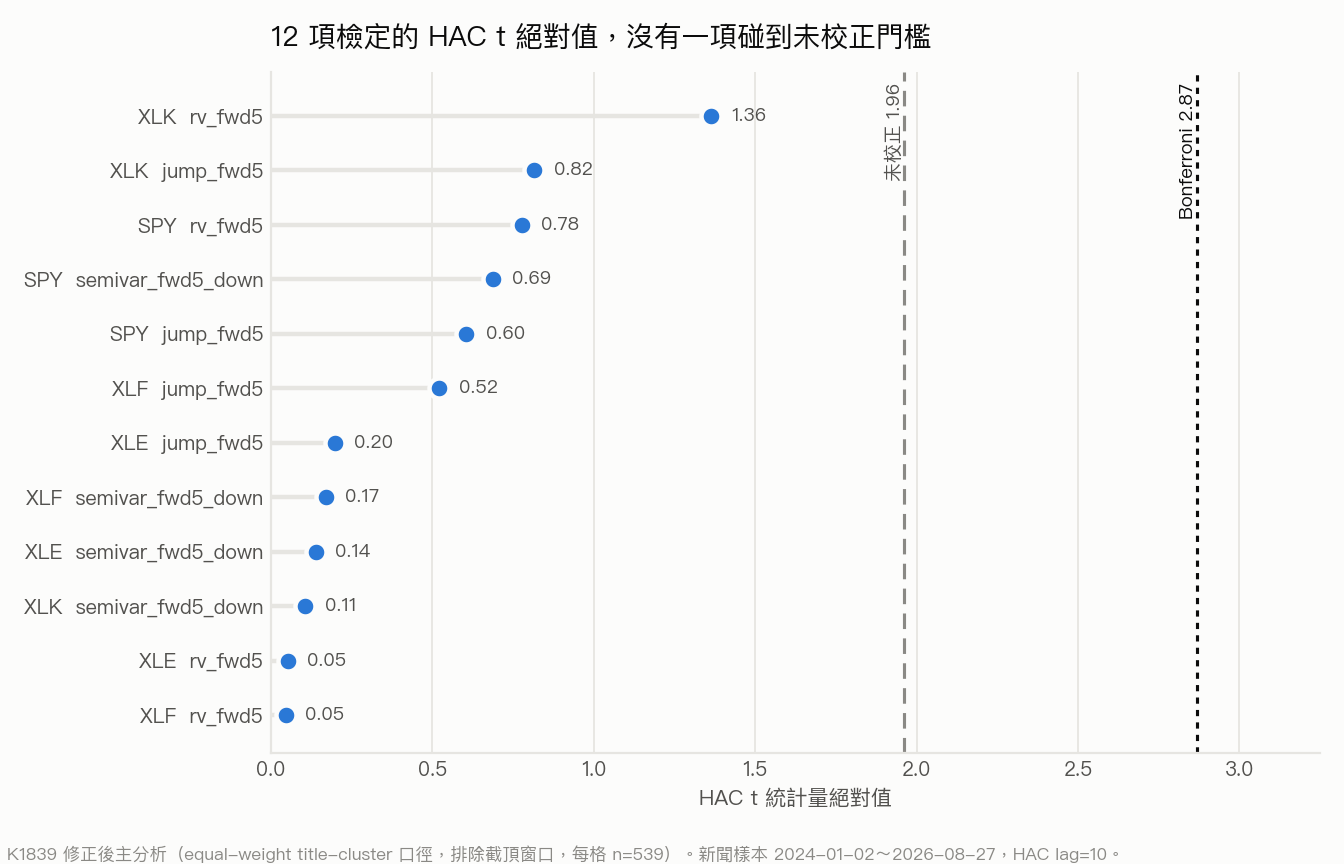
十二項一起檢定,Bonferroni 校正後的門檻是 2.87。最大的 |t| 是 XLK rv_fwd5 的 1.3645。
這個距離的性質要講清楚:多重比較在這裡 沒有 扮演「本來勉強顯著、校正後被刷掉」的角色。整片檢定都在雜訊帶裡,連校正之前就沒有東西可刷。
符號也沒有共識。SPY 三項全負、XLK 兩負一正、XLF 兩正一負、XLE 三項全正。四檔標的說不出同一個方向的故事。
同一批資料,四種答案
現在講那個值錢的部分。下面四條路徑用的是同一份新聞、同一份價格、同一組控制變數,差別只在三個地方:原創比例的分母怎麼定、控制變數要不要落後一天、要不要排除截頂窗口。
| 設定 | n | SPY rv_fwd5 的 HAC t |
|---|---|---|
| 標題分群分母 + 控制變數落後一天、排除截頂(主分析) | 539 | -0.7761 |
| 標題分群分母 + 控制變數落後一天、全樣本 | 654 | -0.4466 |
| 文章列數分母 + 控制變數落後一天、全樣本 | 653 | +1.7124 |
| 文章列數分母 + 控制變數不落後、全樣本 | 653 | +2.1336 |
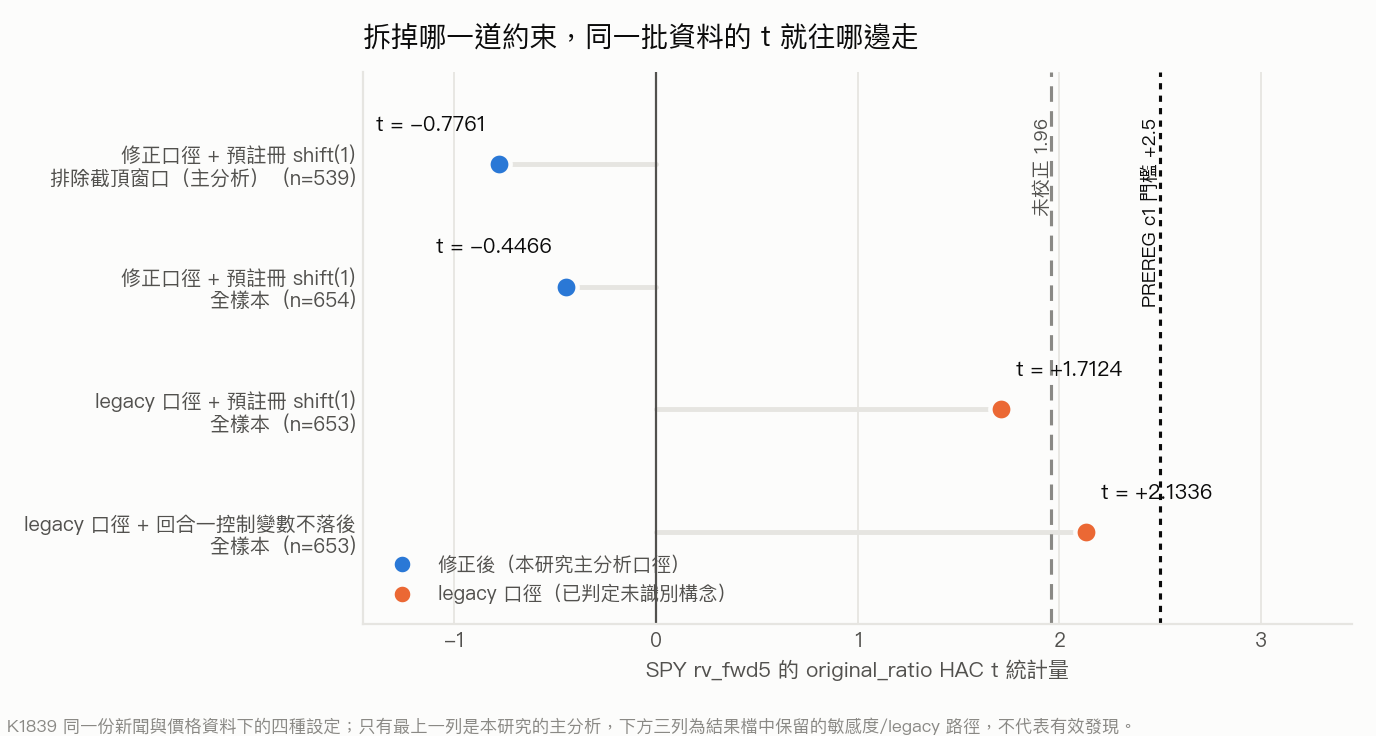
最後一列的 HAC p 值是 0.0329。同一格設定下的 jump_fwd5 是 t = +1.9188、p = 0.0550,樣本外增量 R² 為 +0.0211。
把最後一列單獨拿出來寫,它長得完全像一篇可以投出去的短文:正向係數、五個百分點以內顯著、樣本外增量為正、一個現成的故事,原創報導多的日子,之後五天波動較大。
三個選擇沒有一個涉及造假,三個都可以寫出一段聽起來合理的辯護。而且 三個缺一不可 :同樣是文章列數分母加控制變數不落後,只要把 115 個截頂窗口排掉,t 就掉到 +1.4044、p 是 0.1602,連未校正的門檻都沒過。撐住那個 +2.1336 的,有一部分是那批被資料庫回傳量截頂的窗口。
那三個選擇為什麼是選擇
第一個:分母。 「原創比例」如果用文章列數當分母,一則通訊社稿被四十個網站轉貼,就在分母裡算四十次。改成用標題分群等權,同一組標題無論被轉貼幾次都只算一票,數字的性質整個變了:
| 診斷 | 文章列數分母 | 標題分群分母 |
|---|---|---|
| 與 log(新聞量) 的相關係數 | -0.5557 | -0.3073 |
| 控制變數對原創比例的 R² | 0.2675 | 0.1119 |
| SPY rv_fwd5 的係數 | +0.2736 | -0.5792 |
| 同上的 HAC t | +1.0717 | -0.7761 |
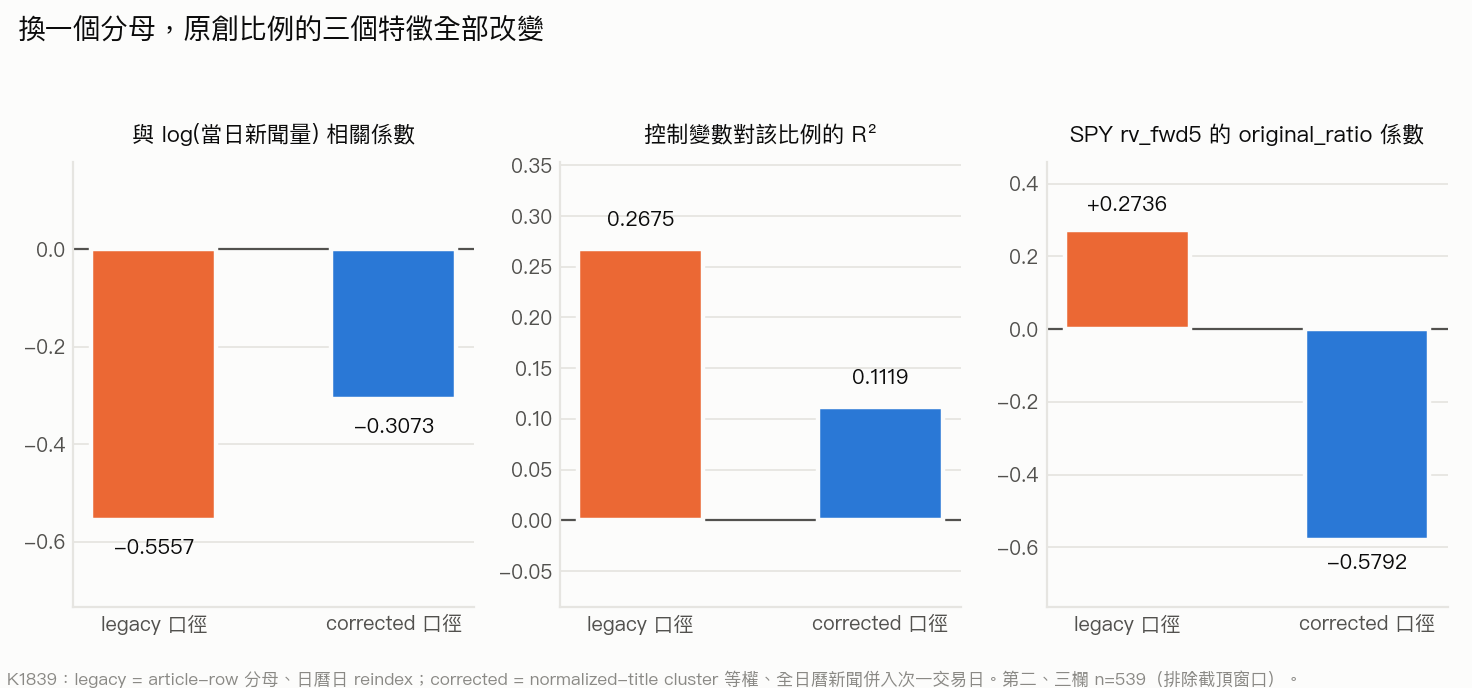
文章列數分母的版本,有超過四分之一的變異可以被控制變數本身解釋掉。也就是說這個「原創比例」有相當一部分只是新聞量的鏡像;再拿它去解釋波動,等於用新聞量解釋了一次波動。換成標題分群後降到 0.1119,VIF 是 1.126,剩下 0.8881 的變異沒有被控制變數吃掉。
第二個:控制變數落不落後一天。 不落後,等於讓模型看到當天才知道的資訊。這是最容易被忽略、也最容易讓 t 變好看的一種洩漏。
第三個:截頂窗口留不留。 GDELT 對單次查詢的回傳量有上限,115 個最熱鬧的日子撞到了那個上限,它們的「新聞總量」其實是被截斷的數字。留著它們,等於把量測誤差最大的那批日子也算進去。
反過來說,排除截頂窗口這個動作本身也該被質疑成挑樣本。所以要看全樣本的版本:n=654 的十二項 HAC t 全部落在 -1.0509 到 +0.2011 之間,比排除截頂後 更 靠近零。結論不依賴這個選擇,往哪個方向調都不會把任何一項推過門檻。
樣本外那個「大於零」有多大
樣本外切在 2025-09-01。因為目標變數是未來五日的量,訓練期尾端的樣本會把觀測窗延伸進樣本外區間,所以加了排除規則:目標視窗的結束日必須早於預測起點。訓練樣本從 333 降到 328,刪掉 5 個,樣本外 206 個。
三條事前判準裡只有一條成立:SPY 的樣本外增量 R² 大於零,實際值是 0.000986。
0.000986 算不算一回事,要看同一欄位在別的格子有多大的離散度。同樣是十二格的樣本外增量 R²:XLE rv_fwd5 是 -0.0713、XLF semivar 是 -0.0117、XLK jump 是 -0.0095,十二格裡最大的正值是 XLF jump 的 +0.0049。SPY 的 +0.000986 在這個量尺上與零沒有分別。
這個結果不能拿來說什麼
它 不能 說原創新聞對波動沒有影響。兩個限制最要緊:標題分群是文字分組,不是語意事件分組,它抓得到「同一篇稿被轉貼」,抓不到「兩篇不同的稿在講同一件事」;而排除截頂窗口之後,估計的對象已經變成「新聞量較低的狀態」,最熱鬧的日子不在主結果裡。
它能說的是:在這個期間、這四檔標的、這個量法之下,沒有可偵測的訊號。
讀到「新聞能預測市場」的研究時,先問三個問題
這十二格檢定對一般投資人的用處,不在那個 NULL,而在那張階梯表。任何一篇宣稱新聞情緒、新聞量或新聞原創性能預測價格的研究,你可以問:
第一,比例型指標的分母是什麼? 轉貼一次算一次,還是同一則事件算一票?這一個選擇就足以讓係數翻號。
第二,解釋變數和控制變數是不是同一天的? 只要控制變數沒有落後,模型就看得到當天才成立的資訊。
第三,資料來源有沒有回傳上限,撞到上限的那些日子還在樣本裡嗎? 這篇裡撐住 +2.13 的,正是那 115 個被截頂的窗口。
三個問題都問完,一個宣稱才值得你花時間看它的結論。
資料來源 :實驗 K1839(experiments/k1839/k1839_results.json)。新聞為 GDELT 美國英文媒體標題,2024-01-02 至 2026-08-27,150,073 篇、654 個交易日窗口;價格為 SPY / XLK / XLF / XLE 與 VIX。科學裁決為 NULL,方法審查(獨立第二驗證)verdict 為 PASS,兩者是不同的欄位:前者說結論沒站住,後者說方法與可複製性通過。全文數字皆對應結果檔的具名欄位。