Expectile 風險測度在債券 ETF 的 VaR backtest:八次配對比較,四次贏在小數點後第七位
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
Expectile 這幾年在風險測度文獻裡的位置不低。它用 asymmetric least squares 估計,在特定條件下同時具備 coherent 與 elicitable 兩個性質,而 quantile 只有後者。Bellini 等人 2014 年把它放進 generalized quantiles 的框架,Fissler 與 Ziegel 2016 年給了 elicitability 的 backtesting 脈絡,Basel III 往 IV 的討論裡也出現過「用 expectile 取代 Expected Shortfall」的提案。理論上的吸引力很清楚。
理論吸引力不等於樣本外表現。K1649 問的是一個可以檢定的窄問題:在 TLT 與 HYG 的日報酬 VaR backtest 中,expectile-VaR 或 CARE 能不能在樣本外 pinball loss 與校準上,穩健地打敗傳統的 quantile-VaR baseline。
答案是不能。實驗的 verdict 欄位逐字是 NULL_NO_EXPECTILE_EDGE_VS_LINEARQR。
這個實驗怎麼設計
四個模型放在同一張桌子上比:HS250(250 天歷史模擬)、LinearQR(線性分位數迴歸)、ALSExpectile-VaR(asymmetric least squares expectile)、CARE-SAV(conditional autoregressive expectile,SAV 型)。前兩個是 baseline,後兩個是被檢定的對象。
資料是 Yahoo Finance 的調整後收盤價,樣本 2010-01-04 至 2026-07-02,樣本外評估從 2015-01-01 起算,每個「資產 × 信心水準」格子有 2891 個共同觀測值。兩個資產(TLT、HYG)乘兩個信心水準(5%、1%)等於四個格子。共變數有七個:rv5、abs_ret1、neg_ret1、ief_mom5、lqd_mom5、credit_chg5、vix。模型每季用擴張窗重估一次,seed 固定 42。
Lookahead 的處理寫在 meta.lookahead_policy 裡,逐字是 features use signal = features.shift(1); HS uses y.shift(1); model refits use df[df.index < ts]。三個地方各自 lag:特徵 shift 一期、歷史模擬用前一日的報酬、重估只看嚴格早於當前時點的資料。
expectile 有一個 quantile 沒有的自由度:它的 tau 參數與目標的 alpha 不是同一個東西,需要對應。這裡的做法記在 meta.tau_mapping:每次重估前,用樣本內的無條件 expectile tau 去匹配目標違約率。實際落在 0.015,四個格子的 tau_summary.unique_values 都只有這一個值。
為什麼 tau 對應是這個實驗的關鍵設計
quantile 與 expectile 的差別在損失函數。quantile 迴歸最小化的是 pinball loss,對殘差的正負兩側給不同權重但都取絕對值;expectile 迴歸最小化的是 asymmetric least squares,兩側都取平方。平方的後果是 expectile 對尾端觀測值更敏感,這正是它被認為具有 coherence 的原因,也是它與 alpha 不能直接對應的原因。
實務上這造成一個額外的自由度。要用 expectile 做 5% 的 VaR,得先決定「哪一個 tau 的 expectile 對應到 5% 的 quantile」,而這個對應本身依賴分佈形狀,換一個資產、換一段期間就會變。K1649 的做法是每次重估前用樣本內無條件 expectile 去匹配目標違約率,實際落在 tau = 0.015。四個格子的 tau_summary 顯示這個值在整段樣本外期間沒有變動過,最小值、中位數、最大值都是 0.015。
這個設計選擇要標出來,因為它同時是這份 null 的一個邊界。如果 tau 用別的方式對應(例如逐期重新校準、或用條件分佈而非無條件分佈),結果可能不同。本文檢定的是這一種對應方式下的 expectile,不是所有可能的 expectile 實作。
主結果:四比八,不是四比四
overall 區塊只有兩個數字要看,而且必須一起看。
第一個是 overall.expectile_cases_better_than_linearqr_by_mean_loss = 4。第二個是 overall.expectile_harvey_wins_vs_linearqr = 0。
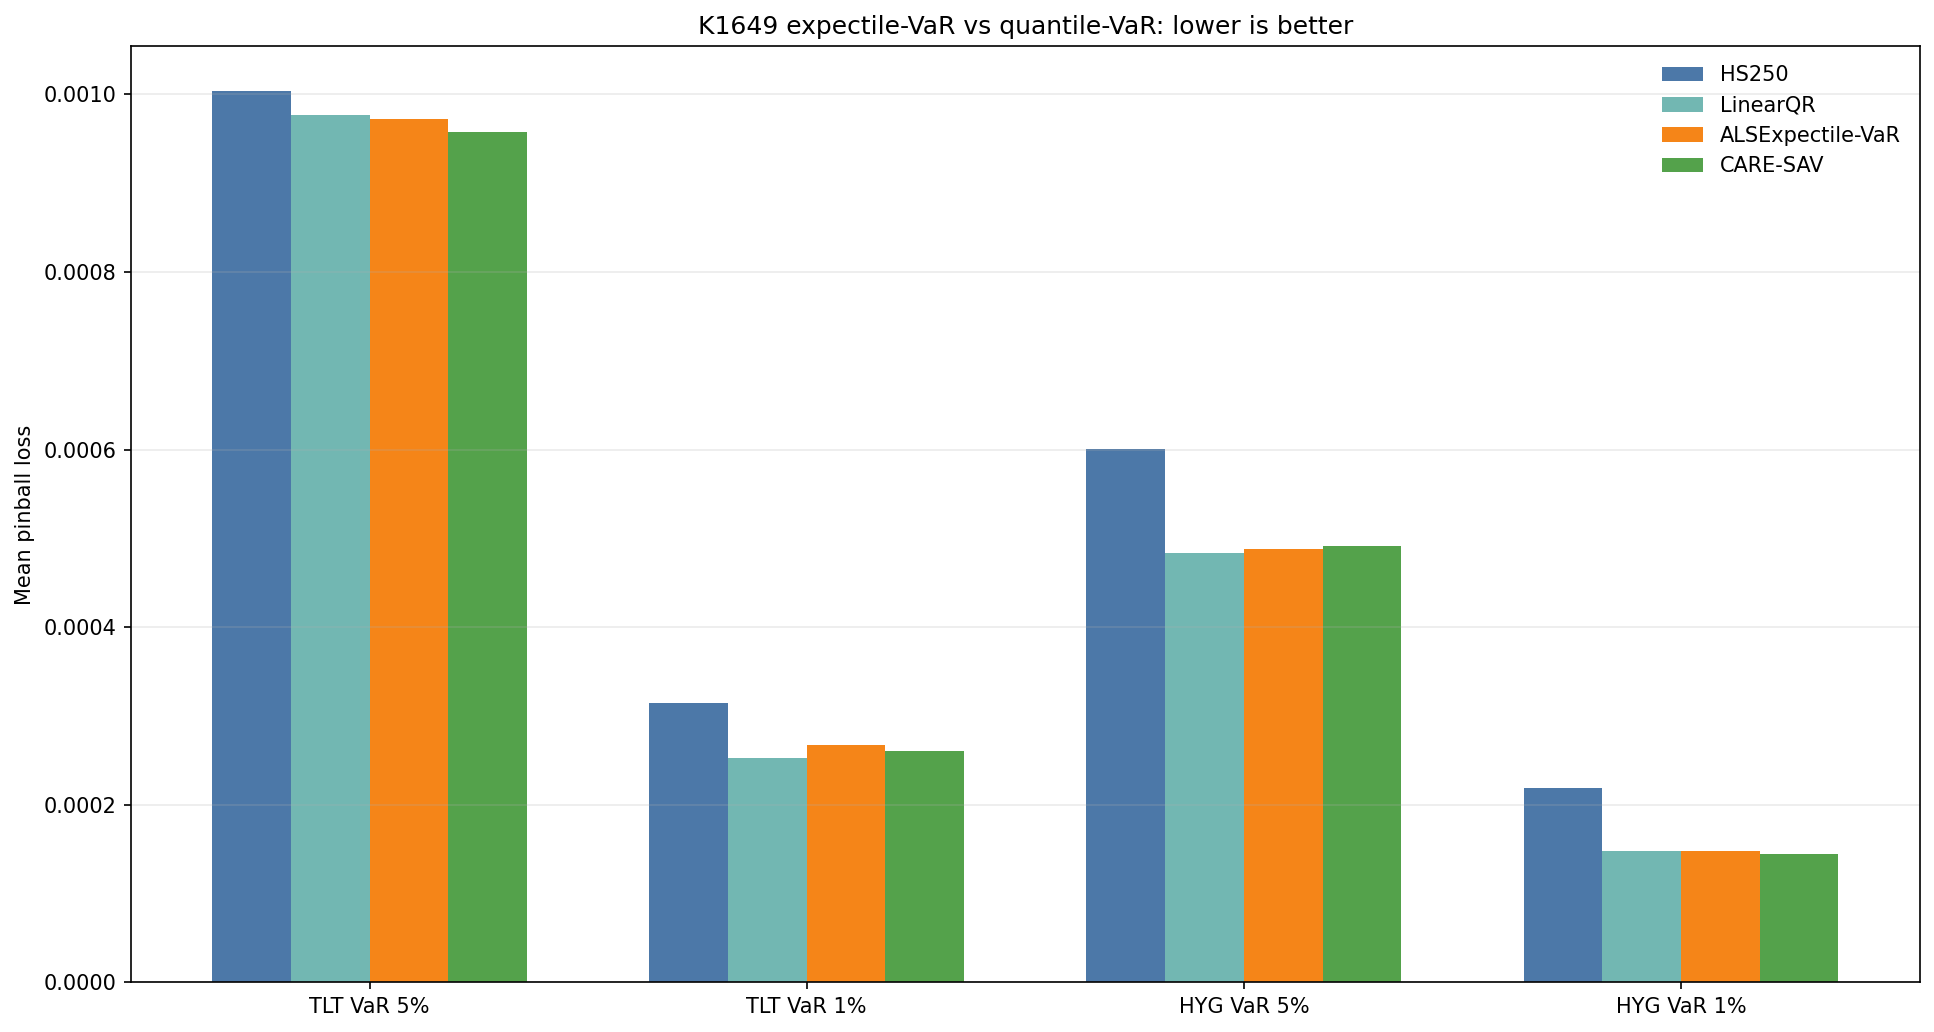
第一個數字的分母是八,不是四。四個格子各有兩個 expectile 模型(ALS 與 CARE)去對上 LinearQR,所以配對數是八。八次配對裡有四次的樣本外平均 pinball loss 比 LinearQR 低。逐格看:
| 格子 | LinearQR | ALSExpectile-VaR | CARE-SAV | HS250 | 該格最低 |
|---|---|---|---|---|---|
| TLT 5% | 0.00097741 | 0.00097266 | 0.00095796 | 0.00100381 | CARE-SAV |
| TLT 1% | 0.00025326 | 0.00026728 | 0.00026103 | 0.00031485 | LinearQR |
| HYG 5% | 0.00048402 | 0.00048835 | 0.00049096 | 0.00060086 | LinearQR |
| HYG 1% | 0.00014791 | 0.00014744 | 0.00014428 | 0.00021935 | CARE-SAV |
TLT 5% 兩個 expectile 模型都比 LinearQR 低,HYG 1% 也是兩個都低,合計四次;TLT 1% 與 HYG 5% 則是六個 expectile 讀數全部高於 LinearQR。overall.best_mean_pinball_counts 記的是 {"CARE-SAV": 2, "LinearQR": 2},四個格子的冠軍二比二平分。
這裡有一個已經發生過的誤讀值得寫出來。知識庫條目 968b552d 曾經把「四次配對較優」寫成「四個格子全部較優」,也就是把 4/8 說成 4/4。同一個數字,換一個分母,結論從「一半一半」變成「全面勝出」。引用 expectile_cases_better_than_linearqr_by_mean_loss 時必須同時引 expectile_harvey_wins_vs_linearqr,兩個放在一起才是完整的讀數。
第二個數字:贏的幅度過不了顯著性門檻
expectile_harvey_wins_vs_linearqr = 0 說的是:八次配對裡,沒有任何一次的 Diebold-Mariano 統計量通過 Harvey 門檻。這個門檻寫在 overall.harvey_abs_t_threshold,值是 3.0。
逐格的 DM t 值(對 LinearQR,Newey-West lag 21):
| 格子 | ALS vs LinearQR | CARE vs LinearQR |
|---|---|---|
| TLT 5% | −0.865 | −1.485 |
| TLT 1% | +1.911 | +1.111 |
| HYG 5% | +0.539 | +0.858 |
| HYG 1% | −0.097 | −0.436 |
絕對值最大的是 TLT 1% 的 ALS,1.911,離 3.0 還有距離,而且它的符號方向代表 LinearQR 較優。TLT 5% 的 CARE 那格 dbar 是 −0.0000195、se 是 0.0000131,t 值 −1.485,p 值 0.138。把小數點後第七位的差距放進檢定,得到的就是這種讀數。
換句話說:四次「較優」的幅度,統計上與零沒有分別。
校準面:兩個 baseline 的差別比 expectile 的差別大
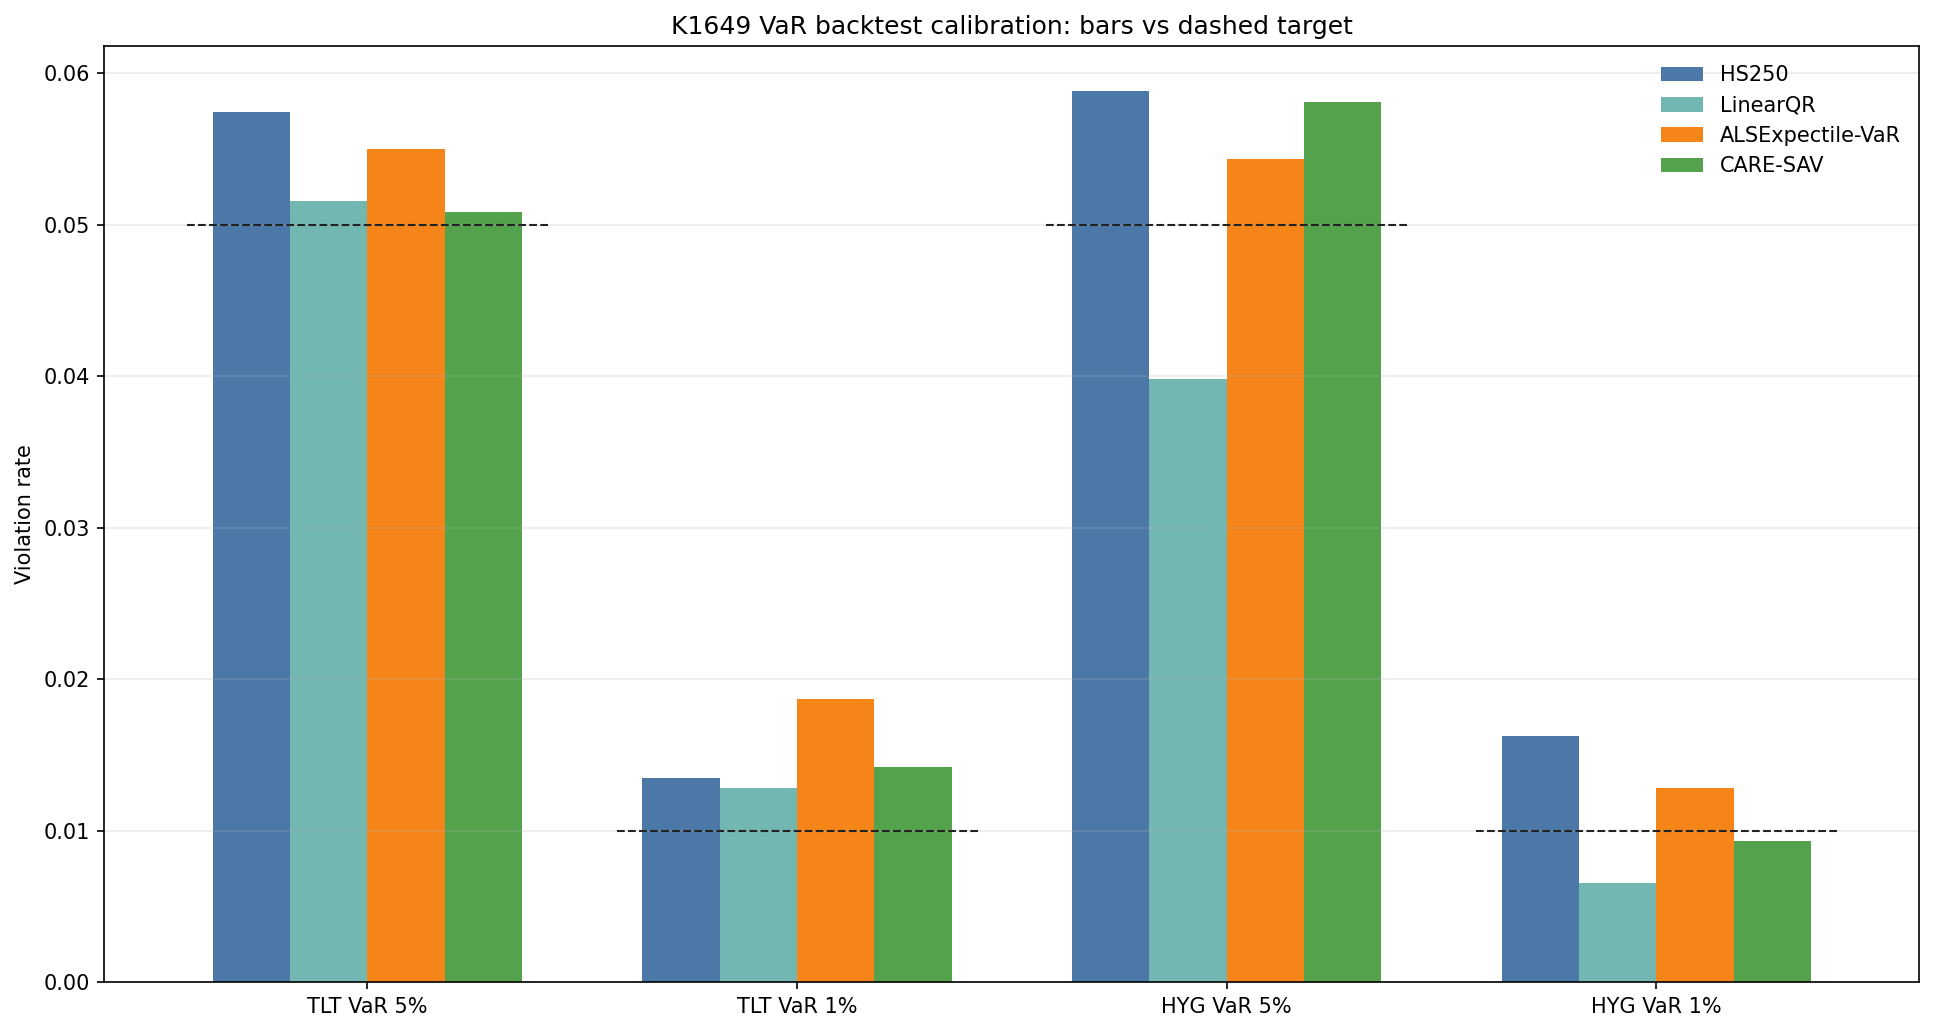
pinball loss 之外,實驗也跑了 Kupiec 無條件覆蓋與 Christoffersen 獨立性檢定。以 TLT 5% 為例:
| 模型 | 違約率 | Kupiec p | Christoffersen p |
|---|---|---|---|
| HS250 | 5.742% | 0.073 | 0.041 |
| LinearQR | 5.154% | 0.705 | 0.063 |
| ALSExpectile-VaR | 5.500% | 0.225 | 0.153 |
| CARE-SAV | 5.085% | 0.835 | 0.557 |
CARE-SAV 在這一格的校準確實最好,Kupiec p 值 0.835、違約率 5.085% 貼著設定的 5%。但真正大的落差在 HS250 與其他三個之間:HS250 的 Christoffersen p 值 0.041,在 5% 水準下拒絕違約獨立性,也就是它的違約有叢聚。條件式模型(無論 quantile 還是 expectile)都沒有這個問題。
這個對照的意思是:把歷史模擬換成條件式模型有明確價值,而在條件式模型內部再從 quantile 換到 expectile,價值看不出來。
5% 與 1% 的行為不一樣
把四個格子拆成兩組看,會發現 expectile 的表現與信心水準有關,只是方向不一致。
5% 那兩格:TLT 上兩個 expectile 模型都贏 LinearQR,HYG 上兩個都輸。1% 那兩格:TLT 上兩個都輸,HYG 上兩個都贏。也就是說,勝負跟著資產與信心水準的組合跑,沒有形成「expectile 在尾端更好」或「expectile 在中段更好」這類可以外推的規律。
這一點對讀者比總分四比八更重要。如果四次勝出集中在同一個信心水準或同一個資產,那還可以說「在某某條件下 expectile 有優勢」,是一個可以繼續追的線索。實際的分佈是對角線形狀,兩個資產各贏一個信心水準,看起來更接近抽樣噪音的樣子。八次配對的 DM t 值全部落在 −1.49 到 +1.91 之間,也支持同一個讀法。
這個 null 的適用範圍
這個 null 的適用範圍很窄。它說的是:在 TLT 與 HYG 的日頻、2015 年起的樣本外、七個共變數、每季擴張窗重估、Harvey 門檻 3.0 這一組設定下,expectile 相對線性分位數迴歸沒有可辨識的優勢。它沒有檢定日內頻率、沒有檢定其他資產類別、沒有檢定其他 tau 對應方式,也沒有處理 expectile 在極端尾部(alpha 遠小於 1%)的行為。八次配對是小樣本,統計檢定的效力有限,「沒有偵測到優勢」與「不存在優勢」是兩件事。
什麼樣的後續會改變這個答案
這份 null 指出三個值得追的方向,而且每一個都能寫成可檢定的問題。
第一個是 tau 對應。目前用無條件樣本內匹配,得到一個固定的 0.015。改成條件式匹配(讓 tau 隨波動狀態移動)會不會讓 expectile 的理論優勢顯現出來,是一個獨立的實驗。
第二個是評估指標。pinball loss 是 quantile 的嚴格一致評分函數,用它來評 expectile 對 expectile 並不公平;Fissler 與 Ziegel 的框架提供了另一組評分函數。換一把尺量同一批預測,四比八會不會變,值得單獨檢定。
第三個是資產類別。TLT 與 HYG 都是債券 ETF,尾部行為與股票、商品不同。若 expectile 的優勢真的來自對尾端觀測值的平方權重,那在尾部更厚的資產上應該更明顯,這是一個有方向性的預測,可以直接測。
對實務的一個推論
如果目標是把 VaR 模型換得更好,這份證據指向的順序是:先確認你用的不是無條件歷史模擬,再考慮條件式設定裡的細節。HS250 到 LinearQR 的 pinball loss 改善,在 HYG 5% 那一格是從 0.00060086 降到 0.00048402,幅度約 19%;LinearQR 到 CARE-SAV 的改善在最好的一格(TLT 5%)是從 0.00097741 到 0.00095796,幅度約 2%,而且過不了顯著性檢定。
理論性質(coherence、elicitability)是選擇風險測度的正當理由,本文沒有反駁它。本文只報告一件事:在這組設定下,那些性質沒有轉換成可測量的樣本外優勢。
延伸閱讀:同一顆實驗的讀者版
這顆實驗先前已有一篇面向一般讀者的文章:把風險尺度換成 expectile,能更準抓到債券的尾部風險嗎?。那一篇回答的是「這個說法成不成立」,本篇回答的是「這個實驗到底量了什麼、量到哪裡為止」。兩篇引用同一份 K1649 的結果檔,數字相同不是重複發布,是同一個量測的兩個深度;若兩篇的數字有出入,以結果檔為準。
實驗 :K1649| 資料 :Yahoo Finance 調整後收盤,2010-01-04 至 2026-07-02,樣本外自 2015-01-01,每格 2891 個觀測| seed :42| verdict :NULL_NO_EXPECTILE_EDGE_VS_LINEARQR| 數字來源 :experiments/K1649/K1649_results.json(逐一對應的 metric key 見同目錄 PROVENANCE.md)