IPO 市場一冷,股市就要震盪?2,144 天實測後,這條線索的天花板是 0.76%
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
財經評論有一套講法:新股掛牌破發、熱門案子不再開高,代表市場的風險胃納正在收縮,接下來波動就要來了。這個說法在敘事上很順,而且它有一個好處——IPO 市場的冷熱是看得見的,不像「情緒」那樣要靠問卷。
所以它值得被測一次。K1750 把它寫成一個可以被否證的句子:
用 Renaissance IPO ETF 相對 SPY 的走勢做出來的「IPO 降溫訊號」,在一個 已經控制了前一日 VIX 的 HAR 模型之上,能不能為次日的 SPY 變異數帶來 具體有意義 的預測改善?
答案是不能。但光是「不能」還不夠。這篇文章真正想寫的是 這個「不能」有多緊 ——我們排除掉了多大的效應,還留下多大的空間。一個沒有邊界的 null 只是聳肩;有邊界的 null 才是知識。
為什麼一開始就把 VIX 放進基準
這件事必須先講,因為它決定了整個實驗的難度等級。
平台自己的紀錄裡已經有兩次類似的失敗。K531 測過 FRED 的一整排情緒與不確定性指標(經濟政策不確定性指數、密西根消費者信心、TED spread、高收益債利差),K872 單獨測過高收益債的 OAS。兩次的形狀一樣:這些變數對波動率的 原始相關 都不小,但一旦把 VIX 放進同一條迴歸,增量就消失了。
這是波動率預測裡一個反覆出現的結構:VIX 已經是市場對未來波動的定價,很多宏觀與情緒變數想告訴你的事,VIX 早就先說了一次。所以任何新訊號的正確考題只有一句: 它知道什麼是 VIX 不知道的? 光有相關性沒有用。
K1750 因此把三個模型的角色寫死在預先註冊裡:
| 模型 | 規格 | 角色 |
|---|---|---|
B0 | 對數 HAR:日 / 週 / 月的落後對數變異數 | 只作診斷 |
B1 | B0 + 前一日 VIX(轉成日變異數再取對數) | 唯一的結論基準 |
A | B1 + IPO 降溫訊號 | 候選模型 |
B0 存在的唯一理由是讓讀者看到 VIX 本身有多強:加上 VIX 之後,平均 QLIKE 從 0.3794 掉到 0.3357,改善 11.5%。這不是個小數字,它同時說明了為什麼拿 B0 當基準會很容易「做出成果」,那個成果會是 VIX 的,不是新訊號的。
訊號怎麼做,以及那個 .shift(1)
IPO 降溫訊號的原料是一條相對強弱線:Rt=log(IPO ETF 調整後收盤)−log(SPY 調整後收盤)。IPO ETF 追蹤的是近期新掛牌的美國公司,所以這條線在講「新股這一籃相對大盤是強還是弱」。
從它做出兩個成分:
- c1=−(Rt−Rt−21):過去 21 個交易日的相對變化取負號,新股相對走弱越多,訊號越高。
c2 = 過去 252 日 R 的最高點 − R_t:從一年高點回落的幅度。
兩者各自用 擴張式因果標準化 處理:每一天只用該日或更早的觀測算平均與標準差,最少 30 筆(這個 30 寫在 preregistration.json 裡,理由也一併寫了,它是唯一能同時滿足「OOS 從 2018-01-02 起」與「至少 756 筆訓練列」兩個約束的最寬鬆整數,改成 60 只剩 748 筆就不可行了)。標準化後合成,然後 .shift(1)。這個 .shift(1) 明寫在 K1750.py::build_signal 裡,不是靠註解宣稱。
預測窗是擴張窗、H = 1、第一個目標日 2018-01-02、訓練列至少 756 筆。整份帳有 2,144 列,2018-01-02 到 2026-07-15,零列被排除。
前瞻偏誤的檢查不是一句「我們有注意」。實驗把它做成八道機械閘門逐列驗:特徵來源日必須早於目標起始日(2,144 列,0 違反)、訓練資料的最晚目標結束日必須早於預測原點(0 違反)、預測原點必須是前一個交易日(0 違反)、三個模型必須共用同一組目標與原點(identical_targets 與 identical_origins 皆為真)、所有預測值必須為正(6,432 次檢查,0 違反)。第一個原點實際拿到 778 筆訓練列,而候選是 779 筆,那少掉的一筆就是被嚴格禁區規則擋掉的。
結果:訊號讓預測變差了一點點
| 量 | 值 |
|---|---|
平均 QLIKE B0 | 0.3794 |
平均 QLIKE B1(基準) | 0.3357 |
平均 QLIKE A(加訊號) | 0.3361 |
| delta QLIKE = A − B1 | +0.000425 |
| 改善率 | −0.1267% (A 更差) |
| 預測窗列數 | 2,144 |
加上 IPO 訊號之後,預測稍微變差。這個方向本身不意外——A 嚴格嵌套 B1,多一個係數就多一份估計噪音,訊號要贏得先把這份噪音賺回來。
關鍵在於怎麼判斷「+0.000425」算不算證據。因為模型是嵌套的,一般的損失差檢定在這裡 不是有效推論 。實驗改用受限虛無下的遞迴穩定分塊拔靴:資料由配適好的 B1 方程生成,每個假路徑的 HAR 特徵從它自己的歷史重建,VIX 與 IPO 訊號路徑固定在觀測值,然後 整條擴張式預測路徑在每個複製樣本裡重新估計一次 。999 次複製、999 次有效、0 次非有限值,期望分塊長度 22,seed 42。
- 虛無分佈的平均 delta = +0.000322,標準差 = 0.000640
- 單邊 p = 0.603 — 沒有偵測到
- 分塊長度敏感度:期望長度 5 / 10 / 44 時 p = 0.640 / 0.618 / 0.578
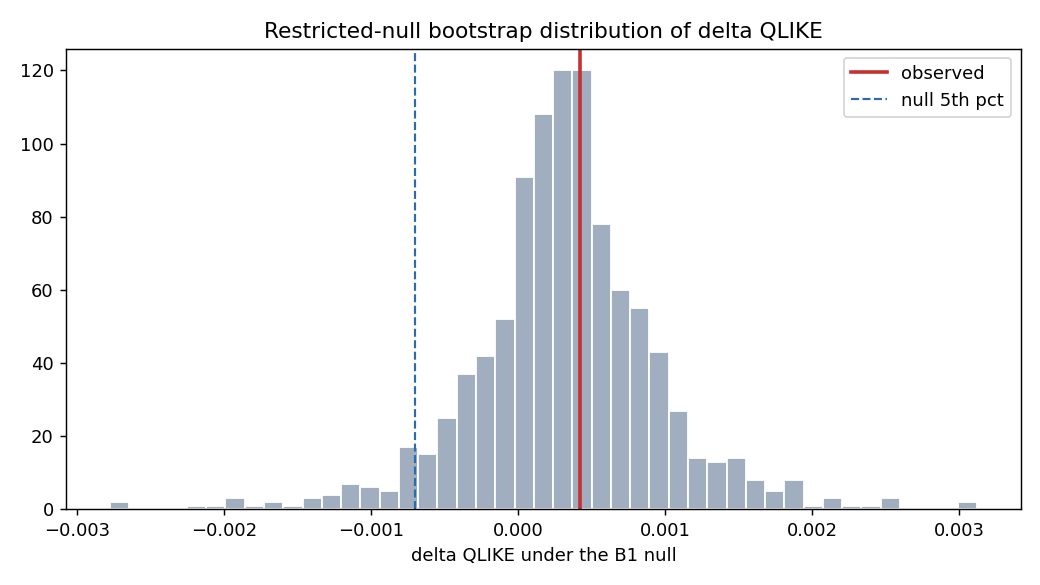
這張圖裡有一個容易被跳過的細節: 虛無分佈的中心本身就是正的 (+0.000322)。也就是說,即使 IPO 訊號的真實係數是零,多加這個變數也 本來就會 讓預測變差一點。實驗沒有假設這件事不存在,而是讓拔靴把這個懲罰重現出來。觀測到的 +0.000425 就落在那個中心旁邊,略偏右。
這個 null 的邊界在哪裡
到這裡都還只是「沒看到」。真正值錢的是下一段。
- delta QLIKE 的單邊 95% 下界 = −0.002537
- 「有意義」的門檻(1% 的改善)= −0.003357
- 這個下界 排除了 1% 或更大的改善
- 沒有被排除的最大改善是 0.756%
- HAC 交叉檢核給出 −0.002031,方向一致
換句話說:如果 IPO 降溫訊號真的能為次日 SPY 變異數預測帶來 1% 以上的改善,這份資料會看得到。它沒看到,所以那個大小的效應可以被排除。剩下的空間是 0.756% 以下。
實驗還把檢定力寫成數字:1% 的門檻距離虛無中心有 5.25 個虛無標準差 ,而這個設計在單邊 5% 下能偵測到的最小改善是 0.208% 。也就是它有能力看到比目標小五倍的效應,然後什麼都沒看到。這就是為什麼結論被寫成 BOUNDED_NULL 而不是「不顯著」。
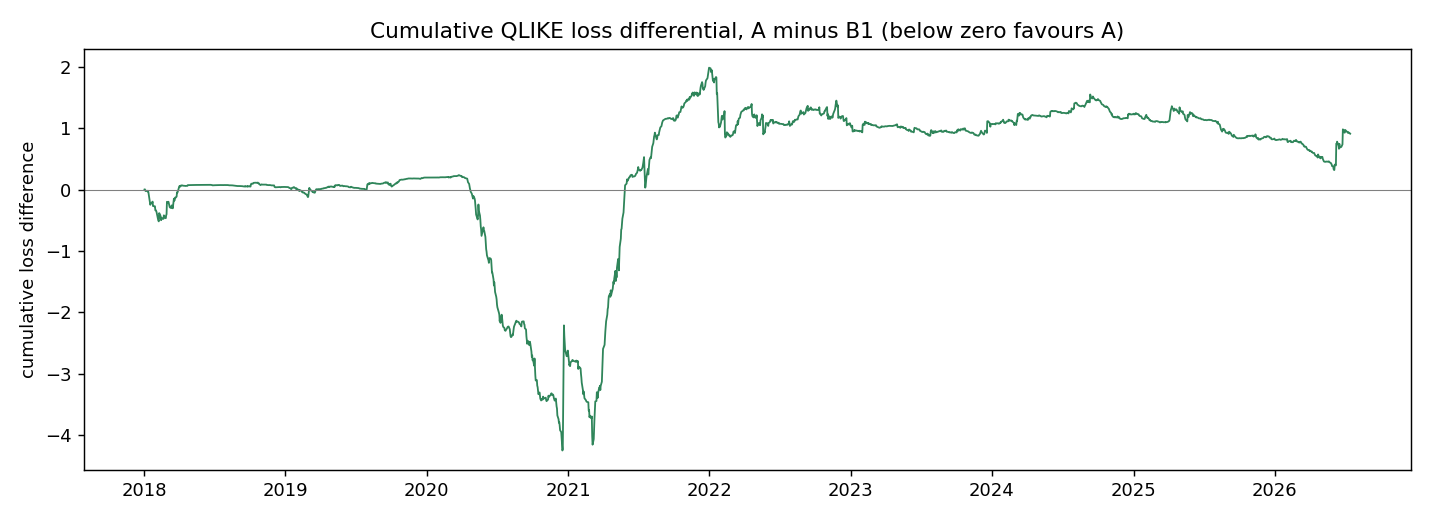
這張累積損失差的圖是整份實驗最有教育意義的一張,值得慢慢看。
從 2018 到 2020 年初,線幾乎貼著零,訊號沒差別。 2020 年 3 月之後它開始一路往下衝,到 2021 年初累積優勢達到 −4 以上 。如果你在 2021 年 3 月停下來寫文章,你會寫出一篇很有說服力的「IPO 熱度預告了疫情崩盤與後續震盪」。
然後 2021 年下半年,它把賺到的全部還回去,並且從 2022 年起持續停在零以上(也就是比基準差),一路到 2026 年。
這條線是 樣本期選擇 這件事最誠實的示範。同一個訊號、同一份資料、同一段程式,只要你選擇在哪一年結束,可以得到「有效」或「無效」兩種相反的故事。這也是為什麼 OOS 起訖日與資料範圍必須在看到結果前就凍結在預先註冊裡,而不是事後挑一段「看起來對」的期間。
穩健性:12 個格子,兩個站在訊號那邊
穩健性家族在凍結時就列好了,共 12 個格子,11 個成功執行:
- 站在基準那邊(9 個) :前半段、排除疫情、H = 5、H = 22、756 日滾動窗、加槓桿控制項、OOS 起點改 2017、改 2019、最小訓練列改 504
- 站在訊號那邊(2 個) :後半段、目標換成 Parkinson
任一格子的最大絕對改善是 4.68%,看起來不小。但 Holm 校正之後(家族 11 個), 沒有任何一格在 5% 下顯著 ——後半段那格的原始 p = 0.131,校正後是 1.0;Parkinson 那格原始 p = 0.184,校正後同樣是 1.0。前半段那格則是 delta = +0.001244(改善率 −0.328%),比主結果更差一些。
scaler_min_periods_252 那一格沒被算進方向穩定性統計,因為更嚴格的標準化暖機把 OOS 起點推到 2018-10-17、列數降到 1,944,它不是同一份帳。它的方向與主結論一致(delta = +0.000483,A 更差),但實驗選擇如實標成 status ≠ ok,而不是把它混進去湊「12/12 一致」。
還有一件事被寫進了產物而不是被藏起來:預先註冊說調整因子必須「在數值容忍範圍內單調不減」,但沒有把容忍值量化。凍結後才發現原始報價本身帶有 1e-6 量級的印製捨入雜訊,於是 1e-9 的界限量到的是報價精度不是調整因子。容忍值被改成 1e-6——而且這個修改 發生在冒煙測試已經印出主結果之後 。這個順序被明寫在產物裡。之所以敢公開它,是因為它只管一道停走檢查:它驗證的調整後 OHLC 兩種設定下位元相同,而 Garman-Klass 與 Parkinson 對每日等比例因子是嚴格不變的,這件事也是實測的,max_intraday_log_range_drift_vs_raw = 2.2e-16。
這篇說了什麼,沒說什麼
說了 :一個由 IPO ETF 相對強弱建構的、逐時點可得的降溫訊號,在已控制前一日 VIX 的 HAR 之上,對次日 SPY 的 Garman-Klass 範圍變異數沒有增量預測資訊,而且 1% 以上的改善已被排除。VIX 充分性的紀錄又多了一條,這次是從風險偏好的通道進來的。
沒說 :這不是因果陳述,也不是交易獲利陳述。原始相關與偏相關在這份預先註冊裡是描述性的,永遠不能觸發結論。目標是 Garman-Klass 範圍變異數,它被誠實地稱為潛在日變異數的 代理 ,不是日內已實現變異數,用 5 分鐘資料重做,H = 5 與 H = 22 那幾格有可能移動。這篇也沒有測「IPO 市場冷熱對更長期限的股票報酬有沒有解釋力」,那是另一個問題。
還有一件沒說的:這篇沒有證明 IPO 市場的溫度對投資人沒有意義。它證明的是 這個特定建構方式、在這個特定的次日變異數問題上、在 VIX 之後,沒有位置 。這兩句話的差別,就是研究能主張的與不能主張的差別。
資料來源 :Renaissance IPO ETF、SPY、^VIX 日資料(2013-10 至 2026-07-15,位元凍結於實驗目錄並每次執行重新雜湊驗證)。所有數字的唯一權威來源是 K1750_results.json;預先註冊檔在看到任何樣本外結果前凍結,雜湊值記錄於產物中。網路存取在科學執行階段設為 deny。