一百個起點,十二次白跑,三次抓到東西——GJR-GARCH 最大概似的局部最優實測
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
我們先前寫過〈同樣遇到壞消息,台股五檔代表股的波動反應差了快七倍〉,那篇講的是 K1302 估出來的下跌放大係數 γ 在五檔標的之間差多少。那個結論沒有變。這篇要講的是它下面那一層: 那五個 γ 是怎麼估出來的,以及如果當初只用一個起點跑,會不會估到別的地方去。
這不是修辭問題。GJR-GARCH 的概似函數不保證是凸的,arch 套件預設從一組固定初值出發呼叫 scipy.optimize.minimize,收斂之後回傳一個參數向量,不會告訴你那是全域最大還是它剛好掉進去的那個坑。它回一個看起來完全正常的數字。
K1302 的重建版本(v2)因此改成每個設定跑一百個隨機起點(seed 42 到 141),取 log-likelihood 最高的那一組當作估計值,並把一百個起點各自收斂到的 log-likelihood 全部留在結果檔裡。留著那條分布,才有辦法事後回答「多起點到底有沒有必要」。
實驗設定
五檔標的(鴻海 2317.TW、聯發科 2454.TW、元大高股息 0056.TW、兆豐金 2886.TW、台光電 2383.TW)乘三種設定,共十五個 (標的, 設定) 組合:
- TWA — 全樣本常態 :GJR-GARCH(1,1,1),常態分配,全樣本。這是 Paper 2 Table 2 用的 canonical 設定。
- TWB — 全樣本厚尾 :同上但改 Student-t。
- TWC — 近 1250 日 :常態分配,只用最後 1250 個交易日。
樣本期間 2008-01-01 至 2024-12-31,全樣本設定的有效觀測數是 4170 筆(0056 為 4173 筆),短視窗設定固定 1250 筆。估計用 arch 的 GJR-GARCH(1,1,1) 搭配 Constant mean,標準誤走 Bollerslev-Wooldridge robust。
判定「一百個起點落在同一個最大值」的門檻設在 log-likelihood 全距 0.001。這個門檻不敏感:十五個設定的全距不是落在 0.0000007 以下,就是跳到 20 以上,中間七個數量級是空的,門檻挪到哪裡結果都一樣。
結果一:十二個設定裡,多起點完全是白跑的
十二個設定的一百個起點收斂到同一個 log-likelihood,最大的全距是 0.00000068——那是浮點數層級的差異,不是不同的解。換句話說,這十二個設定就算只跑一個起點,也會估到同一個地方。
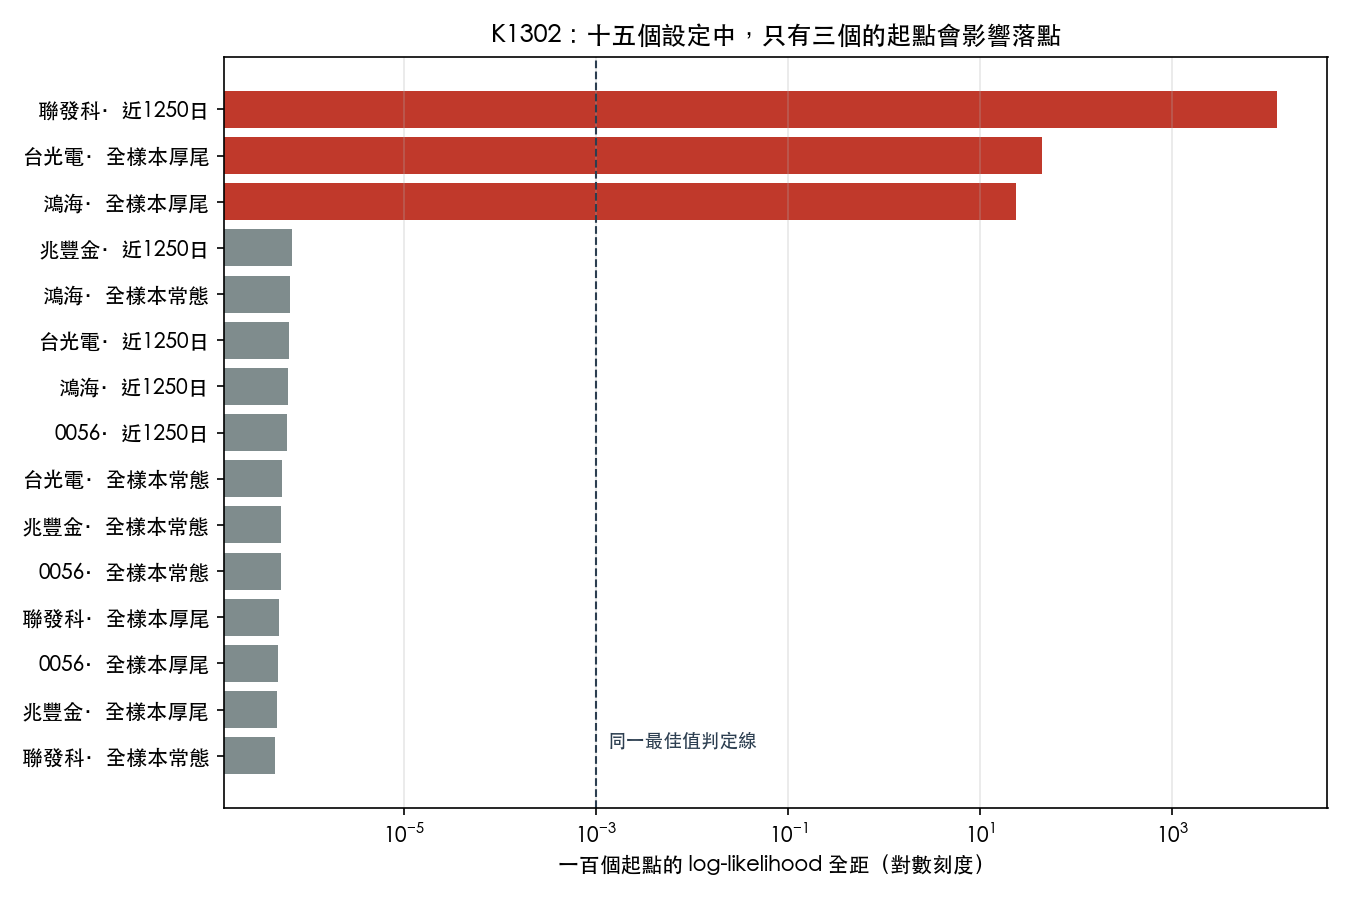
結果二:三個例外,全部集中在厚尾與短視窗
剩下三個設定的全距是:
| 標的 | 設定 | 一百起點的 LL 全距 | 收斂起點數 | 落在最佳值附近的起點數 | 最終 γ | γ 的 robust t | 持續性 α+γ/2+β |
|---|---|---|---|---|---|---|---|
| 聯發科 2454.TW | 近 1250 日(TWC) | 12471.75 | 一百 | 九十九 | 0.0260 | 0.82 | 0.9456 |
| 台光電 2383.TW | 全樣本厚尾(TWB) | 44.14 | 三十一 | 二十八 | 0.0091 | 0.95 | 1.0000 |
| 鴻海 2317.TW | 全樣本厚尾(TWB) | 23.70 | 一百 | 九十九 | 0.0298 | 2.05 | 0.9968 |
三個例外沒有一個出現在 TWA。它們全部落在改了分配(Student-t)或改了視窗(1250 日)的設定上。以這份樣本來說,會不會踩到局部最優,是 設定 的性質,不是標的的性質,同一檔聯發科,全樣本常態與全樣本厚尾都乾淨,只有短視窗那一格出事。
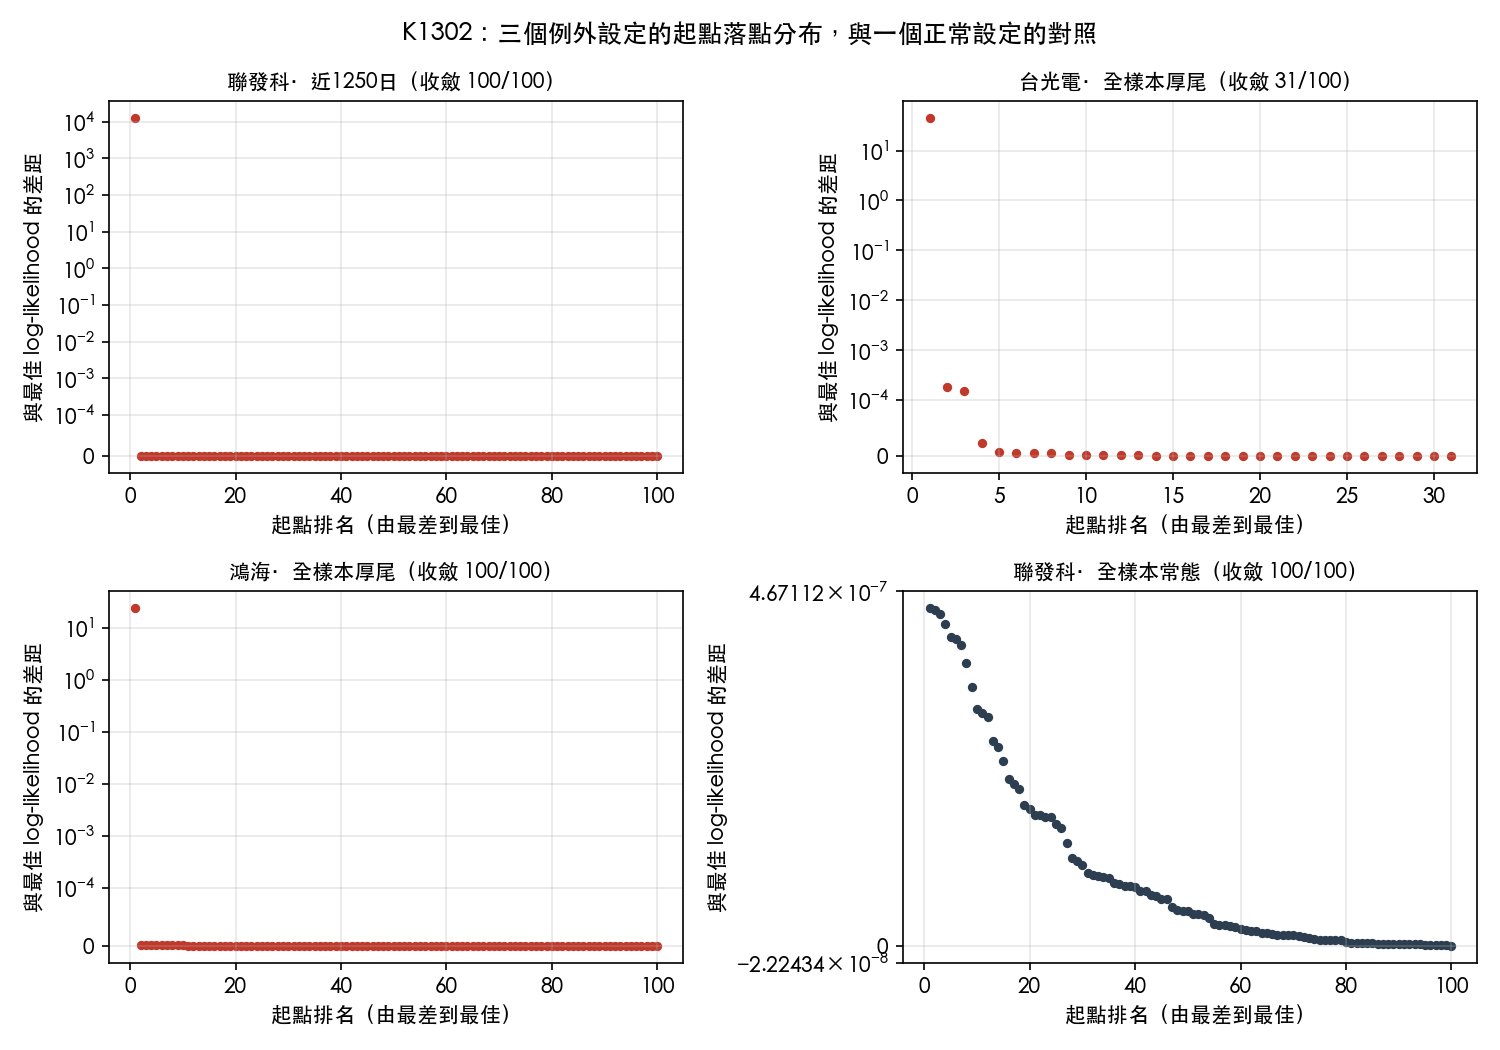
三個例外的形狀也不一樣:
- 聯發科·近 1250 日 :一百個起點全部收斂,但有一個掉到比最佳值低 12471.75 的地方。那不是「稍微差一點的解」,那是完全不同的參數區域。剩下九十九個起點彼此一致。
- 鴻海·全樣本厚尾 :同樣是一百個起點裡一個離群,差距 23.70。
- 台光電·全樣本厚尾 :這個最麻煩。一百個起點只有三十一個收斂,收斂的裡面又只有二十八個落在最佳值附近。而且它估出來的持續性是 1.0000(α + γ/2 + β 到浮點精度都等於一),Student-t 自由度 4.99——參數壓在 IGARCH 邊界上,最佳化本來就會在那裡失去識別力。
值得說的是,這三個設定的 最佳起點 seed 分別是 112、48、139 ,都不是第一個 seed。如果當初只跑預設的單一起點,這三格拿到的會是哪個解,沒有任何先驗理由假設它是最好的那個。
結果三:真正上論文的那一欄,一格都沒受影響
K1302 的原始目的是補 Paper 2 Table 2 的 provenance——確認論文正文那五個 γ 與 t 值真的可以從資料重估出來。重估結果對五檔全部 PASS:
| 標的 | 論文 γ | 重估 γ | |Δγ| | 論文 t | 重估 t | |Δt| | 判定 |
|---|---|---|---|---|---|---|---|
| 鴻海 2317.TW | 0.032 | 0.0320 | 0.000024 | 1.74 | 1.7407 | 0.00067 | PASS |
| 聯發科 2454.TW | 0.041 | 0.0406 | 0.00040 | 3.10 | 3.0962 | 0.0038 | PASS |
| 0056.TW | 0.067 | 0.0668 | 0.00017 | 1.91 | 1.9141 | 0.0041 | PASS |
| 兆豐金 2886.TW | 0.038 | 0.0379 | 0.000068 | 1.55 | 1.5523 | 0.0023 | PASS |
| 台光電 2383.TW | 0.009 | 0.0095 | 0.00045 | 1.15 | 1.1465 | 0.0035 | PASS |
γ 的最大偏離 0.00045,t 的最大偏離 0.0041,容差分別是 0.001 與 0.05。全部落在論文四捨五入的位數之內。
這件事要正著讀也要反著讀。正著讀:Table 2 的數字是穩的,因為它用的是 TWA,而 TWA 是十五個設定裡最乾淨的那一類。反著讀: 這份穩定性是事後才知道的 。做這次重建之前,沒有人能從單起點估計的輸出判斷 TWA 屬於「起點無所謂」那一類,那份輸出跟三個例外的輸出長得一模一樣,都是收斂旗標加一組參數。
這份結果能撐到哪、不能撐到哪
能撐的:局部最優在這個模型族裡 確實存在 ,不是教科書的假設性警告;而且它與設定選擇有關聯,十五格裡出事的三格全部不在 canonical 設定上。
不能撐的:十五個設定不足以估「踩到局部最優的機率」,三個例外也不足以說厚尾與短視窗 必然 危險(TWB 有五格,出事兩格;TWC 有五格,出事一格)。這是單一市場、單一估計套件、單一模型族的觀察,樣本量就是十五。
另外一件不能從這份資料推出來的:一百個起點是否「夠」。我們觀察到的是一百個起點裡最好的那個,沒有辦法證明它是全域最大,只能說再多九十九個起點沒有找到更好的。要回答夠不夠,需要的是跨起點數的階梯實驗(十個、五十個、一百個、五百個各跑一輪看最佳值有沒有再動),那不在這次的範圍裡。
給後續實驗的一條操作結論
多起點的成本是線性的,踩到局部最優的成本不是,它不會報錯,會回一個數字,而那個數字會一路走進表格、走進論文、走進文章。這份實驗裡它剛好沒有走進去,但那是運氣,不是設計。
可操作的版本: GJR-GARCH 類的 MLE,只要換了分配或縮了視窗,就把起點分布連同估計值一起存下來 。存了才有對照組;沒有對照組,收斂旗標是一個永遠回 OK 的裝置。
資料來源
本文基於實驗 K1302(experiments/k1302/k1302.py;結果檔 experiments/k1302/k1302_results.json,時間戳 2026-05-16)。資料期間 2008-01-01 至 2024-12-31,樣本為五檔台灣標的日報酬,主要來源為論文 taiwan-vt 的資料檔,備援為 yfinance 快取。文中圖表由 storage/drafts/K1302_research_charts.py 直接讀結果檔繪製,中間數字另存 storage/drafts/K1302_research_evidence.json。