同一批 20 檔資產、同一套驗證程序:挑變數的版本 R² 是 −0.15,不挑的是 +0.15
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
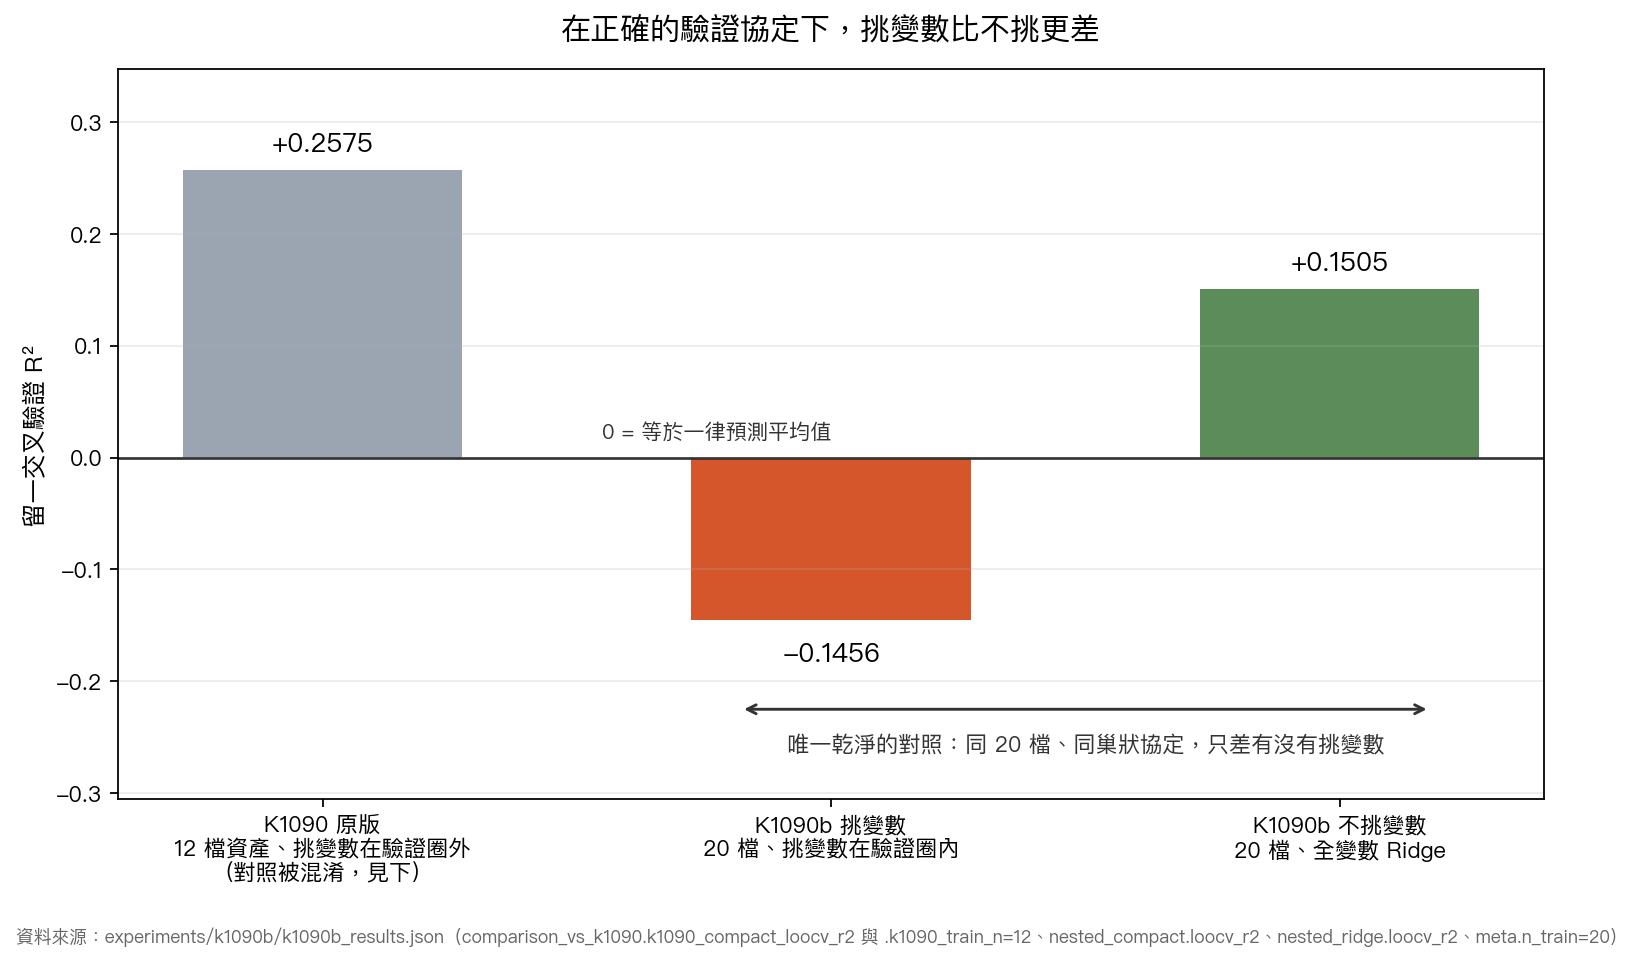
一份跨資產研究在同一批 20 檔資產上跑了兩個版本,共用同一套留一交叉驗證程序,唯一差別是要不要先挑變數。挑變數的版本得到 R² = −0.1456,不挑變數的 Ridge 得到 +0.1505。負的 R² 有明確含義:那個模型比一律回答樣本平均值還差。
這份結果還有一組看起來更戲劇化的對照:同一條研究線的前一版報過 R² = +0.2575。那組數字流傳起來很順口,但它撐不住,前一版是 12 檔資產,這一版是 20 檔,兩個改動一起做了。本文第三節說明為什麼那組對照不能用,以及乾淨的證據為什麼指向同一個方向。
這個實驗在問什麼
研究問題是:不同資產對 VIX 的波動率敏感度,能不能由該資產的結構特徵預測?
具體來說,每檔資產先跑一次 GARCH-MIDAS 設定,得到一個「VIX 對這檔資產的波動率有沒有增量預測力」的檢定統計量(dm_t)。SPY 是 7.92、QQQ 是 5.99、GLD 是 4.46、0050.TW 是 −0.49。接著用資產的結構特徵去預測這個數字:它是不是股票、成分股有幾檔、以美元還是本地貨幣計價、持股集中度、成交金額、報酬與 VIX 的相關係數、年化波動、平方報酬的一階自相關,共 12 個欄位。
如果這條迴歸成立,實務上的意義很直接:拿到一檔沒測過的資產,看它的結構就能猜出 VIX 對它有沒有用,不必每檔都重跑一次 GARCH-MIDAS。
K1090b 的特徵窗是 2018-01-01 到 2024-12-31,訓練樣本 20 檔資產,隨機種子 42。
混淆在哪裡
comparison_vs_k1090.k1090_train_n 是 12,meta.n_train 是 20。
也就是說 +0.2575 那個數字是在 12 檔資產上算出來的,−0.1456 是在 20 檔上。實驗自己的標題寫得很清楚:Nested LOOCV + expanded asset pool——巢狀驗證與擴大資產池,兩件事一起做了。
兩個改動同時發生,就得不到任一個的效果。資產池從 12 擴到 20 加進來的是 VGK、EWJ、CPER、SLV、IEF、ETH-USD、AAPL、NVDA 這類與原本 12 檔性質差距不小的標的,其中好幾檔的 dm_t 落在 0 附近(CPER 是 0.44、SLV 是 −0.08)。光是這批新樣本讓迴歸變難,就足以壓低 R²,與挑變數放在哪一步無關。
所以下面這張圖的第一根柱子是灰色的:它是參考值,不是對照組。
乾淨的對照在同一個實驗內部
K1090b 自己跑了兩個版本,兩者共用同樣的 20 檔資產、同樣的巢狀協定,唯一差別是要不要挑變數:
| 版本 | 留一交叉驗證 R² | 留一 RMSE |
|---|---|---|
| 挑變數(LASSO 在圈內選) | −0.1456 | 2.3216 |
| 不挑變數(全 12 個特徵的 Ridge) | +0.1505 | 1.9991 |
方向很明確:在同一份資料、同一套驗證程序底下,多做「挑變數」這一步的版本比較差,而且差到 R² 轉負。
這與一般直覺相反。挑變數通常被當成減少雜訊的動作,尤其在樣本只有 20 筆而候選變數有 12 個的情況下,把沒用的欄位丟掉聽起來應該有幫助。
為什麼挑變數會傷害預測
答案在選出來的東西本身。
留一交叉驗證會跑 20 折,每折抽掉一檔資產、用剩下 19 檔重新選變數與配適。如果那 12 個特徵裡真的有幾個帶訊號,20 折應該大致選到同一組。實際結果是:
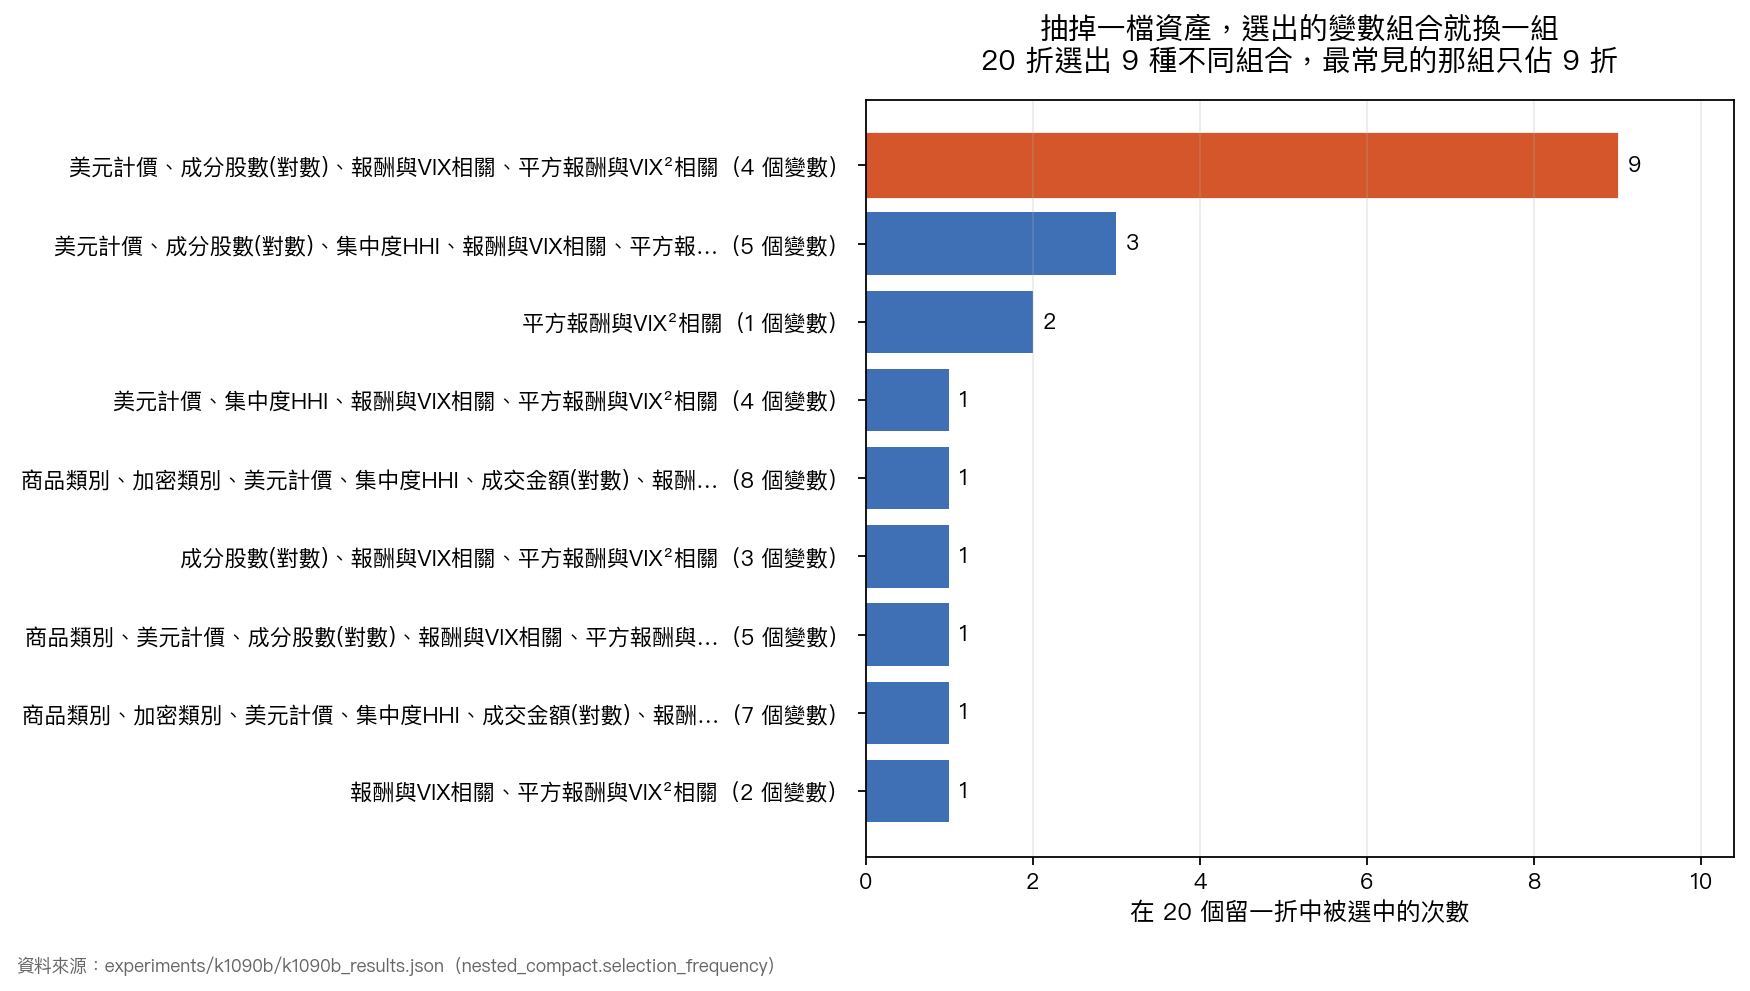
20 折選出 9 種不同的組合。出現最多次的那一組是「美元計價 + 成分股數對數 + 報酬與 VIX 相關 + 平方報酬與 VIX² 相關」這四個變數,只在 9 折中被選中。剩下 11 折散在另外 8 種組合上,選出的變數個數從 1 個到 8 個都有,有一折只留下一個變數,另一折留了八個。
抽掉一檔資產就換一組變數。這代表選擇程序抓到的東西會隨著手上那 19 檔的組成而變,它跟著噪音走。而每一折的模型都是照著自己那組變數配出來的,於是 20 個「同一個模型」實際上是 9 個不同的模型。
Ridge 沒有這個問題,因為它不做離散的取捨,只把係數往零壓(nested_ridge.alpha_median = 30.0)。它在每一折都是同一個模型,只是參數略有不同。
兩版都沒有真的學會
即使 Ridge 的 R² 是正的,也不該讀成這條迴歸可用。
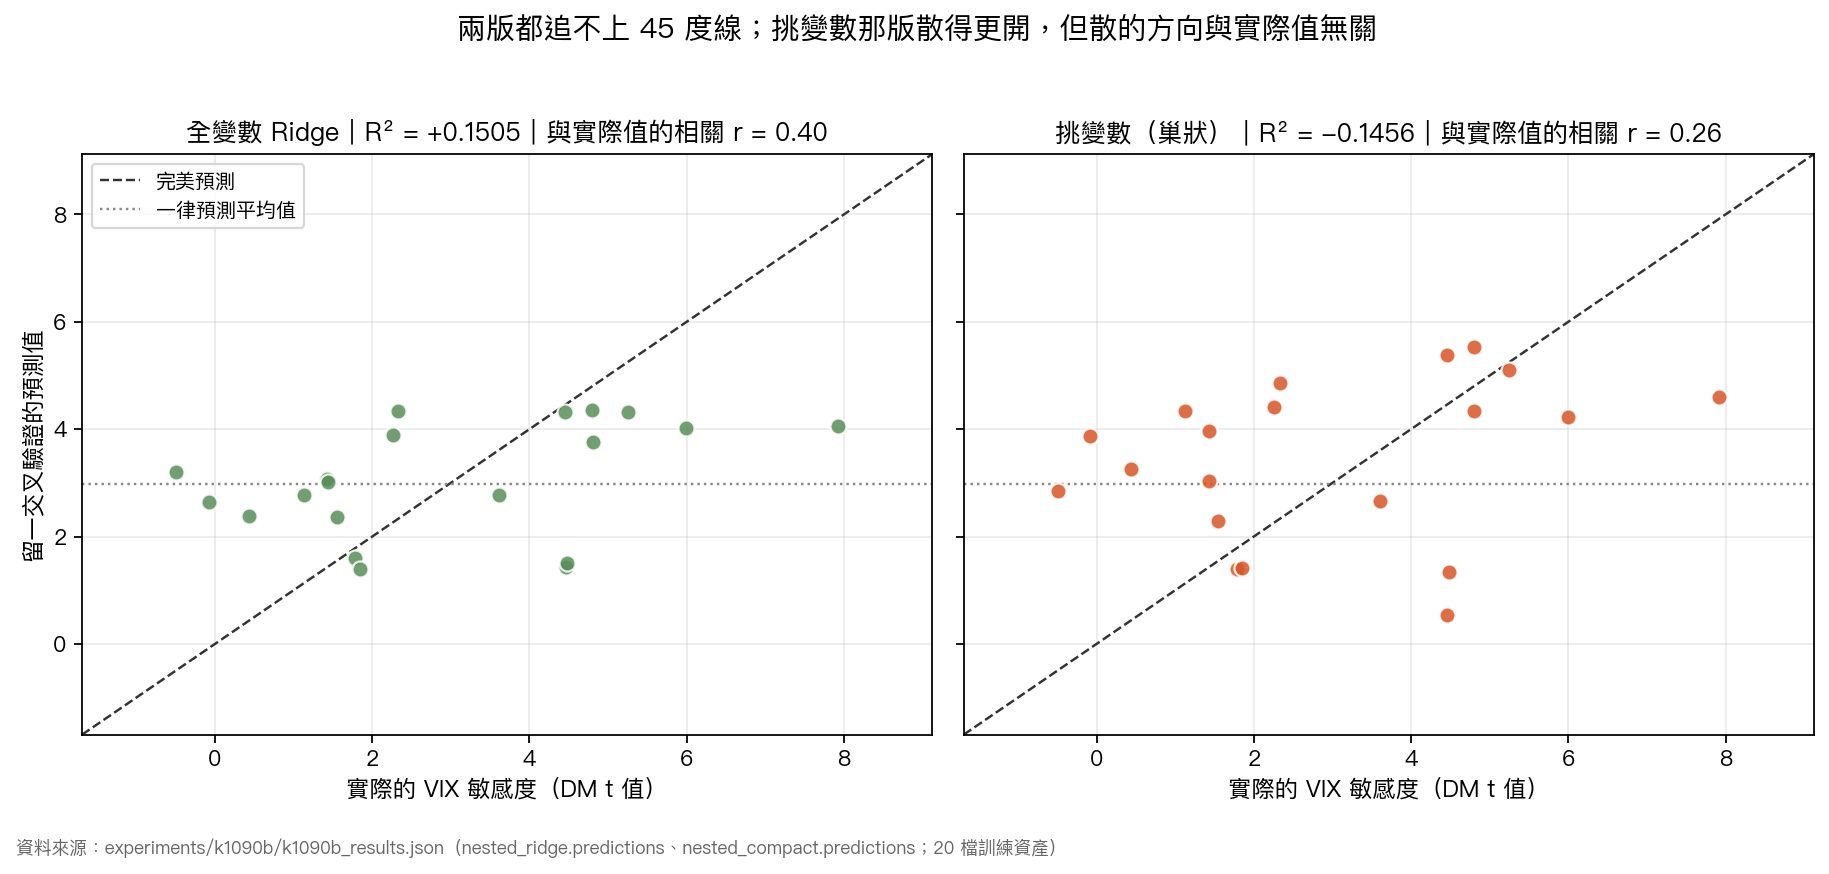
45 度虛線是完美預測,水平點線是「一律回答平均值」。兩張圖的點都貼著水平線分布,離 45 度線很遠。Ridge 版的預測值只落在 1.40 到 4.36 之間,而實際的 dm_t 從 −0.49 一路到 7.92。模型認得出「大概在平均附近」,認不出高低。
挑變數那版的預測範圍反而更寬(0.55 到 5.53),但寬在錯的地方,它的預測與實際值的相關只有 0.26,比 Ridge 的 0.40 更低。散得更開而方向更不準,正是 R² 轉負的算術來源。
這份結果自己的限制
訓練樣本只有 20 檔資產。
在 20 筆資料上做留一交叉驗證,單一資產的留出結果就能大幅移動 R²。BTC-USD 的年化波動是 0.566、ETH-USD 是 0.715,而 IEF 是 0.068——差了十倍。抽掉其中任何一檔,剩下 19 檔的迴歸面貌都不一樣。所以 Ridge 那個 +0.1505 同樣不該被當成穩健的正結果,它與 0 的距離撐不起任何強度的主張。
順帶一提,同一組變數在全樣本內配一次普通最小平方,R² 是 0.5602。那個數字沒有預測意義,列在這裡只是為了標出過擬合的幅度:樣本內 0.56、留一 −0.15,中間的落差就是模型從 20 筆資料裡背下來的部分。
要推進這條線,該做的是擴大資產池,不是換模型。
可以帶走的三個判準
第一,看到交叉驗證的 R²,先問「挑變數這一步在圈內還是圈外」。任何在看過全部資料之後才決定用哪些變數的流程,它報出來的交叉驗證分數都不是樣本外表現。這份資料裡,光是這個位置差異就足以讓結論從「可用」變成「比猜平均值還差」。
第二,選擇不穩定本身就是證據。如果一個流程宣稱找到了有效變數,把資料抽掉一筆重跑,看它選出的還是不是同一組。20 折選出 9 種組合,就不必再看 R² 了。
第三,一次只改一件事。這份實驗同時改了驗證協定與資產池,於是那個看起來最戲劇化的對照(+0.2575 對 −0.1456)反而是三組數字裡唯一不能拿來下結論的。真正撐得住的證據,是同池同協定底下的 −0.1456 對 +0.1505。
資料來源 :experiments/k1090b/k1090b_results.json(K1090b)。特徵窗 2018-01-01 至 2024-12-31,訓練樣本 20 檔資產,隨機種子 42。標的價格來自 yfinance,VIX 為 ^VIX。
方法 :外層留一交叉驗證。防洩漏處理四項均在每個外折的訓練集內完成,補值配適、標準化配適、LASSO 懲罰參數由內層留一決定、變數選擇只用外折訓練集。
復現 :本文三張圖由 storage/drafts/k1090b_selection_bias_charts.py 直接讀結果檔產生,未經人工轉抄。