複雜模型越疊越笨?當你手握十幾個量化指標,用四道檢查門避開過度擬合與模型過載
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
在量化交易與策略開發的世界裡,幾乎每個研究者都踩過同一個陷阱: 當一個簡單模型運作得還不錯時,直覺會驅使你為它加上更多層複雜邏輯。
看到市場波動忽高忽低,就想加入「兩狀態切換」或「多重碎形」機制;覺得參數固定太死板,就設計「每日動態權重漂移」或「線上 Conformal 混合」;嫌傳統統計模型太老舊,就把最新熱門的「時序基礎 AI 模型」或「貝氏 MCMC 抽樣」搬進估計流程。
這些新機制在論文或宣傳上聽起來都無比精妙,每一層數學都有極其漂亮的理論依據。但在實戰中,把十幾個複雜指標與模型疊在一起,隔天的預測真的會變準嗎?還是你只是付出了龐大的維護算力,卻買回了一堆在樣本外瞬間崩潰的過度擬合(Overfitting)與噪音?
本期精選導讀,我們攤開過去數月在美股(SPY、QQQ、TLT、GLD)、日股(^N225)、台股(0050.TW、TX)跨市場超過兩萬筆逐日預測的八項嚴格實驗。結果展示了一個極其殘酷的量化現實: 絕大多數精心設計的複雜擴充機制,在樣本外(Out-of-Sample, OOS)的嚴格擂台上,全數輸給了一行只有兩三個參數的簡單老公式。
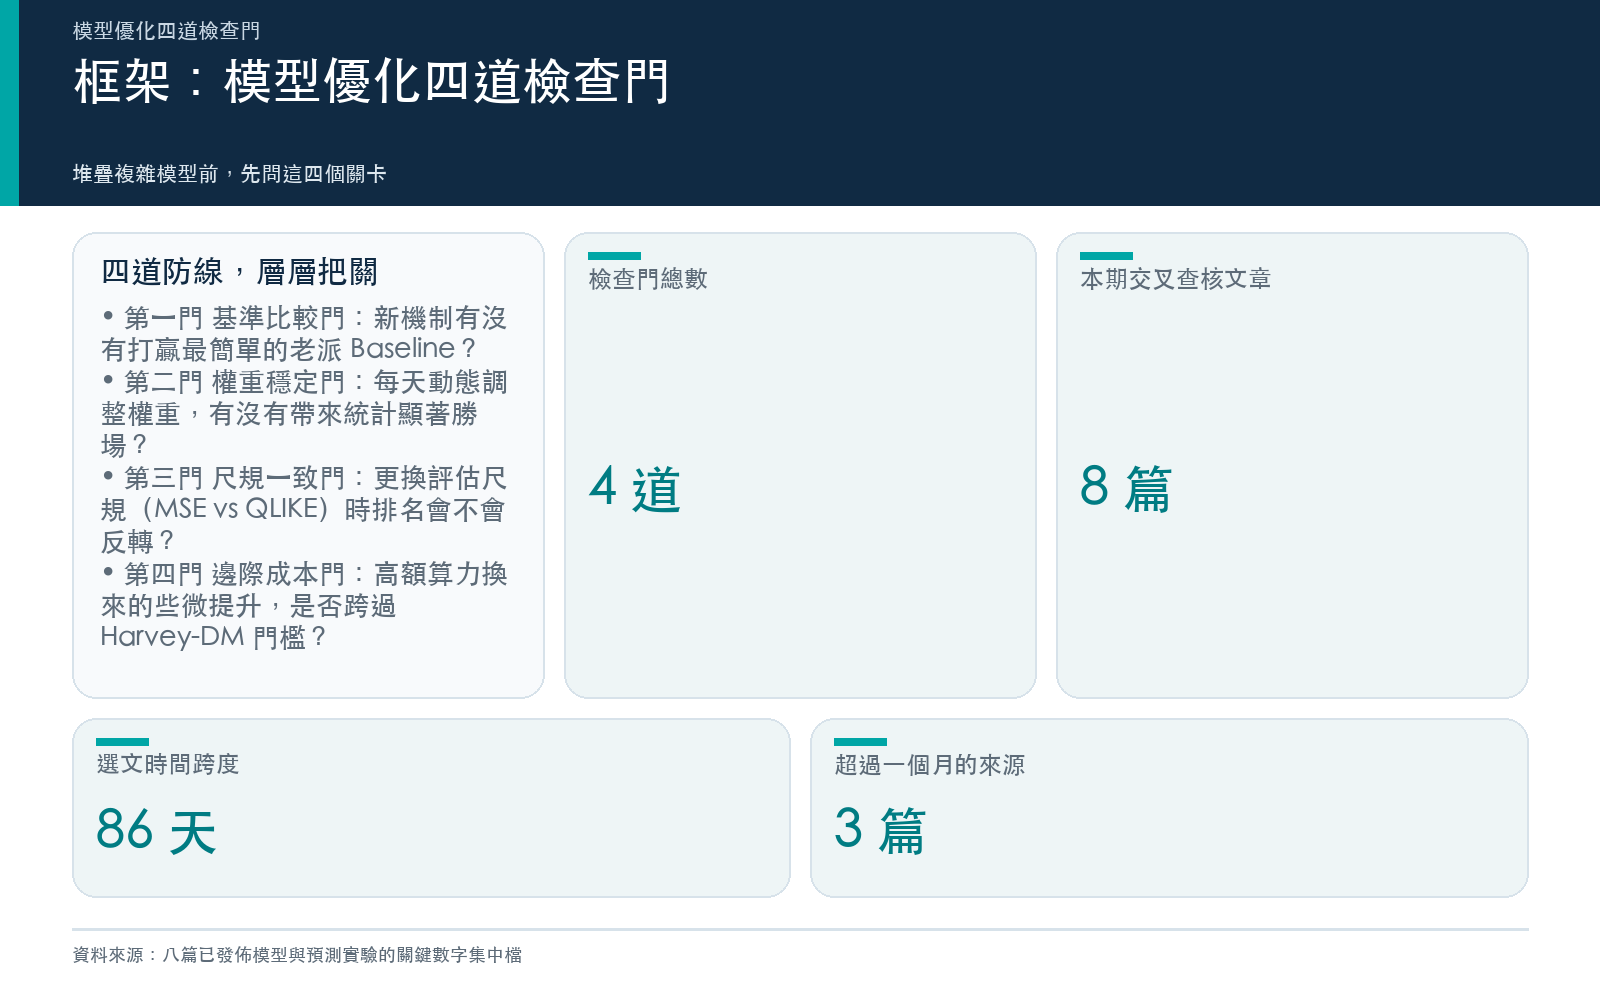
為了防止你的交易系統被「複雜度幻覺」綁架,本期將為你建立一套可立即套用的運算審核機制—— 「模型優化四道檢查門 (Four Quality Gates for Model Optimization & Selection)」 。
本期唯一要你帶走的東西:模型優化四道檢查門
當你準備在交易系統中引入新變數、動態權重或複雜 AI 模型時,請不要被漂亮的擬合曲線誘惑。把新模型送進這四道檢查門,順序不能顛倒:
| 順序 | 檢查門名稱 | 你在確認什麼 | 沒通過的意思/答錯的代價 |
|---|---|---|---|
| 一 | 基準比較門 (Benchmark Gate) | 新機制/複雜模型有沒有統計顯著地打贏最老派簡單的 Baseline(如 3 參數 HAR-RV 或 GJR-GARCH)? | 複雜度只換來自嗨,沒換來真正增量預測力 |
| 二 | 權重穩定門 (Weight Stability Gate) | 每天讓模型權重動態漂移/線上混合,有沒有帶來統計勝場,還是只增加換手率與過擬合? | 權重漂移全在捕捉隨機雜訊,等權重勝率更高 |
| 三 | 尺規一致門 (Metric Consistency Gate) | 當評估尺規從 MSE 換成 QLIKE 或非對稱損失函數時,模型的優劣排名是否會翻轉? | 模型的優勢只存在於某把特定尺規,不具泛化穩健性 |
| 四 | 邊際成本門 (Marginal Cost Gate) | 耗費幾十倍計算資源(MCMC 抽樣/深度 AI 基礎模型)換來的微小提升,是否跨過 嚴格統計-DM 統計門檻? | 付出高昂維護與算力成本,回報卻未達統計顯著性 |
- 基準比較門 :我已經拿新模型跟只有 2-3 個參數的傳統 Baseline 進行樣本外 兩模型比較顯著 檢定。
- 權重穩定門 :我驗證過動態權重調整的表現,確信它贏過簡單的等權重平均(Equal-Weighting)或靜態裁減。
- 尺規一致門 :我在至少兩把不同物理意義的損失函數(如 MSE 與 Patton QLIKE)下核對過排名,確認沒有出現相反的方向訊號。
- 邊際成本門 :新模型帶來的點預測提升已跨過 嚴格統計 統計顯著門檻,足以合理化額外增加的算力與維護複雜度。
四關全過,新模型才有資格進入你的正式投組;只要卡在任何一關,最務實的選擇就是把它留留在研發實驗室,繼續使用簡單穩健的 Baseline。
下面我們結合八篇本土與跨國量化實證,逐門拆解。
第一門:基準比較門,複雜機制真的打得贏一行老公式嗎?
當研究者對舊模型感到不滿時,第一個直覺往往是「多加一層狀態切換」或「讓參數隨時間平滑過渡」。
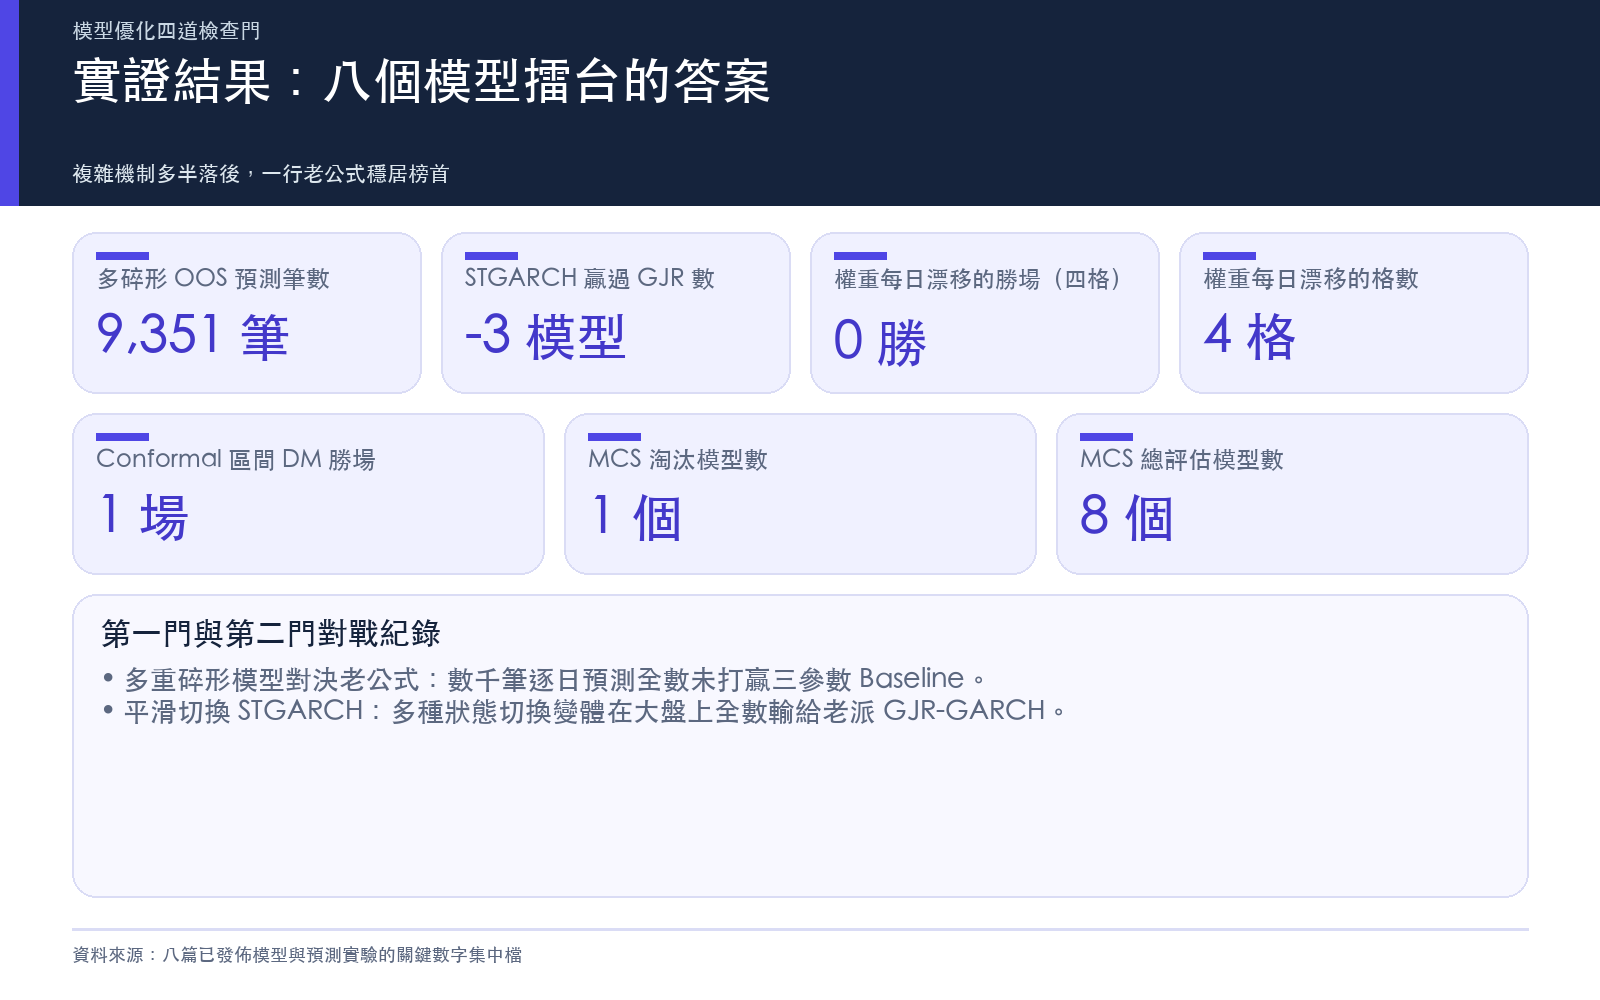
在 〈把市場拆成四層開關:贏了兩狀態切換,也贏了教科書模型,卻沒贏過一行老公式〉 裡,我們測試了一套理論極其優雅的「多重碎形 / 多層狀態開關模型」。這套模型假設市場波動的記憶不只一層:短線有新聞與當沖追價,長線有利率與資金循環。研究者估計了跨美股大盤(SPY)、科技股(QQQ)、黃金(GLD)、長債(TLT)與台股(0050.TW)共 5 檔資產,樣本外合計 9,351 筆逐日預測 。
結果如何?這套四層開關模型確實贏了傳統的兩狀態切換模型,也贏了陽春教科書版,但在最終樣本外對決中, 它依然沒有打贏只有三個參數的老牌 HAR-RV 與 GJR-GARCH 公式 。
類似的教訓發生在 Smooth Transition GARCH(STGARCH)上。在 〈把 GARCH 改聰明反而更笨:3 種 STGARCH 在 SPY 上全輸給老派 GJR〉 中,我們嘗試讓 GARCH 的係數依照市場狀態(分別以 VIX、絕對報酬、滯後波動率作為平滑切換指標)進行動態過渡。在 SPY 2023 年至 2024 年共 502 個樣本外交易日的嚴格測試中,這 3 種「變聰明」的 STGARCH 變體,QLIKE 評分 全數輸給了最老派的 GJR-GARCH 。
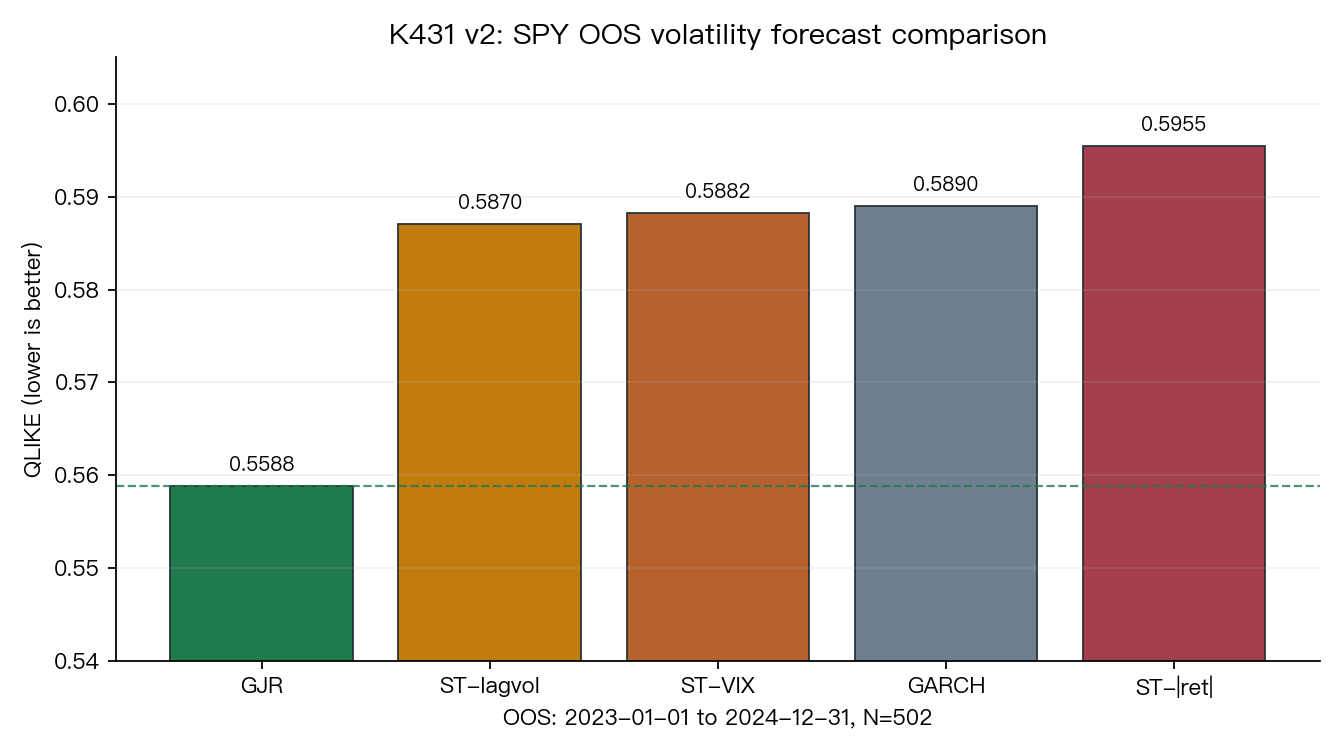
為什麼加了多重開關或平滑切換,預測反而更笨?因為在樣本內估計時,多出來的參數非常擅長「解釋」過去的歷史噪音;但一進到樣本外,這些敏感的切換機制就變成了預測特性的脆弱點。
第一門的判決:任何複雜機制在上線前,必須先放在 3 參數老 Baseline(如 HAR-RV 或 GJR-GARCH)隔壁跑 OOS 對戰。如果連老 Baseline 都打不贏,模型再優雅也只是精美的負擔。
第二門:權重穩定門,天天動態調整權重,真的比較聰明嗎?
如果你手頭有四五個表現都不錯的模型,下一個誘人的想法是:「我不選單一模型,我讓它們每天依據近期表現動態調整權重(Dynamic Weighting / Online Blending)。」
在 〈讓模型的權重每天自己漂移,隔天的波動會更好猜嗎?四格對戰輸掉三格,唯一贏的那格不能算〉 中,漂移的是另一種權重:同一條 HAR 預測式裡的係數,跟幾個模型之間怎麼分配無關。我們讓係數每收到一天新資料就微調一次(時變參數的卡爾曼濾波),在美股 SPY 與台股 0050 兩個市場上,跟每天把整段歷史重估一次的固定係數版本比。每個市場用兩把尺:事前登記的主要量尺 QLIKE,以及直接量變異數水準的次要量尺 MSE,一共四格。
結果: 會漂移的版本在四格裡輸掉三格 。兩個市場在主要量尺上,都是固定係數版本的損失比較低。唯一的正格是台股 0050 的次要量尺,但那把尺不是事前說好要看的,它的平均值又會被少數極端高波動日主導,所以不能算贏。模型在訓練階段自己挑漂移幅度時,挑的是候選值裡最小的那一個。讓係數每天跟著最新數據漂移,沒有換來更準的隔天預測。
進一步地,在 〈K1598:universal-portfolio 式線上 conformal 混合,96 個 DM 檢定只留下一個嚴格勝場〉 裡,我們採用 Cover 經典的 Universal Portfolio 演算架構(UP_AggACI_lite),對 12 檔美股 ETF 自 2016 年起每檔 2,633 個樣本外交易日進行線上 Conformal 區間校準。全矩陣一共執行了 96 個 嚴格統計 調整的 DM 統計檢定 ,在經過嚴格的 Holm-Bonferroni 多重比較校正後, 最終僅僅留下了 1 個嚴格勝場 。
甚至連模型裁減(Pruning)這件事,資料的完整度都遠比想像中關鍵。在 〈把四成六的樣本還回來之後,MCS 才淘汰得掉一個模型〉 中,我們利用模型信心集(Model Confidence Set, MCS)對 8 個候選模型進行篩選。當歷史資料被截斷缺漏時,雜訊會淹沒模型之間的真正差距;而當我們把 46% 的缺失歷史樣本補齊後,在 10% 的顯著水準下,MCS 最終也僅成功淘汰了 1 個模型 ,其餘 7 個模型全數留在同一個信心集內。
第二門的判決:動態調整權重極易陷入「擬合昨天的噪音」之困境。在絕大多數情況下,簡單的「等權重平均」或「靜態保留優質 Baseline」比複雜的動態分配演算法更加穩健且節省交易成本。
第三門:尺規一致門,小心評估工具一把換一把,排名全對調
假設你開發了一個新模型,在常用指標下表現極佳,這就代表它真的獲勝了嗎?
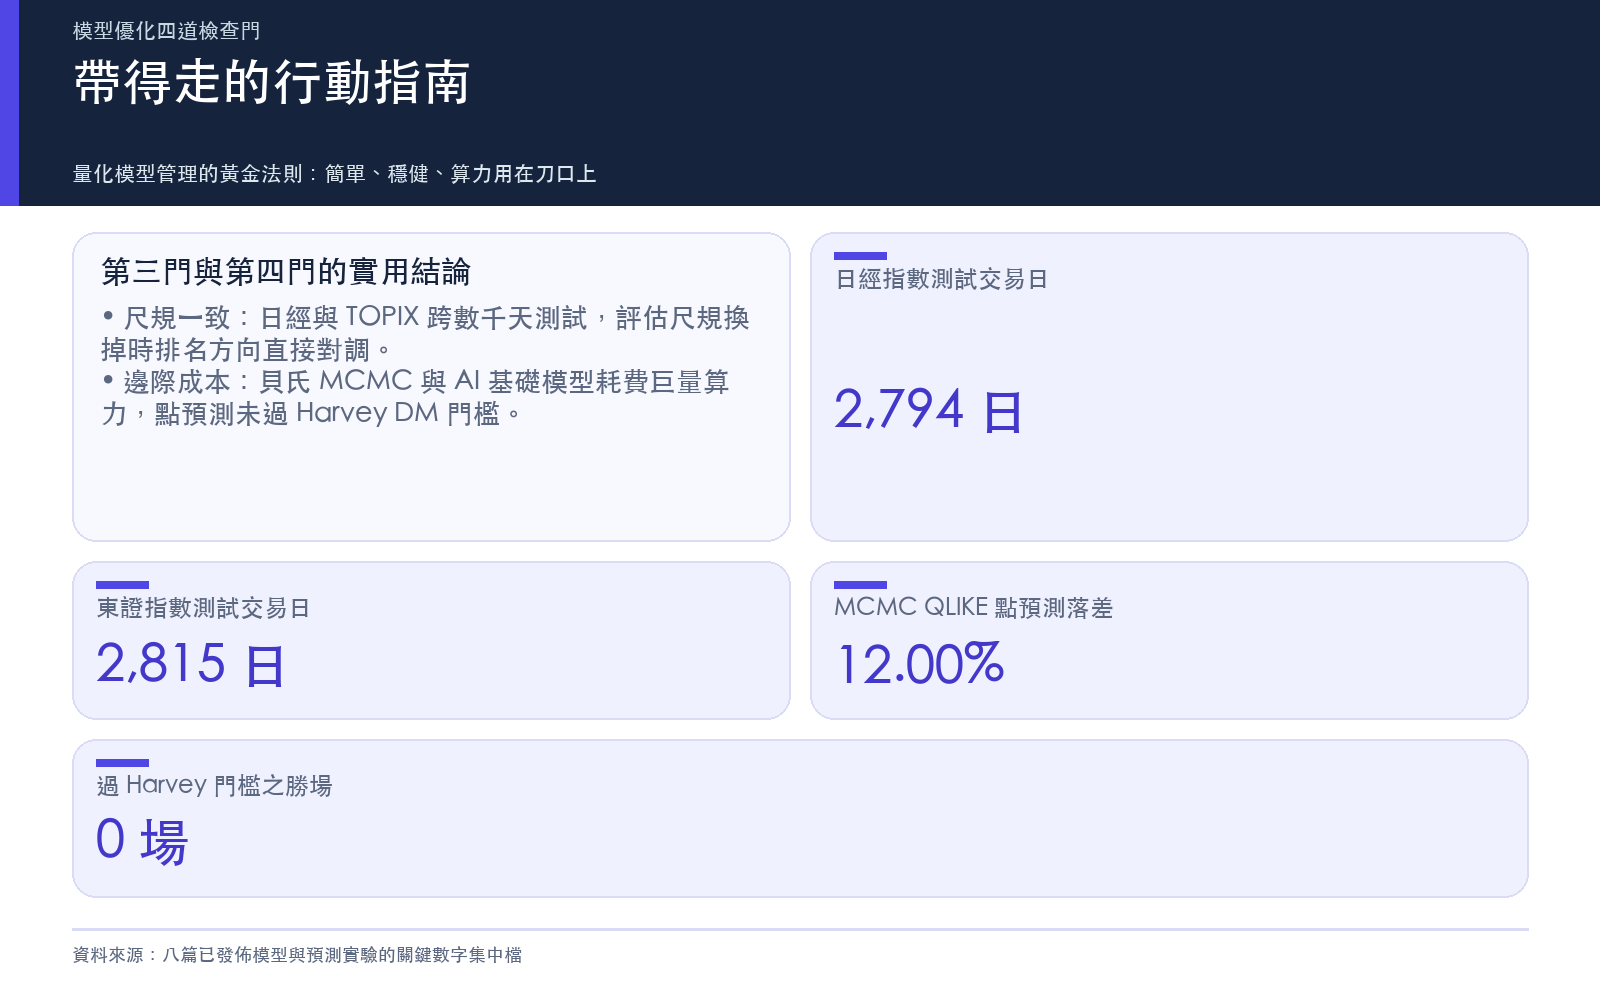
在 〈同一組預測,兩把尺指向相反方向:K1718 日本波動六格 NULL 的損失函數依賴性〉 裡,我們拿日經 225 指數(^N225,2,794 個交易日)與 TOPIX ETF(1306.T,2,815 個交易日)的數據,測試美股恐慌指數是否對日股具備增量預測力。
實驗揭示了一個極其關鍵的計量現象: 在完全相同的同一組預測值上,採用 Clark-West(基於均方誤差 MSE)與 Patton QLIKE 這兩把不同物理意義的評估尺規時,有兩格預測給出了方向完全相反的統計訊號!
- 用 MSE 評估時,模型 A 看起來顯著優於模型 B;
- 換成 QLIKE 評估時,模型 B 卻反過來逆襲勝過模型 A。
為什麼會這樣?因為 MSE 採用平方誤差,對極端大波動高度敏感,且假設預測誤差的代價是對稱的;而 QLIKE 則是基於對數似然率導出的非對稱損失函數,專門懲罰「低估波動率」的危險行為(在風險管理中,低估波動往往比高估波動代價更高)。
如果你在研發時只看 MSE,你可能會選出一個極度害怕少數離群值、但在日常平靜期表現糟糕的模型;而如果你只看 QLIKE,你的選擇又會完全不同。
第三門的判決:評估量化模型時,絕對不能依賴單一的通用純量(如純 MSE 或 R²)。你必須同時在物理意義明確的非對稱損失函數(如 Patton QLIKE)與風險控制尺規下進行交叉驗證。如果換一把尺排名就對調,說明該模型的優勢並不穩健。
第四門:邊際成本門,巨額算力換來的些微提升,真的划算嗎?
最後,隨著 AI 與進階統計學的流行,越來越多團隊開始導入深度學習與貝氏抽樣。但在投入龐大算力與維護成本前,你必須問最後一個問題: 它換來的增量,是否跨過了 嚴格統計 統計顯著性門檻?
在 〈AI 圈的「時序基礎模型」搬進波動率擂台:老公式 HAR 沒被打下來〉 裡,我們將 Google 的 TimesFM 與 IBM 的 TTM 這類最新的「時序基礎模型(Time-Series Foundation Models)」搬進波動率預測擂台。跨美股(SPY)、台股(0050)與台指期(TX)近十年、超過 7,000 個逐日預測 的實戰顯示:
- 直接 Zero-Shot 裸用的 AI 基礎模型,預測誤差在三個市場全數落後給傳統 HAR-A 老公式 ;
- 經過複雜事後校準或與 HAR 組隊後,AI 模型追平了成績,但 依然沒有超越簡單的 HAR-A ;
- 為了維護深度學習模型所付出的算力與 API 成本,換來的淨勝場數為 0 。
同樣的現象也發生在貝氏統計上。在 〈用貝氏 MCMC 重新估計 GJR-GARCH,預測精度真的更好嗎?SPY 20 年資料給出意外答案〉 裡,我們拿 SPY 長達 20 年的日報酬資料,分別用傳統最大概似法(MLE)與貝氏 MCMC(馬可夫鏈蒙地卡羅)重新估計 GJR-GARCH 模型。
結果顯示:在點預測精度上,MLE 的 QLIKE 點排名依舊保持第一;貝氏最佳變體(Median)的 QLIKE 評分略差 0.12%,且 差距完全沒有跨過 嚴格統計 調整的 t > 3 嚴格統計門檻 。耗費了幾十倍的 MCMC 抽樣算力與數個小時的計算時間,在下一天的點預測精度上沒有換到任何顯著的好處(儘管貝氏法在輸出區間不確定性時仍有其理論價值)。
第四門的判決:算力與演算法的複雜度不是炫技的資本。如果一個耗費重金運行的 AI 基礎模型或貝氏抽樣,在樣本外的 嚴格統計-DM 檢定中無法帶來統計顯著的突破,那麼在實戰中維持輕量、簡潔且可解釋的 Baseline 才是最明智的工程選擇。
總結:把四道檢查門套回你的交易系統
將這四道檢查門整理成綜合評估矩陣,你的模型庫應該長這樣:
| 實證案例 | 新模型/機制名稱 | 測試樣本規模 | 實證結果 | 檢查門判決 |
|---|---|---|---|---|
| K431 / K1819 | 多重碎形 / STGARCH 平滑切換 | 9,351 筆 OOS / SPY 502 日 | 全數輸給 3 參數 HAR-RV 與老派 GJR-GARCH | 卡在第一門(基準比較門) :複雜機制未展現增量勝場 |
| K1598 / K1745 | Conformal 線上混合 / 係數每日漂移的 HAR | 12 檔 ETF 2,633 日 / SPY 與 0050 兩市場 × 兩把尺 | 96 區間僅 1 勝 / 四格輸三格,唯一正格不在事前登記的量尺 | 卡在第二門(權重穩定門) :多出來的適應性沒有換到樣本外勝場 |
| K1718 | 日本波動率預測 (MSE vs QLIKE) | 日經225 2,794 日 / TOPIX 2,815 日 | MSE 與 QLIKE 給出完全相反的統計訊號 | 卡在第三門(尺規一致門) :評估尺規改變導致排名翻轉 |
| K1378 / K1820 | 深度 AI 時序基礎模型 / 貝氏 MCMC | 7,000+ 日預測 / SPY 20 年數據 | 點預測未打贏 HAR-A;MCMC 評分未過 嚴格統計 門檻 | 卡在第四門(邊際成本門) :高額算力未換來統計顯著提升 |
量化研究的樂趣在於探索未知,但交易系統的生命線在於控制脆弱性。
下次當你忍不住想為交易系統添加最新潮的 AI 模型或動態機制時,請先把這四道檢查門跑一遍。多數時候,你會發現系統給出的最佳解答是: 「保持簡單,把算力留給真正具備統計顯著性的增量訊號。」
本期精選
- 〈讓模型的權重每天自己漂移,隔天的波動會更好猜嗎?四格對戰輸掉三格,唯一贏的那格不能算〉(2026-08-18)— SPY 與 0050 兩市場、兩把尺的四格對戰,係數每日漂移的版本輸三格,唯一正格落在非事前登記的量尺,第二門典型案例。
- 〈把四成六的樣本還回來之後,MCS 才淘汰得掉一個模型〉(2026-08-18)— 補齊 46% 歷史樣本後,MCS 在 8 個模型中僅淘汰 1 個,證明 Baseline 模型普遍具備強大生命力。
- 〈把市場拆成四層開關:贏了兩狀態切換,也贏了教科書模型,卻沒贏過一行老公式〉(2026-08-16)— 跨 5 檔資產 9,351 筆逐日預測,四層開關碎形模型全數未超越 3 參數 Baseline。
- 〈同一組預測,兩把尺指向相反方向:K1718 日本波動六格 NULL 的損失函數依賴性〉(2026-08-14)— 日經 225 跨 2,794 日實測,MSE 與 QLIKE 兩把尺給出相反方向訊號,第三門核心教材。
- 〈K1598:universal-portfolio 式線上 conformal 混合,96 個 DM 檢定只留下一個嚴格勝場〉(2026-08-09)— 12 檔 ETF 2,633 樣本外日,96 個 DM 檢定經 Holm 校正後僅留 1 勝場。
- 〈AI 圈的「時序基礎模型」搬進波動率擂台:老公式 HAR 沒被打下來〉(2026-07-27)— 跨三市場 7,000+ 筆預測,TimesFM 與 TTM 零樣本 AI 模型未打贏傳統 HAR-A。
- 〈把 GARCH 改聰明反而更笨:3 種 STGARCH 在 SPY 上全輸給老派 GJR〉(2026-06-16)— SPY 502 個 OOS 日對決,3 種平滑切換 STGARCH QLIKE 評分全數輸給老派 GJR-GARCH。
- 〈用貝氏 MCMC 重新估計 GJR-GARCH,預測精度真的更好嗎?SPY 20 年資料給出意外答案〉(2026-05-24)— 20 年 SPY 日數據實測,貝氏 MCMC 點預測未過 嚴格統計 DM 門檻,第四門實證標桿。
2026-09-15 更正說明:第二門的案例描述有誤
本文初版在第二門與總結表,把〈讓模型的權重每天自己漂移〉那篇研究寫成了另一件事,並掛錯實驗編號。對照該篇原文與它的實驗檔 experiments/K1745/K1745_results.json 後更正如下:
| 項目 | 本文初版的說法 | 實際情況 |
|---|---|---|
| 實驗編號 | K1830 | K1745 (時變參數 HAR 對固定係數 HAR)。K1830 是推論降價後應用層軟體的已實現波動分解,與本文主題無關,而且本文發佈時它還不存在 |
| 比的是什麼 | 線上 Conformal 混合、指數加權動態權重,對上固定等權重 | 同一條 HAR 預測式的係數每天漂移,對上每天用整段歷史重估的固定係數,沒有模型之間的等權重 |
| 戰場 | SPY、QQQ、TLT、GLD 四個資產 | 美股 SPY、台股 0050 兩個市場,各用主要與次要兩把尺,合計四格 |
| 唯一的正格 | GLD,且檢定不顯著 | 台股 0050 的次要量尺;那把尺不是事前登記的主要量尺,而且該篇研究對這組比較沒有可用的正式檢定,所以本文也不再引用任何顯著性 |
| 結論 | 等權重勝出 | 會漂移的版本四格輸三格,兩個市場在主要量尺上都是固定係數版本較好 |
「四格輸三格、第二門的判決」這個結論方向不變,改的是案例本身的描述。K1598 那一半(12 檔 ETF、96 個檢定僅一個勝場)核對無誤,未更動。下方懶人包第二張圖已依本節重製,原本沿用初版說法的那一列已改成與上方總結表一致的敘述。
懶人包圖組