空氣污染、票房冠軍、SEC 訴訟名單——我們拿十二個市場外的訊號預測波動率
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
有一篇正經的經濟學論文說,紐約的空氣品質會影響當地交易員的情緒,進而影響他們當天的決策。這不是都市傳說,是刊在美國國家經濟研究局工作論文系列裡的研究。
如果情緒真的被空氣推著走,那空氣品質應該多少能告訴我們一點市場當天會有多顛簸。這個推論看起來很順。
我們去查了美國環保署的每日空氣品質資料,抓紐約五個郡從 2018 到 2025 年的細懸浮微粒濃度,跟標普 500 ETF 的日波動放在一起測。
結果是零。不是「效果很小」,是在我們預先設定的每一個預測期長度上,它都沒有讓預測變得更準。污染高的日子跟污染低的日子,波動的差異也撐不起任何一個檢定。
這只是十二次裡的一次。
十個不相干的領域,同一個答案
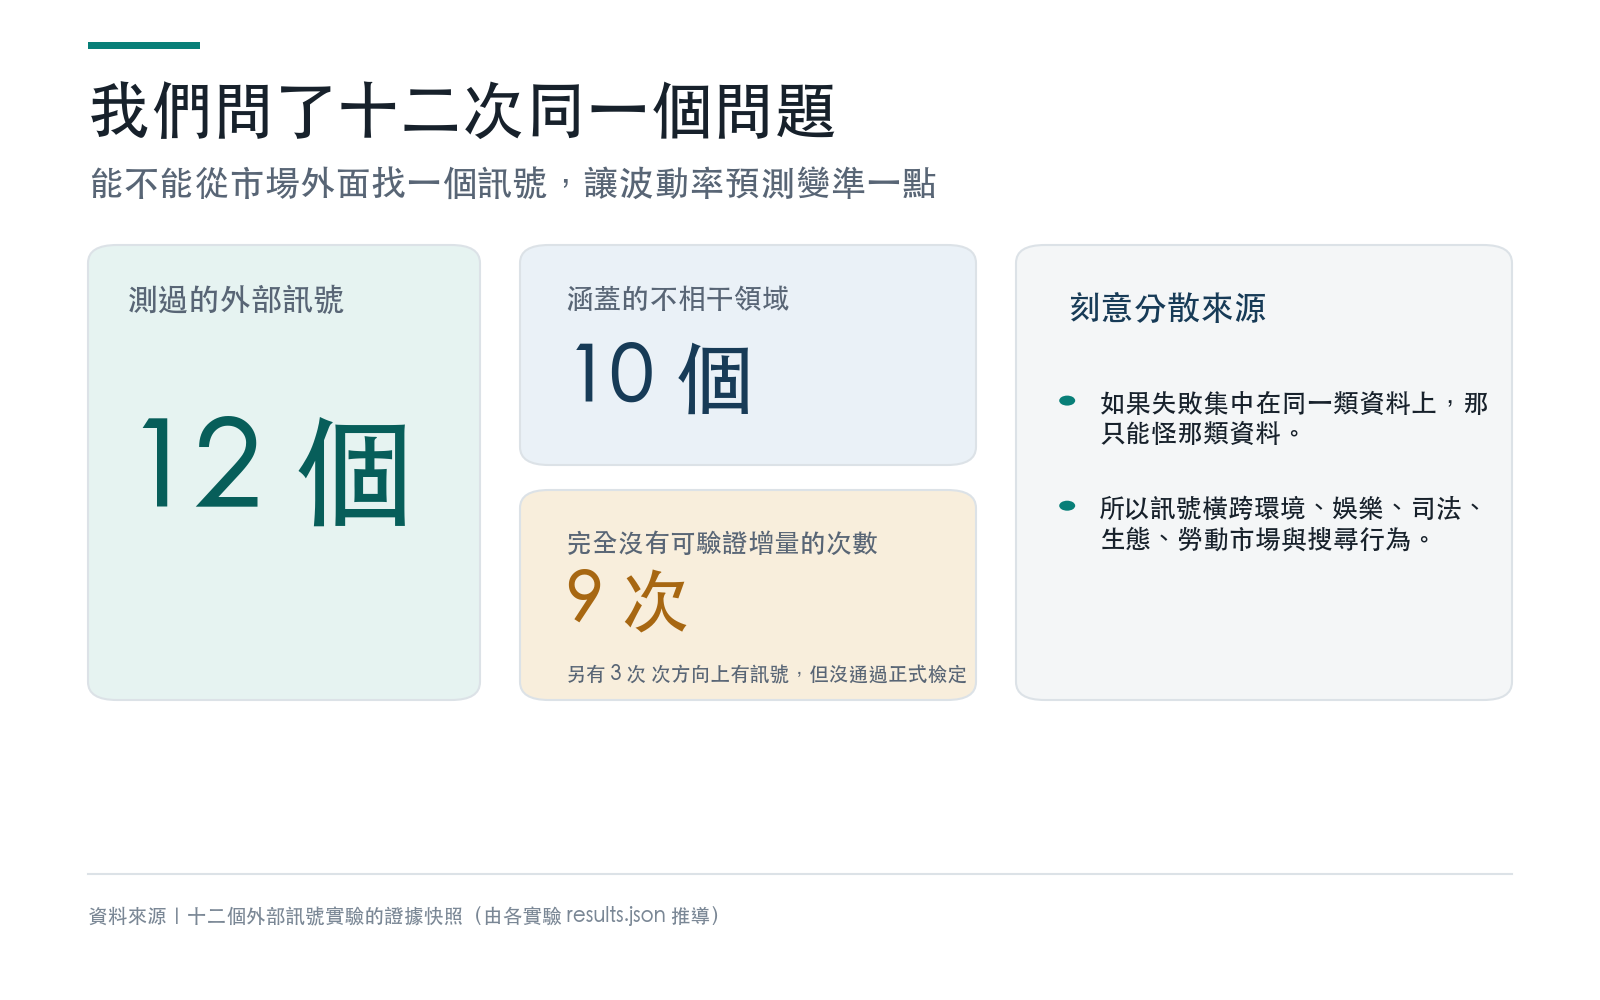
過去大半年,這個平台陸陸續續問了十二個形狀相同的問題: 能不能從市場外面找一個訊號,讓波動率預測變準一點?
其中大部分我們當時就單獨寫過,票房那次、空氣污染那次、搜尋熱度那次,各自有各自的報告。這篇要做的是把它們放在同一張桌子上,因為單獨看每一次都只是「這個沒用」,十二次擺在一起才看得出別的東西。
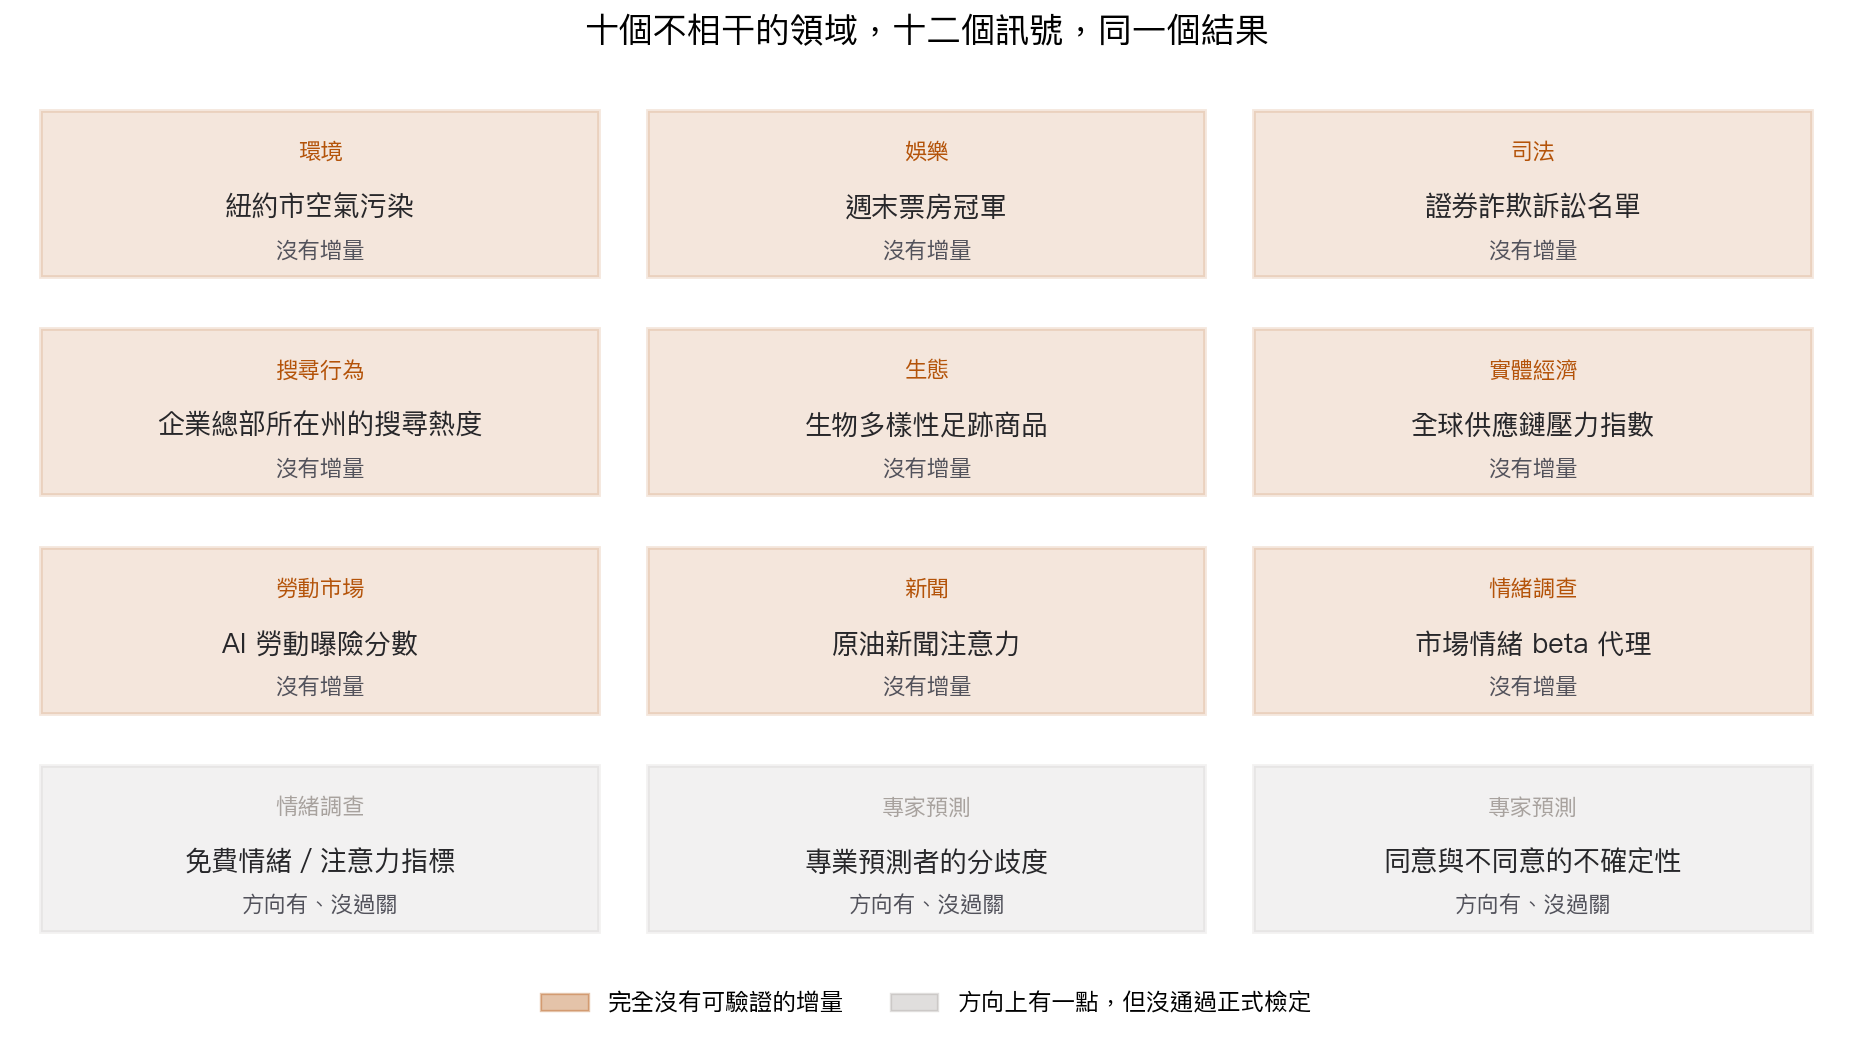
訊號的來源刻意分散,因為如果失敗集中在同一類資料上,那只能怪那類資料。實際測過的包括:
- 週末票房冠軍的賣座程度(娛樂)
- 美國證管會證券詐欺訴訟點名的股票(司法)
- 公司總部所在州對自家品牌的搜尋熱度(搜尋行為)
- 紐約市的空氣污染(環境)
- 生物多樣性足跡較高的農產品商品(生態)
- 紐約聯準銀行的全球供應鏈壓力指數(實體經濟)
- 產業受人工智慧衝擊的曝險分數(勞動市場)
- 原油相關新聞的曝光量(新聞)
- 幾種免費的投資人情緒與注意力指標(情緒調查)
- 專業預測機構彼此的分歧程度(專家預測)
這些領域彼此沒有關係。空氣污染跟票房冠軍之間唯一的共通點,是它們都不是市場自己產生的資料。
十二次裡,九次完全沒有可驗證的增量。剩下三次方向上有一點東西,但沒有一個通過正式的統計關卡,這三次我們也不打算說成成功,方向對而檢定不過,跟沒有是兩回事,但離「找到訊號」還很遠。
幾個具體的數字:供應鏈壓力指數對原油與農產品 ETF 下個月波動的預測,在 101 個月的樣本上,係數的 p 值分別是 0.328 和 0.667。票房那一組跑了 1,098 個週末、96 次賣座衝擊,標普報酬的檢定統計量是 -0.90,而我們事前設的門檻是 3。訴訟名單那組建了一個 19 萬列、250 檔個股的面板,八個預先宣告的檢定格子,通過的是零個。搜尋熱度那組四個目標,通過嚴格檢定的也是零個。
樣本都不小,門檻都是事前訂的,方向也都試過正反兩面。答案一致得有點單調。
有用的那個訊號,一直在市場自己身上
到這裡為止,故事聽起來像是「波動率就是預測不了」。那會是個錯誤的結論,而且我們手上就有反證。
在同一套模型架構下,我們比較過幾種設定:一種只用過去的波動資訊,另一種在此之上加進 VIX——也就是選擇權市場對未來三十天波動的定價。
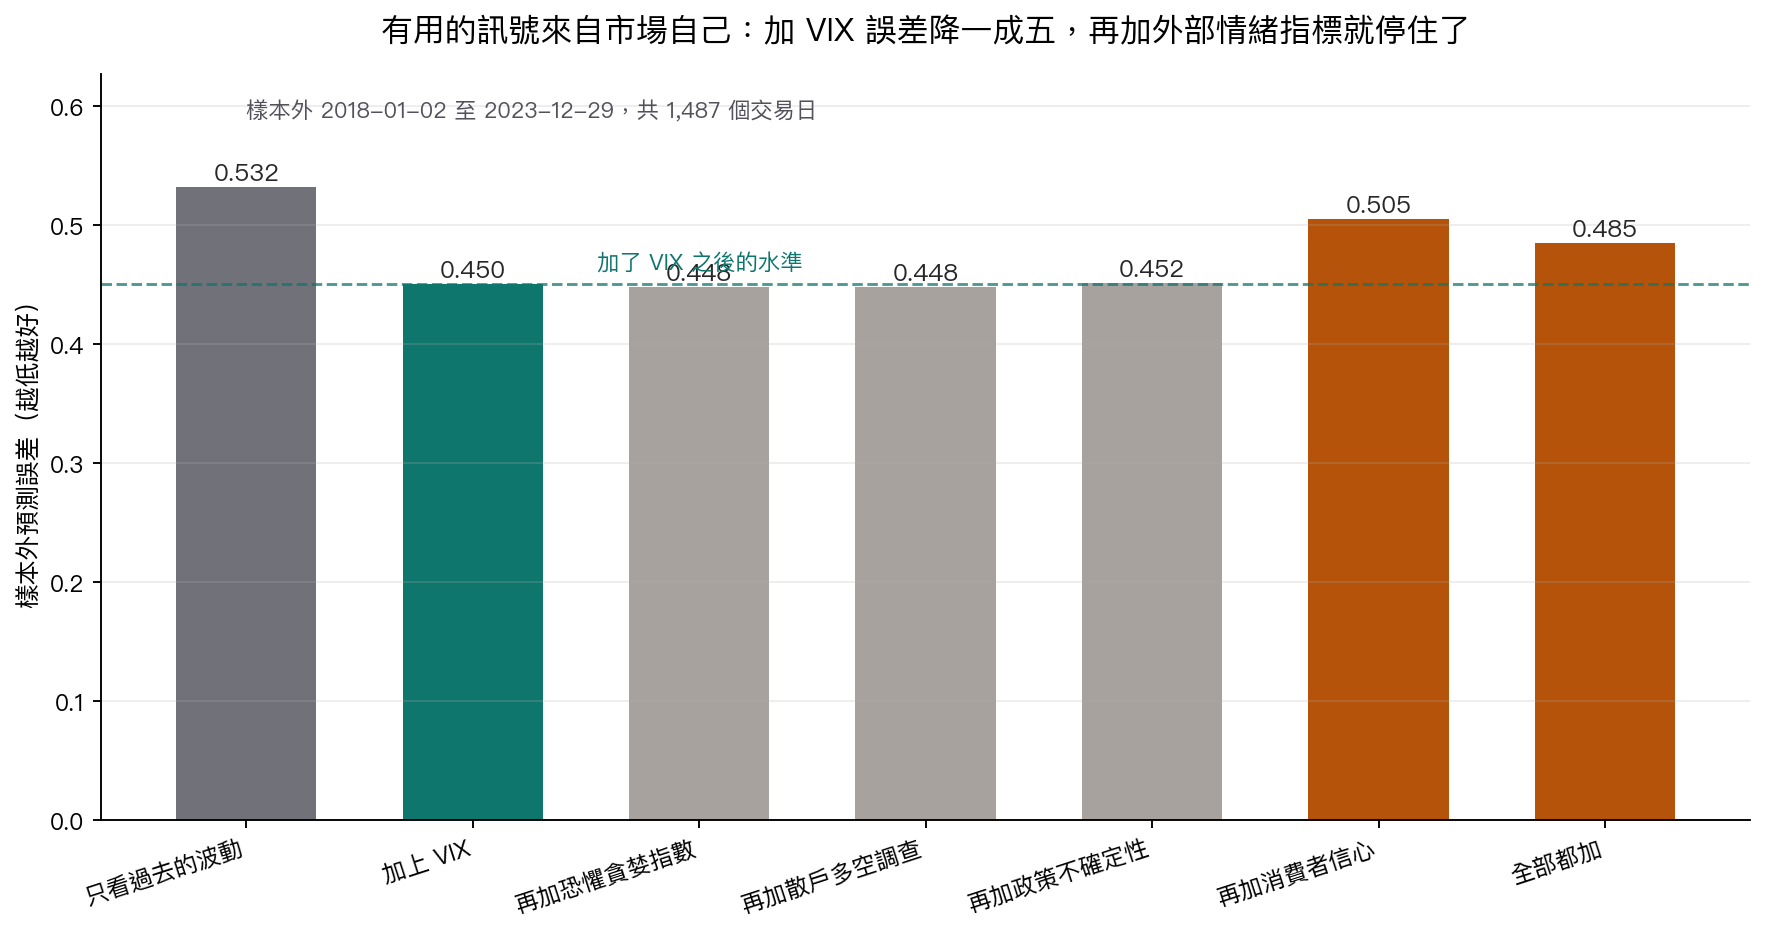
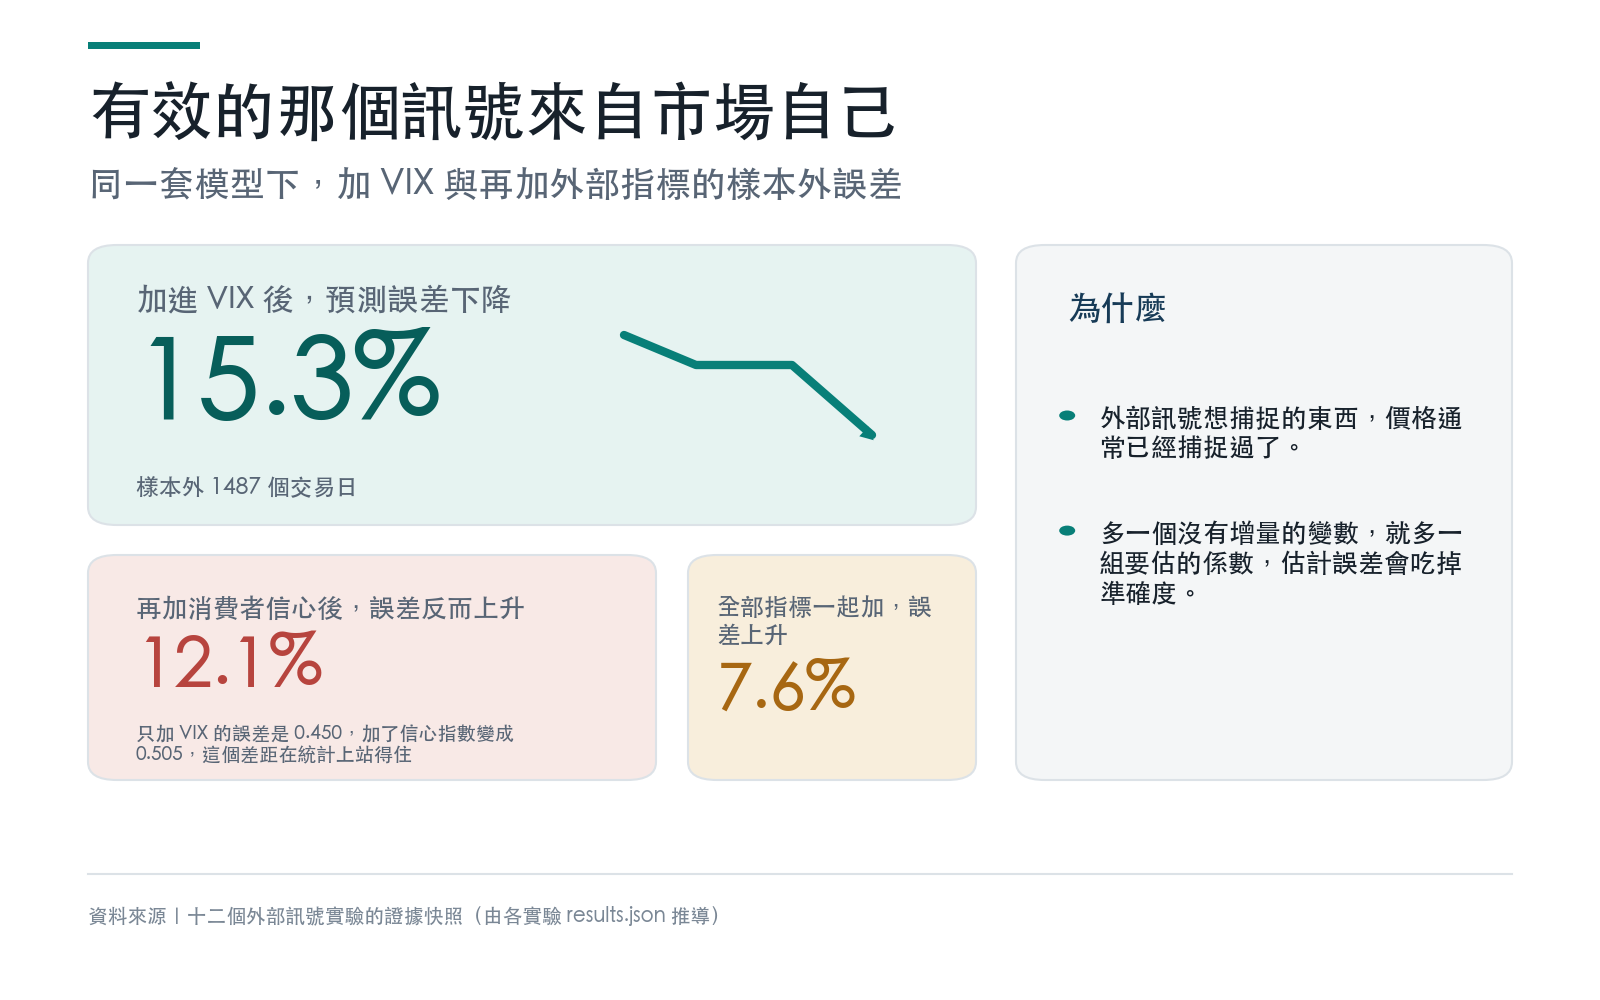
樣本外從 2018 年初測到 2023 年底,總共 1,487 個交易日。只看過去波動的版本,預測誤差是 0.532;加進 VIX 之後降到 0.450。少了大約一成五。
這是一個明確、可重現、幅度不小的改善。所以問題從來不是「波動不可預測」。
真正的問題是 再往上加東西會發生什麼 。我們在「已經有 VIX」的基礎上,依序加進恐懼貪婪指數、散戶多空調查、政策不確定性指數、消費者信心指數,以及全部一起加。
結果分成兩種,兩種都不是好消息。
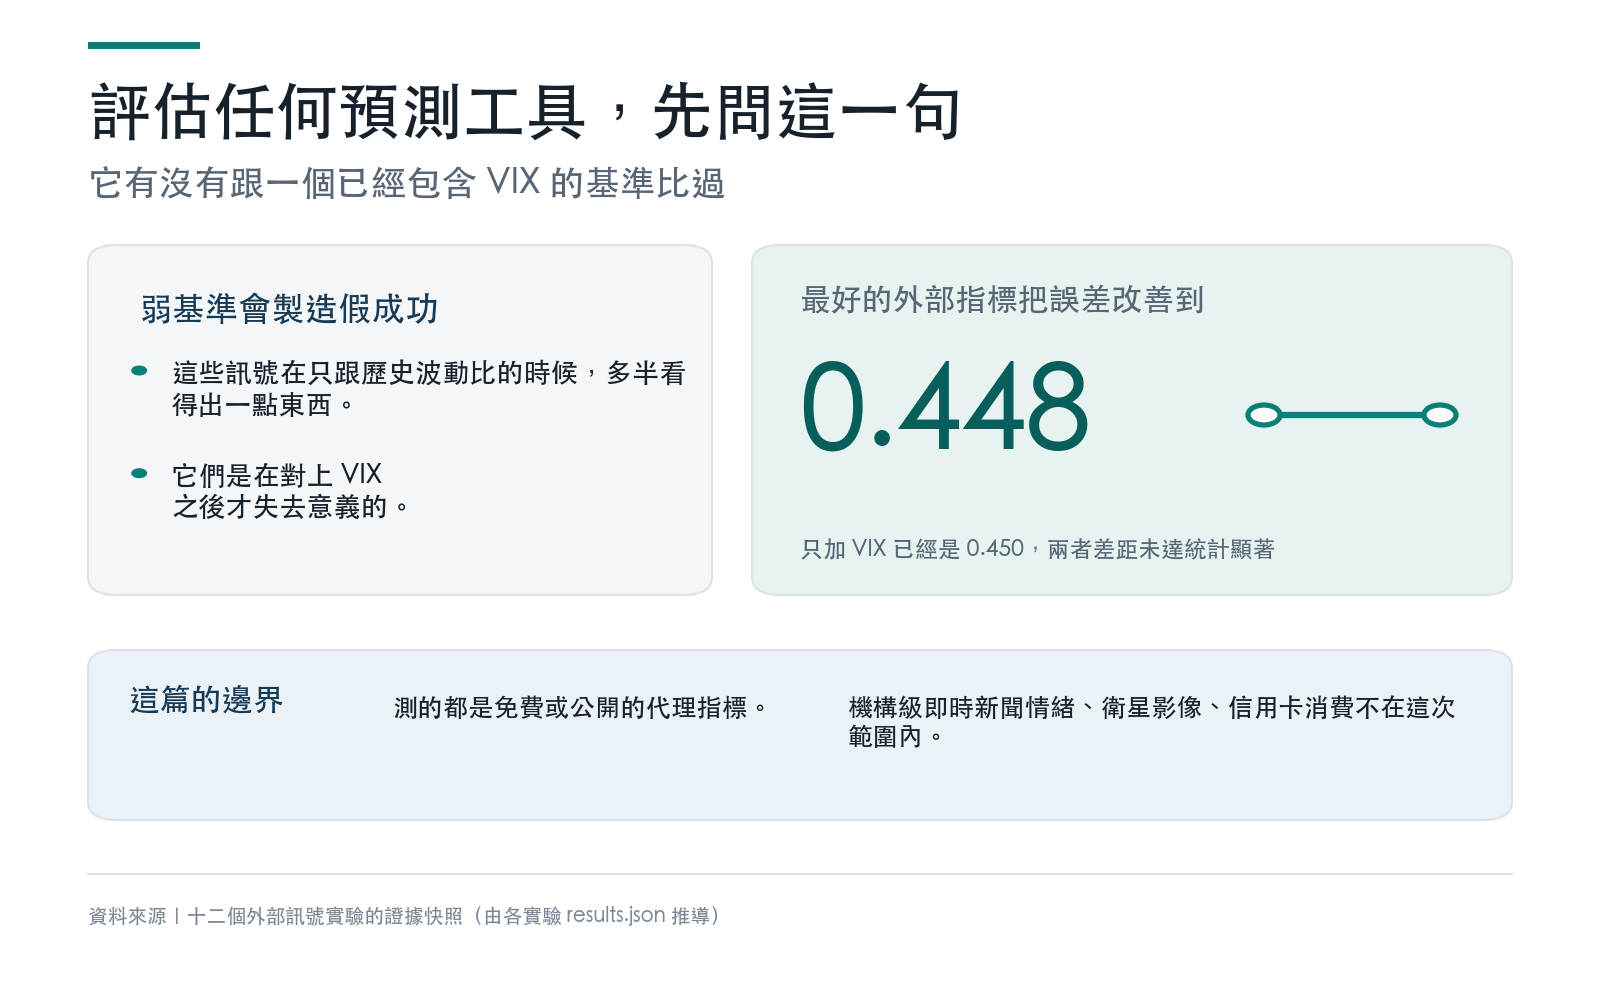
第一種是加了等於沒加。恐懼貪婪指數把誤差從 0.450 挪到 0.448,散戶調查也是 0.448,政策不確定性反而變成 0.452。用兩個模型比較的正式檢定去看,這幾個差異的 p 值分別是 0.679、0.515、0.762——連接近顯著都談不上。它們在 VIX 已經說完話之後,沒有補充任何東西。
第二種比較難堪:加了會變差,而且是統計上站得住的變差。消費者信心指數把誤差從 0.450 推到 0.505,惡化超過一成,p 值 0.0002。把所有指標一起塞進去,誤差變成 0.485,同樣顯著地比只加 VIX 差。
換句話說,在一個已經包含 VIX 的模型裡,多塞一個看起來合理的外部指標,最好的情況是浪費,最壞的情況是主動把預測弄壞。
為什麼會這樣
一個合理的解釋是:這些外部訊號想捕捉的東西,市場已經捕捉過了。
空氣污染如果真的影響交易員情緒,那個情緒會表現在他們的報價上;供應鏈壓力如果真的會讓能源股更顛簸,買選擇權避險的人會先把它買進權利金裡。等我們從外面拿到那份資料的時候,價格裡通常已經有了。
VIX 之所以有效,是因為它本身就是一群拿真錢下注的人對未來波動開出的價。沒有人從外面觀測它,它把無數條我們想不到、也拿不到的資訊壓縮成一個數字。
這也解釋了為什麼多加指標會讓結果變差。模型的參數量是有成本的:多一個沒有增量資訊的變數,就多一組要從有限樣本裡估出來的係數,估計誤差會吃掉原本的準確度。消費者信心那個例子特別清楚,它是月頻的調查資料,拿來預測日頻的波動,本來就隔了好幾層。
這對你的實際意義
如果你在評估任何一個號稱能預測市場波動的另類資料產品,有一個問題比「它的回測績效多好」更值得先問:
它有沒有跟一個已經包含 VIX 的基準比過?
我們這十二次測試裡,幾乎每一個訊號在「只跟歷史波動比」的時候都能看出一點東西。它們是在對上 VIX 之後才失去意義的。一個只跟弱基準比較的漂亮結果,說明的可能只是那個基準太弱。
這不是說另類資料沒有價值。我們測的都是免費或公開的代理指標,衛星影像、信用卡消費、機構級的即時新聞情緒,這些我們沒測,不能替它們背書也不能替它們定罪。這篇的邊界很清楚: 在公開可得的範圍內,用外部世界的變數去改善日頻波動率預測,我們試了十二次,沒有一次成功。
對一般投資人來說,這其實是個省錢的消息。你不需要訂閱什麼特殊資料源才能知道市場接下來可能有多顛簸。那個數字每天都在,免費,而且到目前為止,我們還沒找到什麼東西能在它之外再多說一句話。
資料來源 :yfinance(ETF 與個股日頻價格)、美國環保署 AirData 每日細懸浮微粒、紐約聯準銀行全球供應鏈壓力指數、GDELT 新聞資料庫、費城聯準銀行專業預測者調查、聖路易聯準銀行 FRED 消費者信心指數、美國證管會訴訟公告、Wikimedia 公開瀏覽資料。各實驗的樣本期間、檢定設定與完整統計量存放於平台的實驗存檔,本文引用的每個數字都可回溯到對應的結果檔。
懶人包圖組