同一份資料、三種統計口徑:把 K1734 的九個檢定攤開來看
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
K1734 問的是新興市場 carry 的老敘事能不能拆開驗:左尾比較厚、恐慌時左尾放得更大、日圓走強是引爆點。那三段的答案已經另外寫過一篇給一般讀者。這篇要講的是另一件事,同一份資料,換一種統計口徑讀,接受清單就會變。
這不是修辭。K1734 的確認性檢定家族有九個成員,資料是 CEW 這檔新興市場貨幣籃子的 4313 個交易日。九個成員裡,如果只看各自的原始 p 值或拔靴區間,有一組結論;套上 Benjamini-Hochberg 的錯誤發現率控制之後,有三個掉出去。而樣本外那一段,同一個切分、同一組模型,換一個損失函數就從「拒絕虛無假設」變成「區間跨過零」。
九個成員,六個活下來
先看家族本身。alpha 設在 0.05,m 是九。
| 家族成員 | BH 校正後 p | 校正後是否拒絕虛無假設 |
|---|---|---|
| H1_semivardiff_cew | 0.0 | 是 |
| H2a_contemp_fxy | 0.0010 | 是 |
| H1_skew_cew | 0.0012 | 是 |
| H3_insample_hac_carry | 0.0015 | 是 |
| H1_skew_emlc | 0.0173 | 是 |
| H3_oos_cw_mse | 0.0226 | 是 |
| H2a_lead_logit_fxy | 0.4927 | 否 |
| H1_ampgap_cew | 0.7790 | 否 |
| H1_skew_spread | 0.9548 | 否 |
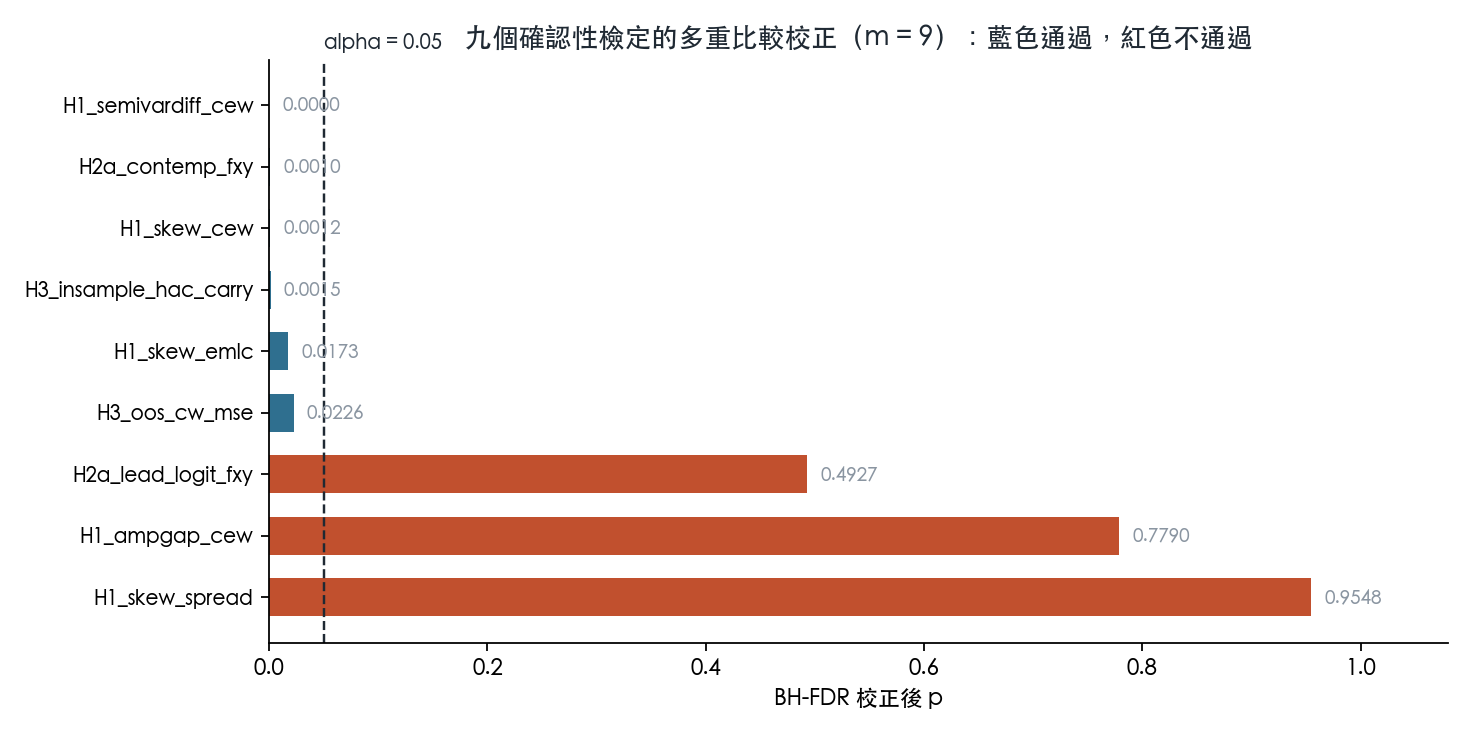
掉出去的三個各有各的成因,值得分開講。
H1_skew_spread 是代理變數不一致的那個。同樣量左尾厚度,CEW 的偏態是 -0.2952,EMLC 是 -0.8691,而 carry spread 這個構造出來的價差序列只有 -0.0205。前兩個的拔靴區間都不含零,第三個的 p 是 0.9548,離顯著很遠。三個代理變數量同一件事,兩個說有、一個說沒有,這種分歧在單一代理的報表上完全看不出來,只有把三個並列才會浮出來。
H2a_lead_logit_fxy 是方向就不對的那個。日圓 funding 假說要的是 FXY 走強會拉出隔天的左尾事件,但 FXY 的同期 HAC 係數是 0.0972,t 值 3.6818,符號跟 funding 故事要的相反;領先一期的 logit 係數則完全不顯著。這一段的正確說法是「在免費代理上識別不出來」,不是「證明不存在」,真實的槓桿部位資料本來就不在免費資料源裡。
H1_ampgap_cew 是這篇最需要小心的一個。
null 之前,先證明尺是活的
「恐慌時左尾放得更大」在 CEW 上的讀數是這樣:以落後一期的 VIX 二十為門檻切出高壓與平靜兩組,下行 ES 的放大倍數是 1.3520,上行是 1.3020,兩者相減的差是 0.0499,拔靴 95% 區間 [-0.1646, 0.2640],雙尾 p 為 0.6924。
點估計的方向是對的(下行放大得比上行多一點),區間卻寬到毫無意義。這時候有兩種可能:效果本來就很小,或者這支檢定在這個樣本數下根本沒有解析度。報表上這兩件事長得一模一樣,都是一個跨過零的區間。
K1734 的作法是注入一個已知效果再測一次:把高壓期的下行報酬幅度乘以 1.5 倍,其餘設定(seed 42、block 21、同一支配對區塊拔靴)一個字都不動,重跑。合成樣本上的放大差變成 0.7259,區間 [0.4226, 1.0327],不含零。
尺是活的。所以原本那個 null 是「效果小到測不出來」,不是「檢定沒有鑑別力」。這個區別決定了下一步該做什麼,前者的解法是換更長的樣本或更乾淨的高壓期定義,後者的解法是換一支檢定。沒有這個負對照,兩條路看起來一樣寬。
同一個切分,兩個損失函數,兩個判決
H3 問的是:把前一日的 unwind 幅度(cs_down,取負報酬的正值部分後 shift 一期)加進 HAR-RV,對 EEM 的日內已實現變異數有沒有增量預測力。
樣本內的答案很乾脆:cs_down 的 HAC t 值是 3.4101,p 為 0.0006,整條迴歸的 R² 是 0.1507。
樣本外才是重點。訓練 2156 天,測試 2130 天,切在 2018-01-02。同一組預測值,兩個讀法:
- Clark-West 巢狀 MSE 檢定:統計量 2.1691,單尾 p 為 0.0150。BH 校正後是 0.0226;就算把單尾 p 先加倍成雙尾再校正,也還有 0.0451,仍然落在 0.05 之內。
- QLIKE 損失差的條件式區塊拔靴:平均增益 0.0052,95% 區間 [-0.0092, 0.0187],雙尾 p 為 0.4744。區間穩穩地跨過零。
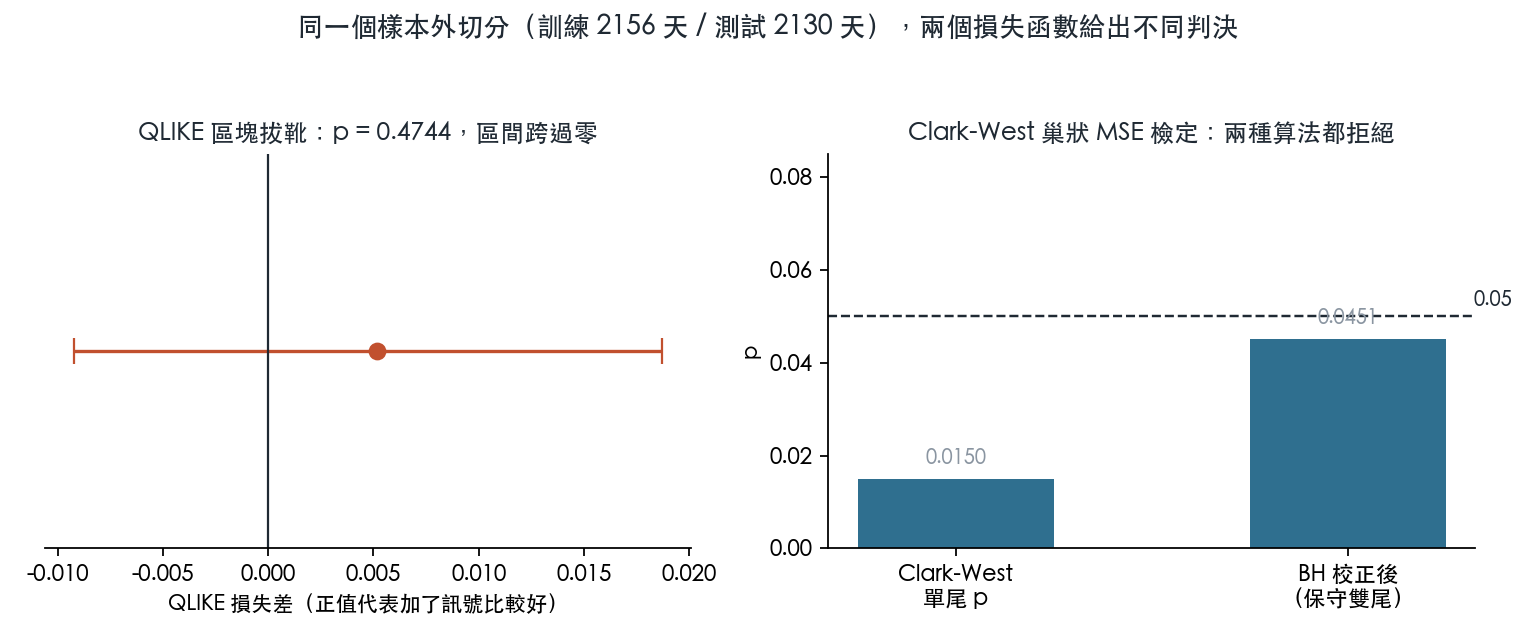
兩個都不是誤用。Clark-West 是為巢狀模型設計的,它承認增項在虛無假設下會帶進估計噪音並做了調整;QLIKE 拔靴問的是另一個問題,在這一條已經實現的損失差路徑上,平均增益能不能跟零區分開。前者問的是母體,後者問的是這一次切分。
所以答案取決於你問哪一句話。而兩句話的經濟意義都指向同一個方向:RMSE 改善 0.5326%,QLIKE 改善 1.3607%。統計上存在,交易上什麼都不是。
家族邊界不是自由參數
還有一件事必須寫進來,因為它是這份結果在第四輪對抗式審查裡被改過的地方。
H2 原本寫成一個析取式:日圓 funding 那一支成立,或是 risk-off 那一支成立,H2 就算通過。審查抓到的問題不是 risk-off 那六個檢定算錯了,而是「把它們算進確認性家族」這個決定本身是在看到擬合符號之後才做的,因子集合從第一版就在,但具名的符號規格與「視為確認性」的決定都出現在第四版。
於是那六個檢定被移出 verdicts 區塊,降級成探索性觀察,H2 的通過條件收斂成只看日圓那一支。這個改動會讓家族從十五個縮回九個,而縮小家族在 BH 之下是會讓 p 變小的,換句話說,這個「誠實的降級」在數學上剛好對自己有利。
K1734 的處理是把兩個版本都算出來:在那個不該用的十五成員家族下,H3_oos_cw_mse 的校正後 p 是 0.0226,保守雙尾版是 0.0451,兩個數字跟九成員家族下完全一樣,結論不變。降級沒有製造出 H3 的顯著性。
這一步不是形式主義。家族邊界是研究者自己畫的,畫得越小、通過的越多,而且過程中沒有任何程式會報錯。唯一能讓讀者檢查這條線畫得對不對的方式,就是把另一種畫法的數字也印出來。
這份資料留下的三條可搬走的規則
一,代理變數要並列,不要挑一個當主角。CEW 與 EMLC 都給出顯著的負偏態,carry spread 沒有;如果 K1734 只報主代理,這個分歧就永遠不會進到讀者眼前。
二,宣告 null 之前先跑一次注入已知效果的重測。跨過零的區間有兩種成因,報表上同一個樣子。
三,家族邊界改動之後,把改動前的算法一起印出來。降級自己的主張通常對統計結果有利,這種有利必須當場被看見。
三段敘事的結論本身寫在另一篇。這一篇想留下的是:同一份凍結的結果檔,換一把尺就換一組結論,而那把尺是誰選的、什麼時候選的,跟結論一樣需要被記錄。
資料與復現 :所有數字取自 experiments/k1734/K1734_results.json(生成於 2026-08-24,seed 42),該實驗目錄含 reproduce_spec.json 與 reproduce_report.json。本文圖表由 storage/drafts/K1734_research_charts.py 直接讀該結果檔繪製,不重算、不連網。