把 Fed 演講讀成一個分數,再拿去預測市場:12 個檢定沒有一個過,而最大的那個數字方向是反的
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
FOMC 開會那幾天,市場會動,這件事已經被測到爛了。但 Fed 官員一年講幾百場話,絕大多數不在會議那兩天,那些 會議之間 的發言,市場到底聽進去多少?
這個問題有它的道理。決議日是排定的,所有人都知道那天要看什麼;會議之間的演講不是,資訊如果真的從那裡漏出來,它應該比決議日更接近「意外」。學術上也有人主張,央行講話裡的 預測修正 內容(對 GDP、通膨、就業的看法變了沒)才是真正帶資訊的部分,而不是講了幾次、講了多長。
我們把這件事做成一個可以檢定的問題: 用 Fed 官網的演講全文,建一個透明的預測修正分數,看它能不能對隔天與未來五天的波動、以及左尾事件,提供任何增量訊號。
答案是不能。而且失敗的方式比失敗本身有意思。
怎麼量的
資料是 Fed 理事會官網的演講全文,配上四檔標的:SPY(美股)、QQQ(科技股)、TLT(長天期美債)、IEF(中天期美債)。樣本從 2020-02-05 到 2026-06-22,SPY 隔日波動那組有 1,602 個交易日。
分數本身刻意做得很笨:用一份 透明的字典 去數演講裡與 GDP、通膨、勞動市場相關的措辭方向,合成一個預測修正衝擊值,再標準化。這不是論文裡那種多模態機器學習模型,就是一個任何人都能照著重做的代理指標。
時間對齊上我們把話說死,因為這是這類研究最容易出事的地方:演講日期先對到 下一個 可交易日,然後訊號再 shift(1),程式裡是 align_speech_signals() 建出的 *_z_l1 欄位,HAR 控制項同樣用 log_rv.shift(1)。 同一天的資訊完全不使用。 演講的發布時間我們沒有拿來用,不是忘了,是刻意保守:與其猜某場演講是盤前還是盤後,不如整體往後推一個交易日。
檢定用 HAC 標準誤(重疊的五日目標會製造序列相關),多重比較用 BH 校正。 發表門檻在跑之前就先寫死 :要宣稱有訊號,至少要有兩個主檢定同時滿足 HAC t ≥ 3(方向為正)且 BH q ≤ 0.05。隨機種子 42。
12 個格子,沒有一個過
四檔標的 × 三個目標(隔日波動、未來五日波動、未來五日左尾事件)= 12 個主檢定。
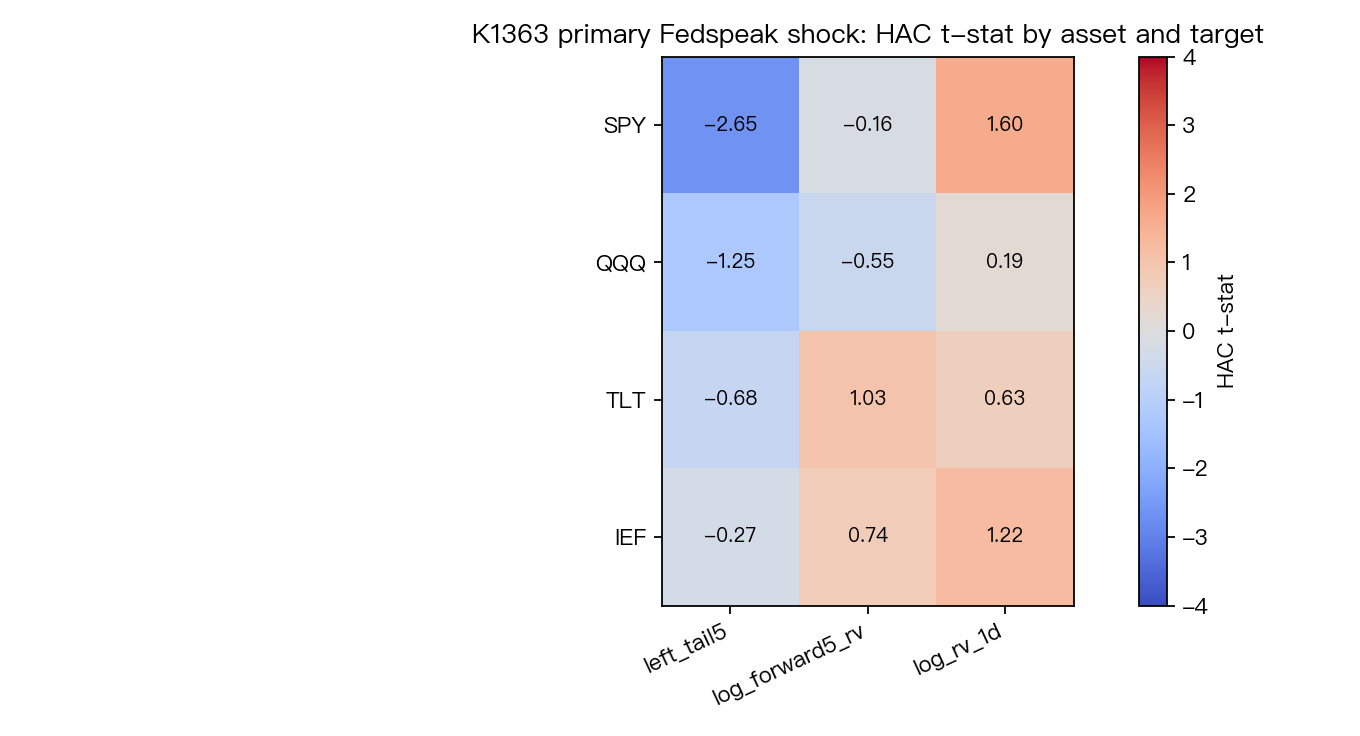
通過門檻的:0 個。 不只是「沒有兩個」,正向 t ≥ 3 的有 0 個,連取絕對值後 |t| ≥ 3 的也是 0 個。
最強的一格是 SPY 的隔日波動:訊號每上升一個標準差,對數波動增加 0.033,HAC t = 1.60,p = 0.109,BH 校正後 q = 0.654,R² = 0.142。第二強是 IEF 的隔日波動,t = 1.22、p = 0.222。
p = 0.109 這個數字值得停一下。它不是那種「差一點就過」的邊緣案例,它連未校正的 0.05 都沒到,而校正之後 q = 0.65,意思是在這樣的多重檢定裡看到這種強度的東西,本來就很常見。
最大的那個數字,方向是反的
熱圖裡絕對值最大的一格,是 SPY 的左尾事件: t = −2.65 。
負號的意思是: 預測修正衝擊越大的日子,接下來五天出現左尾事件的機率反而更低。 這跟出發時的假設相反,我們原本預期的是資訊衝擊推高尾部風險。
這個「反而」在四檔標的上方向一致(SPY −2.65、QQQ −1.25、TLT −0.68、IEF −0.27),看起來很像一個故事的開頭。 但它撐不起任何結論 ,理由有兩層:
第一,它沒有通過門檻。門檻是事前寫死的正向 t ≥ 3,而它連絕對值都只有 2.65。事後把門檻改成雙尾、或改成「方向相反也算發現」,就是拿結果去挑規則。
第二,也是更根本的:這個方向如果是真的,它的解釋反而更可疑,為什麼 Fed 官員講出更強的預測修正之後,市場的尾部風險會 下降 ?比起「講話安撫了市場」,更平凡的解釋是:這個字典分數在動盪期本來就比較容易給出高分(措辭更密集),而動盪期之後往往是回穩。這是共變不是因果,而我們沒有做能區分兩者的設計。
所以這一格我們只記錄,不解讀。
只挑訊號最強的 48 天,還是什麼都沒有
有人會問:整體沒訊號,會不會是被大量無聊的日子稀釋了?只看訊號真的很強的那幾天呢?
我們取正向訊號日的第 80 百分位當門檻(z = 3.148),得到 48 個「最強訊號日」,對照其餘 1,572 天:
| 標的 | 最強 48 天的未來五日波動均值 | 其餘 1,572 天 | Welch p |
|---|---|---|---|
| SPY | 0.000867 | 0.000826 | 0.880 |
| QQQ | 0.001425 | 0.001241 | 0.607 |
| TLT | 0.000570 | 0.000551 | 0.808 |
| IEF | 0.000120 | 0.000110 | 0.497 |
四個 p 值分別是 0.88、0.61、0.81、0.50。 沒有一個接近任何門檻。 方向上四檔都是「最強訊號日之後波動略高」,但幅度小到在雜訊裡看不出來。
左尾事件那一欄同樣要小心地講:SPY 在最強的 48 天裡,左尾發生率 2.08%,其餘日子 5.09%,看起來差了一倍多。 但 2.08% × 48 = 1 ——那 48 天裡總共只發生了 1 次 左尾事件。QQQ 與 TLT 各 2 次,IEF 3 次。
用個位數的事件去談機率減半,是這類研究最常見的自我欺騙。我們把數字放上來,是為了讓它自己說明為什麼不能用。
訊號和波動長得就不像
把訊號序列和 SPY 的前瞻五日波動疊在同一條時間軸上,這件事其實用看的就有感覺:
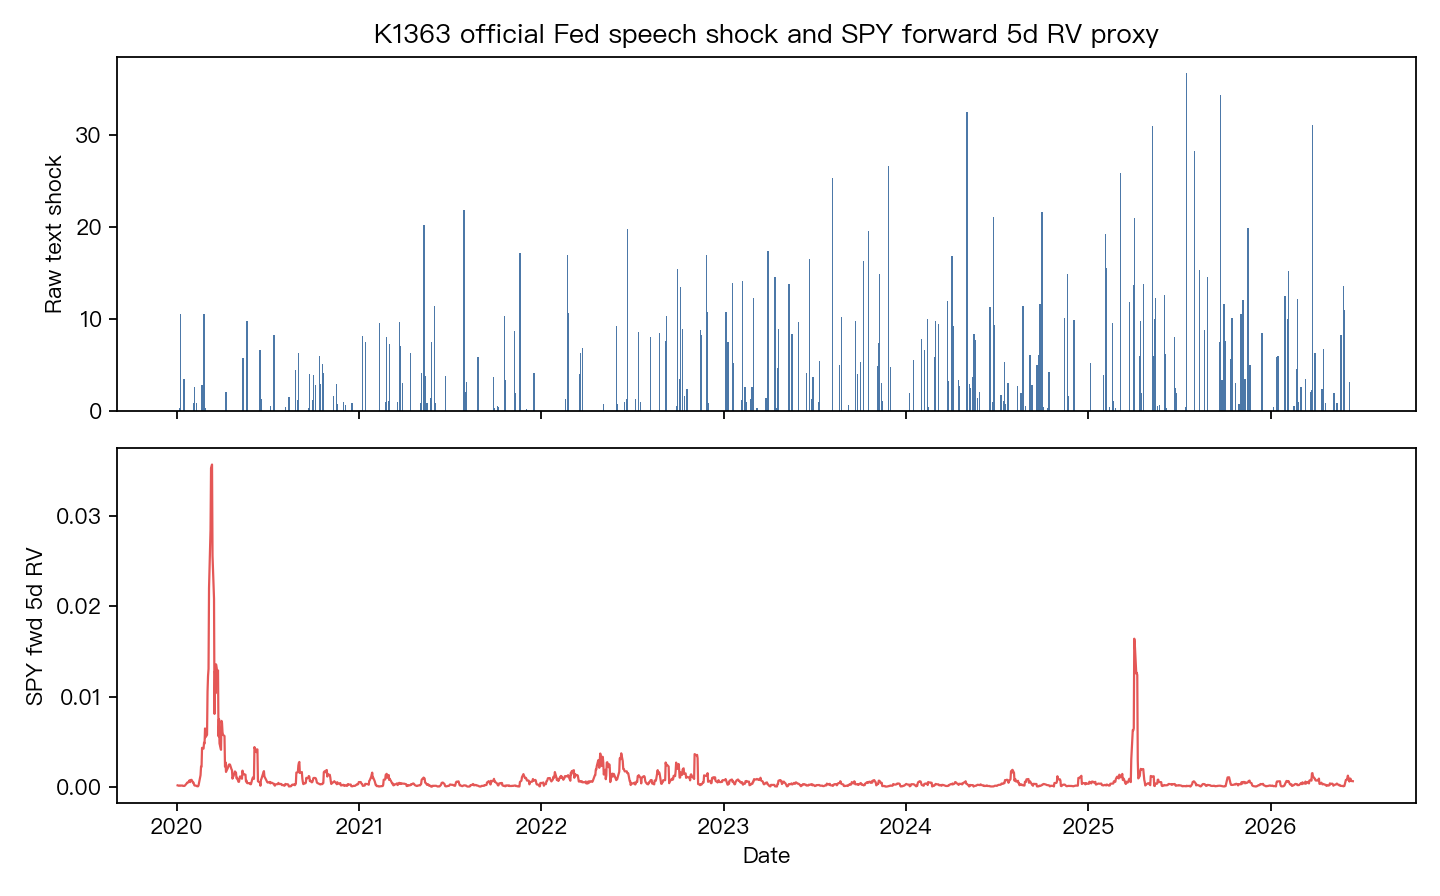
上半部是原始文字衝擊,尖峰在 2024 到 2026 之間越來越密、越來越高。下半部是 SPY 的前瞻五日波動,整段期間只有兩個明顯的大尖峰:2020 年初,以及 2025 年春季。
兩者的高點沒有對齊。 文字衝擊最猛的那幾年,正好是波動最平靜的那幾年。這張圖不能取代檢定,但它讓檢定的結果不那麼意外。
這個結果不能證明什麼
null result 最容易被過度延伸,所以這幾條要寫清楚,這些是實驗自己列的限制,不是事後找的台階:
- 語料不完整。 Fed 理事會官網的演講頁面不涵蓋所有地區聯準銀行總裁的發言,這不是一份完整的 FOMC 成員語料庫。
- 字典是代理,不是原模型。 我們用的是透明字典評分,不是文獻裡那種多模態機器學習的預測修正模型。 做不出訊號的是這個代理指標,不是「Fed 演講的資訊內容」這個假說本身。
- 日頻抓不到事件窗。 用日線 OHLCV 算的收盤對收盤波動代理,看不到高頻的事件窗反應;真正的反應如果只持續幾十分鐘,這個設計就是看不見。
- 五日目標重疊。 HAC 落後期設在五個交易日,緩解序列相關,但不等於做過非重疊穩健性檢查。
- 沒有用演講發布時間。 統一往後推一個交易日是保守處理,代價是可能錯過當天的即時反應。
換句話說: 這篇能說的是「用公開資料 + 透明字典做的簡單版本沒有訊號」,不能說「Fed 會議之間的講話對市場沒有影響」。 這兩句話的距離,正好是這個實驗沒有跨過的那段路。
那這篇的價值在哪
在於它把一條看起來很誘人的路走完了,並且留下了可以接手的座標。
用公開演講文本做波動率訊號,是那種聽起來一定有效的想法,央行講話當然重要,文本當然有資訊。但「重要」和「能在日頻資料上被一個透明字典抽出來、還能通過多重比較校正」之間,隔著好幾層。這個實驗量出了那幾層有多厚:最強的一格 p = 0.109,最大的一格方向還是反的。
下一個要試的人,至少知道兩件事:不要再從透明字典開始,以及日頻可能本來就是錯的解析度。