K1724:台股當沖比重加進 HAR,樣本內顯著、樣本外不顯著;Granger 方向則取決於已實現變異用哪一個估計量
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
一般讀者版〈當沖比重衝上五成,是市場要變盪的預告嗎?〉回答的是「當沖多了,波動會不會跟著來」。這篇處理研究者在用同一份資料時要先做的兩個決定: 當沖比重該不該加進台股的 HAR 波動預測模型,以及 Granger 檢定的方向是不是被已實現變異的估計量製造出來的。 K1724 的答案是:樣本內聯合檢定顯著,但樣本外的增量既小又不穩;「波動先行於當沖」在三種估計量下都成立,「當沖先行於波動」只有 Garman-Klass 撐得住。
資料與設定
- 當沖比重 :證交所 TWTB4U 當日沖銷交易統計,取當沖買進與賣出金額占市場比重的平均。
- 已實現變異 :台灣加權指數日線 OHLC。台股指數沒有免費的盤中資料,所以三個量尺都是日線代理:Garman-Klass(主設定)、Parkinson、收盤到收盤平方報酬。
- 樣本 :2935 個交易日,2014-06-30 至 2026-07-27,起點在現股當沖開放之後。
- 預測設定 :目標是隔日已實現變異(水準)。基準是 HAR,即已實現變異的日、週、月平均;加入模型再放進當沖比重的日、週、月平均,所有變數都只用到當日為止的資訊。擴張視窗,前 750 天只估計,之後逐日做一步預測,共 2163 個樣本外預測。
- 加入模型包住基準模型,所以樣本外的主要檢定是 Clark-West;DM 一併列出,但在巢狀比較下,虛無假設成立時它偏向不利於大模型。
樣本內顯著,樣本外的增量在 MSE 與 QLIKE 下方向相反
表一:主設定的樣本內與樣本外比較
| 量測 | 數值 | 檢定統計量 | p 值 |
|---|---|---|---|
| 樣本內:當沖三項聯合 Wald | 調整 R² 增加 0.0064 | 8.49 | 0.0369 |
| 樣本外:增量 R²(MSE) | 0.0029 | DM 0.53 | 0.5973 |
| 樣本外:平均 QLIKE(基準 → 加入當沖) | 0.3510 → 0.3595 | DM -1.49 | 0.1370 |
| 樣本外:Clark-West(巢狀,單尾) | — | 1.61 | 0.0542 |
樣本內,當沖的三個 HAR 項聯合顯著,Wald p = 0.0369,但調整 R² 只增加 0.0064。樣本外,用 MSE 量,加入當沖的模型增量 R² 為 0.0029;用 QLIKE 量,平均損失從 0.3510 升到 0.3595,反而變差。兩個 DM 統計量的符號相反,都不顯著。巢狀比較的正確檢定 Clark-West t = 1.61,單尾 p = 0.0542,落在 5% 門檻的邊上。
MSE 與 QLIKE 給出相反方向,本身就是資訊。 兩者都對已實現變異的量測誤差穩健,差別在權重:MSE 以水準計誤差,少數高波動日的大誤差主導總和;QLIKE 以比例計誤差,低波動日與高波動日權重相近。增量 R² 為正而 QLIKE 變差,與「當沖項在少數高波動日改善預測、在多數平常日小幅變差」這個形狀一致。本實驗沒有把損失依波動狀態拆開,這是讀法,不是檢定結果。
所以這是一個邊際的 null,不是「當沖比重沒有資訊」。 5% 下不能說加入模型在樣本外勝過 HAR;Clark-West 的 0.0542 也不夠強,不能反過來斷言增量為零。
增量的符號跟著設定走
表二:增量預測力在不同設定下
| 設定 | 樣本外增量 R² | DM(QLIKE) | p | 樣本內 Wald p |
|---|---|---|---|---|
| 主設定:Garman-Klass | 0.0029 | -1.49 | 0.1370 | 0.0369 |
| 加入當日絕對報酬與 log 成交量 | -0.0026 | -1.58 | 0.1147 | 0.0335 |
| 2020 年以前 | -0.0043 | -1.16 | 0.2451 | 0.0149 |
| 2020 年起 | 0.0203 | -1.17 | 0.2435 | 0.0651 |
| 改用 Parkinson | -0.0034 | -1.56 | 0.1179 | — |
| 改用平方報酬 | 0.0021 | -1.47 | 0.1411 | — |
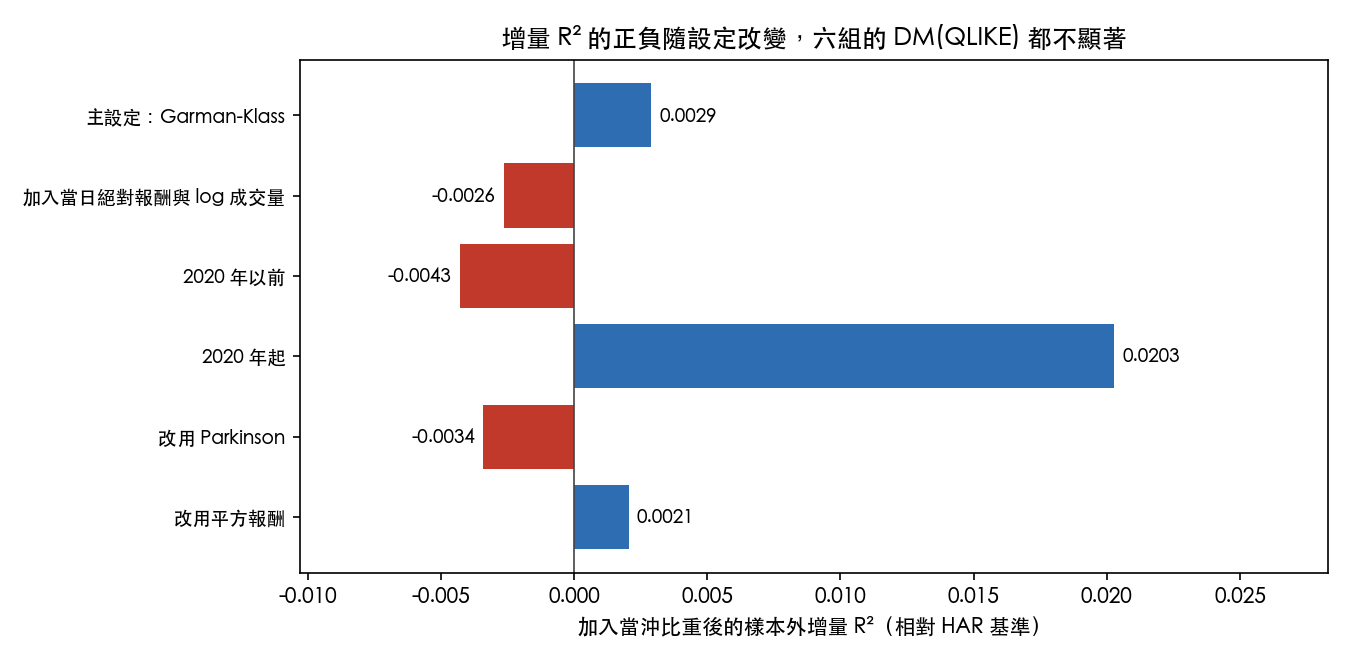
六組設定裡,增量 R² 三正三負,DM(QLIKE) 統計量全為負且都不顯著。兩個控制變數(當日絕對報酬、log 成交量)同時加進兩個模型後,增量轉負。
2020 年起的子期必須單獨看。 這一段的增量 R² 為 0.0203,是表中最大的,但 DM(QLIKE) p = 0.2435,樣本內 Wald p = 0.0651 反而不顯著。子期以各自樣本的一半作訓練,樣本外的天數比主設定少得多;在這個長度下,0.02 的 R² 差異與雜訊分不開。它可以當成一個要用更長樣本追蹤的假說,不能寫成「疫情後當沖開始有預測力」。
Granger 方向:只有一個方向對估計量穩健
Granger 用的是 VAR。平穩性檢定先決定變換:log 已實現變異的 ADF 拒絕單根、KPSS 卻拒絕平穩,結果混合;當沖比重水準的 ADF p = 0.3787,取一階差分。主設定用 log 已實現變異水準配當沖差分,落後期 AIC 選 16、BIC 選 7,採 AIC 的 16。為了排除定態與單根序列混用的疑慮,實驗再把兩個序列都差分重做一次。
表三:Granger 方向依已實現變異估計量而定
| 估計量 | 變異數轉換 | 落後期 | 當沖 → 波動 p | 波動 → 當沖 p |
|---|---|---|---|---|
| Garman-Klass | log 水準 | 16 | 0.000079 | 低於存檔精度 |
| Parkinson | log 水準 | — | 0.07481 | 低於存檔精度 |
| 平方報酬 | log 水準 | — | 0.3163 | 低於存檔精度 |
| Garman-Klass | log 差分 | 22 | 0.001232 | 低於存檔精度 |
| Parkinson | log 差分 | 24 | 0.1964 | 低於存檔精度 |
| 平方報酬 | log 差分 | 24 | 0.1152 | 低於存檔精度 |
p 值以六位小數存檔,「低於存檔精度」表示存檔值為零,也就是小於百萬分之零點五。Parkinson 與平方報酬在水準設定下的落後期沒有另外存檔。
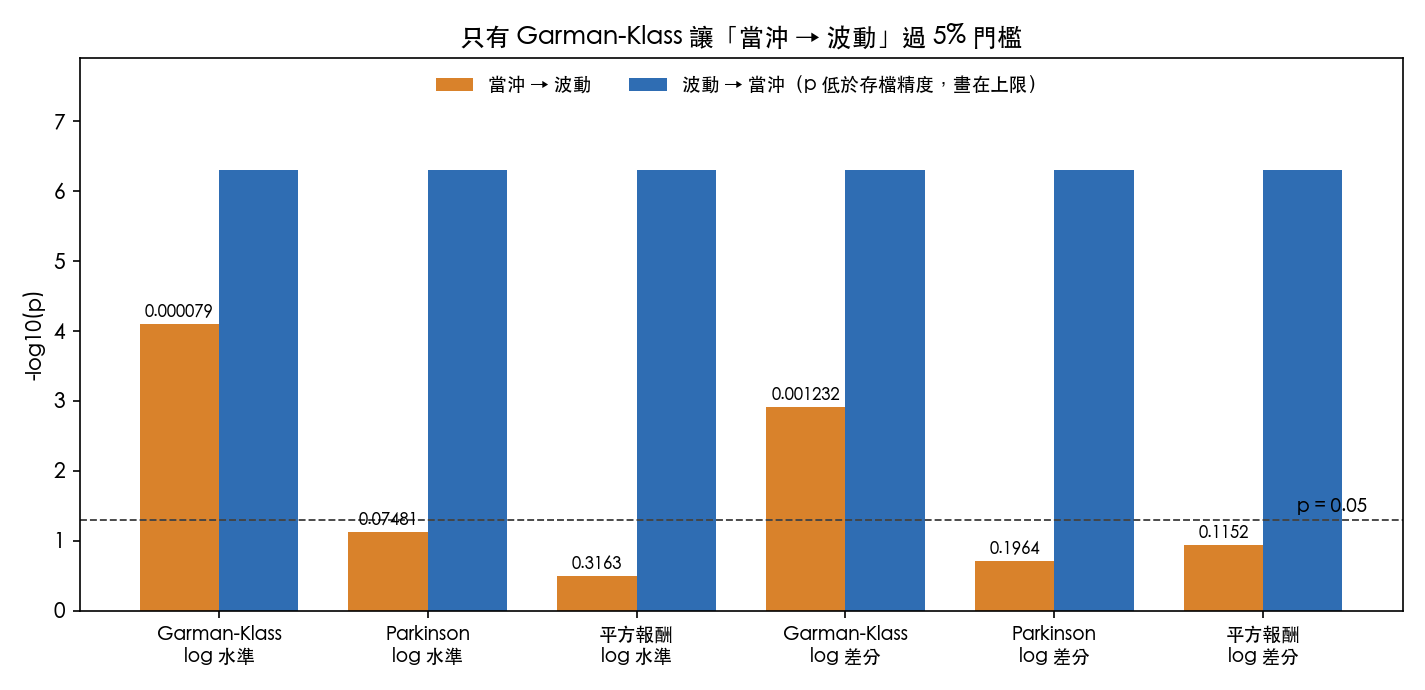
「波動先行於當沖」在六格裡全部顯著。「當沖先行於波動」在 Garman-Klass 下顯著,水準設定 p = 0.000079,雙差分設定 p = 0.001232;換成 Parkinson,兩種變換的 p 是 0.07481 與 0.1964,換成平方報酬是 0.3163 與 0.1152,都不過 5%。 只看 Garman-Klass,會寫出「雙向回饋」;三個估計量一起看,能寫的只有單向的預測先行。
估計量差異能描述,不能當成因。 Garman-Klass 等於 Parkinson 的區間項乘上權重,再減去開盤到收盤報酬平方的一項;Parkinson 只用高低區間;平方報酬用收盤到收盤,含隔夜。至少有兩種讀法符合表三:Garman-Klass 是三者中效率最高的估計量,檢定力因此較高;或者當沖與波動的關聯集中在開收盤報酬那一項。本實驗沒有設計能分開這兩種讀法的檢定。也不能把 Parkinson 與 Garman-Klass 的差異歸因於隔夜:兩者都只用盤中價格,含隔夜的是平方報酬。
這裡的「先行」都是 Granger 意義上的預測先行,不是因果。
對做研究的人,結論是什麼
- 要把當沖比重放進台股 HAR,樣本內顯著不足以支持;它在樣本外的增量取決於損失函數、控制變數與期間。
- 寫 Granger 方向時,至少列兩個以上的已實現變異估計量。同一份資料,只換估計量就能把「雙向回饋」改成「單向」。
- 用巢狀比較時,報 Clark-West,DM 只作輔助。
限制
- 三個已實現變異都是日線代理,沒有五分鐘資料;結論可能隨盤中已實現變異改變。
- 當沖比重是全市場加總,沒有個股或投資人類別的分解。
- 子期切點固定在 2020-01-01,沒有做結構轉折搜尋。
- 預測目標是已實現變異水準,沒有測 log 設定下的增量。
- 損失依波動狀態的拆解沒有做,MSE 與 QLIKE 分歧的讀法未經檢定。
- 本實驗沒有成本模型或交易規則,不構成任何交易主張。
資料與復現
- 實驗:K1724,非作者審查 PASS。
- 程式、凍結資料與結果檔都在
experiments/k1724/;數字取自k1724_results.json的具名鍵。 - 本文的表格與圖由
storage/drafts/k1724_research_charts.py從同一份結果檔直接產生。
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊