先猜『這個實驗值不值得做』的那把尺,我們拿四個標的去試:股票兩個猜中,商品兩個全錯
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
做研究最貴的成本不是算力,是把三個星期花在一個最後什麼都沒有的方向上。
所以我們早先做過一件事。過去跑過幾十個「把恐慌指數的資訊加進某個資產的波動預測裡」的實驗,有的有效有的沒效。
那能不能從這些歷史結果裡歸納出一把尺,碰到一個沒跑過的新資產時,先估一下值不值得動手?
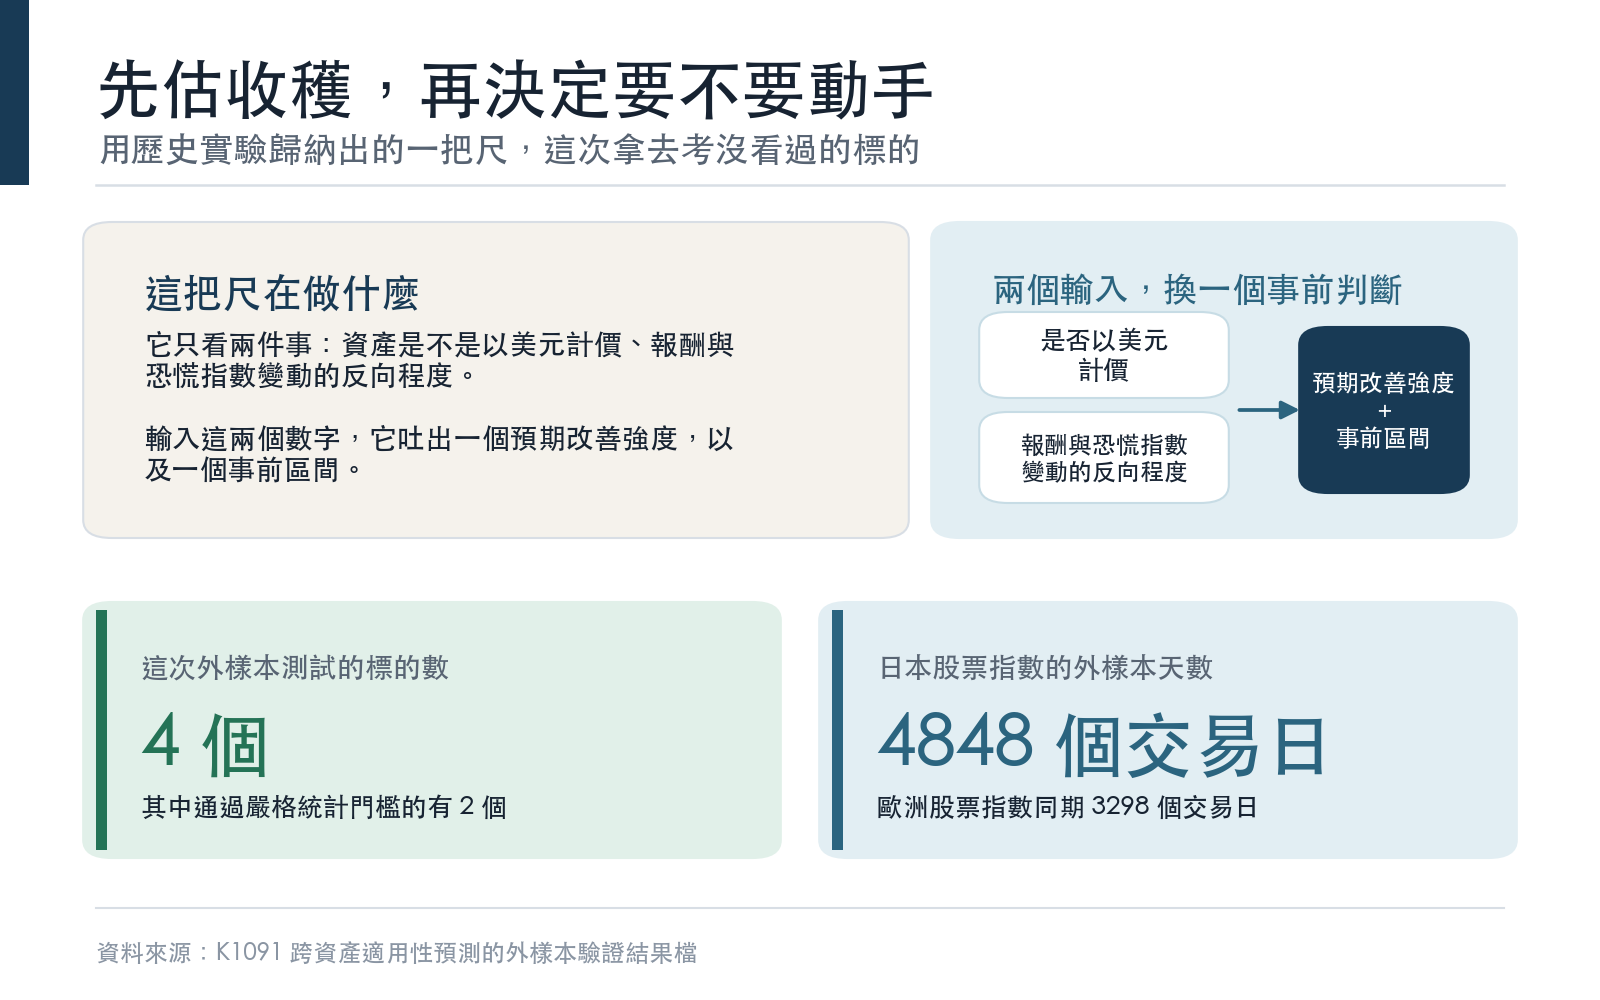
那把尺當時歸納出來了。它只看兩個東西:這個資產是不是以美元計價、以及它的日報酬跟恐慌指數的變動之間有多強的反向關係。輸入這兩個數字,它吐出一個「預期改善強度」,以及一個事前的區間。
這篇要講的不是那把尺怎麼做出來的,是我們後來拿它去外樣本試的結果。 這件事比前一篇重要,因為一把用歷史資料歸納出來的尺,在歷史資料上當然很合身,真正有意義的問題只有一個:它對它沒看過的東西,猜得準嗎?
四個標的,兩種答案
我們挑了四個標的:歐洲股票指數、日本股票指數、銅、白銀。前兩個是股票、以美元計價;後兩個是商品。每一個都跑完整的外樣本流程,用滾動視窗重新估計參數,每季調整一次,只用當下之前的資料做預測,然後把整段外樣本期的表現跟不加恐慌指數的版本比。
資料量不算少:
| 標的 | 外樣本期間 | 外樣本天數 | 事前預測強度 | 事前區間 | 實際強度 |
|---|---|---|---|---|---|
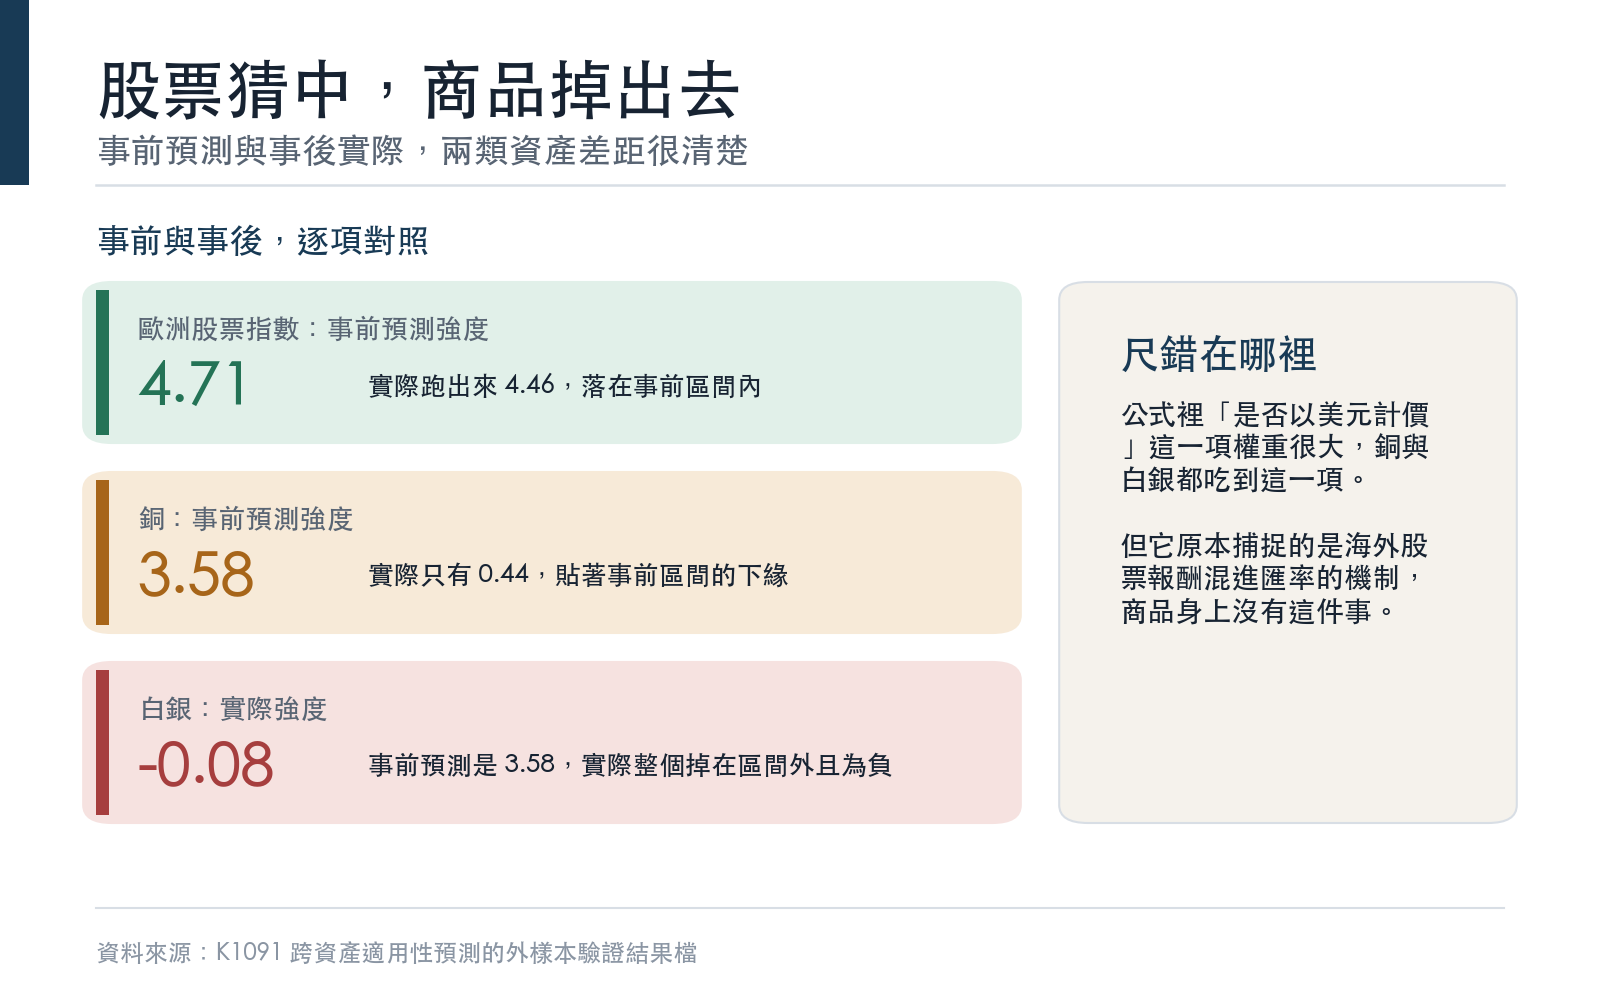
| 歐洲股票指數 | 2013-03-01 ~ 2026-04-10 | 3298 | 4.71 | 3.26 ~ 5.84 | 4.46 |
| 日本股票指數 | 2007-01-03 ~ 2026-04-10 | 4848 | 4.34 | 3.16 ~ 5.40 | 4.81 |
| 銅 | 2020-01-02 ~ 2026-04-10 | 1576 | 3.58 | 0.35 ~ 4.47 | 0.44 |
| 白銀 | 2014-05-01 ~ 2026-04-10 | 3004 | 3.58 | 0.70 ~ 4.29 | -0.08 |
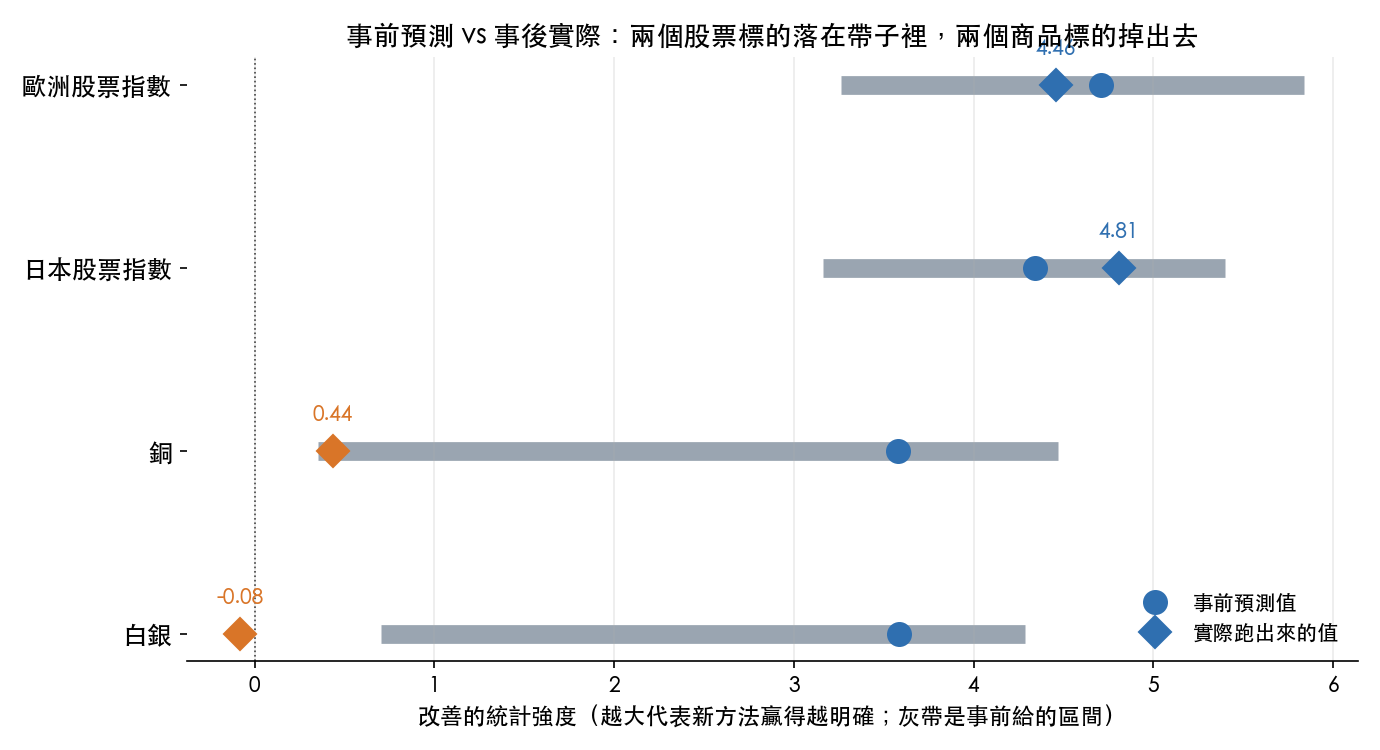
兩個股票標的,事前猜的跟事後跑出來的幾乎貼在一起。歐洲那個差 0.25,日本那個差 0.47。兩個都在事前區間內,而且都通過了我們設的那道嚴格統計門檻。
兩個商品標的,整個是另一回事。尺說銅有 3.58 的改善強度、白銀 3.58,實際跑出來是 0.44 和 -0.08。白銀那個負號的意思是:加了恐慌指數的版本,比不加的還差一點點。銅的實際值還勉強落在區間下緣裡面(區間下界 0.35),白銀的則整個掉在區間外。
換成比較好懂的單位,預測誤差實際改善了多少:
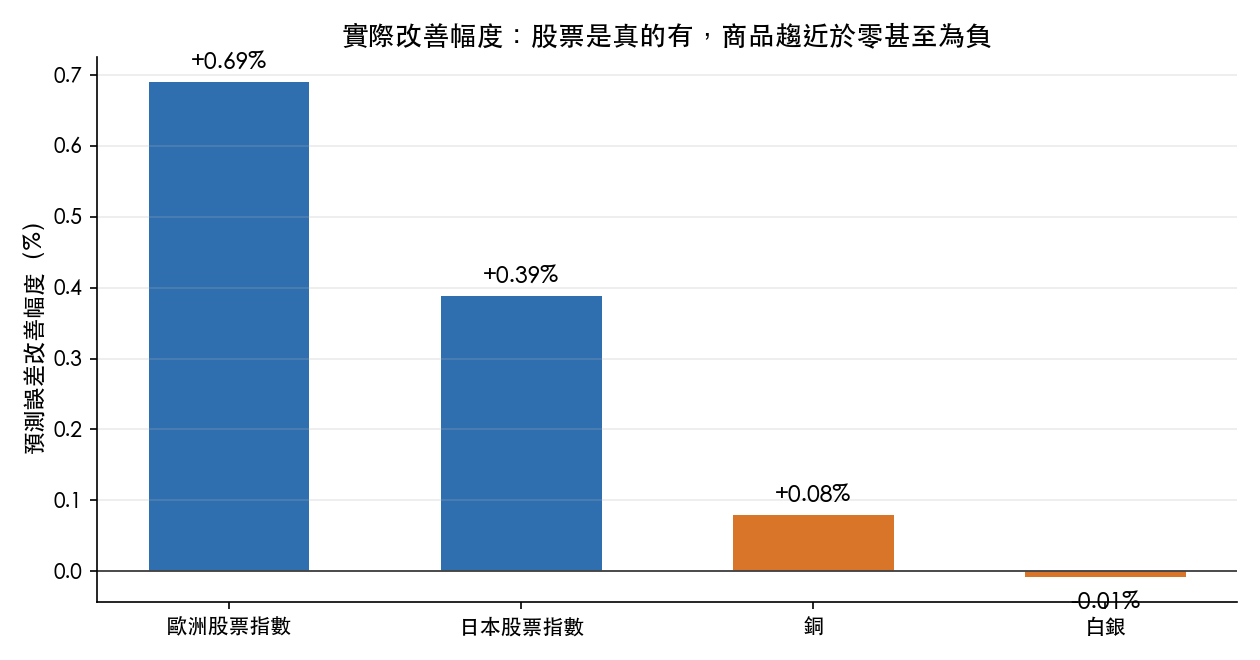
歐洲股票指數改善 0.69%,日本股票指數改善 0.39%。這兩個數字看起來很小,但它們是在幾千個交易日上穩定累積出來的,統計上站得住。銅只有 0.08%,白銀是負的 0.01%——這兩個在雜訊裡面。
這把尺錯在哪裡
尺的公式裡有一項是「這個資產是不是以美元計價」,而這一項的權重相當大。銅和白銀都是以美元報價的商品,所以它們在這一項上拿到跟股票一樣的分數。
問題是這一項原本捕捉的東西,跟商品身上發生的事不是同一件。對一檔以美元計價的海外股票指數來說,美元計價意味著它的報酬裡混進了匯率,而匯率在市場恐慌時會跟著動,恐慌指數因此對它有話可說。對銅和白銀來說,價格本來就是用美元報的,這個「混進匯率」的機制根本不存在。同一個欄位,在兩類資產上代表兩件不同的事,尺沒有能力分辨。
這是歸納型工具很典型的失效方式:它學到的是相關,不是機制。訓練樣本裡以美元計價的東西剛好大多是股票,於是「美元計價」這個欄位順便替「是股票」背了書。等到出現一個以美元計價但不是股票的東西,這個借來的解釋力就還回去了。
但更該說的是樣本數
到這裡為止的敘述有一個很容易被跳過的問題: 四個標的裡,通過門檻的有兩個,猜對方向的也是兩個。
四分之二。我們現在拿這個結果說「這把尺在股票上有效、在商品上失效」,其實只有兩個資料點支持前半句、兩個支持後半句。
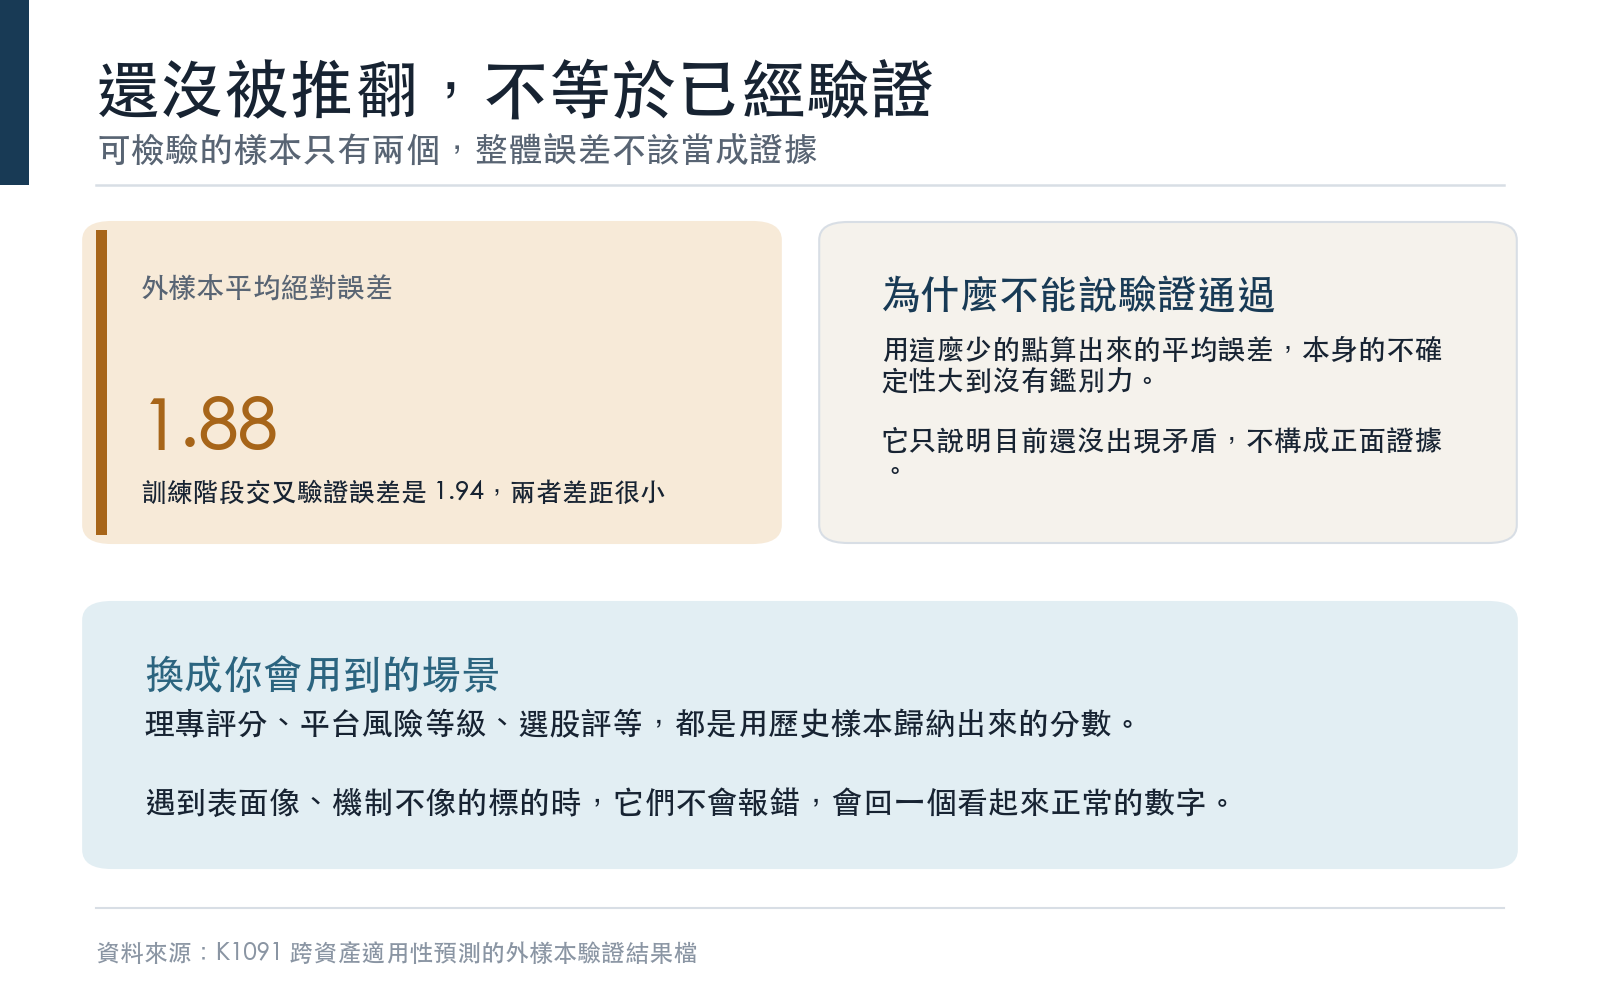
我們把整體誤差也算了:這把尺在四個標的上的平均絕對誤差是 1.88,而它自己在訓練階段做交叉驗證時的誤差是 1.94。外樣本誤差比訓練誤差略小,聽起來是好消息。但用四個點算出來的平均誤差,它本身的不確定性大得沒有意義,這個數字不該被當成證據,它只是「還沒出現矛盾」。
所以這篇的結論不是「尺驗證通過」。誠實的說法是三句話:
- 在以美元計價的股票指數上,它連續兩次猜對,包含數值大小而不只是方向。
- 在商品上,它連續兩次猜錯,而且我們找得出錯的機制。
- 兩個「連續兩次」都只是兩次。
如果你不做研究,這件事跟你有什麼關係
你大概不會去估計波動率模型。但你很可能會用到某種「先幫你判斷值不值得」的工具,理專的資產適合度評分、平台上的風險等級、選股網站的評等、任何一個把複雜判斷壓縮成一個分數的東西。
這些工具全都是用歷史資料歸納出來的,全都有同一個弱點:它們在訓練樣本長得像的東西上很準,遇到「表面特徵相同但底層機制不同」的東西時會靜靜地失效,而且失效的時候不會報錯,會回你一個看起來很正常的分數。
銅和白銀在那把尺眼裡,跟歐洲股票指數是同一類。它給的是 3.58,不是「無法判斷」。
所以實務上只有一個做法有用:問這個分數是拿什麼樣本訓練出來的,以及你手上這個標的跟那批樣本像不像。像,就參考;不像,那個分數不是弱訊號,它是沒有訊號。
資料與方法
外樣本設計:滾動視窗 2000 個交易日,每 63 個交易日重新估計一次參數,預測只使用當下之前的資料。四個標的的原始資料起點分別是 2005-03-11、以及各自表格中列出的外樣本起點之前。隨機種子固定為 42。完整結果檔與腳本在 experiments/k1091/。
事前預測值與區間來自前一篇歸納那把尺的研究,在本次外樣本測試開始前就已經凍結,沒有在看到結果之後調整過。
懶人包圖組
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊