想用新聞原創比例預判下週震盪?這道功課可以先省下來
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
想用新聞原創比例預判下週震盪?這道功課可以先省下來
打開任何一個財經新聞聚合頁,同一則通訊社稿會被幾十個網站換個標題轉貼。獨家報導與轉載混在一起,讀者分不出今天的新聞量是「真的有很多事發生」,還是「一件事被講了很多遍」。
一個自然的猜想由此而來:如果某天獨家報導的比例特別高,代表媒體正在挖出新資訊,市場接下來幾天可能比較不平靜。要是猜想成立,它會是一個免費的預警指標,只要數一數今天有幾則不同的新聞就好。
這篇要回答的是一個很實際的問題:這件事值得排進你每天的功課嗎?我們拿六百多個交易日、十五萬篇新聞實測了一次。答案是可以先省下來,原因分兩層,第二層比第一層更值得記住。
資料怎麼組
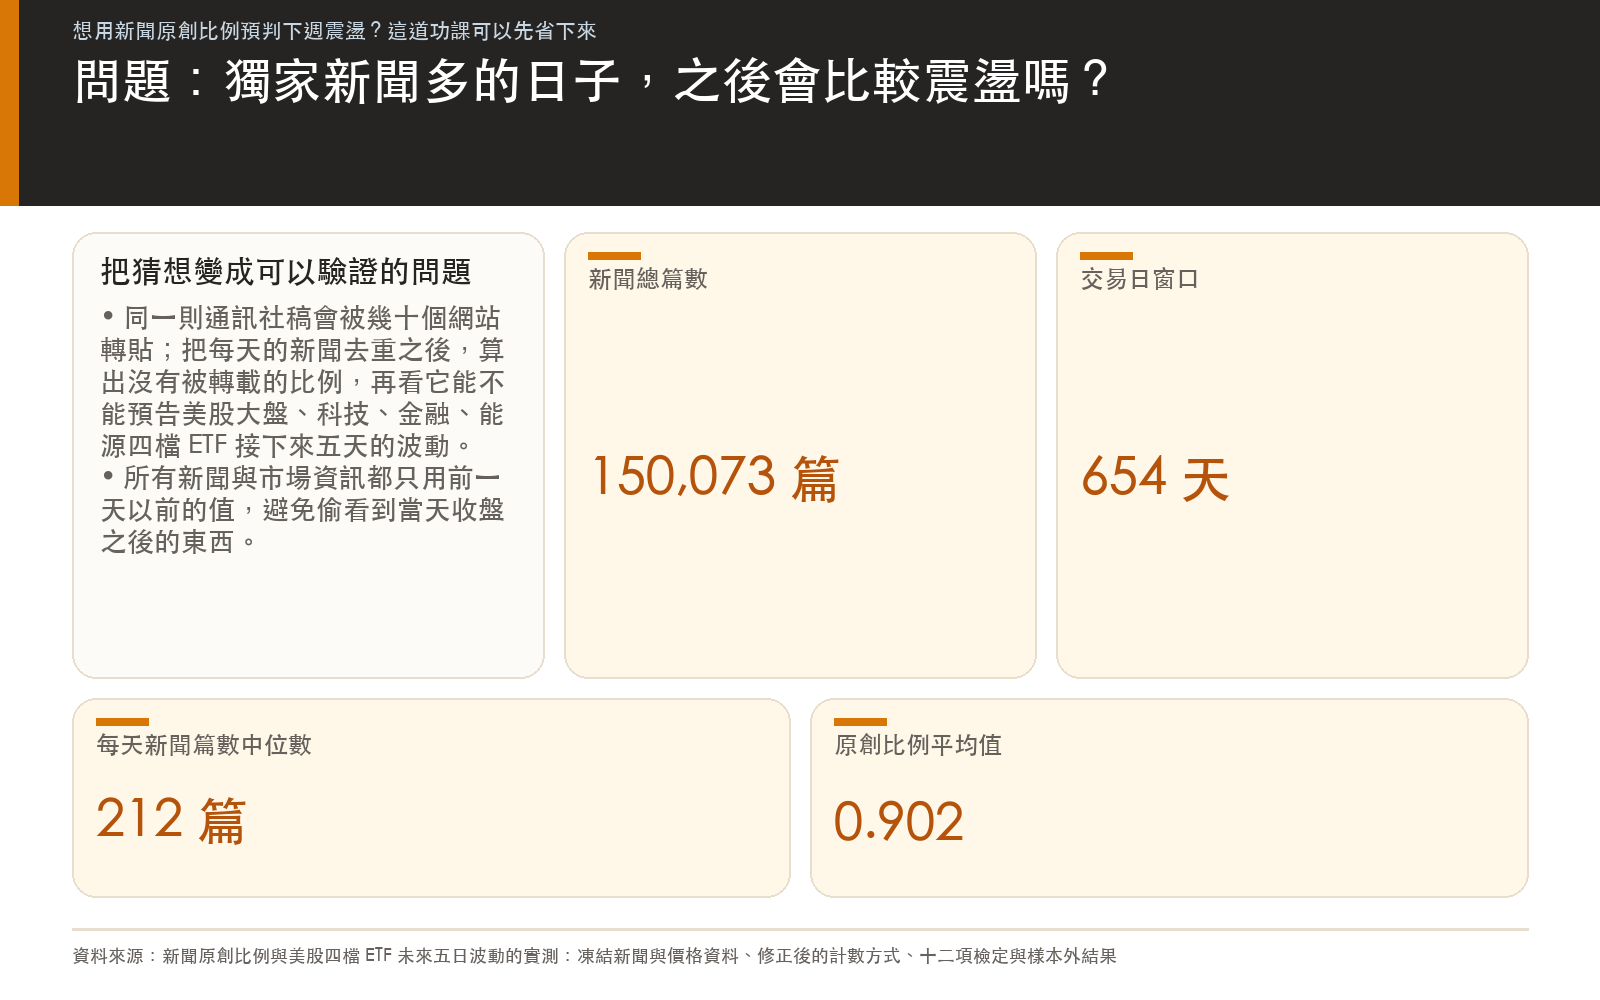
新聞來自 GDELT 這個免費的全球新聞資料庫。我們抓下二○二四年一月初到二○二六年八月底,以「stock market」為關鍵字、來源為美國英文媒體的全部標題與來源網站,共 150,073 篇。每一則標題先做正規化,同一則稿子在不同網站的版本會被歸成同一組;一組標題若出現在兩個以上的網站,就算轉載。
每個交易日算出一個「原創比例」:不同標題的組數裡,沒有被轉載的組占多少。整段期間有 654 個交易日窗口,每天的新聞篇數中位數是 212 篇,原創比例的平均值是 0.902。
市場那一端用四檔常見的美股 ETF:大盤、科技、金融、能源。每檔各看三種「接下來五天」的風險:整體波動、下跌那一側的波動、以及單日最大的跳動幅度。四檔乘三種,共十二項檢定。所有新聞、新聞量、過去波動與恐慌指數的資訊都只用前一天以前的值,避免偷看到當天收盤之後的東西。
第一層:怎麼數新聞,會改變答案的方向
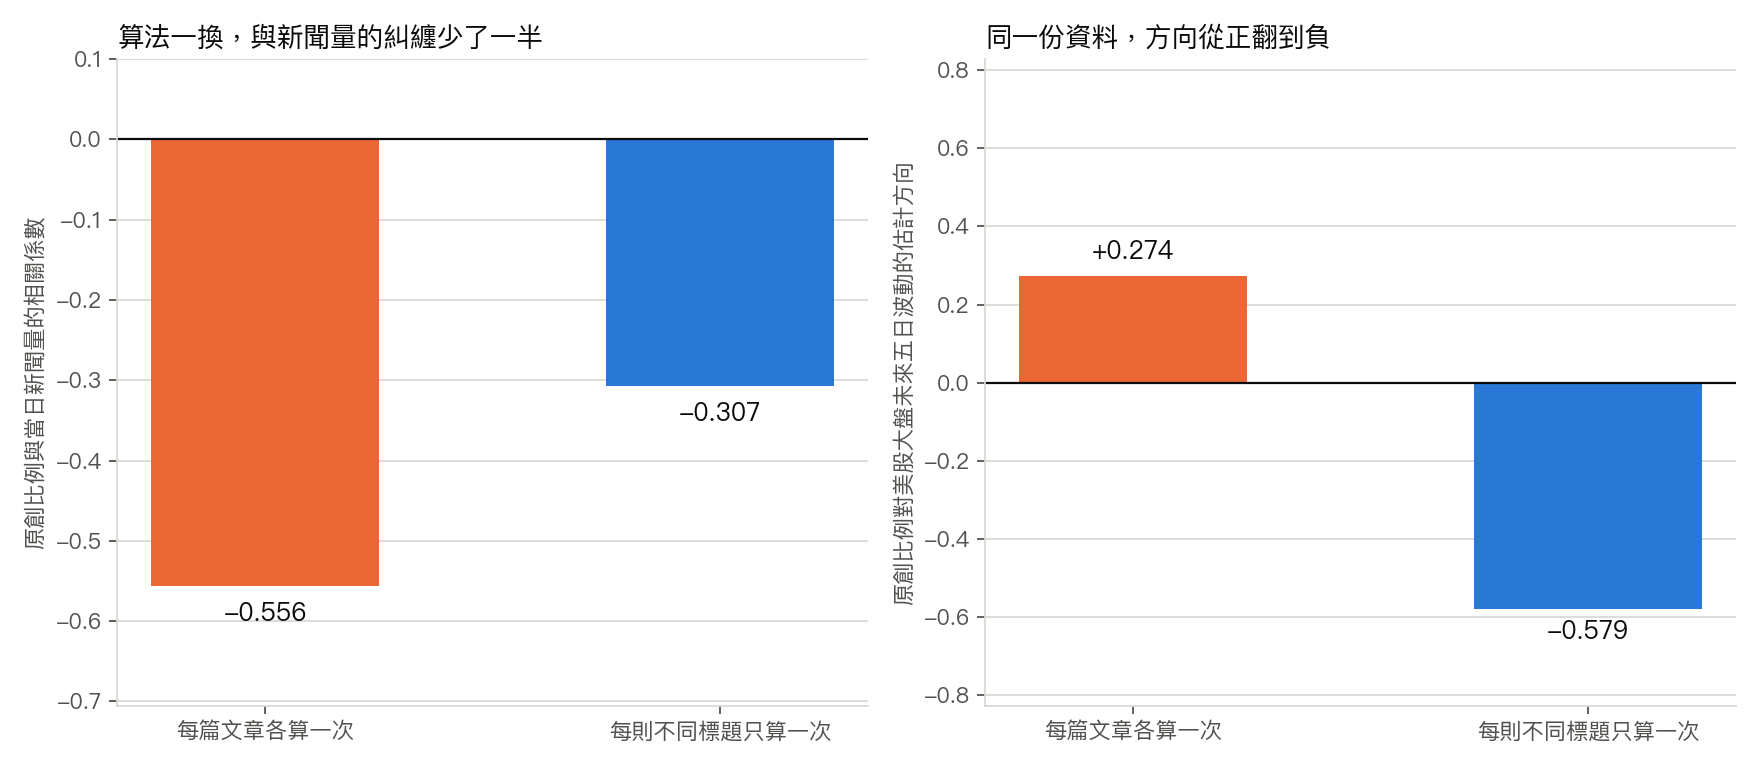
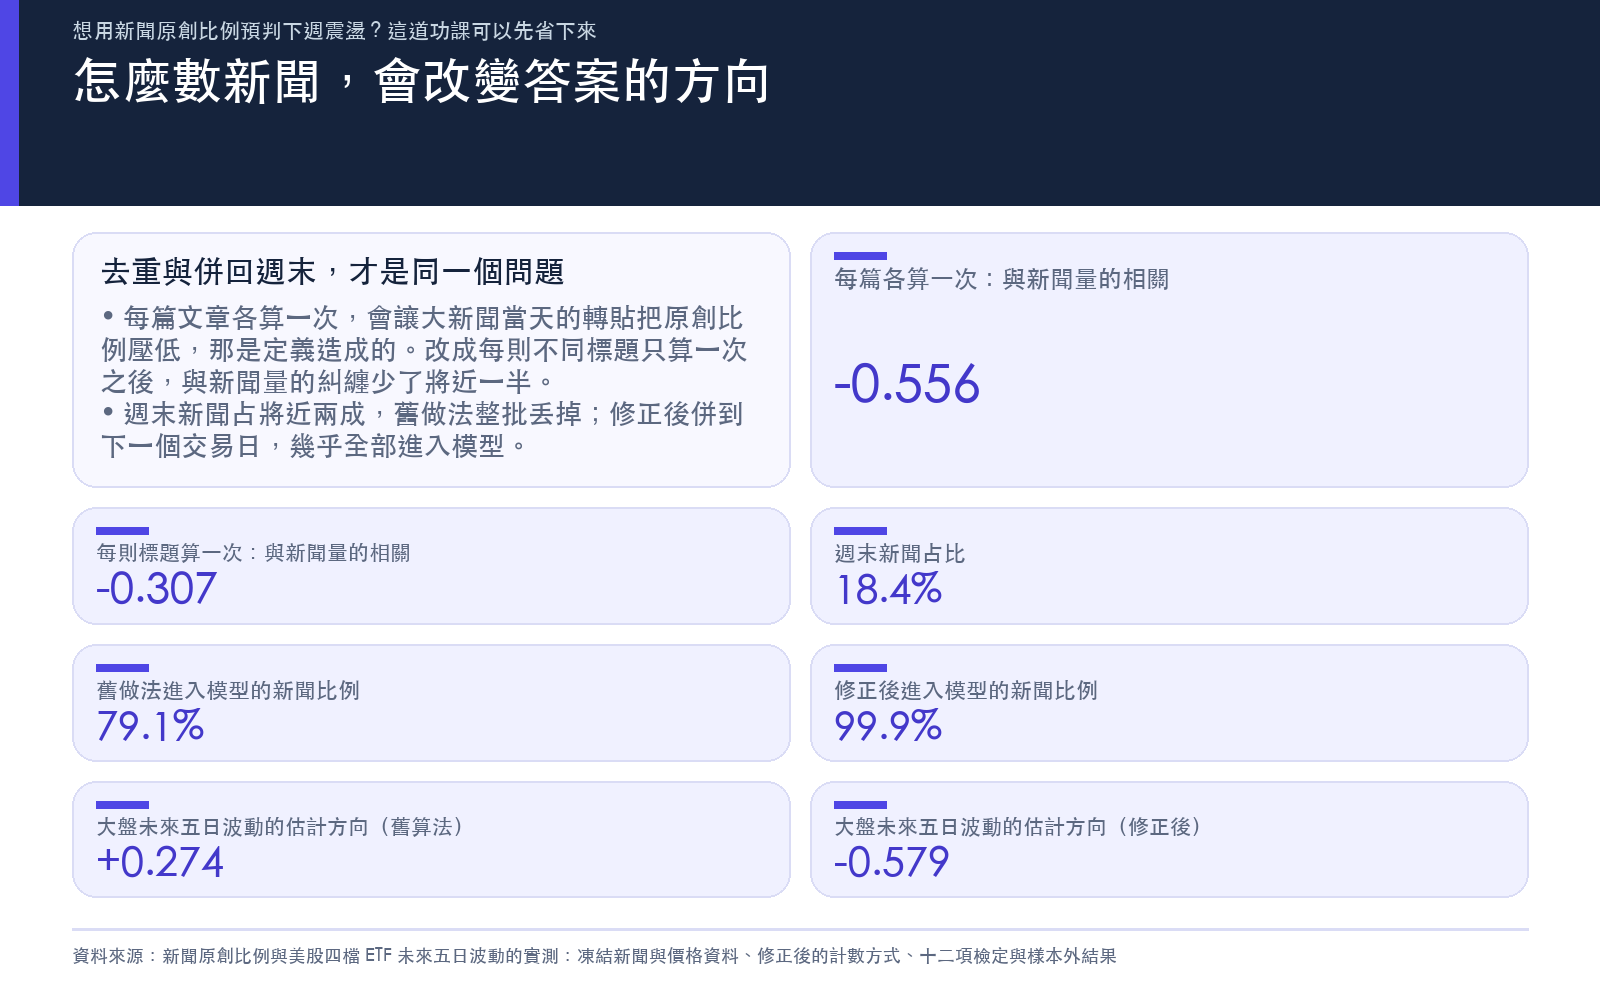
我們的第一版把每一篇文章各算一次。一則通訊社稿被四十個網站轉貼,就貢獻四十篇「轉載」。用這種算法,原創比例與當天新聞量的相關係數是 -0.556:新聞越多的日子,原創比例越低。看起來像個發現,仔細想卻是定義造成的。大新聞當天轉貼最多,分母膨脹,原創比例自然被壓下去。
第二版改成每一組不同標題只算一次,四十個轉貼只算一組。相關係數縮到 -0.307,與新聞量的糾纏少了將近一半。更重要的是,原創比例對大盤未來五日波動的估計方向,從第一版的 +0.274 翻成第二版的 -0.579。同一份資料、同一個問題,只因為「數的單位」不同,結論就從「原創多、之後較震盪」變成相反方向。
還有一個容易被忽略的地方:週末新聞。全部新聞裡有 27,572 篇發在週末,占 18.4%。第一版只收交易日當天的新聞,週末與假日的稿子整批被丟掉,只有 79.1% 的文章進入模型。第二版把每個曆日的新聞併到下一個交易日,覆蓋率升到 99.9%,剩下的 161 篇是最後一個交易日之後的新聞,沒有可以對應的交易日。
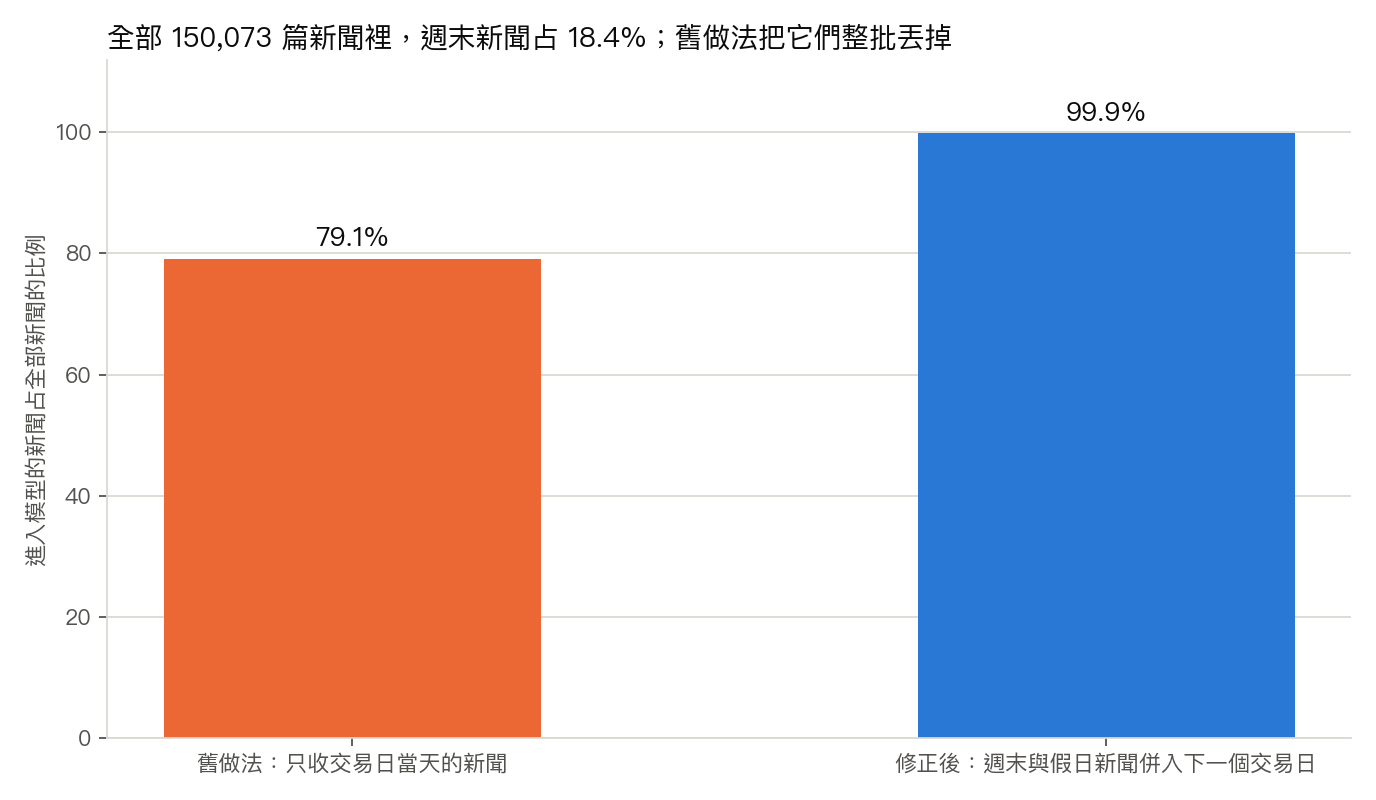
這一層對讀者的意義很直接:任何拿新聞篇數當指標的做法,若沒有先把轉載去重、把週末併回來,看到的訊號有一部分是計數方式製造出來的。
第二層:數對了之後,訊號沒有跨過門檻
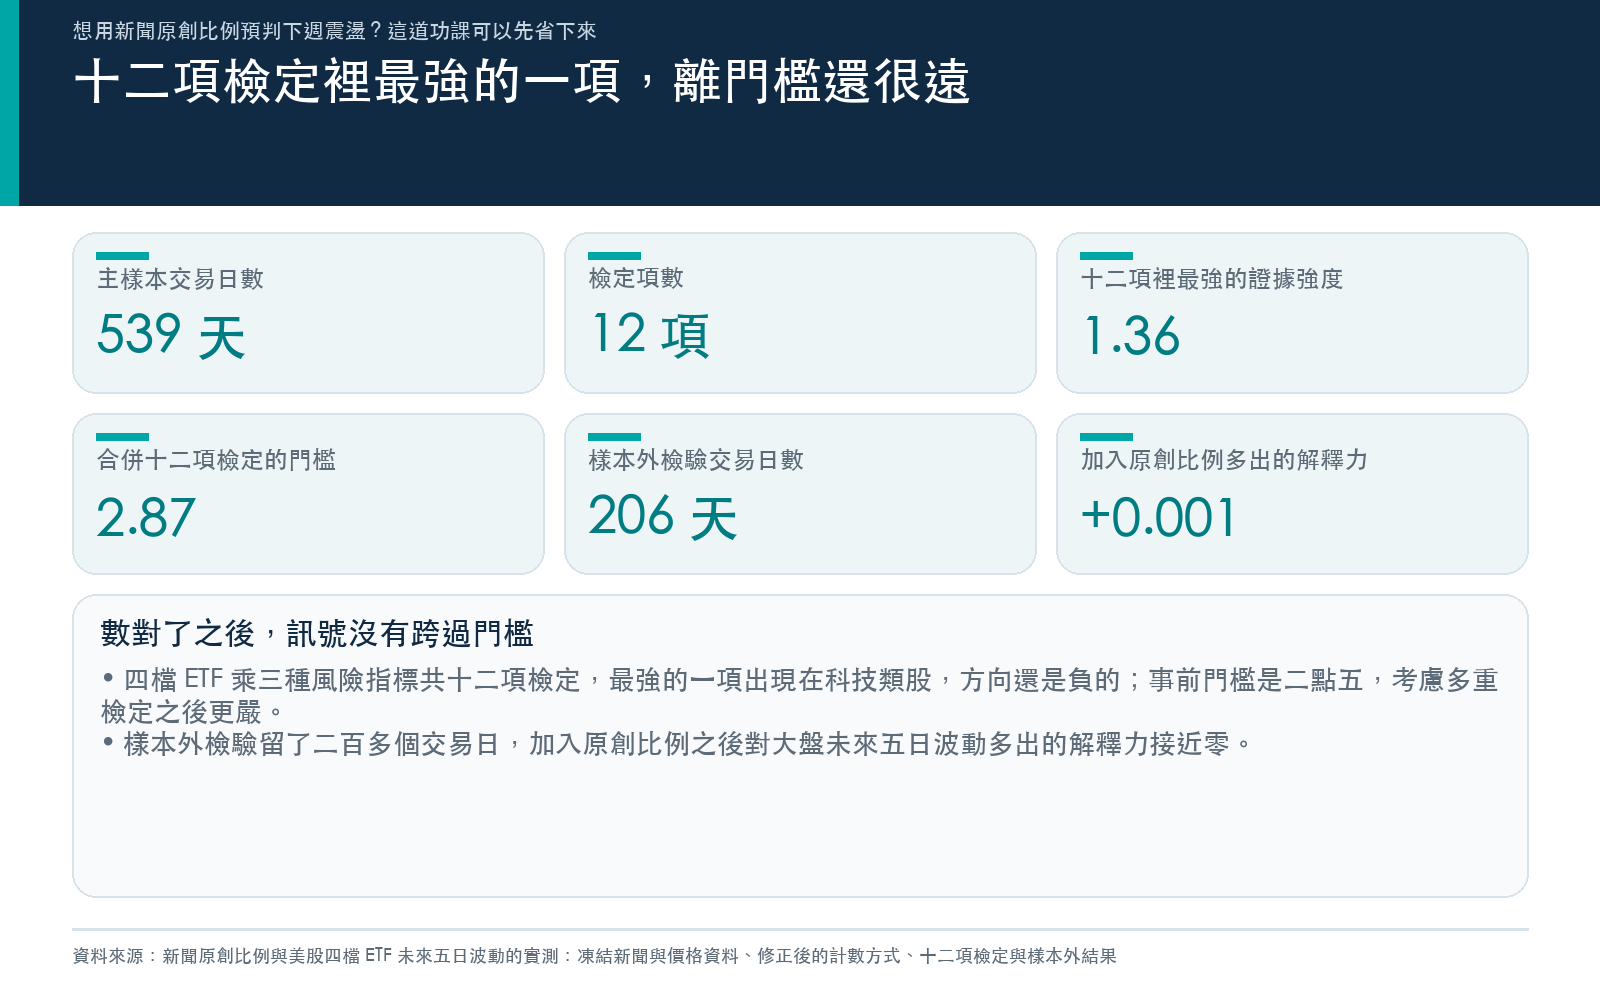
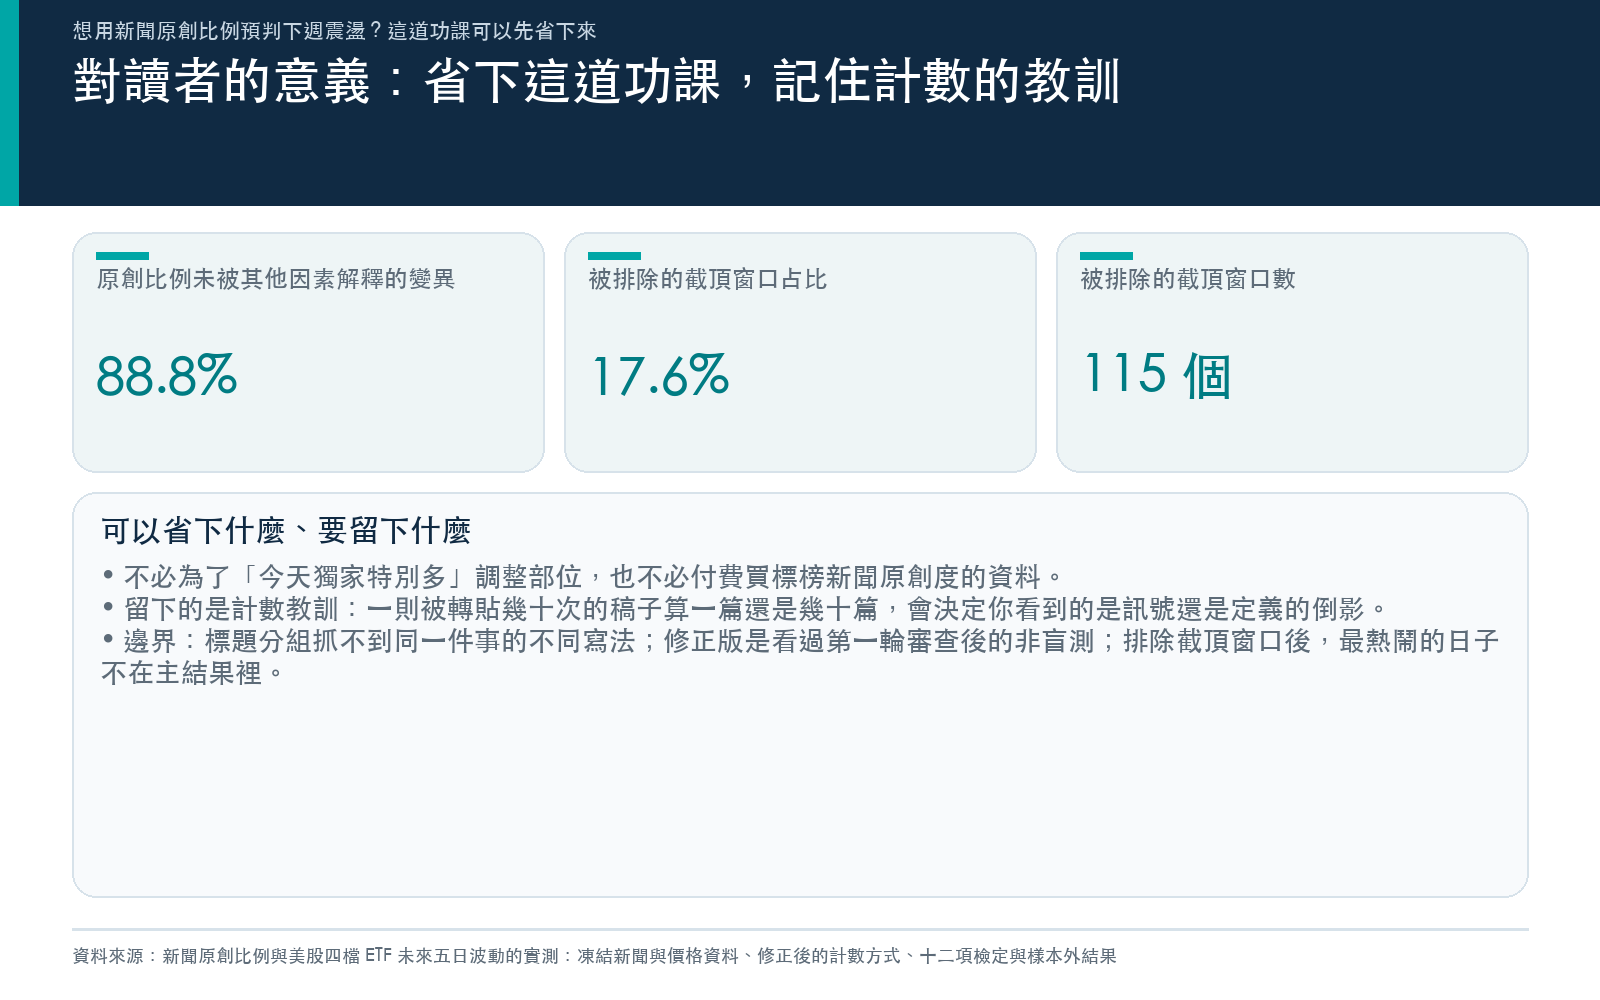
用第二版的算法,排除新聞資料庫回傳量被截頂的 115 個窗口(占 17.6%)之後,主樣本有 539 個交易日。十二項檢定的結果如下,證據強度離零越遠代表訊號越清楚,正值代表原創比例高、之後越震盪:
| 標的 | 未來五日波動 | 未來五日下跌波動 | 未來五日最大單日跳動 |
|---|---|---|---|
| 美股大盤 | -0.78 | -0.69 | -0.60 |
| 科技類股 | -1.36 | +0.11 | -0.82 |
| 金融類股 | +0.05 | -0.17 | +0.52 |
| 能源類股 | +0.05 | +0.14 | +0.20 |
十二項裡最強的一項只有 1.36,出現在科技類股的整體波動,而且方向是負的。實驗開跑前就寫下的門檻是二點五;考慮到一次做了十二項檢定、必須更嚴格時,門檻是 2.87。沒有任何一項接近。四檔標的的方向也沒有一致:大盤與科技偏負,金融與能源偏正,看不出一個共同的故事。
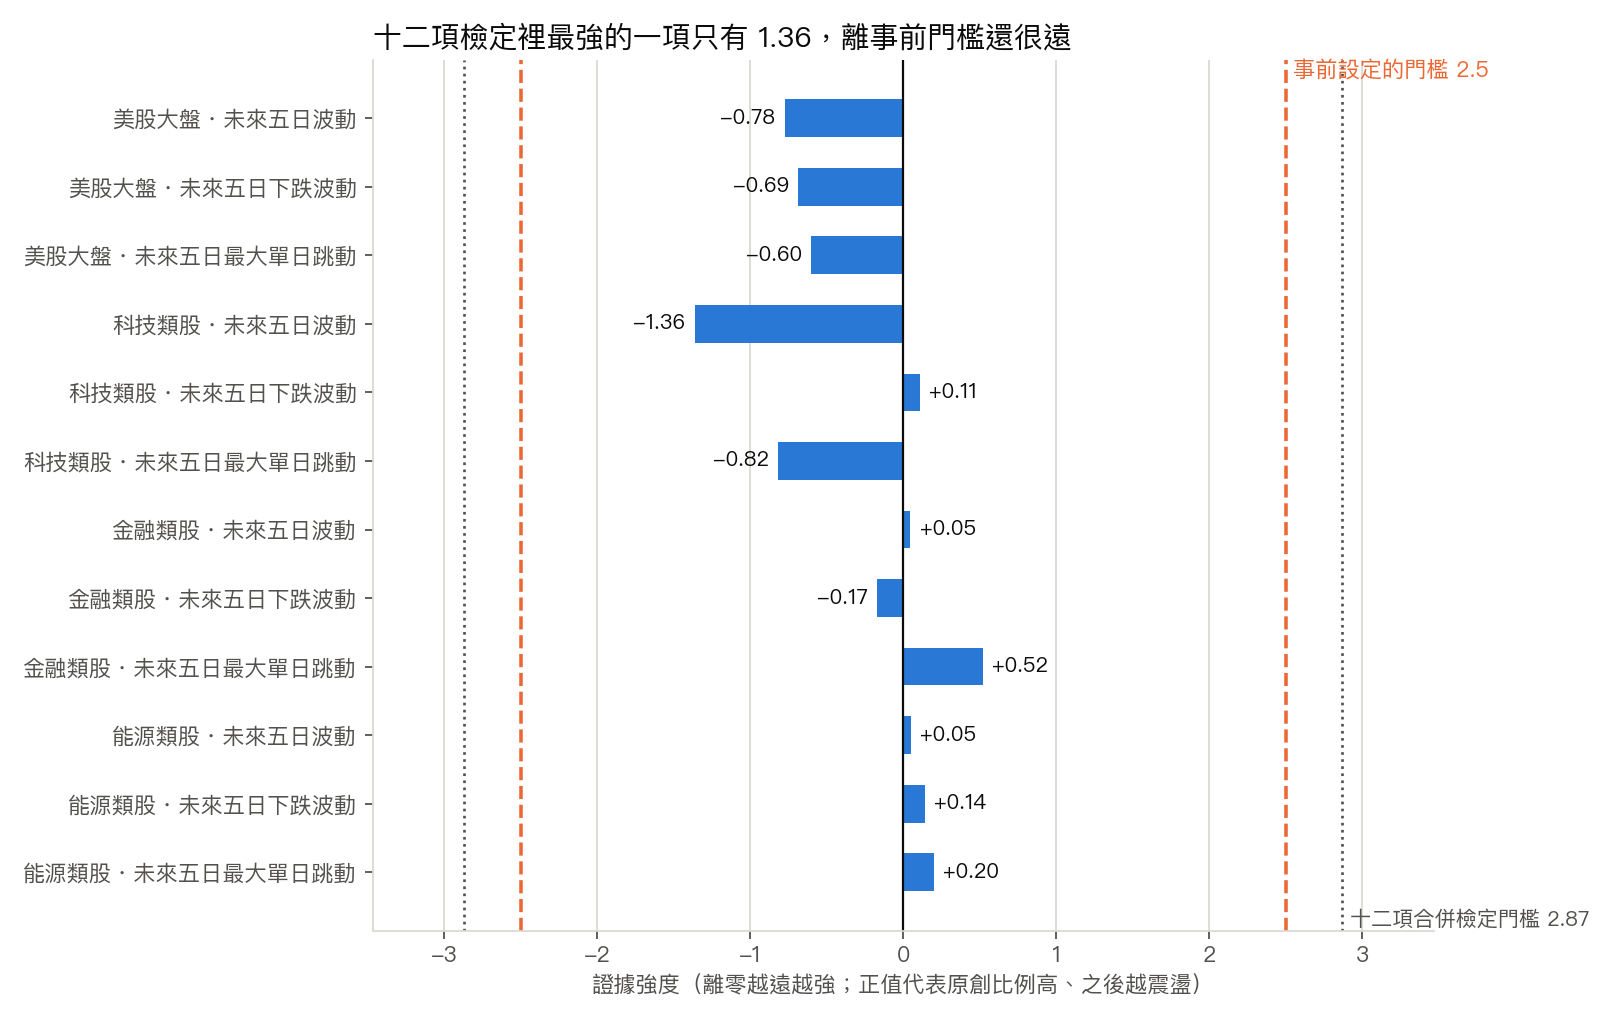
事前定下的三個判定條件是:大盤那一項要達到正向門檻、四檔標的至少三檔同方向、大盤在樣本外要有正的增量解釋力。前兩條都沒有達成。第三條有達成,但幅度小到可以忽略:把二○二五年九月一日之後的 206 個交易日留作樣本外檢驗,用之前的 328 個交易日估計模型,加入原創比例之後,對大盤未來五日波動的解釋力只多了 0.00099。
這對你的決策代表什麼
省下來的,是一整套工作:抓新聞、去重、算比例、每天更新。這條線在目前的資料與方法下,沒有給出可用的預警訊號。你不需要為了「今天獨家特別多」而調整部位,也不需要付費買任何標榜「新聞原創度」的資料。
值得留下的,是計數的教訓。我們之前寫過幾篇拿新聞「數量」當波動率訊號的實測,油市新聞與監管文件數量都沒有跑出可用的訊號。這篇換了一個角度,看的是新聞的「成分」,也就是原創與轉載的比例,同時扣掉了新聞量的影響。結論仍然一致,並且多了一個前幾篇沒有碰到的發現:新聞資料的計數單位選錯,會憑空生出一個方向明確的假訊號。
這個結果的邊界
這篇能說的只有「在這份資料、這個代理變數與這段期間裡,沒有偵測到事前門檻要求的大型正向關聯」。它不能說原創新聞對波動沒有影響,理由有三個。
第一,我們用標題正規化來判斷轉載,這只是文字層面的分組,抓不到「同一件事、不同寫法」的報導,也分不出編輯意義上的原創。第二,修正後的分析是在第一輪審查指出計數問題之後才做的,屬於看過結果再修正的版本,我們在實驗紀錄裡明確標為非盲測。第三,排除截頂窗口之後,樣本偏向新聞量較少的日子,最熱鬧的那些日子反而不在主結果裡。
另外,控制了新聞量、過去波動與恐慌指數之後,原創比例仍有 88.8% 的變異沒有被這些因素解釋。它量到了某個獨立的東西,只是那個東西在這裡沒有轉成未來五日的波動訊號。
一句話結論
一天的新聞裡獨家占多少,在六百多個交易日、四檔美股 ETF、十二項檢定裡都沒有預告下週的震盪;把這道功課省下來,並且記住:數新聞之前,先決定一則被轉貼四十次的稿子算一篇還是四十篇。
懶人包圖組
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊