K1623:同一批 749 天預測,換一個 loss 讓 3 個資產排名翻轉,BH 校正後 focal 比較存活 0 個
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
K1623:同一批 749 天預測,換一個 loss 讓 3 個資產排名翻轉,BH 校正後 focal 比較存活 0 個
摘要
K1623 原本要回答的是已實現波動率的長記憶是真是假。本實驗的設計對這個問題沒有鑑別力;能回答的,是一組關於推論程序本身的結果。
本實驗在 VIX、SPY、TW0050、QQQ、N225 五個資產上跑 Diebold-Mariano 檢定,樣本是各資產最後 749 個一步樣本外預測(h=1,seed=42),benchmark 一律是 HAR,挑戰者四個:ARFIMA(0,d,0)、BreakRobustHAR、AR(1)、EWMA(0.94)。兩個 loss(QLIKE 與 MSE)各跑一輪,合計 40 個比較。
QLIKE 下,HAR 的平均損失在 5 個資產中有 4 個低於 ARFIMA。MSE 下,ARFIMA 在 5 個資產中有 4 個低於 HAR,ARFIMA/HAR 的損失比落在 0.8359(TW0050)到 0.8914(N225)之間。SPY、TW0050、QQQ 三個資產的排名直接對調。同一份預測向量、同一段評分視窗、同一批模型,只換計分方式。
但兩邊都沒有勝負可言。ARFIMA 對 HAR 的 10 個 focal 比較裡,名目 5% 顯著的只有 QQQ/QLIKE 一格(p=0.0332),BH FDR 校正後存活 0 格。QLIKE 家族裡撐過 BH 的 7 格,打的全是刻意設弱的 AR(1) 與 EWMA。
rev3 追加的 500-rep 三臂 Monte Carlo 給出第二個可量化的結論:斷點去均值後 d̂ 的實際抽樣離散度,是已發表漸近 SE 的 1.21–1.33 倍。
Codex 在 round 5 覆核給 PASS,無 blocking defect。
一、兩個 loss 給出相反的排名
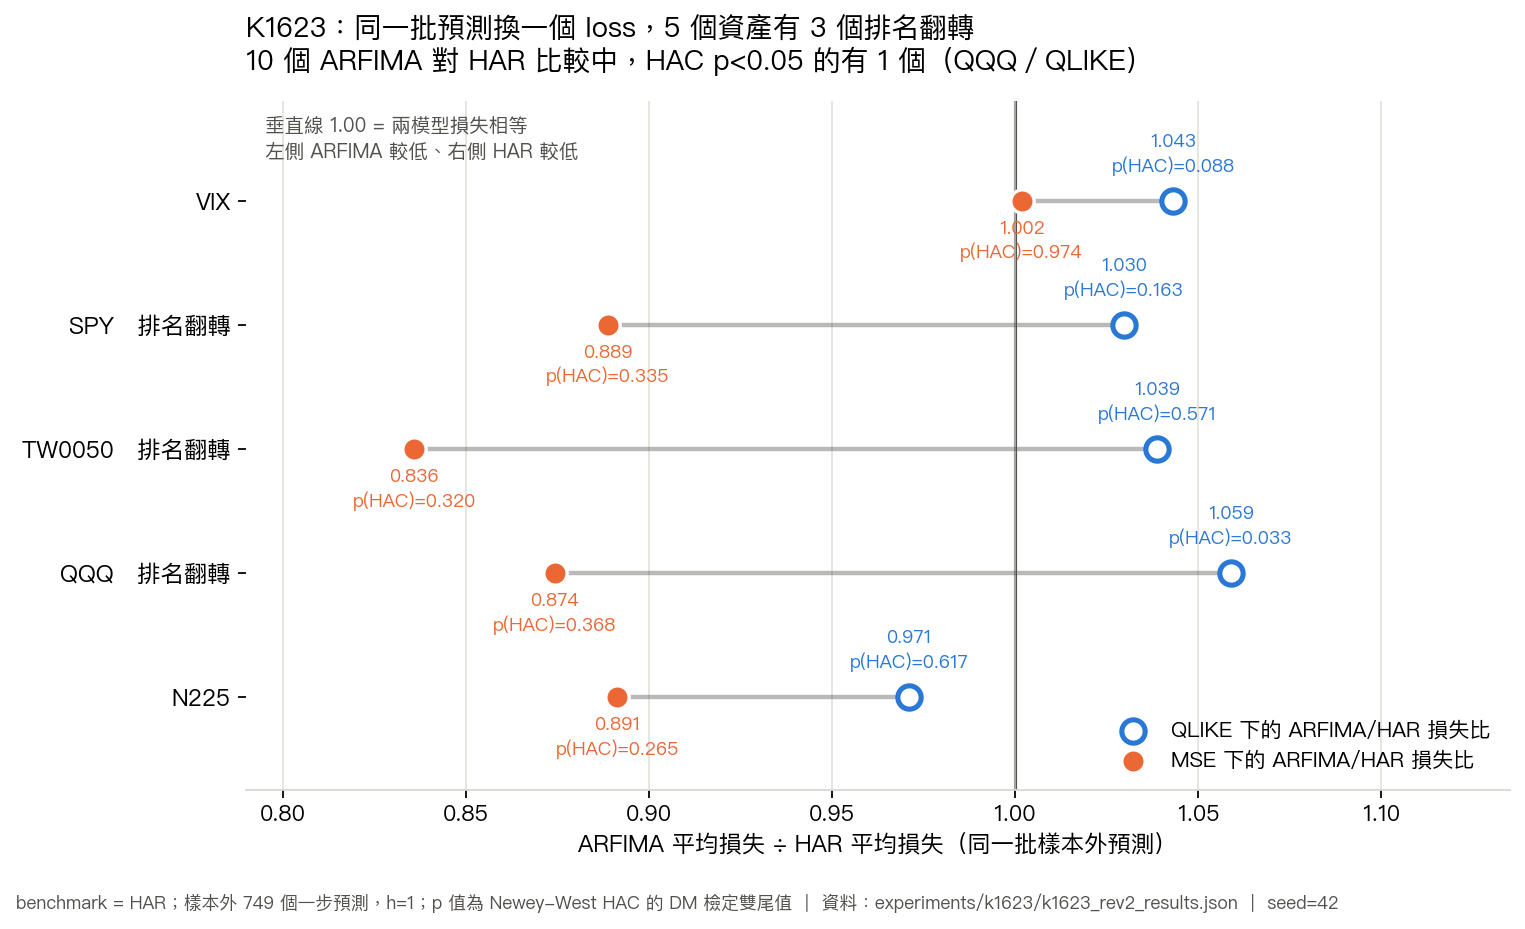
| 資產 | QLIKE ratio (ARFIMA/HAR) | QLIKE p_hac | MSE ratio | MSE p_hac | 排名翻轉 | BH 存活(任一 loss) |
|---|---|---|---|---|---|---|
| VIX | 1.0431 | 0.0882 | 1.0017 | 0.9744 | 否 | 否 |
| SPY | 1.0297 | 0.1631 | 0.8888 | 0.3349 | 是 | 否 |
| TW0050 | 1.0388 | 0.5712 | 0.8359 | 0.3203 | 是 | 否 |
| QQQ | 1.0589 | 0.0332 | 0.8742 | 0.3681 | 是 | 否 |
| N225 | 0.9710 | 0.6173 | 0.8914 | 0.2654 | 否 | 否 |
ratio 是 ARFIMA 的平均損失除以 HAR 的平均損失,小於 1 代表 ARFIMA 較低。同一列的兩個 ratio 來自同一批 749 天的預測值。
QLIKE 那一欄只有 N225 落在 1 以下,其餘四個資產 HAR 較低。MSE 那一欄只有 VIX 落在 1 以上,其餘四個資產 ARFIMA 較低,TW0050 低了 16.4%、QQQ 低了 12.6%、SPY 低了 11.1%、N225 低了 10.9%。
MSE 在變異數尺度上由少數極端日主導。0.8359 到 0.8914 的損失比配上 p 值 0.27 到 0.37,兩件事並不衝突:差距大,標準誤更大。
這裡最容易犯的錯,是把 MSE 那一欄讀成「ARFIMA 在 MSE 下勝出」。5 個 ARFIMA-vs-HAR 的 MSE 比較,p 值落在 0.2654 到 0.9744 之間,沒有一個接近 0.05。可以說的只有一句:點估排名翻轉,統計上兩者分不出高下。
如果只報 QLIKE,這篇會寫成「HAR 穩健勝出」;只報 MSE,會寫成「長記憶模型平均誤差低一成以上」。兩個版本都有數字撐,方向相反,來自同一次執行。
二、多重比較家族要先講清楚,才能說誰活下來
40 個比較不能各自看 p 值。本實驗在程式裡預先指定主要家族為 within_loss_20:QLIKE 20 個比較做一次校正,MSE 20 個比較做另一次校正。README 的每一句結論都用這個家族下的 BH FDR。
另外兩組只當敏感度:focal_10 是各自 within_loss_20 的子集(只留 ARFIMA 與 BreakRobustHAR 兩個挑戰者),pooled_40 是 QLIKE-20 與 MSE-20 的聯集。這五個集合裡,只有 focal 對 within-loss 是真正的 nested 關係;QLIKE-20 與 MSE-20 彼此互斥,pooled_40 是聯集。
家族講清楚之後,存活數字如下:
| 校正 | QLIKE(20 比較) | MSE(20 比較) |
|---|---|---|
| 名目 5% | 8 | 2 |
| BH FDR(within_loss_20,primary) | 7 | 0 |
| Bonferroni(within_loss_20) | 3 | 0 |
QLIKE 撐過 BH 的 7 格是 VIX/EWMA、SPY/AR1、SPY/EWMA、QQQ/AR1、QQQ/EWMA、N225/AR1、N225/EWMA。挑戰者全是 AR(1) 與 EWMA——實驗設計裡刻意放進來墊底的樸素基準。HAR 打贏 AR(1) 從來就不是爭議點。撐過 Bonferroni 的 3 格是 VIX/EWMA、SPY/AR1、QQQ/AR1,同樣一個 focal 都沒有。
真正被檢驗的命題落在 ARFIMA 與 BreakRobustHAR 這 20 個 focal 比較上。名目顯著的只有 QQQ/QLIKE/ARFIMA 一格,p=0.0332;同一格在 within_loss_20 下的 BH 校正 p 是 0.0829。無論用哪一個家族定義,focal 的 BH 存活數都是 0,所以結論不依賴家族的選擇。
三、HAC 修正的方向是雙向的
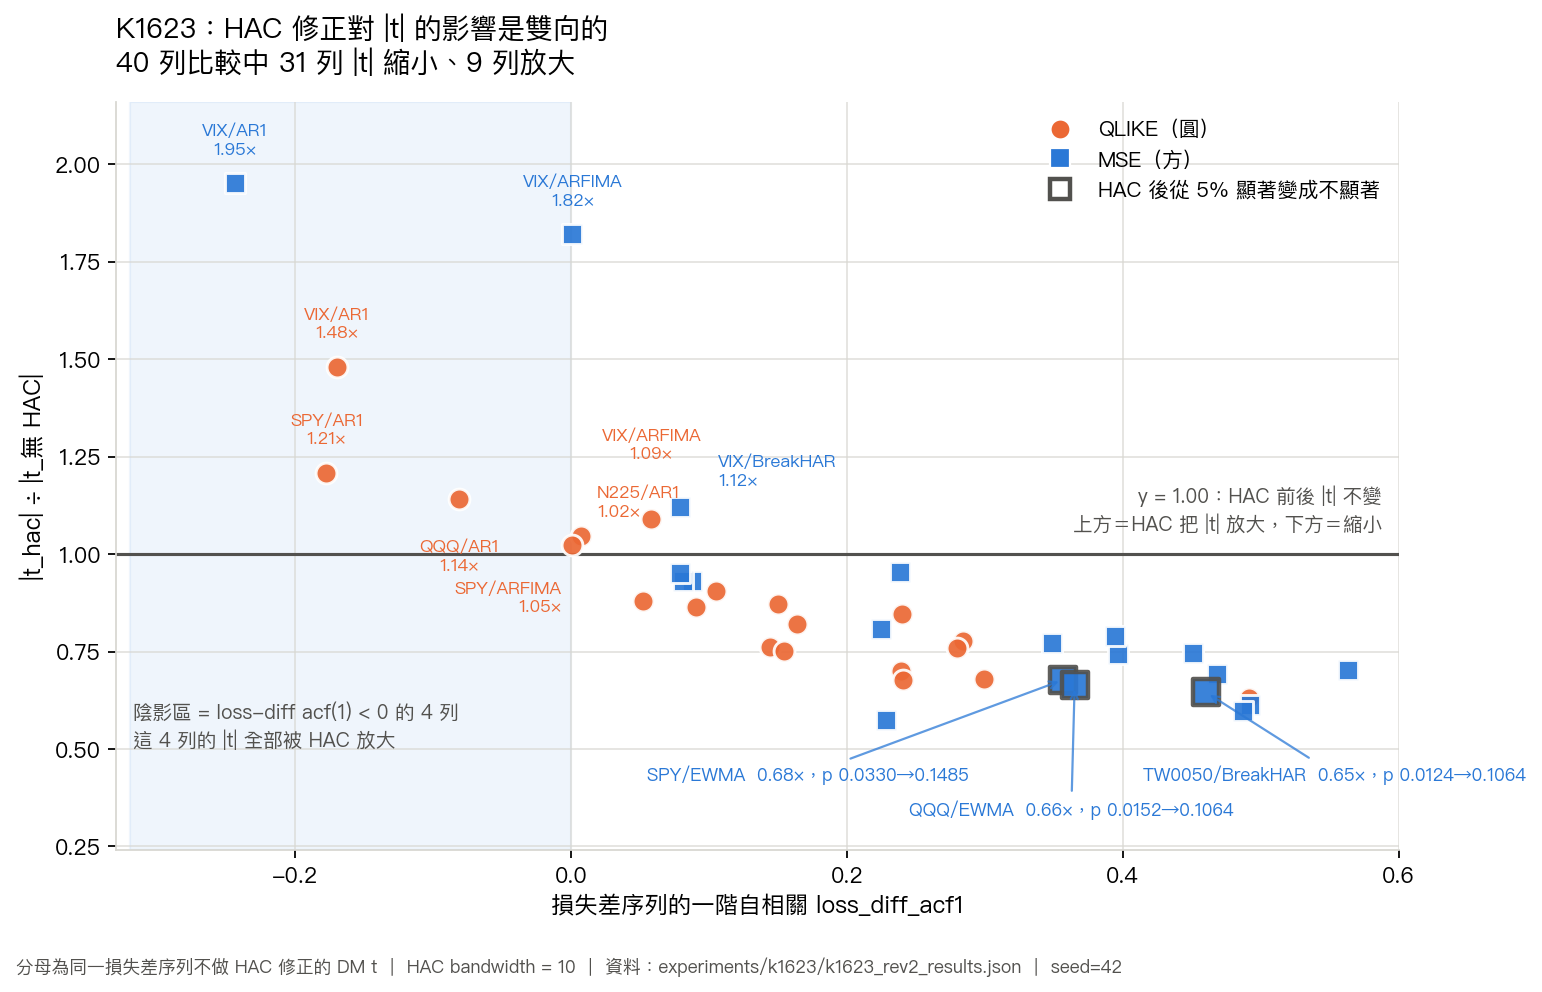
與不做 HAC 修正的同一統計量相比,40 列裡有 31 列 |t| 縮小、9 列放大。方向由損失差序列的一階自相關決定。
loss_diff_acf1 為負的列共 4 列,全部放大:SPY/QLIKE/AR1 從 2.52 變成 3.05,QQQ/QLIKE/AR1 從 4.72 變成 5.38,VIX/MSE/AR1 從 0.62 變成 1.21,VIX/QLIKE/AR1 從 0.36 變成 0.53。這在 Newey-West 的長期變異數估計裡是直接的:負的自協方差會把長期變異數壓小,標準誤跟著變小,|t| 因此變大。結果檔的 all_negative_acf1_rows_grew 欄位把這件事記成布林值 true。
反方向的三列則因為 HAC 從名目顯著掉到不顯著:SPY/MSE/EWMA 的 p 從 0.0330 變 0.1485,TW0050/MSE/BreakHAR 從 0.0124 變 0.1064,QQQ/MSE/EWMA 從 0.0152 變 0.1064。這三列的 acf(1) 分別是 0.357、0.460、0.365,正自相關強,長期變異數被放大。
實務上的含意很窄但很具體:看到一份漏做 HAC 的 h=1 DM 檢定,不能直接假設它的顯著性被高估。這份資料裡放大幅度最大的一列是 VIX/MSE/AR1,|t| 變成 1.95 倍;縮小最多的是 N225/MSE/EWMA,只剩 0.57 倍。兩個方向都在。
HAC bandwidth 全部是 10(公式 max(1, ceil(h^(1/3) n^(1/3))))。Harvey-Leybourne-Newbold 小樣本乘數在 h=1、n=749 下是 0.9993,對任何 5% 判定與 BH 結果都沒有影響;結果檔把 p_hac 與 p_hac_hln 兩欄都存下來,差異出現在小數第四位。
四、長記憶與可交易性:這批結果說不到的地方
第一,break-demean 之後殘留的 d̂ 不能用來拒絕純 level-shift(Diebold-Inoue)假說。
原因在檢定對象。Diebold-Inoue 講的 DGP 是隨機、可能密集的 level shift 過程。我們扣掉的是 Bai-Perron 在 BIC 下選出的至多 5 個(permissive 設定至多 15 個)決定性均值斷點。扣掉有限個決定性斷點之後仍有殘留慢衰減,正是那個 DGP 會產生的樣子,所以殘留的 d̂ > 0 對它沒有鑑別力。沒有任何識別定理支持這個推論。雪上加霜的是,去均值後的標準誤沒有考慮斷點日期是估出來的。
能說的只有描述性的一句:break-demean 後 d̂ 仍為正,BIC 設定下 0.46–0.65,permissive 設定下 0.19–0.58。要真的檢定真長記憶對假長記憶,需要 Qu (2011) 的 score 檢定、Shimotsu (2006) 的分割法或 Perron-Qu (2010),這三個都還沒實作。
第二,這批結果不能支持「這個長記憶成分不可交易」。
本實驗沒有跑過策略、沒有算過交易成本、沒有做過效用檢定。能說的版本窄得多:QLIKE 下 ARFIMA 與 BreakRobustHAR 都沒有在一步預測上贏過 HAR。至於能不能交易,本實驗不表態。
五、Monte Carlo:漸近 SE 低估了多少
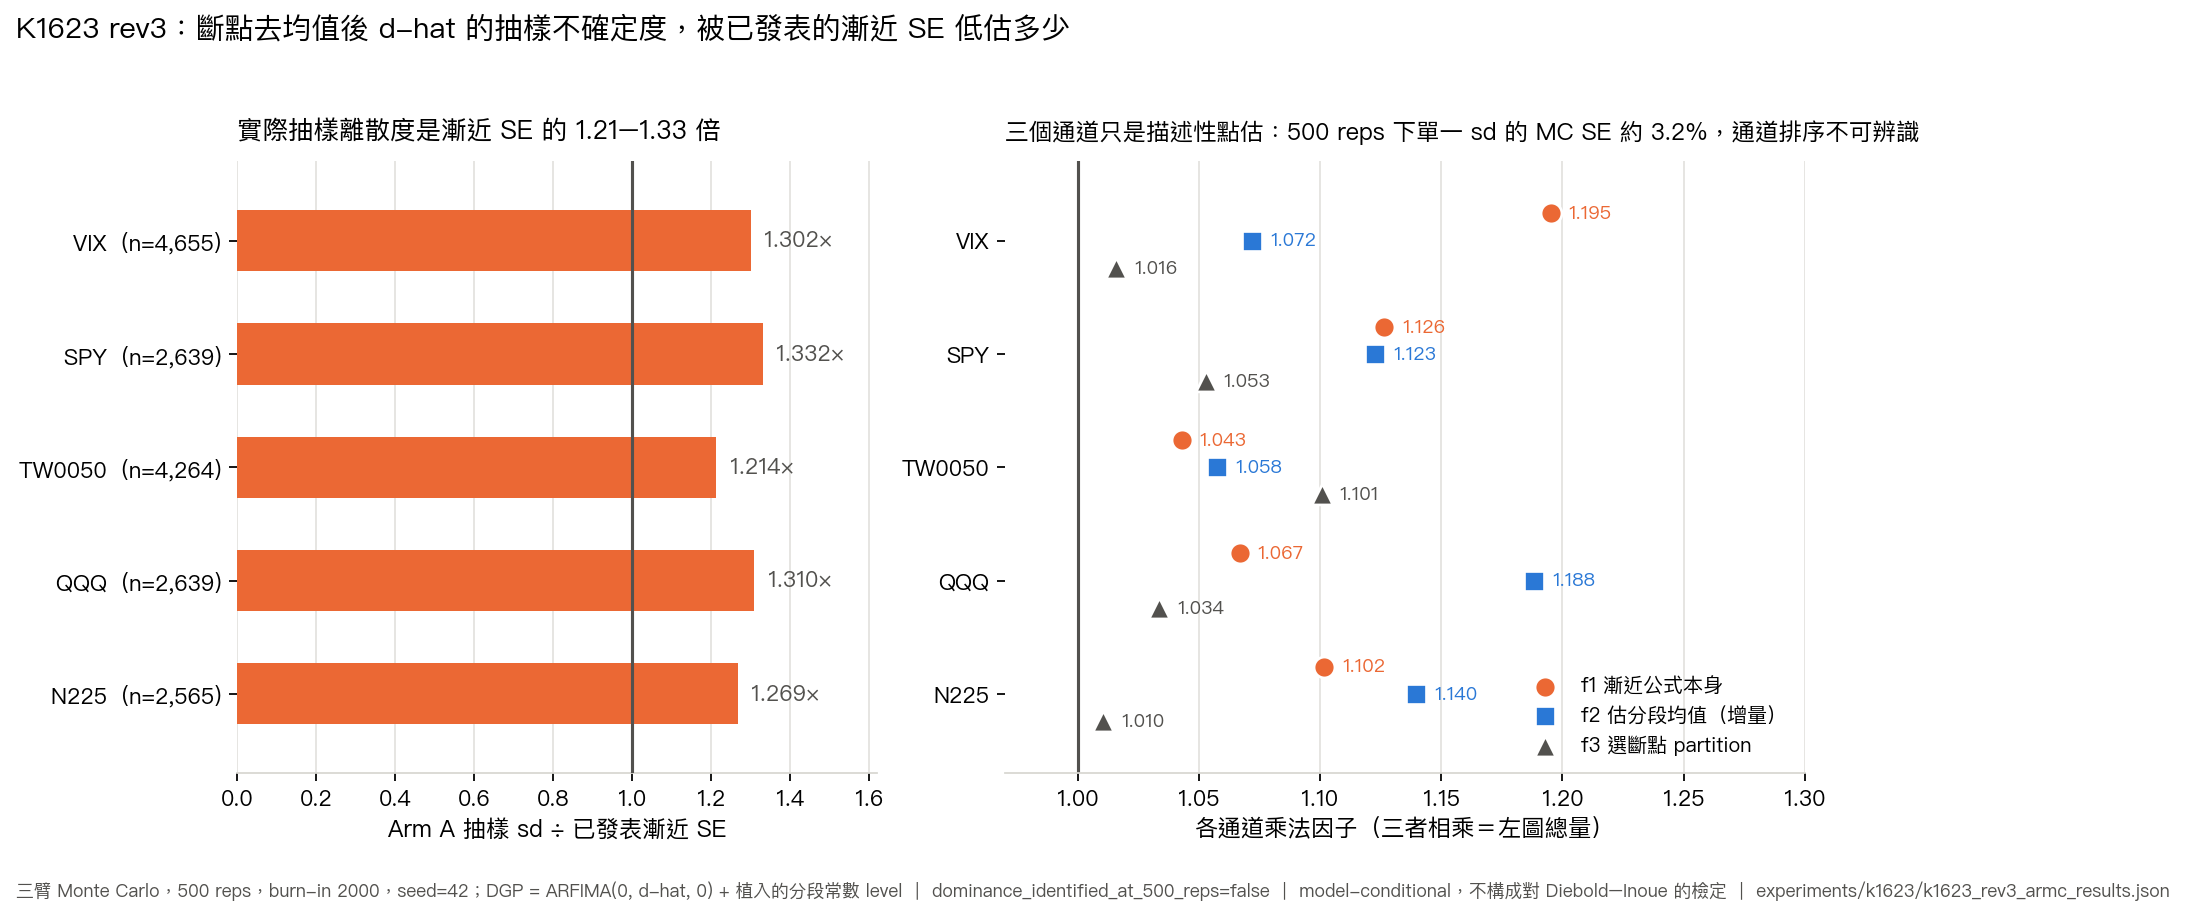
rev3 用 500 次重複、burn-in 2000、seed=42 的模擬,量化「斷點是估出來的」對 d̂ 抽樣分布的影響。DGP 是 ARFIMA(0, d̂, 0) 高斯創新,加上在估計出的斷點日植入的分段常數 level。三臂共用同一批模擬路徑:
- Arm A:Bai-Perron 重新估斷點 → 去均值 → ELW(真實流程)
- Arm B:在真實斷點 partition(數量+位置)上去均值,段均值仍從模擬資料估計 → ELW
- Arm C:直接扣掉已知的植入 level 向量 → ELW
偏差分解(相對於實際資料上配適出來的 d̂):
| 分量 | 定義 | 五資產範圍 |
|---|---|---|
| A−C | generated-regressor 總效果 | −0.0886 ~ −0.0457 |
| A−B | 選斷點 partition(數量+位置) | −0.0556 ~ −0.0200 |
| B−C | 估 n_breaks+1 個段均值的增量成本 | −0.0431 ~ −0.0225 |
| C−配適值 | ELW 自身的有限樣本行為 | +0.0008 ~ +0.0183 |
B−C 這一列的措辭要小心。Arm C 不是 zero-mean oracle:local_whittle(exact=True) 內部仍然扣掉一個樣本總均值,三臂都扣。所以 B−C 量到的是「估 n_breaks+1 個段均值相對於單一 demeaning 的增量」,不是「估任何均值的總成本」。把它讀成後者,會誇大估段均值的成本。
離散度那一側更值得記住。Arm A 的抽樣 sd 除以已發表的漸近 SE,五個資產分別是 VIX 1.302、SPY 1.332、TW0050 1.214、QQQ 1.310、N225 1.269。已發表的那個 SE 是 ELW 的原始漸近式 1/(2√m),它不知道斷點日期是估出來的,因此是真實抽樣不確定性的下界。
總量可以再乘法拆成三個通道:f1(漸近公式自身的樂觀程度)1.043–1.195、f2(估段均值)1.058–1.188、f3(選斷點 partition)1.010–1.101,三者相乘等於總量。這三個數字是描述性點估。500 次重複下,單一 sd 的相對 Monte Carlo SE 約 3.2%,而且逐次重複的抽樣值沒有保留,配對排序檢定算不出來,所以 dominance_identified_at_500_reps 是 false,逐資產的主導通道沒有被識別,本文也不指定。只有 1.21–1.33 倍這個總量離 3.2% 的雜訊尺度夠遠。
整個模擬是 model-conditional 的:它假設 DGP 真的就是 ARFIMA 加決定性斷點。在那個前提下細分抽樣不確定性的來源是有意義的,但它不能拿來檢定那個前提,更不能拿來檢定 Diebold-Inoue。
六、這篇不主張什麼
- 不主張真長記憶存在。 本實驗沒有能鑑別真假長記憶的檢定,殘留的 d̂ 只是描述性統計。
- 不主張 ARFIMA 在 MSE 下比 HAR 好。 5 個 ARFIMA-vs-HAR 的 MSE 比較,p 值在 0.2654–0.9744。
- 不主張 HAR 在 QLIKE 下比 ARFIMA 好。 唯一名目顯著的那格 BH 後不存活。
- 不對可交易性表態。 從未跑過策略、成本或效用檢定。
- 不主張任何通道主導 SE 低估。 500 reps 下通道排序不可辨識。
- VIX 的 d̂ 最不可信。 原始 ELW d̂ = 0.723 落在非平穩區,而實作用樣本均值去均值,在該區間不是有效的 level 估計。VIX 的 permissive 斷點又取到上限 15/15,20.3% 的 level-shift 份額在上方是開放的。
- FD_MAXK = 2000 對每個資產都 binding。 n 落在 2,565–4,655,分數差分濾波器的截斷在每個資產都咬到,d 越大咬得越深。
- 樣本外只有 h=1。 h=5/22 帶重疊預測的 HAC 尚未測試。
- RV proxy 是日線 Parkinson high-low 範圍。 日內歷史只有約 115 天,太短;測量誤差會影響 d̂ 的水準。
七、重現範圍要說得比「重現成功」更精確
本實驗把資料 vintage 釘死(VIX/SPY/QQQ 到 2026-07-02,TW0050/N225 到 2026-07-03),t 統計以這個 vintage 為準。
重現守衛檢查了 100 個 cell。VIX、SPY、QQQ、N225 四個資產的四個彙總 functional(qlike_mean、qlike_median、mse、clip_hit_rate)對原 artifact 的最大相對偏離是 0.0,容忍度 1e-9。
這句話的射程要壓住。原 artifact 從來沒有儲存逐期預測向量,所以逐點比對做不到。1e-9 一致證明的是「重現出來的彙總損失相同」,這是預測路徑一致的強證據,不是證明。
TW0050 是近似重現。它的快取歷史被上游修訂過,不只是延長:在釘死的結束日,一列原本 high==low 的退化資料現在 high > low 而被保留,n 從 4263 變成 4264,最大相對偏離 5.26e-3。凡是「同一批預測、同一個樣本」這類敘述,對 TW0050 都是錯的。
八、可重現
uv run python experiments/k1623/k1623_rev2.py
uv run python experiments/k1623/k1623_rev3_armc_mc.py
40 個 DM 比較、HAC 稽核欄位與多重比較校正在 experiments/k1623/k1623_rev2_results.json;三臂 Monte Carlo 在 experiments/k1623/k1623_rev3_armc_results.json。本文三張圖的產生腳本在 storage/article_charts/k1623_research/gen_k1623_research_charts.py,執行時直接讀這兩份 JSON,不硬編任何統計量。
資料來源:VIX((VIX/100)^2)與 SPY/TW0050/QQQ/N225 的日線 Parkinson 高低價範圍波動率,n = 2,565–4,655,樣本外一步預測 749 筆,seed = 42。Codex 覆核紀錄在 experiments/k1623/review_round5_codex_20260723.md,verdict PASS。
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊