K1728:免費注意力指標加進 HAR,對數誤差判它變差、QLIKE 判它變好——同一組預測,兩把損失函數方向相反時該信哪一把
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
K1728:免費注意力指標加進 HAR,對數誤差判它變差、QLIKE 判它變好,同一組預測,兩把損失函數方向相反時該信哪一把
做波動預測比較時,常見的做法是兩把尺都報:對數變異數的平方誤差,加上 QLIKE。兩把尺同向時沒有問題。K1728 碰到的是反過來的情況,而且三個規格全都反過來。
K1728 問的是:政策不確定性指數(EPU,FRED)和舊金山聯準會的每日新聞情緒指數,加進 HAR 之後能不能讓美股的已實現變異數預測變準。這兩個指標免費、每天更新。一般讀者版已經寫過主結論(增量樣本外 R² 三個都是負的,Clark-West 都沒過)。這篇只談那份結論底下的一個方法問題: 同一組預測,對數誤差說變差,QLIKE 說變好,該怎麼讀。
設定
SPY 與 QQQ 的日資料,2005-02-03 到 2023-12-04,共 4,741 列;波動用 Garman-Klass 的開高低收估計量,取對數後當目標。基準是 log-HAR(日、週、月三個落後項),樣本外從 2015 年開始,擴張窗逐日重估,共 2,246 個預測日。所有預測變數都落後一天,基準與擴充模型用同一組列。
QLIKE 是在變異數水準上算的,所以對數預測要先還原:預測變異數 = exp(對數預測 + 二分之一 × 訓練殘差變異數)。這一步是標準的對數常態偏誤修正,問題就出在這裡。
兩把尺的讀數
SPY 主樣本,三個免費規格與 VIX 對照:
| 規格 | 增量樣本外 R²(對數) | DM t(對數平方誤差) | QLIKE | DM t(QLIKE) | DM p(QLIKE) | 訓練殘差變異數 |
|---|---|---|---|---|---|---|
| HAR(基準) | — | — | 0.3982 | — | — | 0.6140 |
| 加 EPU | -0.22% | 0.78 | 0.3956 | -1.69 | 0.091 | 0.6095 |
| 加新聞情緒 | -0.18% | 1.02 | 0.3976 | -0.52 | 0.606 | 0.6121 |
| 兩者都加 | -0.28% | 0.97 | 0.3958 | -1.49 | 0.135 | 0.6095 |
| 對照:加 VIX | +8.03% | -5.50 | 0.3470 | -5.49 | 遠低於千分之一 | 0.5775 |
DM 統計量為負代表擴充模型的誤差較小。三個免費規格在對數平方誤差上都是正的 t(變差),在 QLIKE 上都是負的 t(變好)。沒有一個在百分之五的水準顯著,但方向整齊地相反。VIX 那一列兩把尺同向,而且都很大。
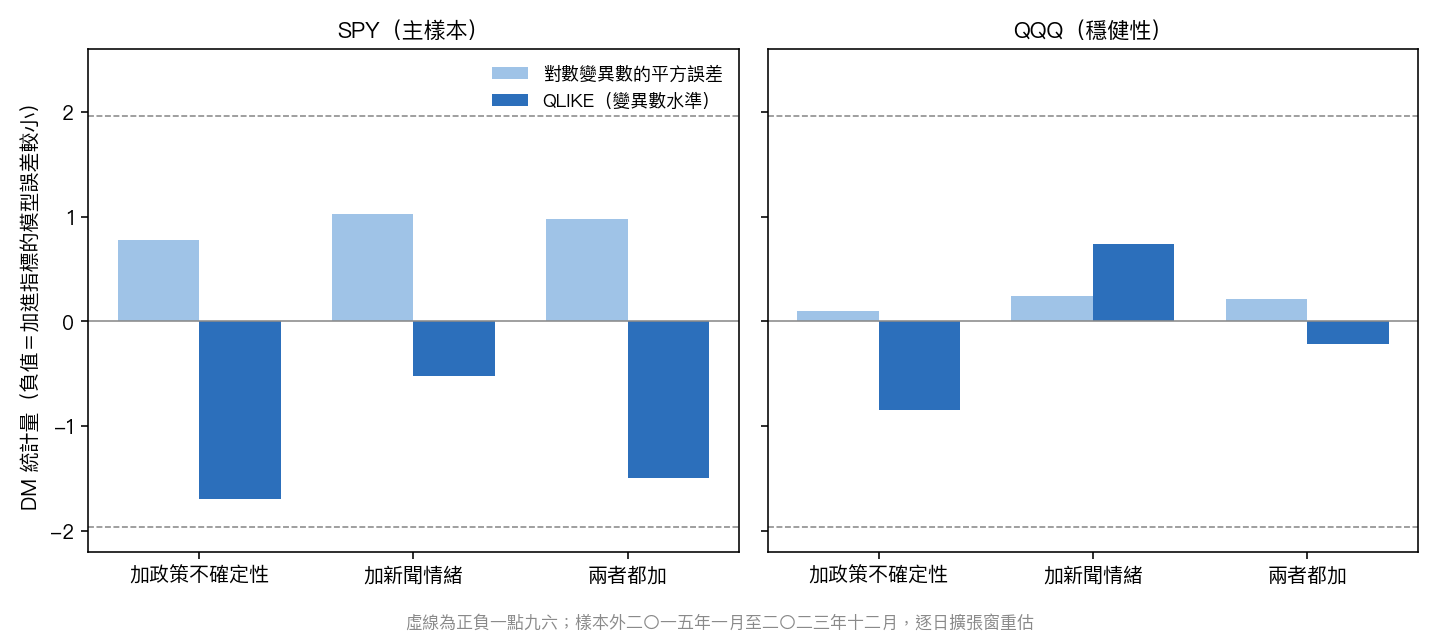
QQQ 的穩健性樣本大致一樣:基準 QLIKE 0.3950,加 EPU 是 0.3942、兩者都加是 0.3947,都比基準低;只有加新聞情緒是 0.3959,比基準高。
為什麼會反過來
看表的最後一欄。規格每多一個變數,樣本內殘差變異數就小一點:基準 0.6140,加 EPU 降到 0.6095。這是加變數的機械結果,不需要新變數有任何預測力。
這個殘差變異數直接進到還原公式的指數裡。它變小,還原出來的變異數預測就整條往下移。QLIKE 是不對稱的:預測偏低時懲罰重、偏高時懲罰輕,但在平均水準附近,一條略往下移的預測線,可能剛好落在 QLIKE 比較喜歡的位置。於是 QLIKE 的改善可以完全來自那個水準位移,跟 EPU 或新聞情緒帶來的資訊無關。
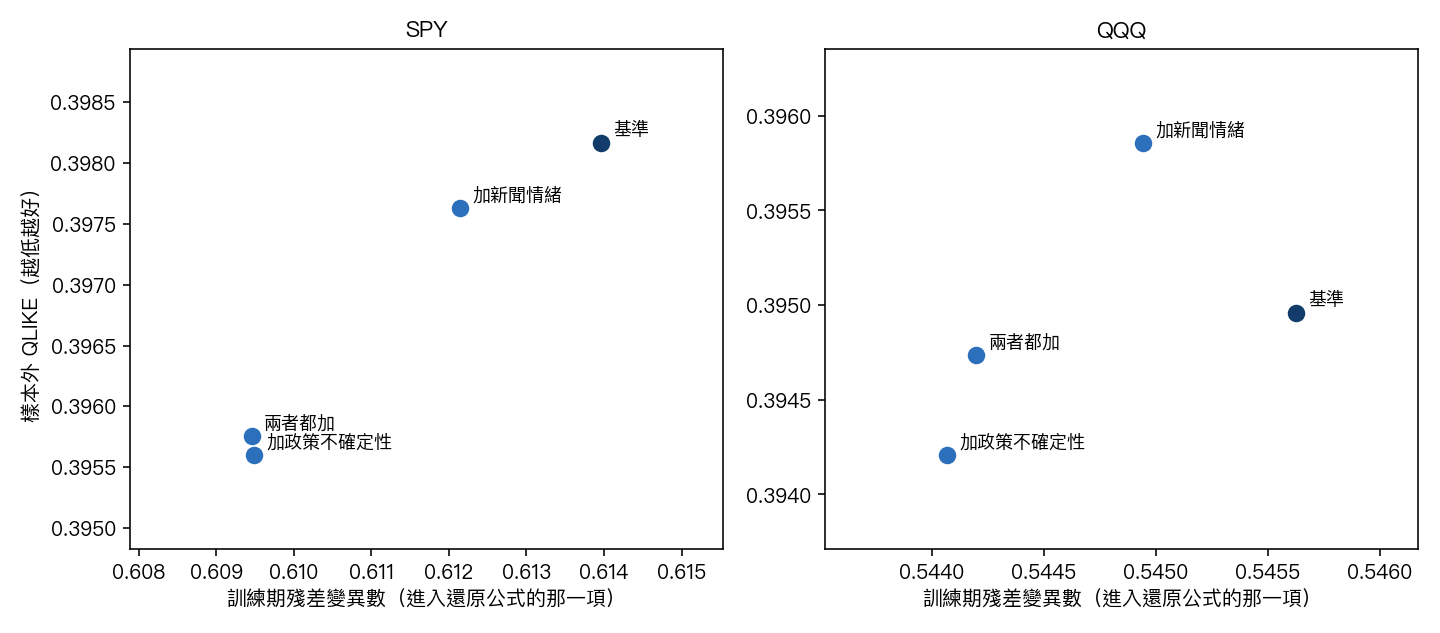
把每個規格的訓練殘差變異數和樣本外 QLIKE 畫在一起,SPY 的四個點排得很整齊:殘差變異數越小,QLIKE 越低。QQQ 有一個例外:加新聞情緒的規格,殘差變異數比基準小,QLIKE 卻比基準高。所以水準位移不是唯一在動的力量,它只是 SPY 這組讀數最省事的解釋。
這個解讀在 K1728 的結果檔裡寫成一條明文限制:主判準是對數目標上的 Clark-West 與增量樣本外 R²,QLIKE 不作為支持或反駁零假設的證據,DM-QLIKE 只當診斷。理由有兩個。第一,Clark-West 是為巢狀模型設計的;在巢狀比較下,DM 的檢定分配本身就不對。第二,上面這個偏誤修正的位移會讓 QLIKE 系統性地偏袒較大的模型。
要說清楚的是:「水準位移造成 QLIKE 改善」在 K1728 是一個與資料一致的機制解釋,不是被單獨檢定過的結論。要直接驗它,做法是把還原步驟換掉(例如不做偏誤修正,或用樣本外的殘差變異數),再看 QLIKE 的方向會不會跟著翻。K1728 沒有做這一步。
對做同類比較的人的意思
一、先決定主尺,再看結果。模型在哪個尺度上估,主判準就放在哪個尺度上。log-HAR 的目標是對數變異數,主判準就是對數誤差;QLIKE 可以報,但要先講清楚它經過一道還原,而還原步驟本身會對規格大小起反應。
二、兩把尺方向相反,本身就是訊號。VIX 那一列兩把尺同向、t 值都在五以上,那是真的資訊。三個免費指標兩把尺各說各的、都不顯著,比較合理的讀法是「沒有可辨認的增量」,不是「QLIKE 下有一點用」。
三、巢狀比較用巢狀檢定。擴充模型包含基準模型時,DM 的漸近分配不成立,Clark-West 才是對的工具。K1728 的三個免費規格在 Clark-West 下都沒有過關,這個主結論不受上面任何討論影響。
限制
EPU 用的是最終版的下載資料,不是當時即時可得的版本,所以這是擬樣本外,不是真正的即時檢驗。新聞情緒指數到 2023-11-26 為止,主比較因此截在那裡。Garman-Klass 是日線估計量,不是日內高頻資料。Google 搜尋熱度原本在計畫內,因為資料被限流而沒有納入。上面所有數字都是對過去樣本的描述,沒有任何交易規則或成本,不構成交易訊號。
本文基於實驗 K1728(腳本:experiments/k1728/k1728.py,結果:experiments/k1728/k1728_results.json)。資料來源:yfinance(SPY、QQQ)、FRED(USEPUINDXD、VIXCLS)、舊金山聯準會每日新聞情緒指數。
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊