0050 的波動有 46% 發生在收盤之後:把一天拆成兩段,預測誤差少掉兩成
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
台股九點開盤到下午一點半收盤,你能盯著盤。剩下的十九個半小時,美股開了又收,你在睡覺。
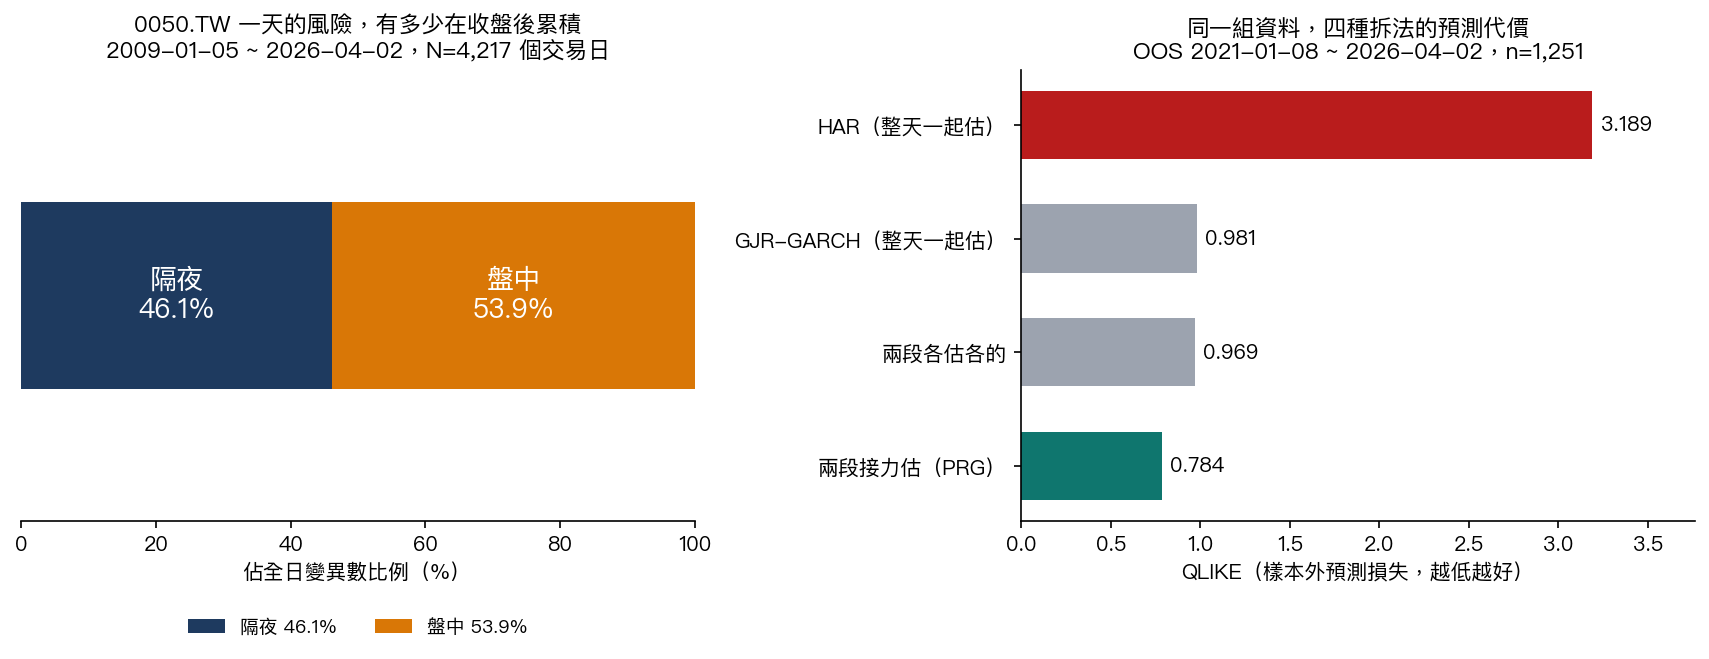
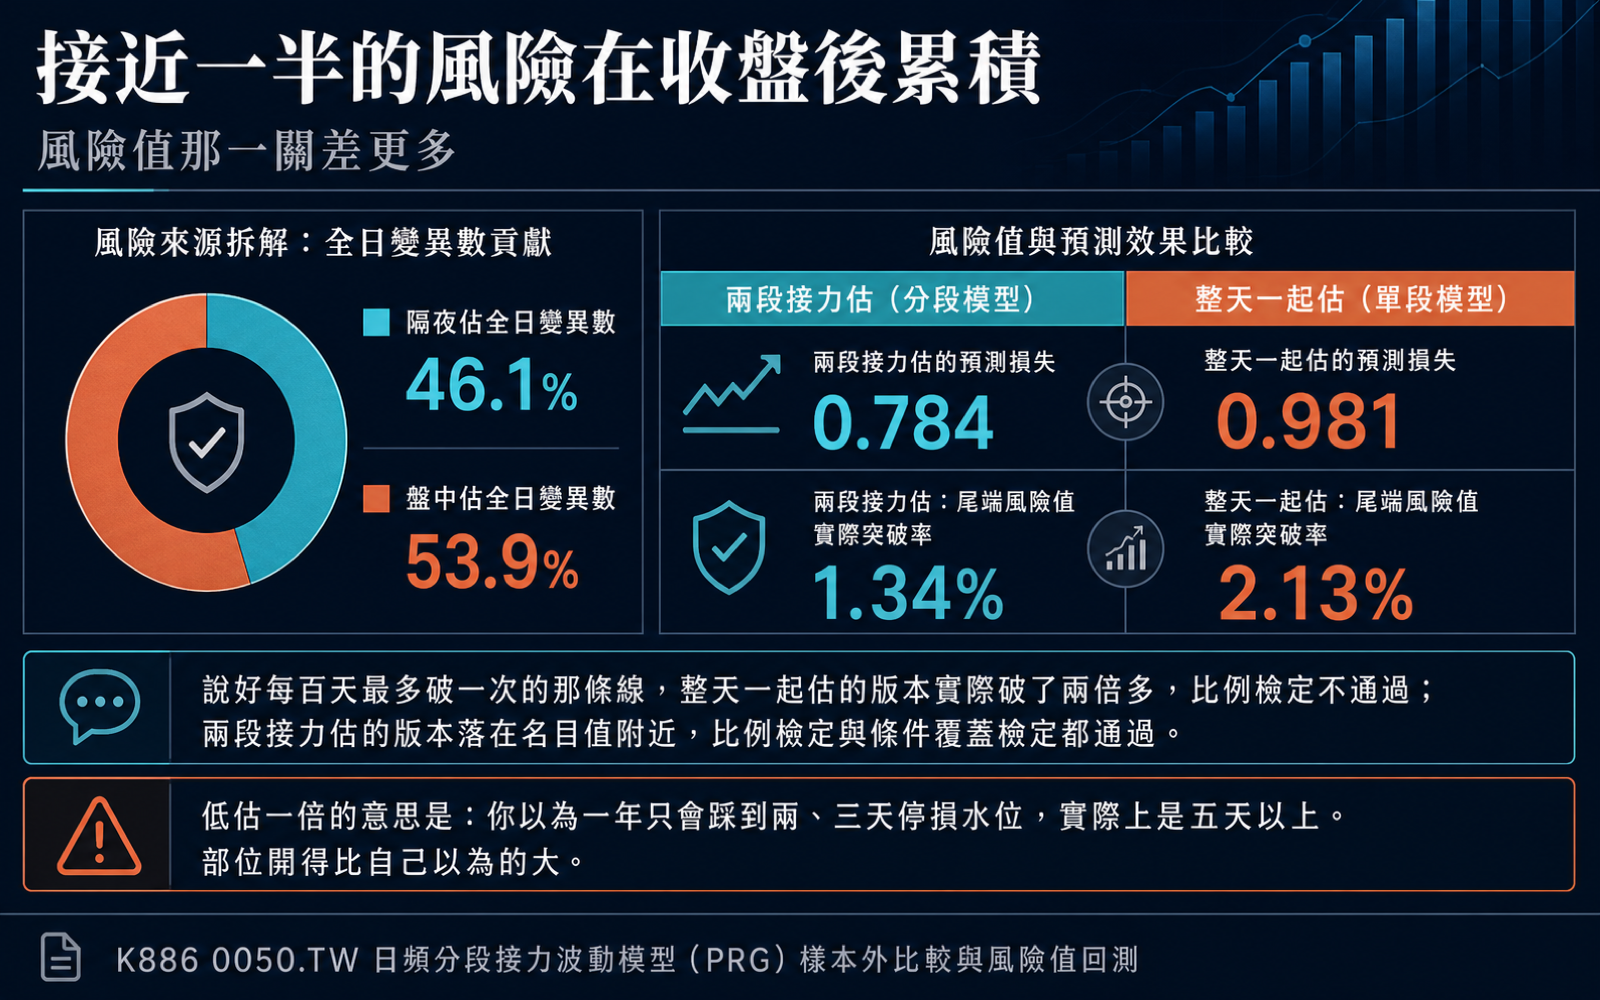
那段時間 0050 的風險並沒有停下來。我把 2009 年 1 月 5 日到 2026 年 4 月 2 日、共 4,217 個交易日的全日波動拆成兩段,收盤到隔天開盤那一段佔了 46.1% ,盤中那一段 53.9%。接近一半的風險,是在你看不見的時候累積的。
這個數字本身不算新聞,台股跟著美股走,大家都知道。有意思的是下一步:既然這一天明顯是兩段拼起來的,那用一條式子把它當成連續的一天來估波動,會不會估歪?
先把資料的坑講清楚
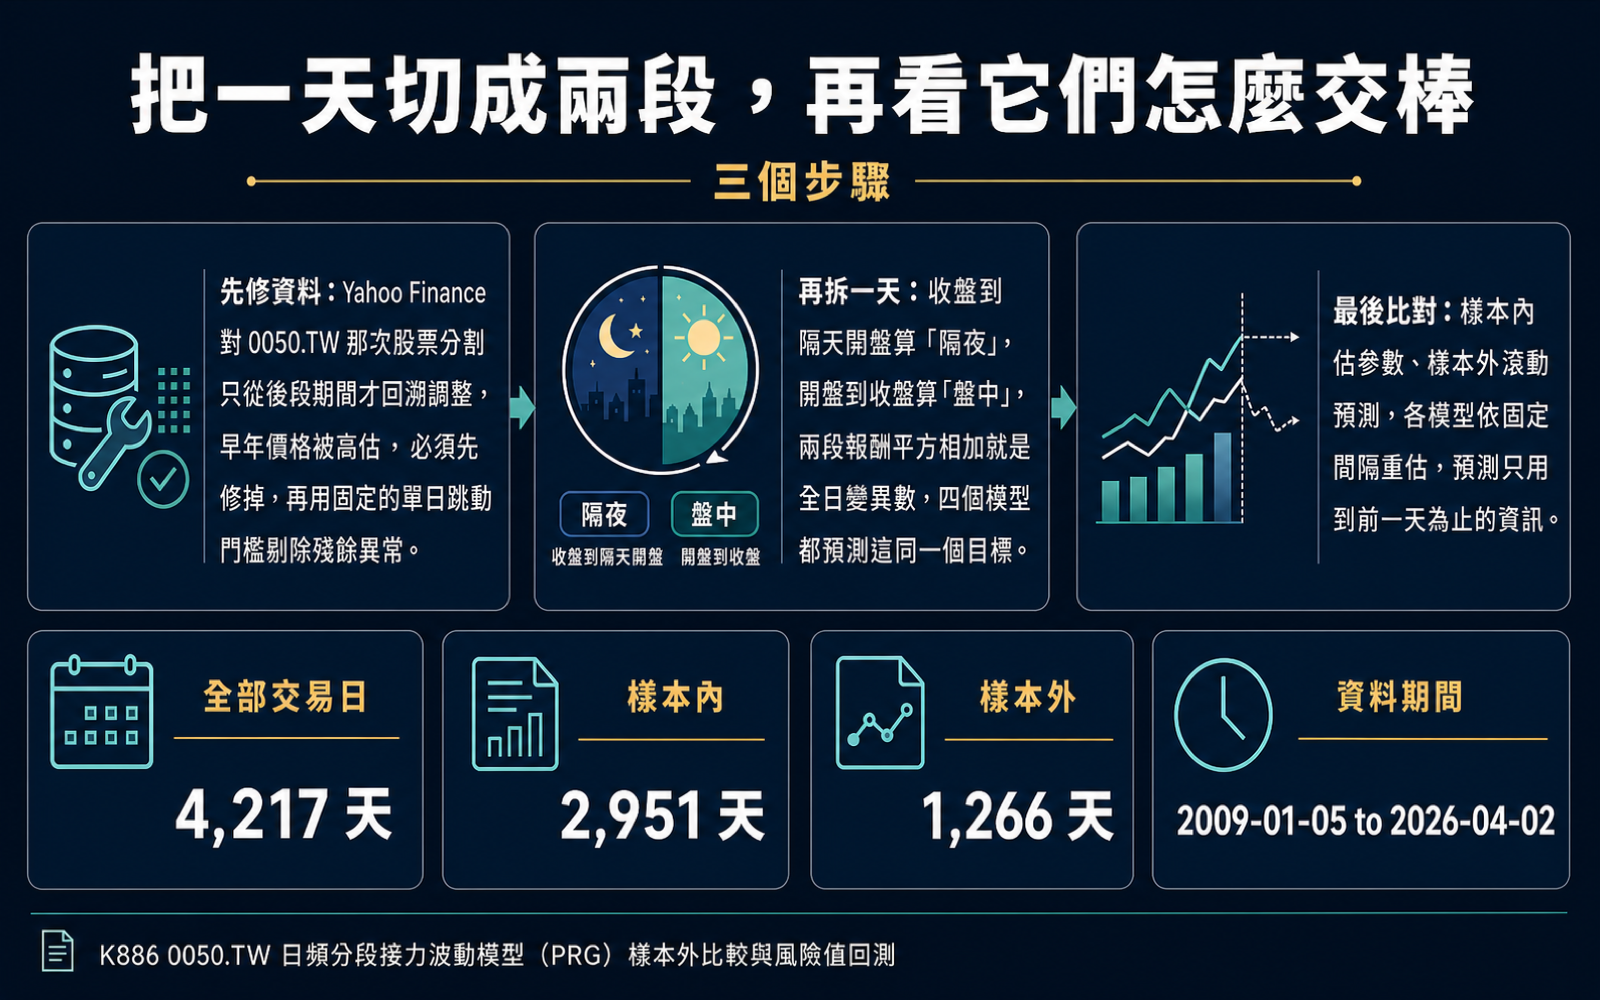
Yahoo Finance 的 0050 日線有個陷阱:2008 年那次一股拆四股,它只從 2014-01-02 之後才回溯調整,2014 年以前的價格通通高了四倍。直接抓下來跑,2013 年底會冒出一根假的暴跌。這份資料先修掉分割,再用單日 25% 的門檻剔除殘留的異常跳動(比美股常用的 20% 寬一點,因為台股有漲跌幅限制,真正的極端值長相不一樣)。
早期 2,951 天(2009-01-05 ~ 2021-01-07)拿來估參數,後面 1,266 天(2021-01-08 ~ 2026-04-02)完全不給模型看,只用來驗收。每個模型都定期滾動重估,而且每一次預測只用得到前一天為止的資訊。
四種拆法,四種代價
我讓四個做法用同一個目標打對台:預測「隔夜的波動幅度 + 盤中的波動幅度」加起來的全日波動。
| 做法 | 預測誤差(越低越好) | 排序準確度 |
|---|---|---|
| 多時間尺度平均法(日線近似版) | 3.189 | 0.282 |
| 整天一起估的標準波動模型 | 0.981 | 0.305 |
| 兩段各估各的 | 0.969 | 0.316 |
| 兩段接力估 | 0.784 | 0.440 |
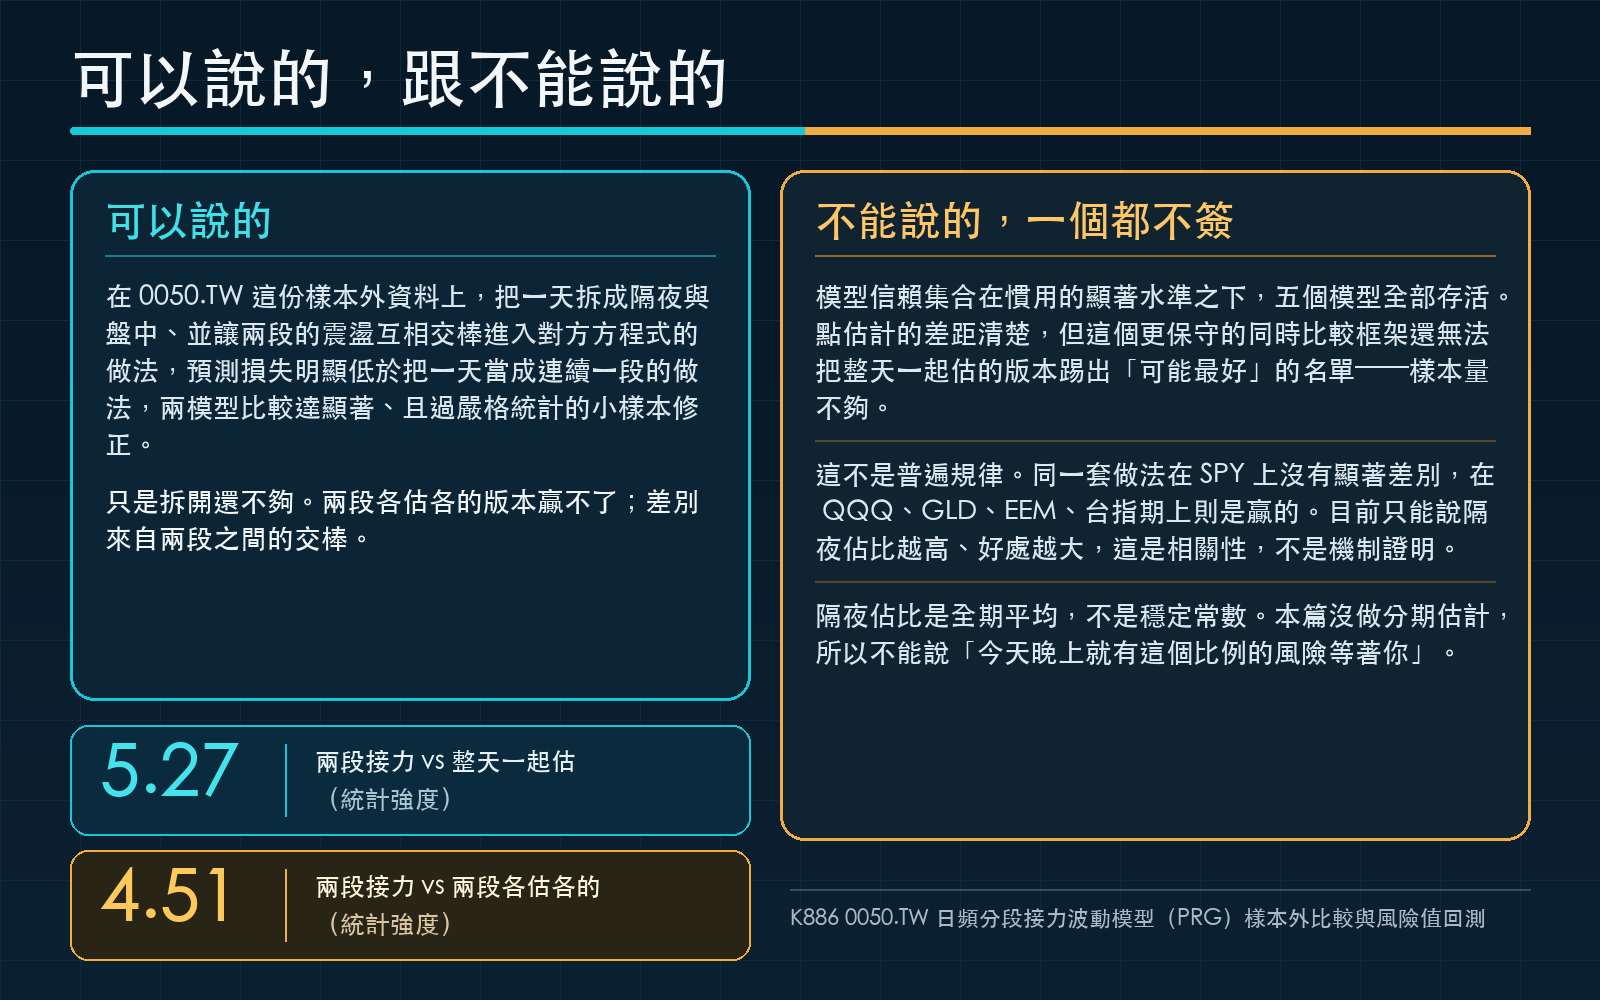
驗收期共有 1,251 個可比較的日子。接力估法的誤差比整天一起估低了兩成,正式的兩模型比較檢定 統計檢定高度顯著(強度很強,統計值 5.27),連小樣本修正都過得去。排序準確度那一欄講的是另一件事:模型說「今天比較抖」的時候,實際上真的比較抖嗎,整天一起估是 0.305,接力估法 0.440。
「各估各的」跟「接力估」差在哪?各估各的是把隔夜和盤中當成兩件互不相干的事,各跑一條式子再加起來。接力估是讓昨天盤中的震盪進到今晚隔夜的算式、今晚隔夜的震盪再進到明天盤中的算式,資訊在兩段之間交棒。這一步不是裝飾:接力估對上各估各的,t=−4.51,同樣過修正。 拆開有用,但拆開之後還得接回去,才是效果的來源。
至於第一列那個 3.189,我不打算幫它辯護,也不打算拿它當靶。手上沒有日內每分鐘的資料,那個做法只能用日報酬去堆一個近似版,結果它系統性地把波動估太高(把預測值拿去對實際值做回歸,斜率跑到 3.05,正常應該接近 1)。它在這份資料上被淘汰,說的是這個近似實作不行,不是原始方法不行。
翻成風控看得懂的話
誤差少 0.2 是多少?換個口徑:假設你用模型算 1% 的風險值,說好每 100 天最多破 1 次的那條線。
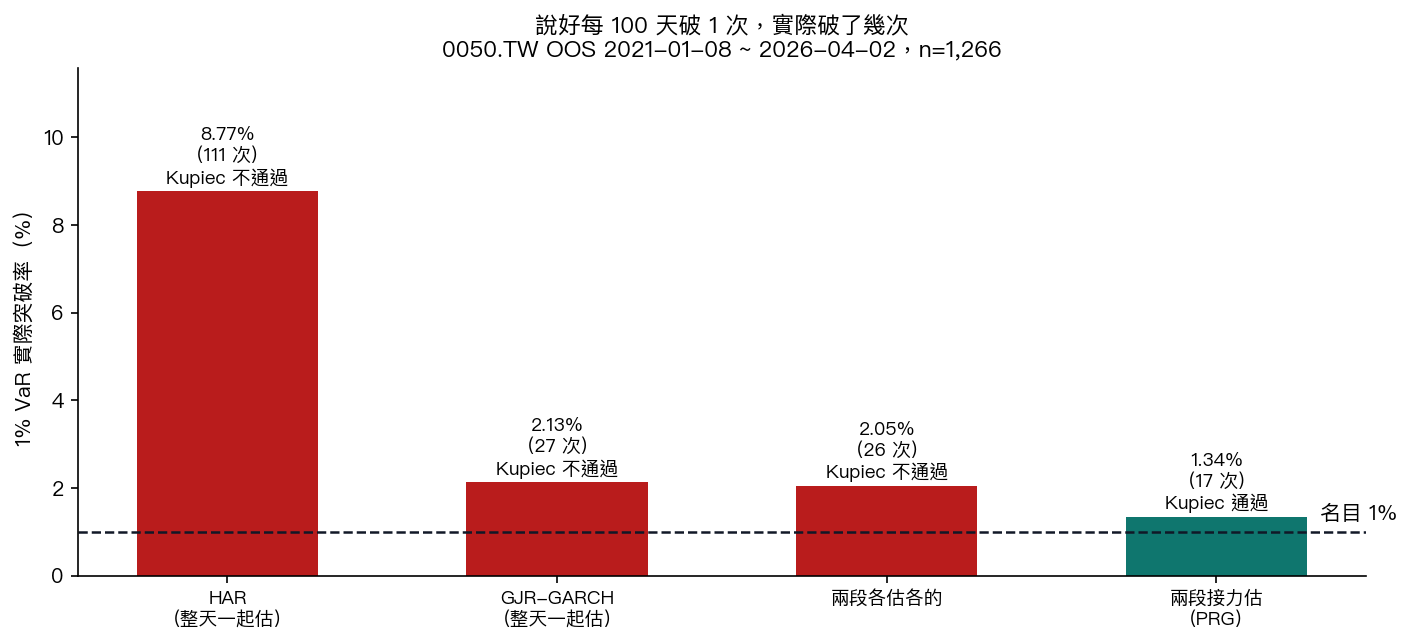
驗收期 1,266 天裡,整天一起估的版本破了 27 次,突破率 2.13%,是名目值的兩倍多,比例檢定 高度顯著(顯著性 0.0004),不通過。日線近似版破 111 次,8.77%,直接崩掉。接力估法破 17 次,1.34%,比例檢定 未達顯著水準(顯著性 0.244) 通過,再檢查「破線會不會擠在一起」的條件覆蓋檢定 未達顯著水準(顯著性 0.242),也通過。
5% 那條線也一樣:接力估法破 58 次、4.58%,兩個檢定都過。在這五個做法裡,它是唯一在 1% 和 5% 兩個水準、兩個檢定全部通過的。
低估風險兩倍是什麼概念,你以為一年會有 2.5 天踩到停損水位,實際上有 5.4 天。部位開得比自己以為的大。
三件不該省略的事
第一,更嚴格的那套框架沒有淘汰任何人。 模型信賴集合是一種同時比較所有模型的做法,在慣用的門檻之下,這五個做法全部存活。這句話很不好聽但必須寫:以 1,251 天的樣本量,誤差的點估計差距明明白白,可是這個更保守的框架還無法把整天一起估的版本踢出「可能最好」的名單。前面那些 t 值是兩兩比較,這個是同時比較,後者對多重比較的懲罰重得多。要說「接力估法確定比較好」,這份樣本還不夠。
第二,這不是普遍規律。 同一套做法在 SPY 上,t=−0.57,沒有顯著差別。在 QQQ(統計檢定高度顯著(強度很強,統計值 4.26))、黃金 GLD(6.12)、新興市場 EEM(6.63)、台指期(5.10)上則是贏的。目前對得起來的圖像是:隔夜波動佔比越高的標的,分段接力估的好處越大——0050 的 46.1% 是所有日頻標的裡最高的。SPY 的隔夜佔比低,好處自然消失。但這是五、六個市場歸納出來的相關性,不是機制證明,把它當成定律會出事。
第三,46.1% 是全期平均。 它不是一個穩定常數,2020 年那種美股熔斷的時期跟 2024 年的平靜期不會一樣。這篇沒有做分期估計,所以我不能說「今天晚上有 46% 的風險等著你」。
所以呢
如果你持有 0050,而你的風險數字是拿一條「把一天當成一天」的模型算出來的,這份資料建議你去確認一件事:那條模型有沒有把收盤後那十九個半小時當一回事。以驗收期 1,266 天的表現看,沒當一回事的版本,把 1% 的尾巴風險低估了一倍。
至於要不要相信「接力估法比較好」,兩兩比較說是,同時比較說還不能斷定。我把兩個都寫在這裡,你自己拿捏。
資料:0050.TW 日線(yfinance,經分割修正),2009-01-05 ~ 2026-04-02,共 4,217 天。驗收期 2021-01-08 ~ 2026-04-02,1,266 天。方法參考 Bollerslev & Ghysels (1996)、Corsi (2009)、Patton (2011)、Hansen-Lunde-Nason (2011)、Kupiec (1995)、Christoffersen (1998)。完整結果:experiments/k886/k886_prg_0050tw_results.json。
懶人包圖組
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊