「我們在五個標的上都測過」:這句話要扣分,不是加分
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
投資研究報告裡有一句話很常見:「我們在五個標的上都測試過。」
聽起來像是加分。測得越多,看起來越扎實。
實際上,每多測一個標的,你就多給了運氣一次機會。統計上這筆帳要付錢,而且有公定價。
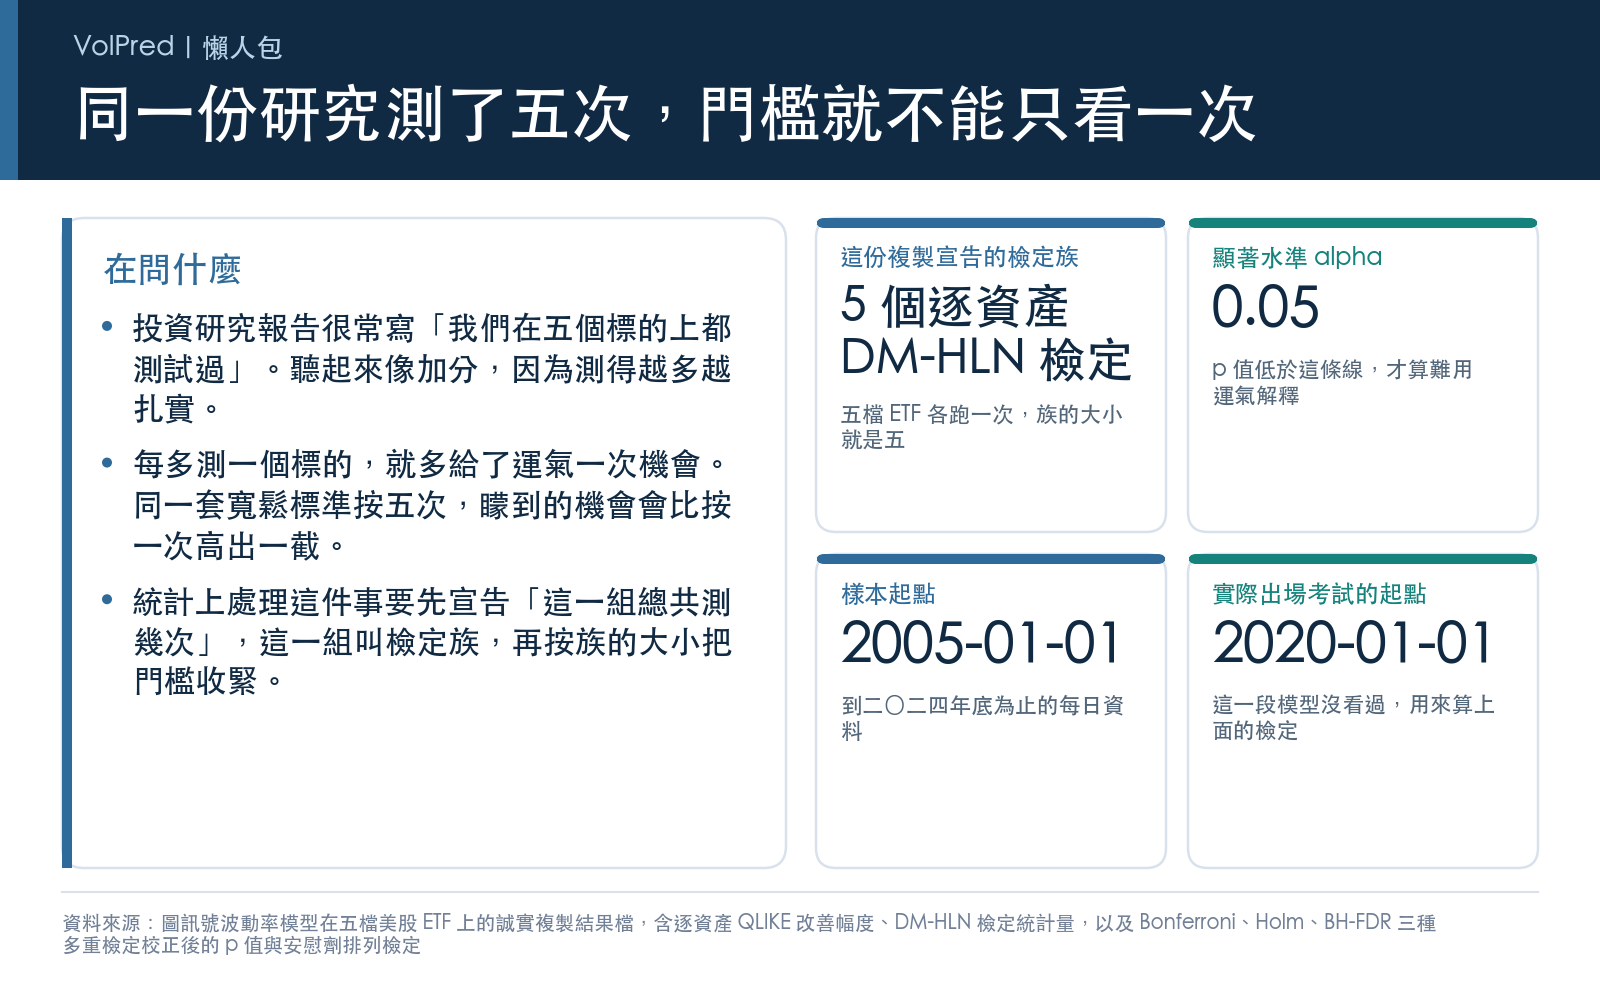
先講規則:測五次,門檻就不能只看一次
假設你用一個很寬鬆的標準:只要某個結果「碰巧到這種程度的機率低於 5%」,就算它有效。
只測一次,運氣矇到的機會是 5%。測五次,只要其中任何一次矇到就算贏,機會變成 1 減去 0.95 的五次方,大約 22.6%。同一套標準,因為你多按了四次按鈕,含金量就掉了一大截。
統計學處理這件事的方法叫多重檢定校正。做法是先宣告「我這一組總共測幾次」,這一組叫檢定族,然後按照族的大小把門檻收緊。
我們複製那篇圖訊號波動率模型的研究時,檢定族被寫死在結果檔裡: 5 個逐資產 DM-HLN 檢定 ,顯著水準 alpha = 0.05。五檔 ETF 各測一次,族的大小就是 5。
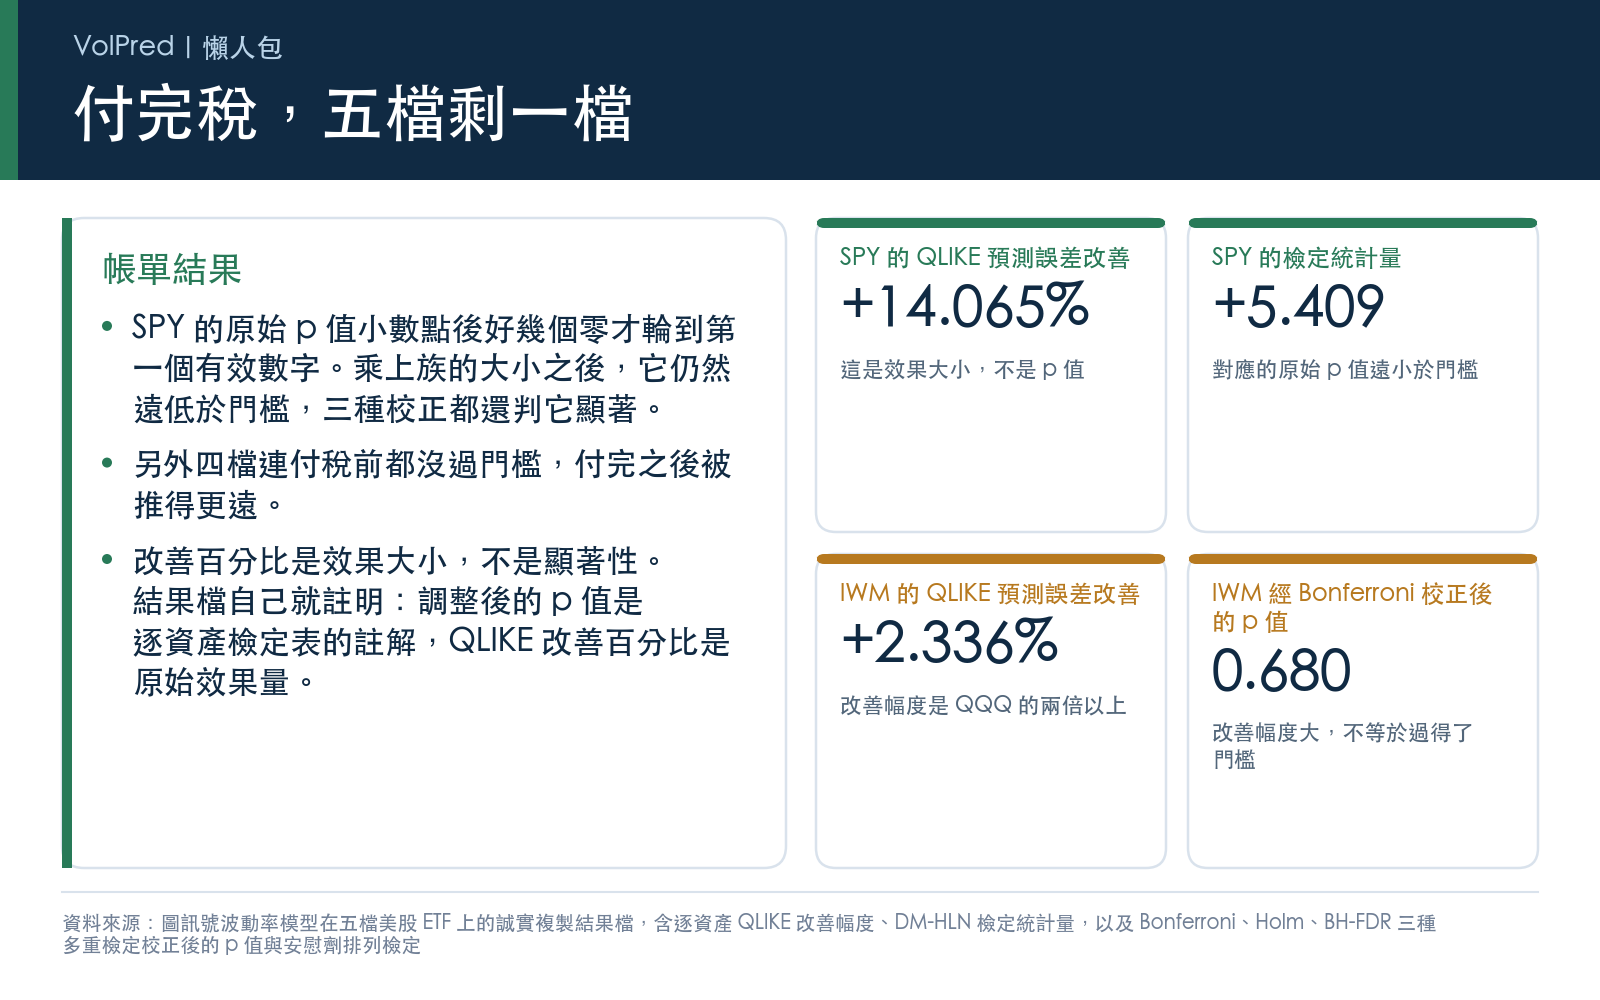
付完這筆稅,五檔剩下一檔
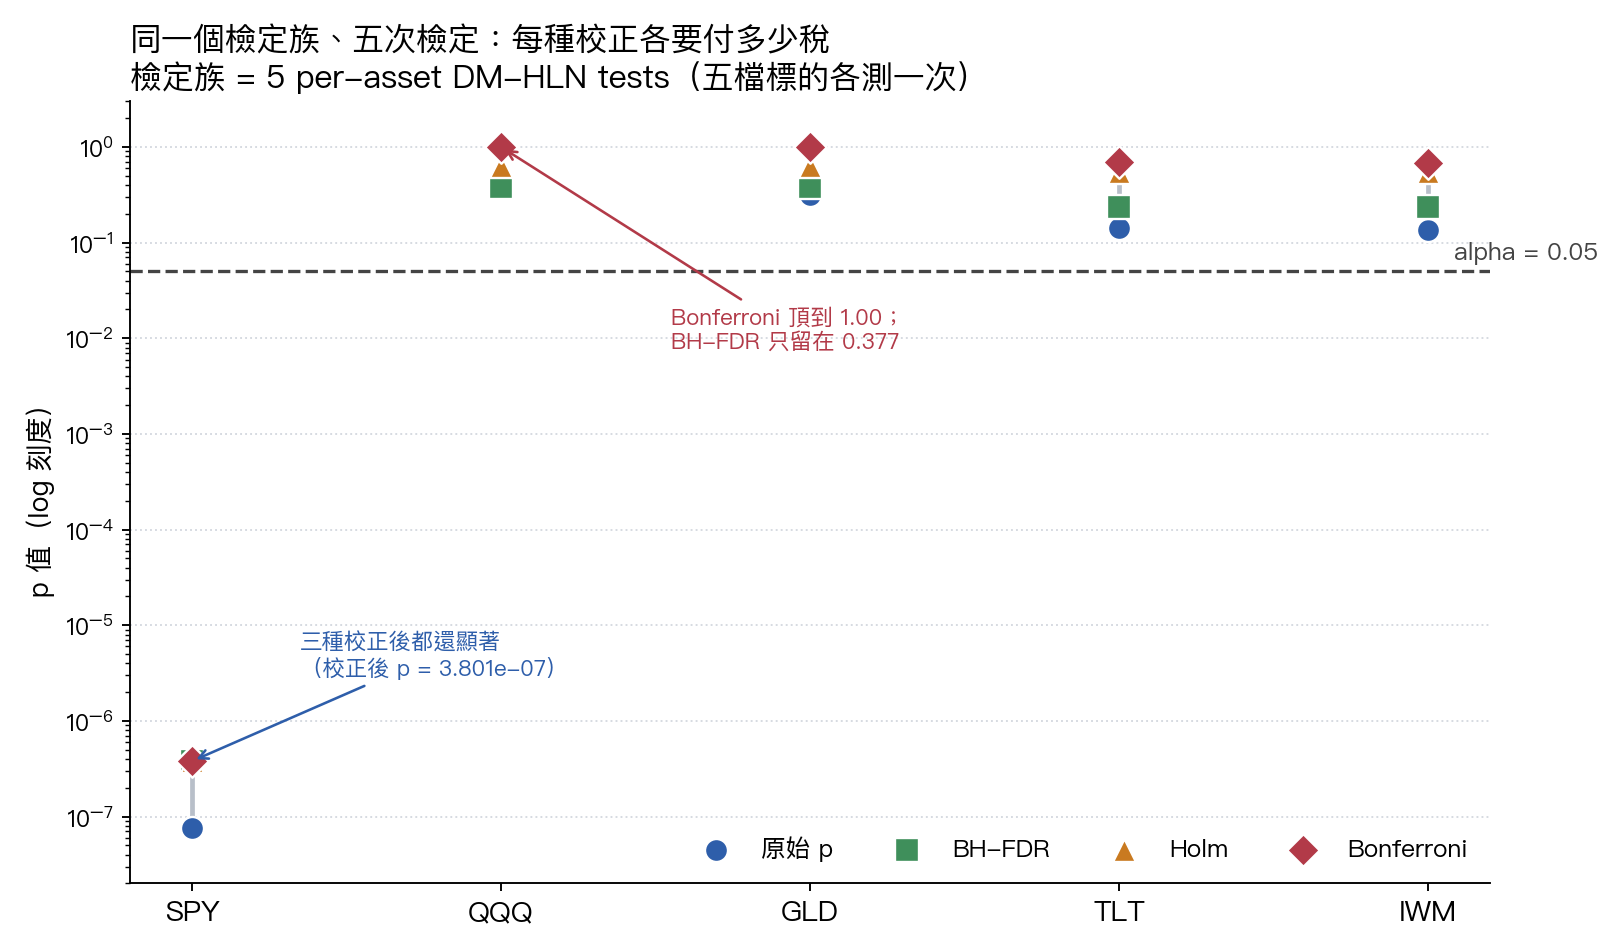
下面是完整的帳單。左邊是還沒付稅的原始 p 值,右邊三欄是三種收費方式算出來的結果。p 值越小代表越難用運氣解釋。
| 標的 | 預測誤差改善 | 原始 p | Bonferroni | Holm | BH-FDR | 5% 下還顯著嗎 |
|---|---|---|---|---|---|---|
| SPY | +14.065% | 7.601e-08 | 3.801e-07 | 3.801e-07 | 3.801e-07 | 三種都還顯著 |
| QQQ | +1.005% | 0.3772 | 1.0000 | 0.6260 | 0.3772 | 三種都不顯著 |
| GLD | −2.360% | 0.3130 | 1.0000 | 0.6260 | 0.3772 | 三種都不顯著 |
| TLT | +1.052% | 0.1409 | 0.7043 | 0.5438 | 0.2348 | 三種都不顯著 |
| IWM | +2.336% | 0.1359 | 0.6797 | 0.5438 | 0.2348 | 三種都不顯著 |
樣本從 2005 年初到 2024 年底,2020 年起算作實際的出場考試。
SPY 的原始 p 值是 7.601e-08,小數點後七個零才輪到第一個有效數字,對應的檢定統計量是 +5.409。Bonferroni 把它乘上族的大小 5,變成 3.801e-07。仍然比 0.05 小了五個數量級。
另外四檔的狀況不一樣:它們連還沒付稅的時候就沒過 0.05 這條線。付完稅之後被推到 0.23 到 1.00 之間。
三種收費方式,嚴格度差很多
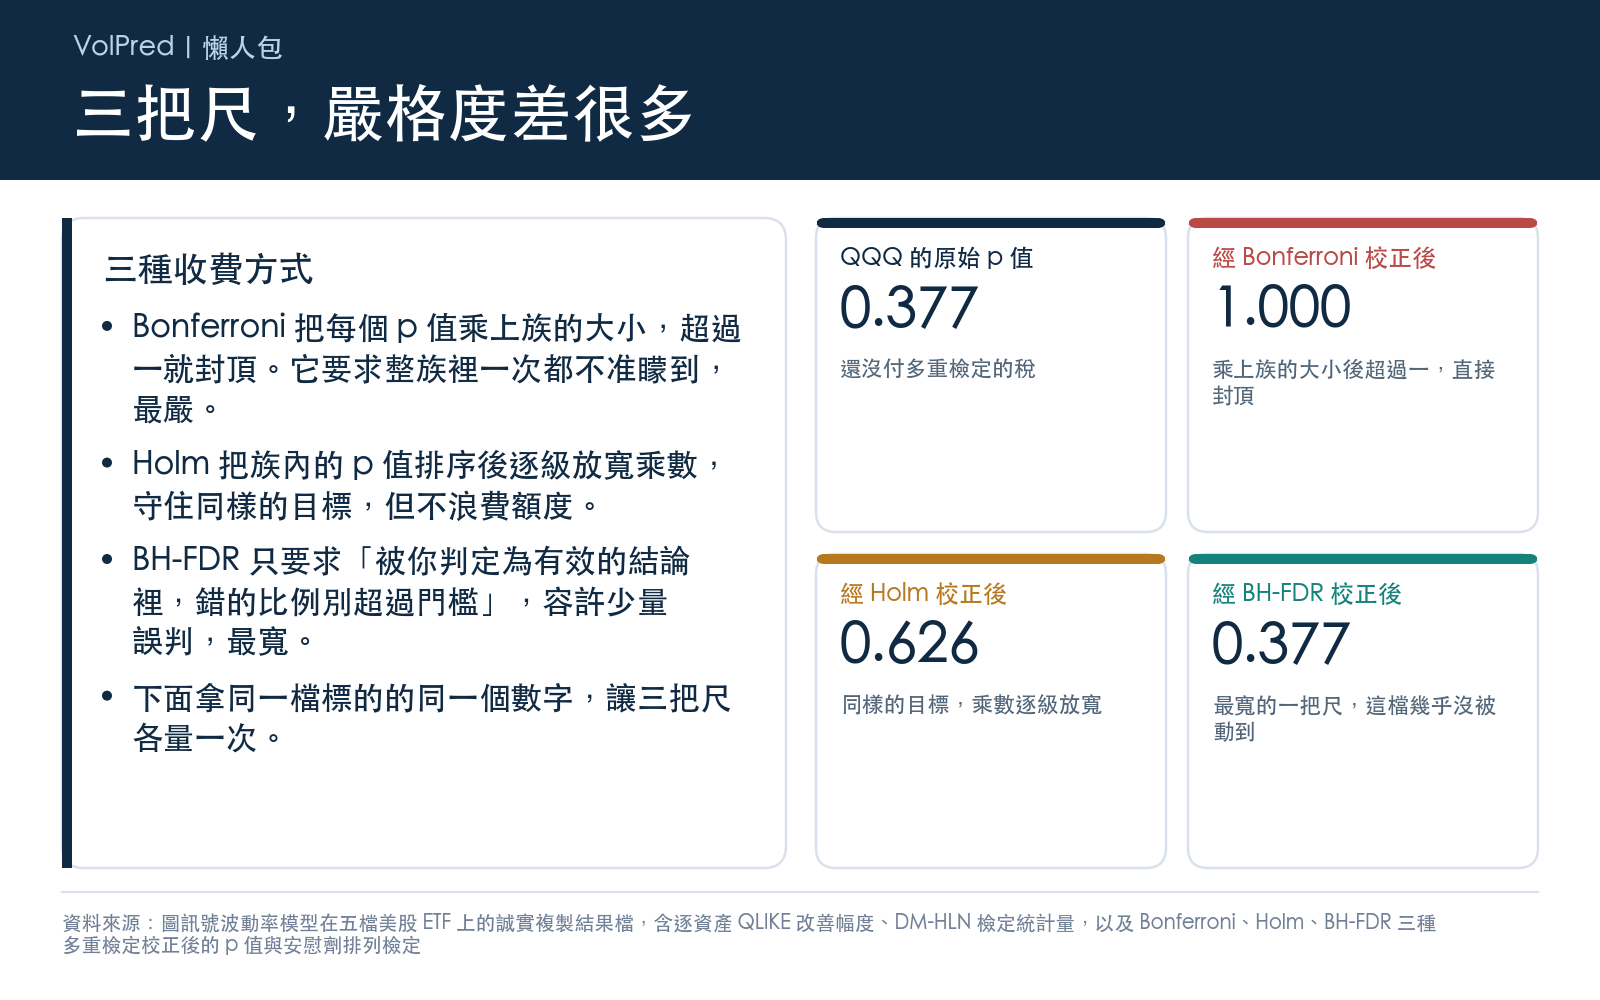
用 QQQ 當例子看同一個數字被三把尺量出什麼結果,原始 p 是 0.3772:
- Bonferroni 直接乘 5,得到 1.886,超過 1 就封頂成 1.0000 。它把「五次裡面一次都不准矇到」當目標,最嚴。
- Holm 把五個 p 值排序後逐級放寬乘數,得到 0.6260 。同樣守住 Bonferroni 的目標,但不浪費額度。
- BH-FDR 只要求「被你判定為有效的那些結論裡,錯的比例別超過 5%」,容許少量誤判,算出來是 0.3772 ,和原始值一樣。
TLT 把這個階梯拉得更開:0.1409 經過 Bonferroni 變 0.7043,Holm 變 0.5438,BH-FDR 只變 0.2348。同一份資料,最嚴與最鬆的兩把尺差了三倍。
所以「校正過了」這四個字本身沒有資訊量。要問的是用哪一把尺、族多大。族大小 5 這個數字,就是整張表的稅率來源。
兩個容易被混淆的欄位
表格第二欄的改善百分比,是效果大小,不是顯著性。結果檔自己也註明了這件事:調整後的 p 值是逐資產檢定表的註解,預測誤差的改善百分比則是原始效果量。
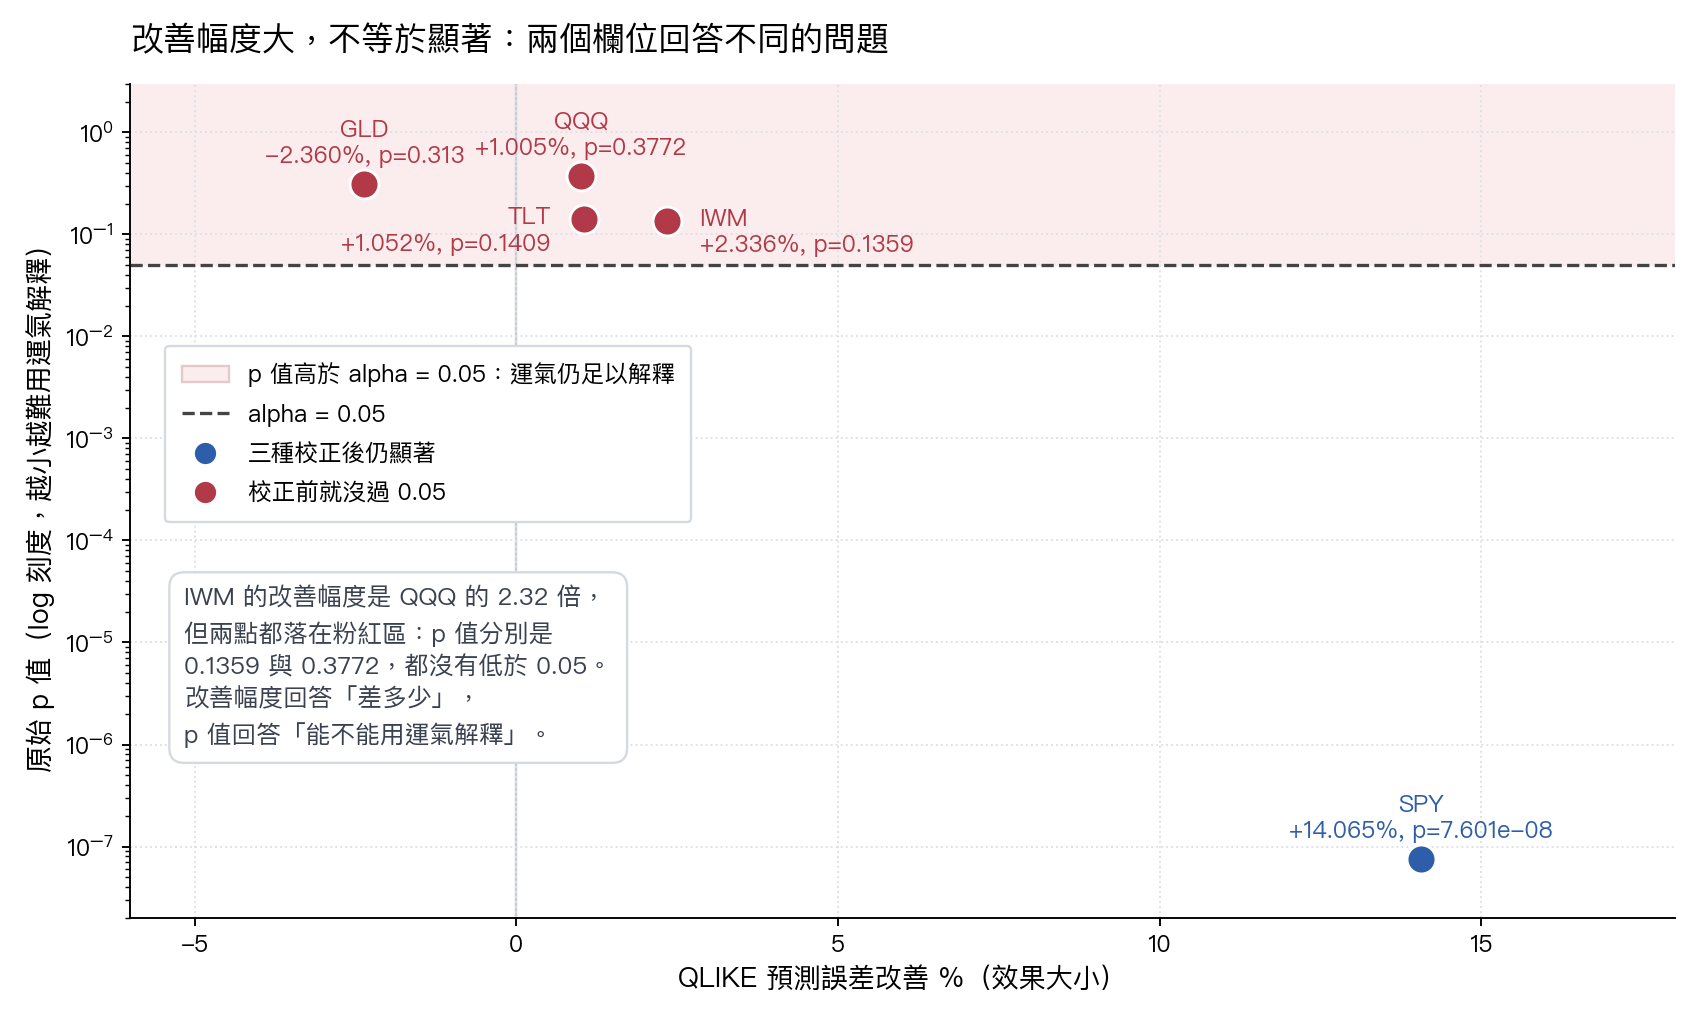
IWM 的 +2.336% 看起來比 QQQ 的 +1.005% 好一倍以上,但兩檔的原始 p 值都沒過 0.05(IWM 0.1359、QQQ 0.3772),付完稅後更是一起退到 0.2348 與 0.3772。改善幅度回答「差多少」,p 值回答「這個差距能不能用運氣解釋」。兩欄要分開讀。
活下來的那一檔,還有第二關
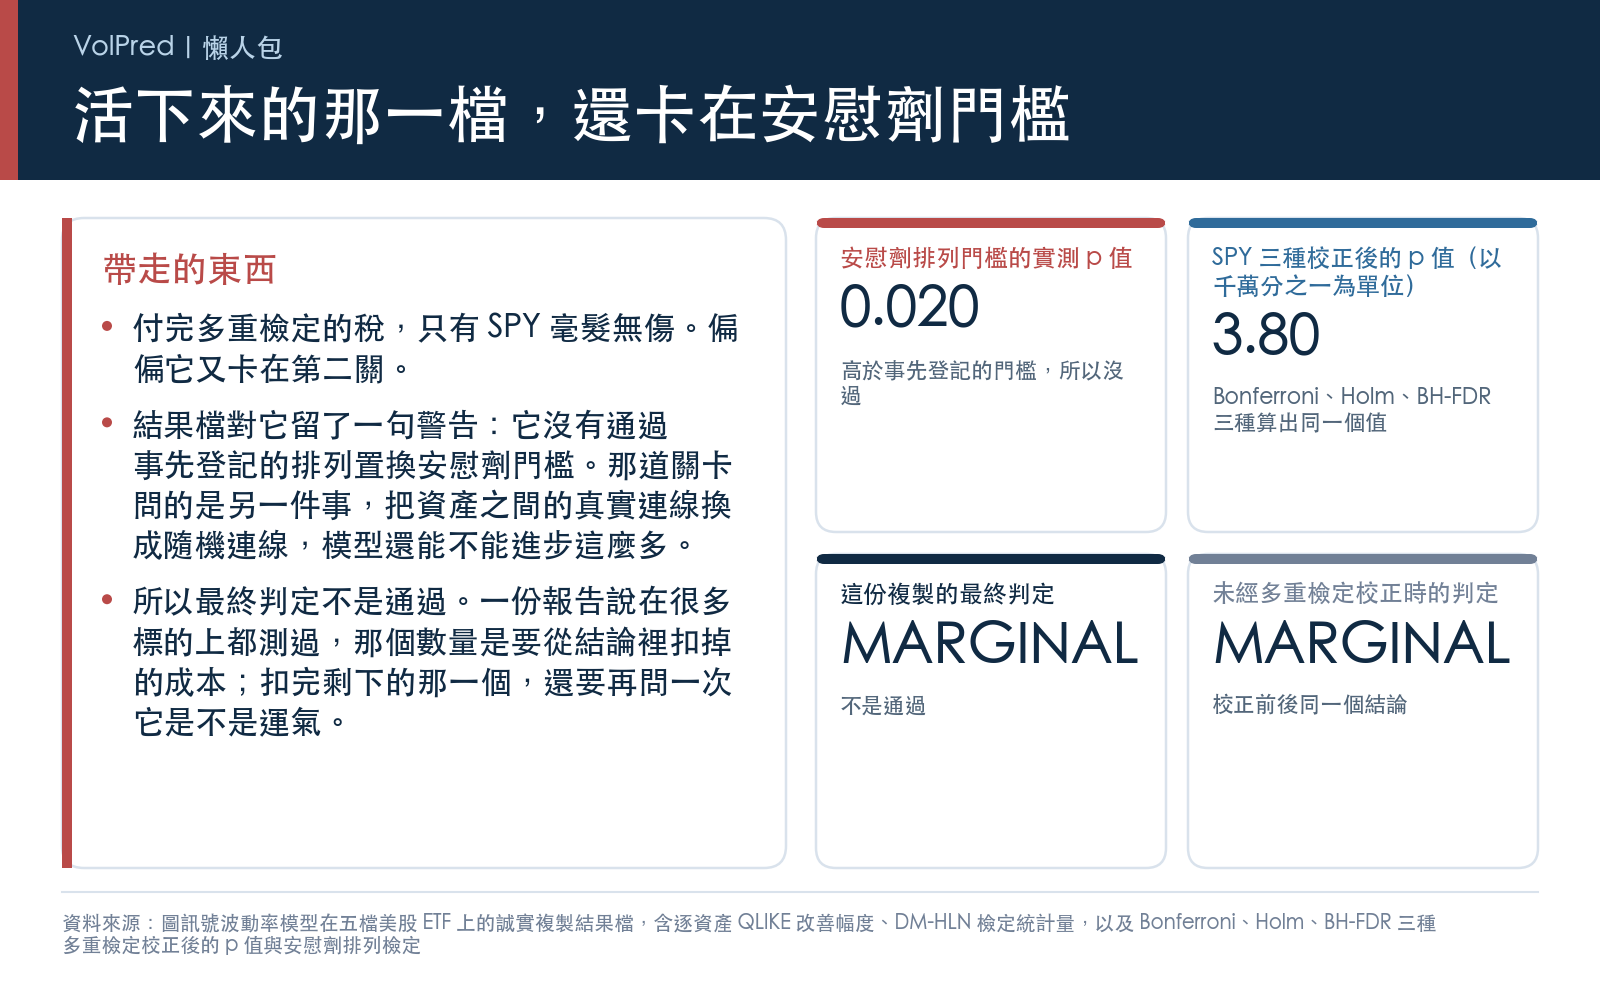
付完多重檢定的稅,SPY 是唯一毫髮無傷的。
同一份結果檔對它留了一句警告:SPY 沒有通過事先登記的排列置換安慰劑門檻(高度顯著(顯著性低於 0.01)),實測值是 0.0198。那道關卡問的是另一個問題:如果把資產之間的真實連線換成隨機連線,模型還能不能進步這麼多。
所以 SPY 過了第一關、卡在第二關。整份複製的最終判定是 MARGINAL ,不是通過。
給讀者的三個問句
我自己複製這份研究的時候,最花時間的不是跑模型,是決定哪些數字可以寫成結論。下次讀到績效報告或策略回測,這三題可以直接問:
- 你這一組總共測了幾次? 檢定族有多大,稅率就有多高。這份複製的族是五檔標的各測一次;如果還同時試了好幾個參數版本,族只會更大。沒宣告族大小的 p 值,等於沒付稅。
- 用哪一把尺校正的? Bonferroni、Holm 還是 BH-FDR,結論可能完全不同。
- 活下來的那一個,有沒有再驗一次? 通過校正只代表它不容易被運氣解釋,不保證它抓到的是真訊號。
N 個標的都測過,是成本,要從結論裡扣掉。扣完剩下的那一個,還要再問一次它是不是運氣。
懶人包圖組
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊