「它從來沒被打敗過」講的是沒輸,不是贏——八檔資產把這句話拆開來看
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
投資說明書、基金月報、策略簡介裡,有一句話出現的頻率高得驚人:
「這個做法從來沒有被顯著打敗過。」
這句話是真的。問題在於它講的事情,跟多數人讀到的事情,不是同一件。
它說的是「沒輸」。多數人讀成「贏了」。
這兩件事中間隔著一整個統計學。
我們拿一條真的規則來拆這句話
要拆得乾淨,得先有一條夠具體、而且沒有作弊空間的規則。
我們用的是波動率預測裡一個很經典的選擇題。預測明天市場會震盪多大,有兩種常見模型:
- 對稱模型 :上漲和下跌對未來波動的影響一樣大。
- 不對稱模型 :下跌會比同幅度的上漲,帶來更多後續波動。市場確實常常這樣,這個現象叫槓桿效果。
不對稱模型看起來比較貼近現實,但它多估一個參數,資料不夠時反而容易估歪。於是有個聽起來很聰明的折衷: 平常用對稱模型,只有在最近的資料顯示槓桿效果夠強的時候,才切換到不對稱模型。
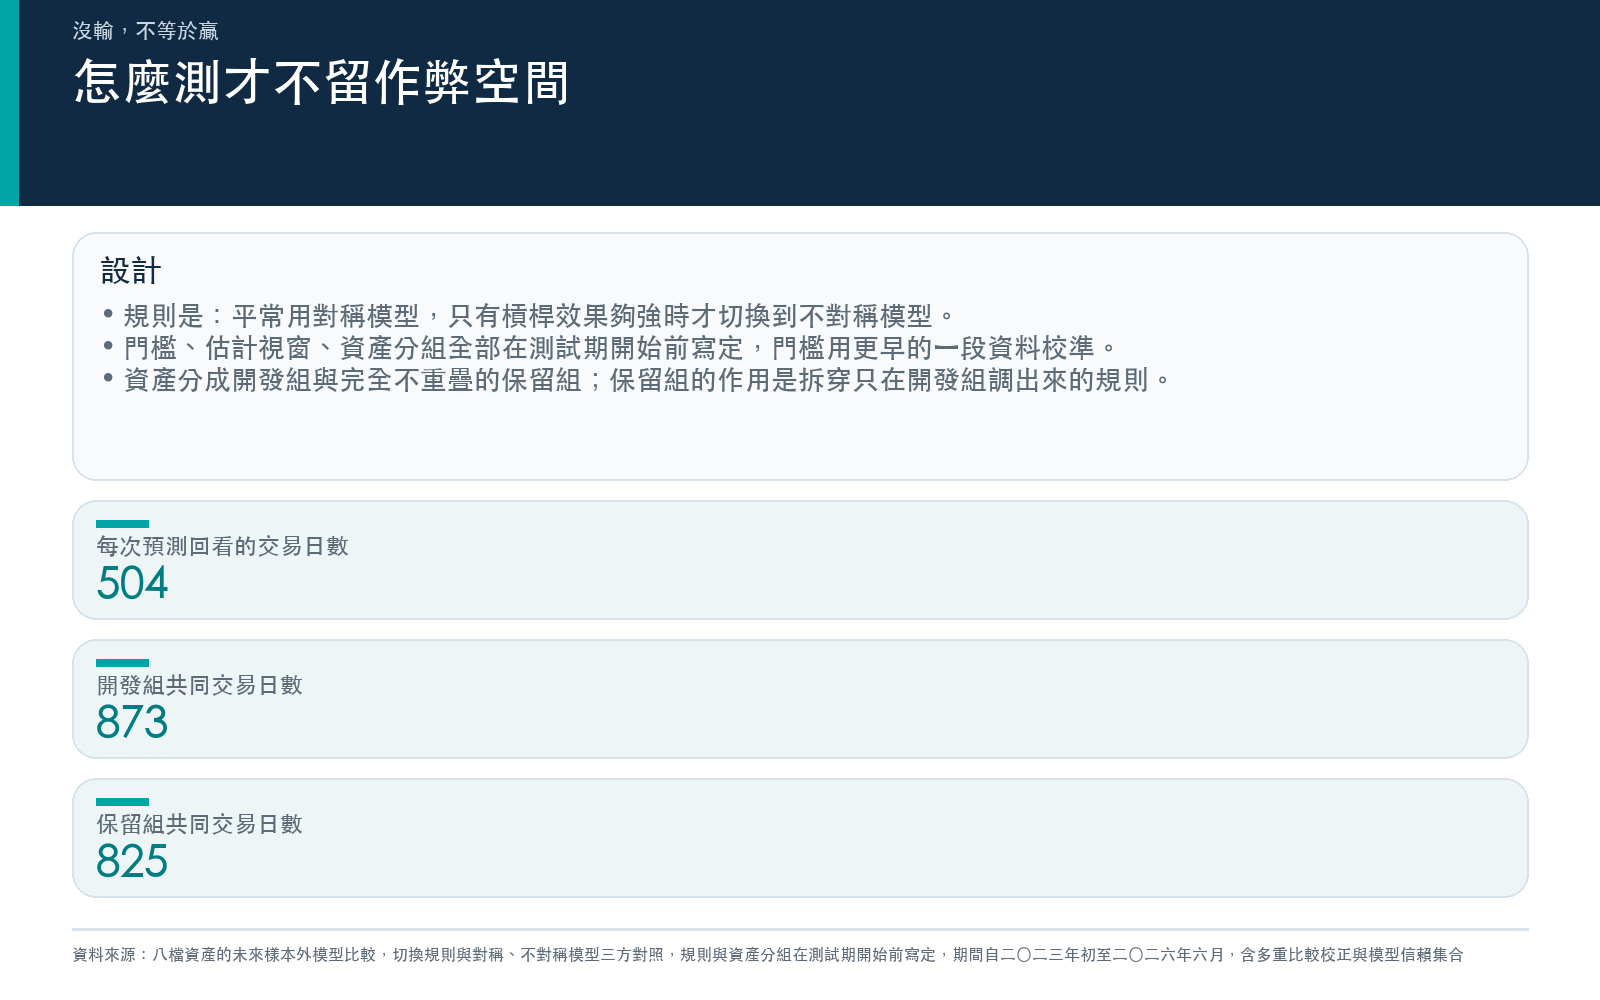
這條規則我們在測試開始之前就寫死了:每次預測前只看過去 504 個交易日,算出槓桿效果的強度,強度超過 1.65 才切換。門檻怎麼訂,是用 2017 到 2020 年那段資料決定的;正式考試用的是 2023 年 1 月 3 日到 2026 年 6 月 26 日,一段規則完全沒看過的未來。
資產分成兩組,也是事先分好的: 開發組 五檔(S&P 500、Nasdaq 100、新興市場、黃金、長期美債), 保留組 三檔(美國小型股、白銀、比特幣)。保留組的作用只有一個,如果規則只是在開發組上被調出來的,保留組會拆穿它。
第一張成績單:八檔裡拿下三檔
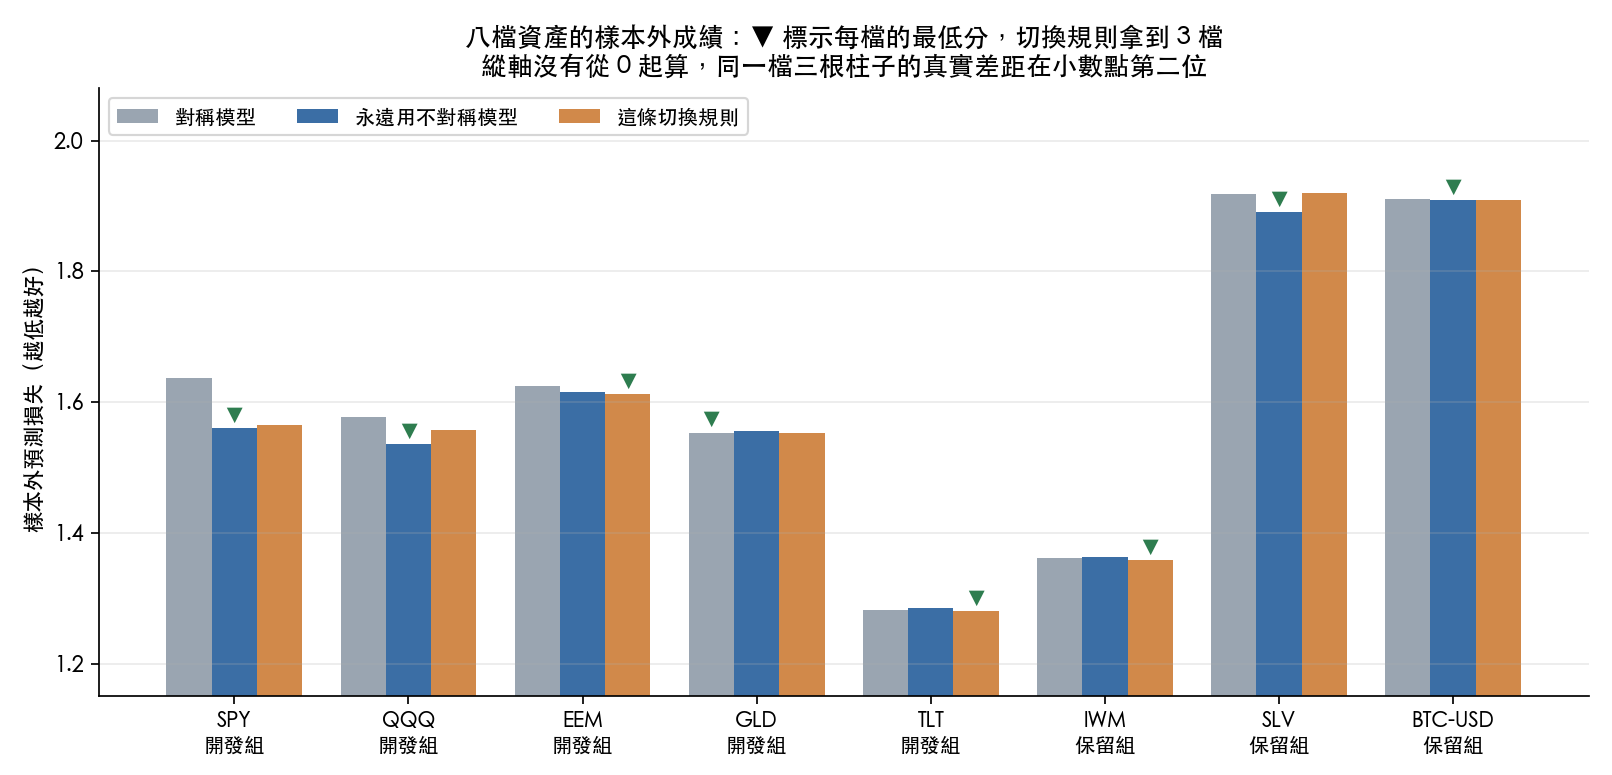
分數是預測損失,越低越好。完整表格:
| 標的 | 分組 | 對稱模型 | 永遠用不對稱 | 切換規則 | 誰最低 | 規則啟動比例 |
|---|---|---|---|---|---|---|
| S&P 500 | 開發組 | 1.6367 | 1.5610 | 1.5656 | 不對稱 | 80.8% |
| Nasdaq 100 | 開發組 | 1.5779 | 1.5365 | 1.5567 | 不對稱 | 59.1% |
| 新興市場 | 開發組 | 1.6253 | 1.6158 | 1.6128 | 規則 | 60.1% |
| 黃金 | 開發組 | 1.5535 | 1.5558 | 1.5535 | 對稱 | 0.0% |
| 長期美債 | 開發組 | 1.2825 | 1.2858 | 1.2810 | 規則 | 36.1% |
| 美國小型股 | 保留組 | 1.3623 | 1.3631 | 1.3580 | 規則 | 54.3% |
| 白銀 | 保留組 | 1.9181 | 1.8906 | 1.9206 | 不對稱 | 2.5% |
| 比特幣 | 保留組 | 1.9107 | 1.9092 | 1.9093 | 不對稱 | 10.9% |
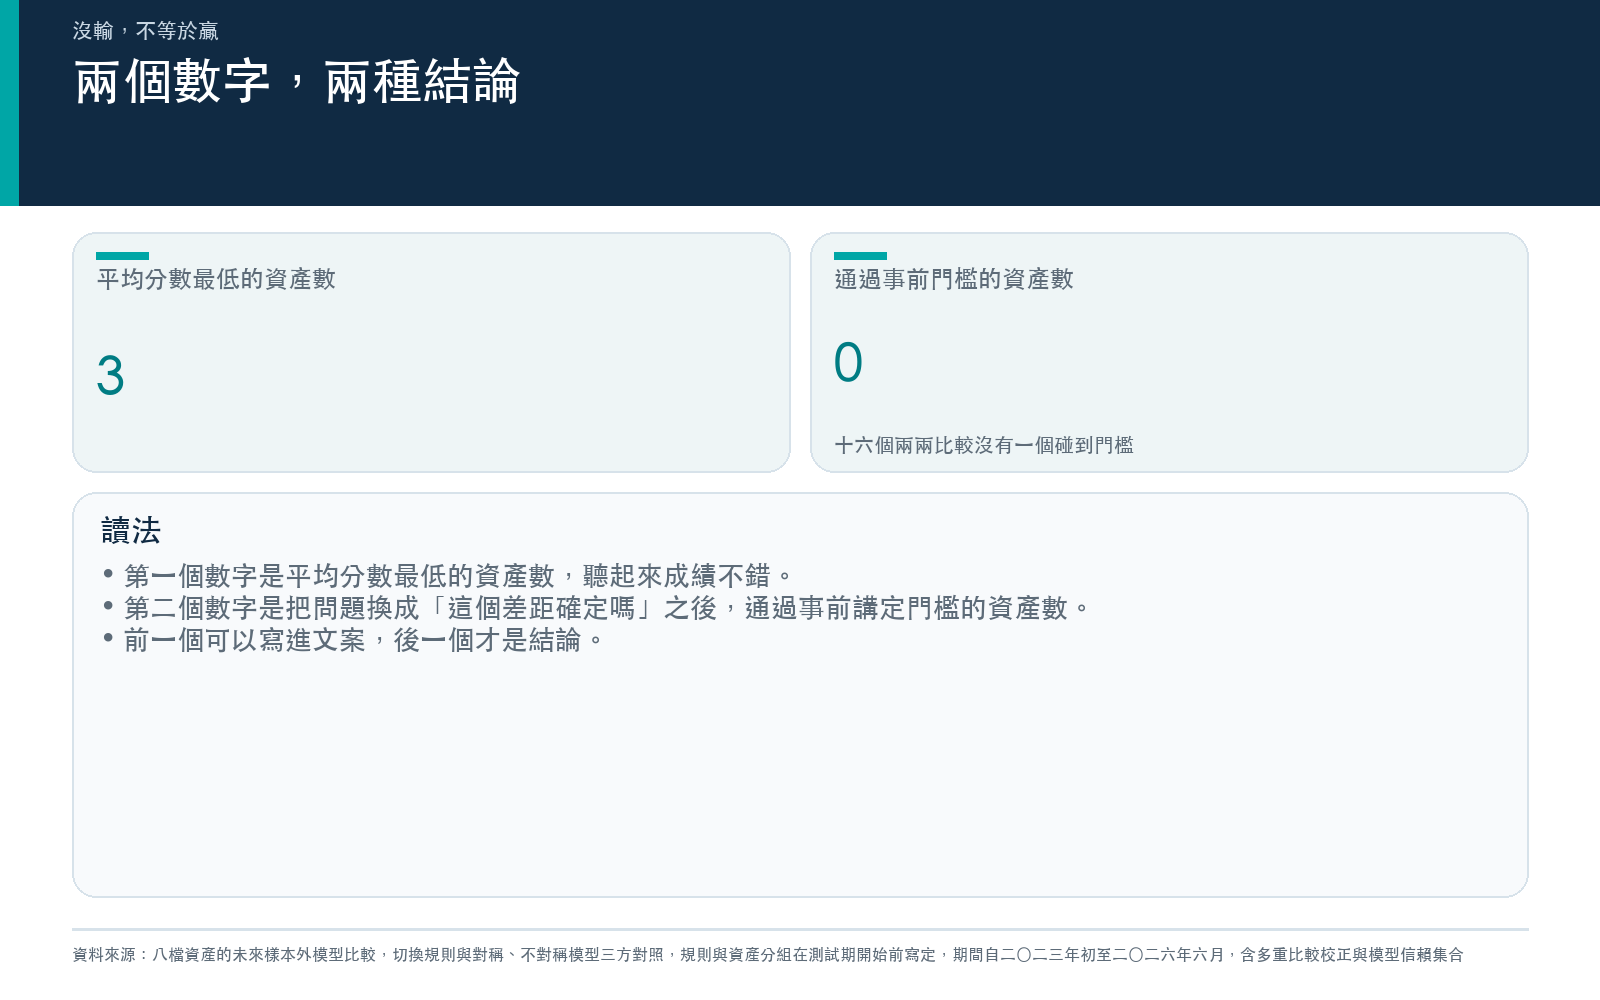
八檔裡有三檔,這條規則的平均分數最低。
如果只看到這裡,寫成宣傳文案非常容易:「在包含保留組的八個市場測試中,本規則於三個市場取得最佳預測表現,且從未被顯著打敗。」每個字都是真的。
第二張成績單:通過門檻的是零檔
把同一批數字換一個問題來問: 這些差距,確定嗎?
比特幣那一列最適合示範。不對稱模型 1.9092,切換規則 1.9093。規則「輸了」,輸在小數點後第四位。這種差距要說誰比較好,跟丟銅板連丟十次數正面沒兩樣。
統計上有專門衡量這件事的工具:把每天的預測誤差逐日比對,算出一個強度值。離 0 越遠,代表這個差距越不可能只是運氣。這個實驗在開跑前就講定了門檻:強度要超過 3,而且要扣掉「做了很多次比較,總有一次會中」的運氣成分。
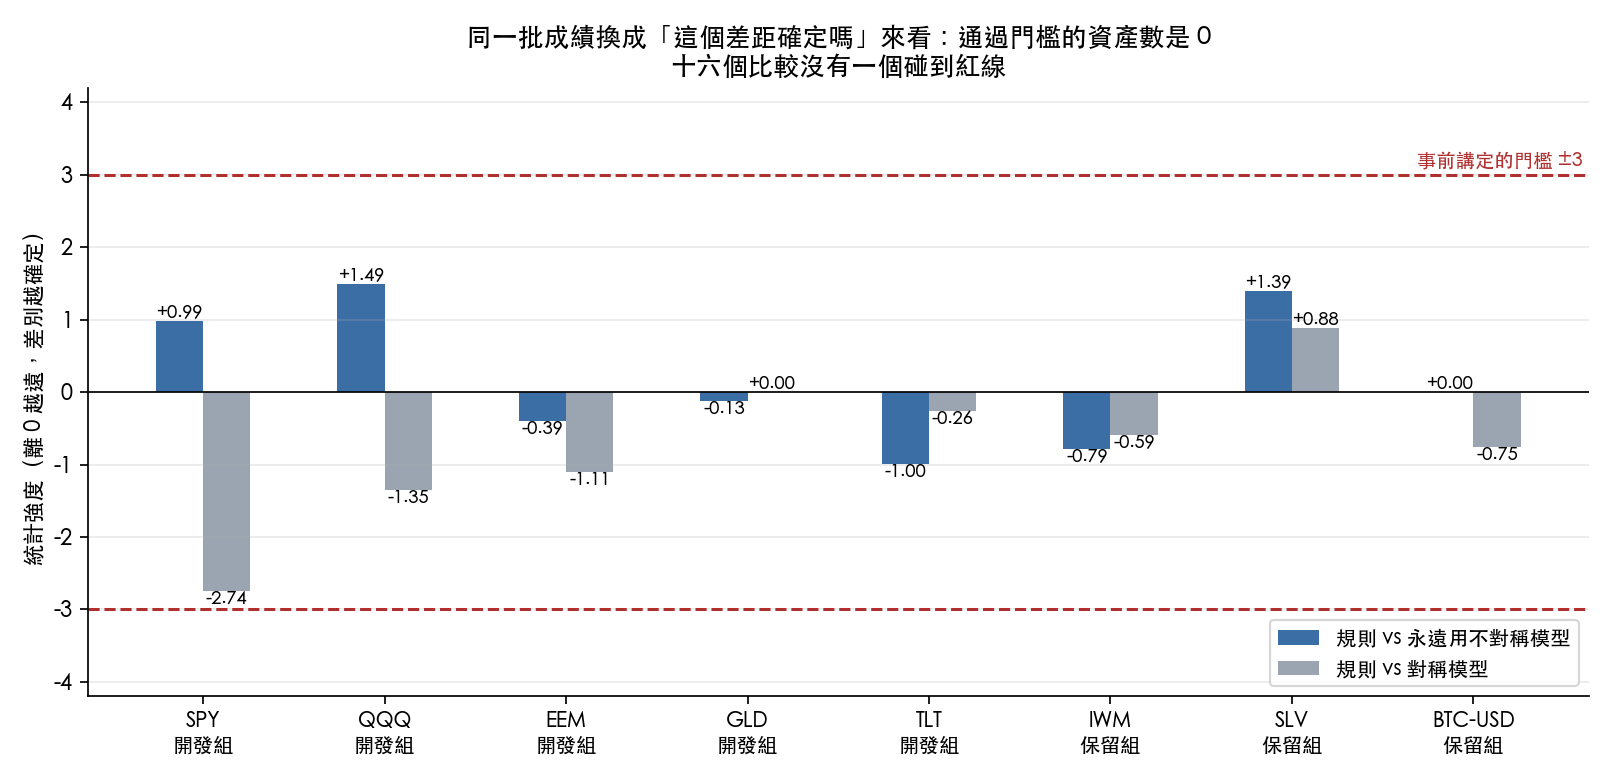
十六個比較, 沒有一個通過門檻 。最接近的是 S&P 500 那一組的 −2.74,離紅線還有一段。
所以完整的成績單是這樣:
- 平均分數最低的資產數: 3 / 8
- 通過事前門檻的資產數: 0 / 8
前一個數字可以寫進文案,後一個數字才是結論。
黃金那一列,是整張表最誠實的地方
回去看黃金:規則啟動比例 0.0%。
在整個三年半的測試期裡,這條規則在黃金上 一次都沒有切換過 。它每一天都在用對稱模型。所以它的分數跟對稱模型一模一樣,1.5535 對 1.5535,並列第一。
也就是說,表格上黃金那一列的「最低分」,確實有這條規則的份,而這份成績跟規則本身完全無關,它只是對稱模型換了個名字。
這是很好的提醒: 一個做法出現在得獎名單上,不代表它在那裡做了任何事。
把八檔放在一起問,資料只肯說一句話
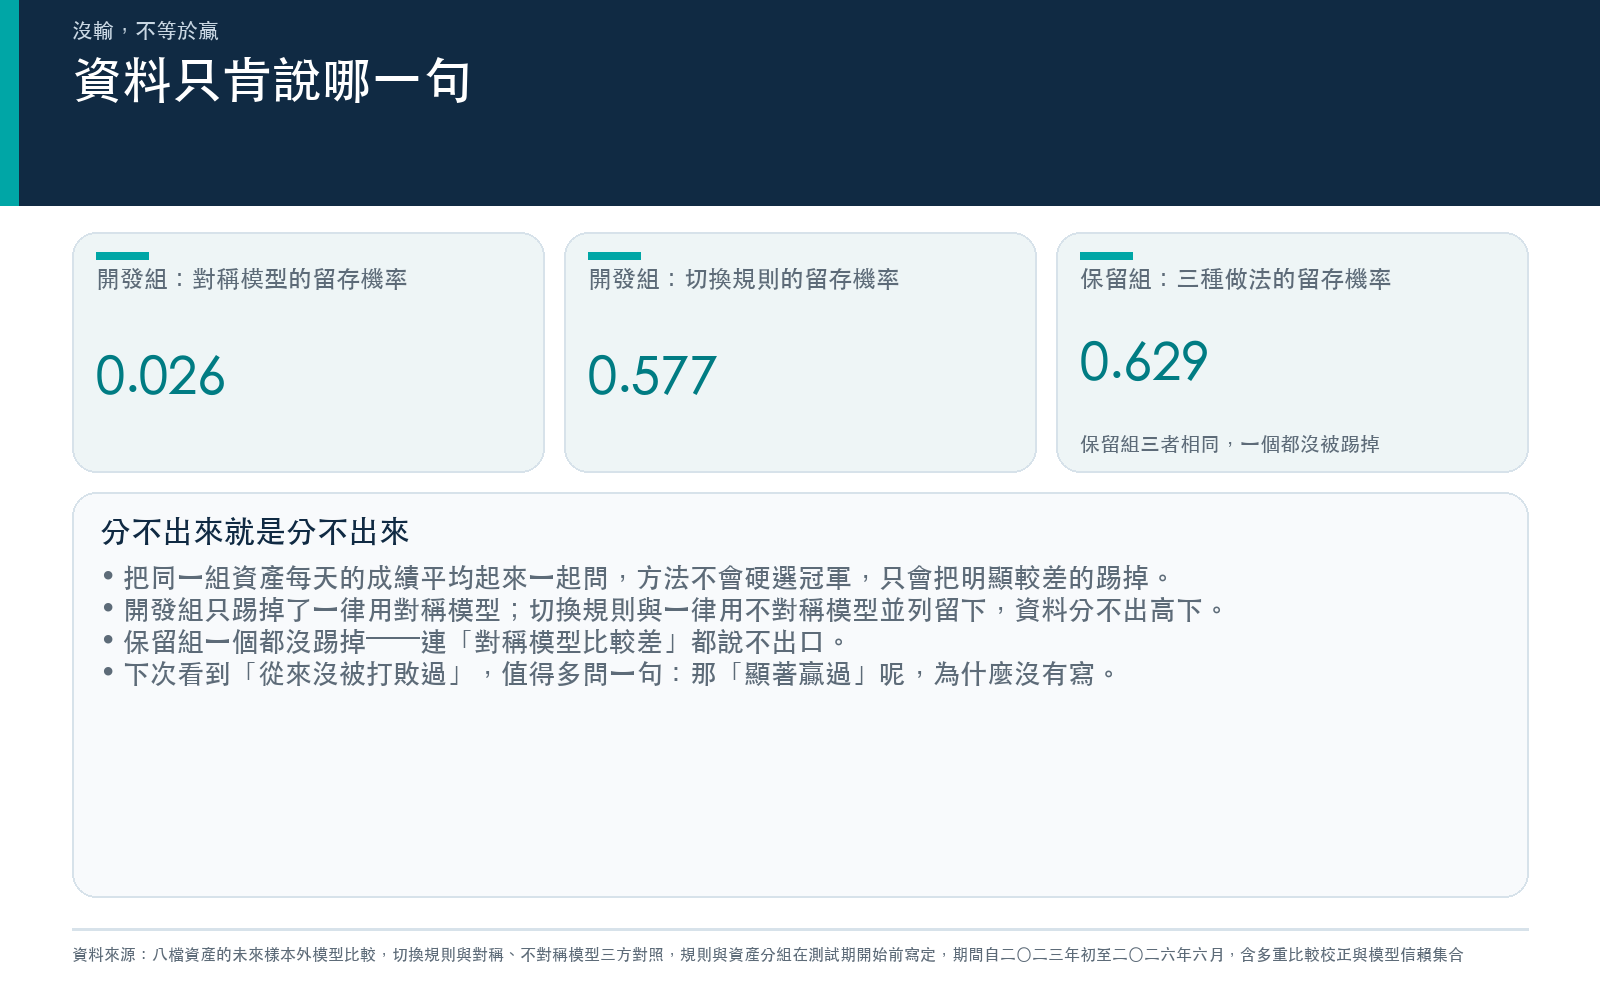
單獨看每一檔,比較容易被個別的巧合帶著走。所以還有第三種問法:把同一組資產每天的成績平均起來,一次問「這三種做法裡,哪些還有資格留在檯面上?」
這種方法不會硬選出一個冠軍。它只會把明顯比較差的踢掉,剩下的就一起留著,代表「資料分不出來」。
- 開發組五檔 (873 個交易日):踢掉對稱模型(0.026);不對稱模型和切換規則一起留下,兩者都是 0.577。
- 保留組三檔 (825 個交易日):一個都沒踢掉。三種做法全是 0.629。
開發組能說的,只有「一律用對稱模型是比較差的」。至於切換規則跟一律用不對稱模型誰好,資料明白表示分不出來。
到了保留組,連「對稱模型比較差」都說不出口了。
所以那句話該怎麼讀
三句話,看起來很像,強度差很多:
「它的平均分數最低。」 — 最弱。這句話可能只反映了小數點第四位,也可能像黃金那樣,根本不是它的功勞。
「它從來沒有被顯著打敗過。」 — 中等,而且是在講別人。這句話的意思是「沒有人能證明它比較差」。一個從頭到尾什麼都不做的做法,也可以完全符合這個描述。
「它顯著贏過對照組。」 — 最強,也是唯一一句在講它自己贏了。這個實驗裡,八檔資產沒有一檔做得到。
下次讀到第二句話的時候,值得多問一個問題: 那第三句話呢?為什麼沒有寫?
有時候答案是實驗還沒做。更多時候,答案是做了,而結果就是這篇的那張圖。
資料與方法 :資產為 S&P 500、Nasdaq 100、新興市場、黃金、長期美債(開發組)與美國小型股、白銀、比特幣(保留組),使用論文凍結的價格快照,未在實驗期間更新。切換規則、門檻 1.65、504 個交易日的估計視窗、資產分組全部在測試期開始前寫定,門檻以 2017-01-01 至 2020-12-31 的資料校準。正式樣本外期間為 2023-01-03 至 2026-06-26,每 21 個交易日重新估一次參數,每天只用當天以前的資訊做一步預測。預測損失使用波動率預測的標準評分,逐日比對後做統計檢定,並對多重比較做校正。多資產一起比較時先把同一天的成績平均,再做檢定。比特幣因為週末也交易,單獨計算時的天數多於其他資產;多資產比較只取共同交易日。本文所有數字取自該實驗結果檔的具名欄位。
懶人包圖組
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊