一篇論文試了 27 個指標,只留下冠軍:那個 0.043 還能信嗎?
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
一篇論文試了 27 個指標,只留下冠軍:那個 0.043 還能信嗎?
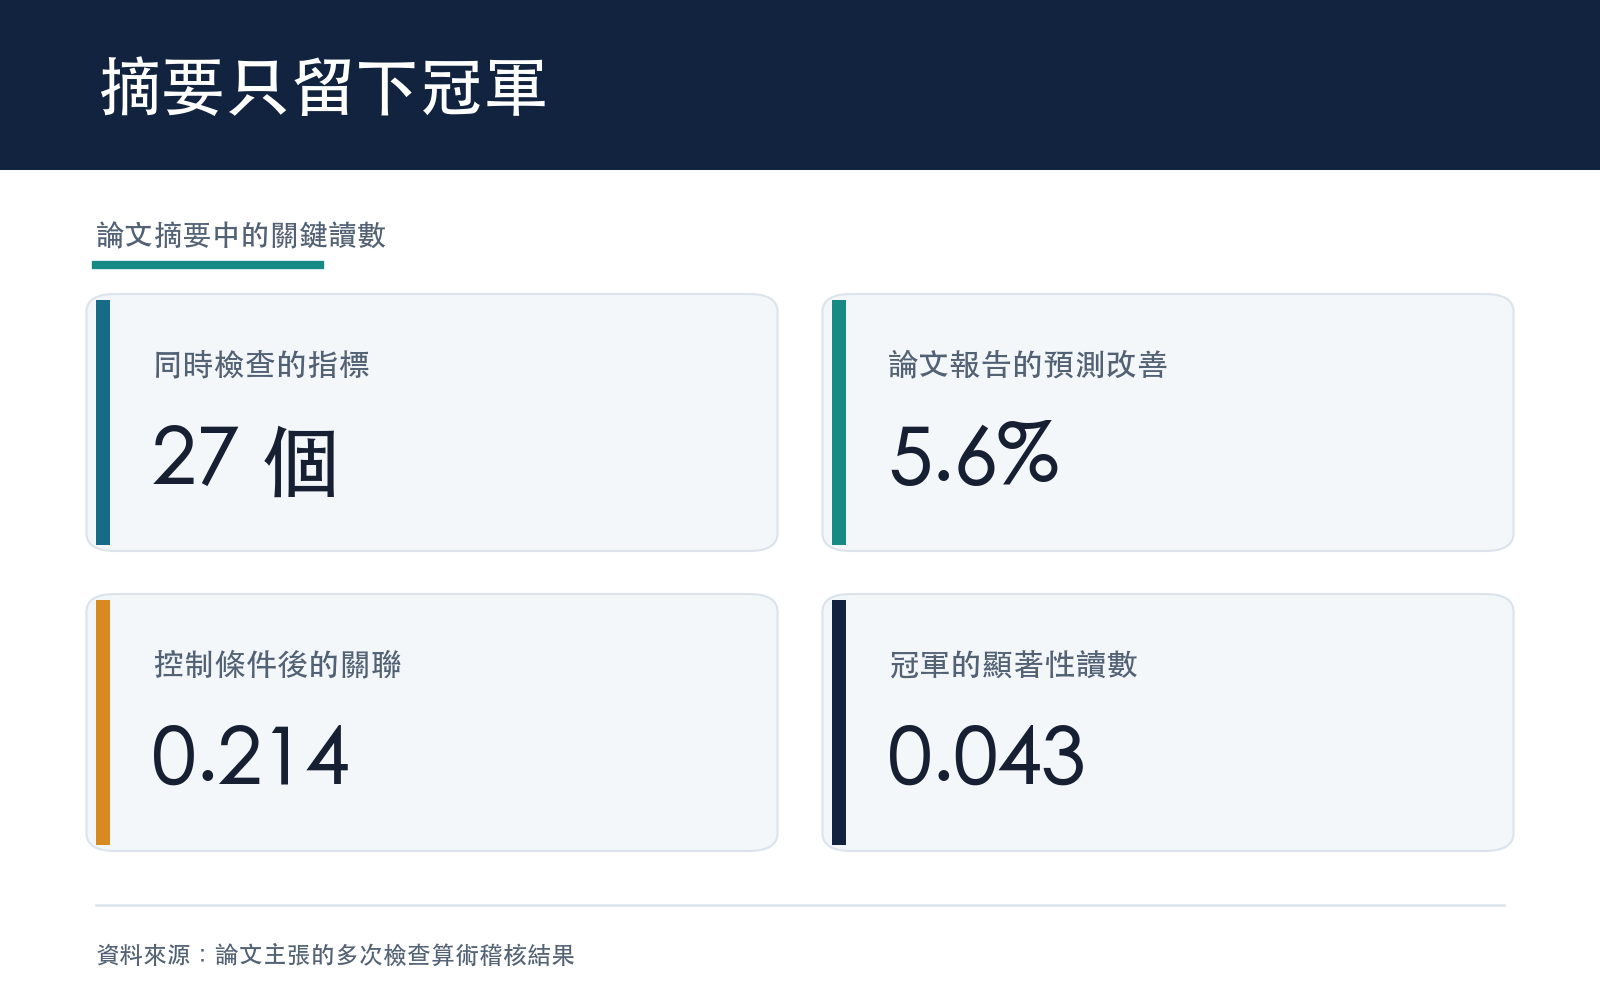
一篇研究台灣股市波動的論文寫下三個醒目的數字。作者檢查了 27 個總體經濟指標,只有進口成長率達到樣本外顯著;它讓預測誤差改善 5.6%,控制其他條件後的關聯是 0.214,顯著性讀數是 0.043。
如果進口成長率從一開始就是唯一題目,0.043 會是一個值得繼續追查的線索。論文描述的流程卻是先考 27 題,再把最低讀數的那一題端上桌。讀者看到的是冠軍成績,卻沒有看到冠軍取得了 27 次參賽機會。這個差別足以改變結論。
我們回頭稽核這句話,只問一個窄問題: 當 0.043 是 27 次檢查裡最亮的一個,它能不能支持「這個指標有獨立預測力」? 答案是目前不能。兩道對指標相關性都有效的校正尺給出同一結論,而且原始的 27 項成績表沒有被保存,後人無法重跑當時那場比賽。
一次考一題,跟考完再挑最高分,機會不同
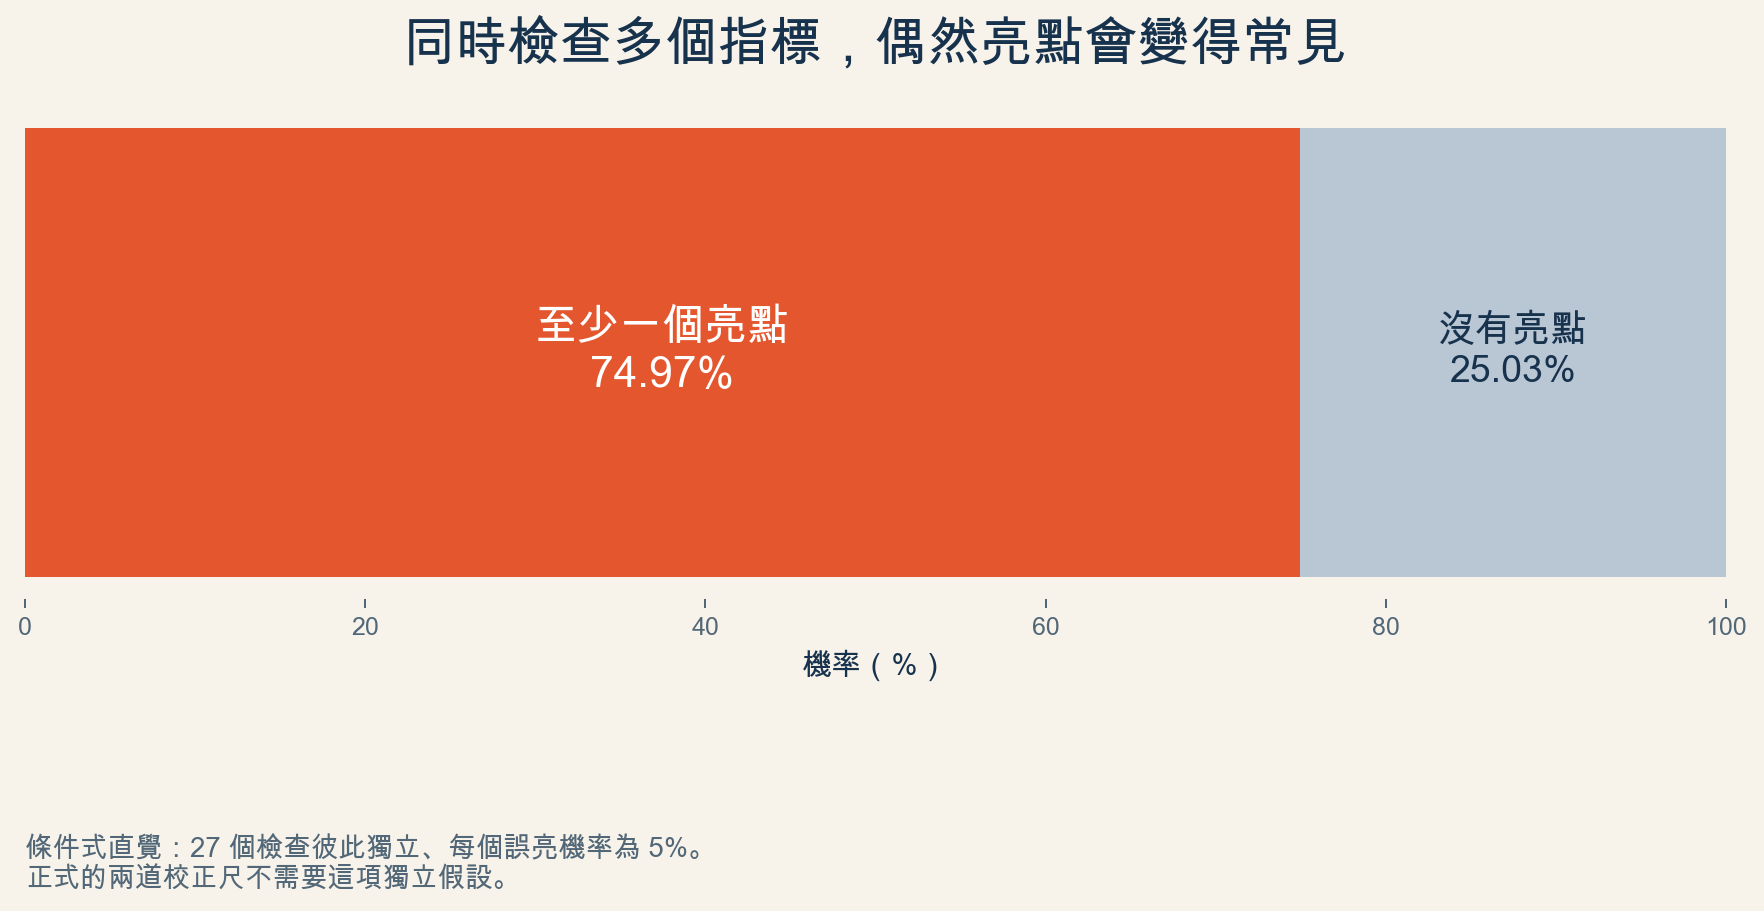
先用一個簡化情境建立直覺。假設每個指標其實都沒有預測力,每次檢查仍容許 5% 的誤亮機率。若 27 次檢查彼此獨立,至少亮起一次的機率是:
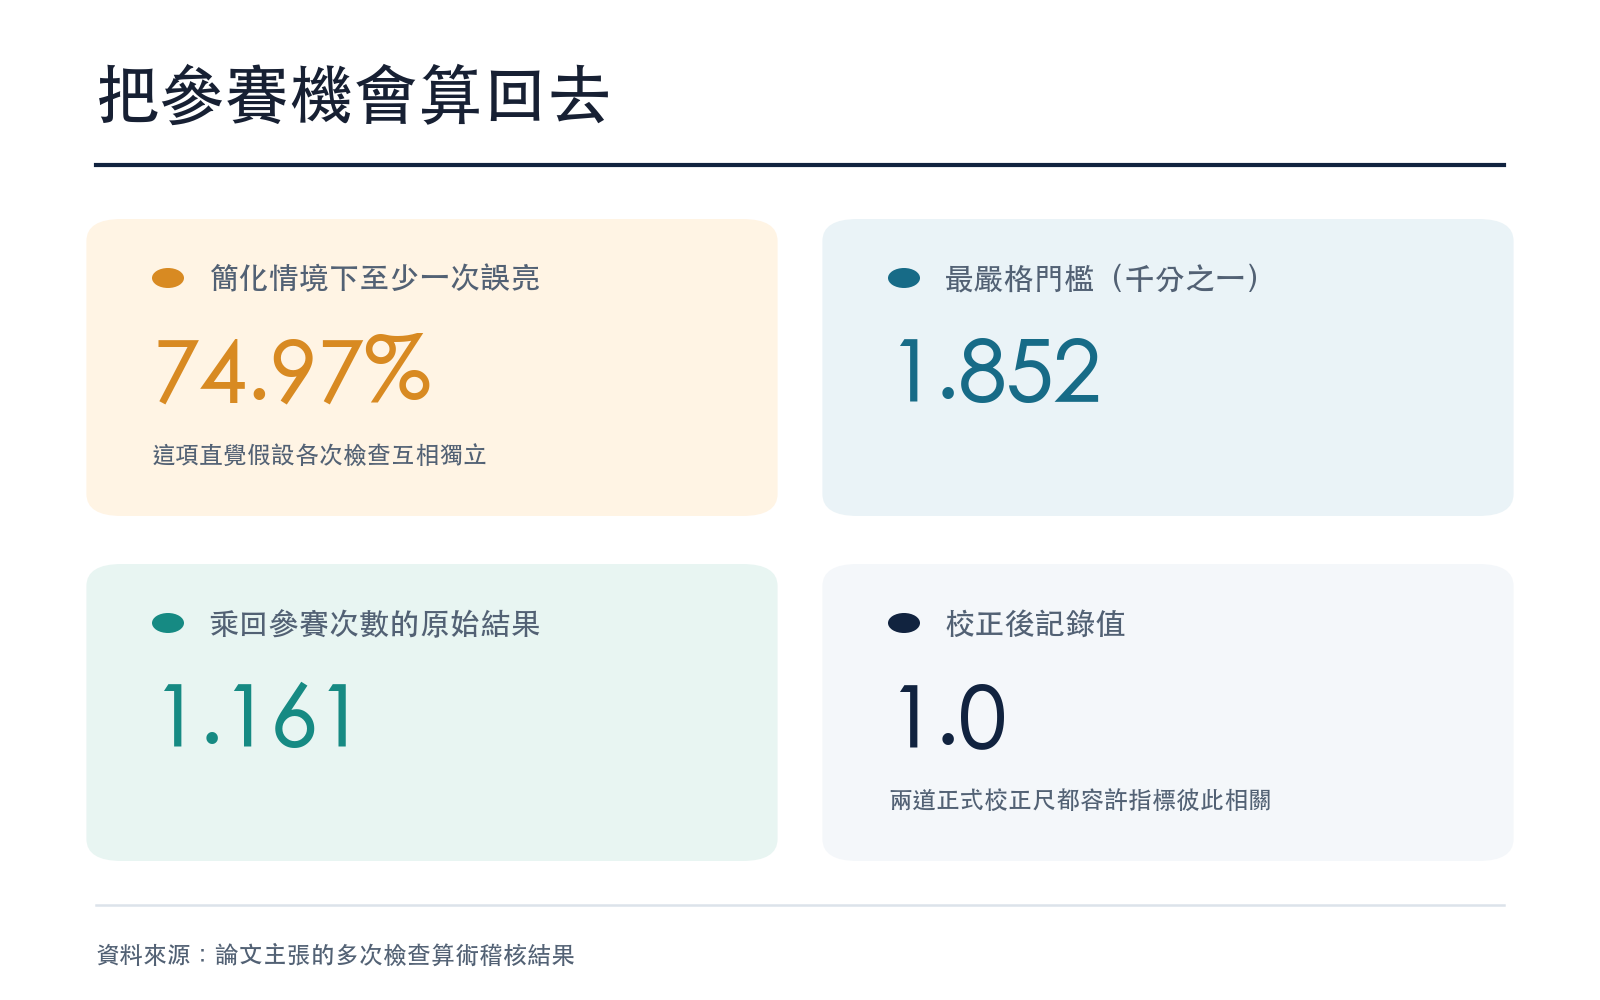
1 − 0.95²⁷ = 74.97%。
這個 74.97% 只是一幅直覺圖。總體指標通常互相牽動,27 次檢查很難真的獨立,因此不能拿它當正式裁決。它仍清楚說明一件事:同時打開愈多扇門,從其中一扇看到偶然亮光的機會就愈高。
正式判斷不能停在這幅直覺圖。指標彼此相關可能降低重複資訊,也可能讓偶然亮點一起出現。我們因此使用兩道即使檢查結果互相依賴也成立的校正尺。這兩道尺直接處理「從一整組結果中挑冠軍」的問題。
第一道尺:把參賽次數算回去
第一道尺很直白:把冠軍的 0.043 乘上 27 次機會。
0.043 × 27 = 1.161。
顯著性讀數的上限記為 1,所以校正後的結果是 1.0。讀數愈小,反對「只是偶然」的力量才愈強;校正後到達上限,表示這個冠軍無法排除多試幾次自然會出現的亮點。
這項乘法看起來嚴格,優點也正在這裡。它不需要知道進口、出口、貨幣與利率彼此相關多少。無論 27 個指標之間的依賴結構長什麼樣,這道尺都守得住整組誤判風險。
第二道尺:冠軍要先跨過最窄的門
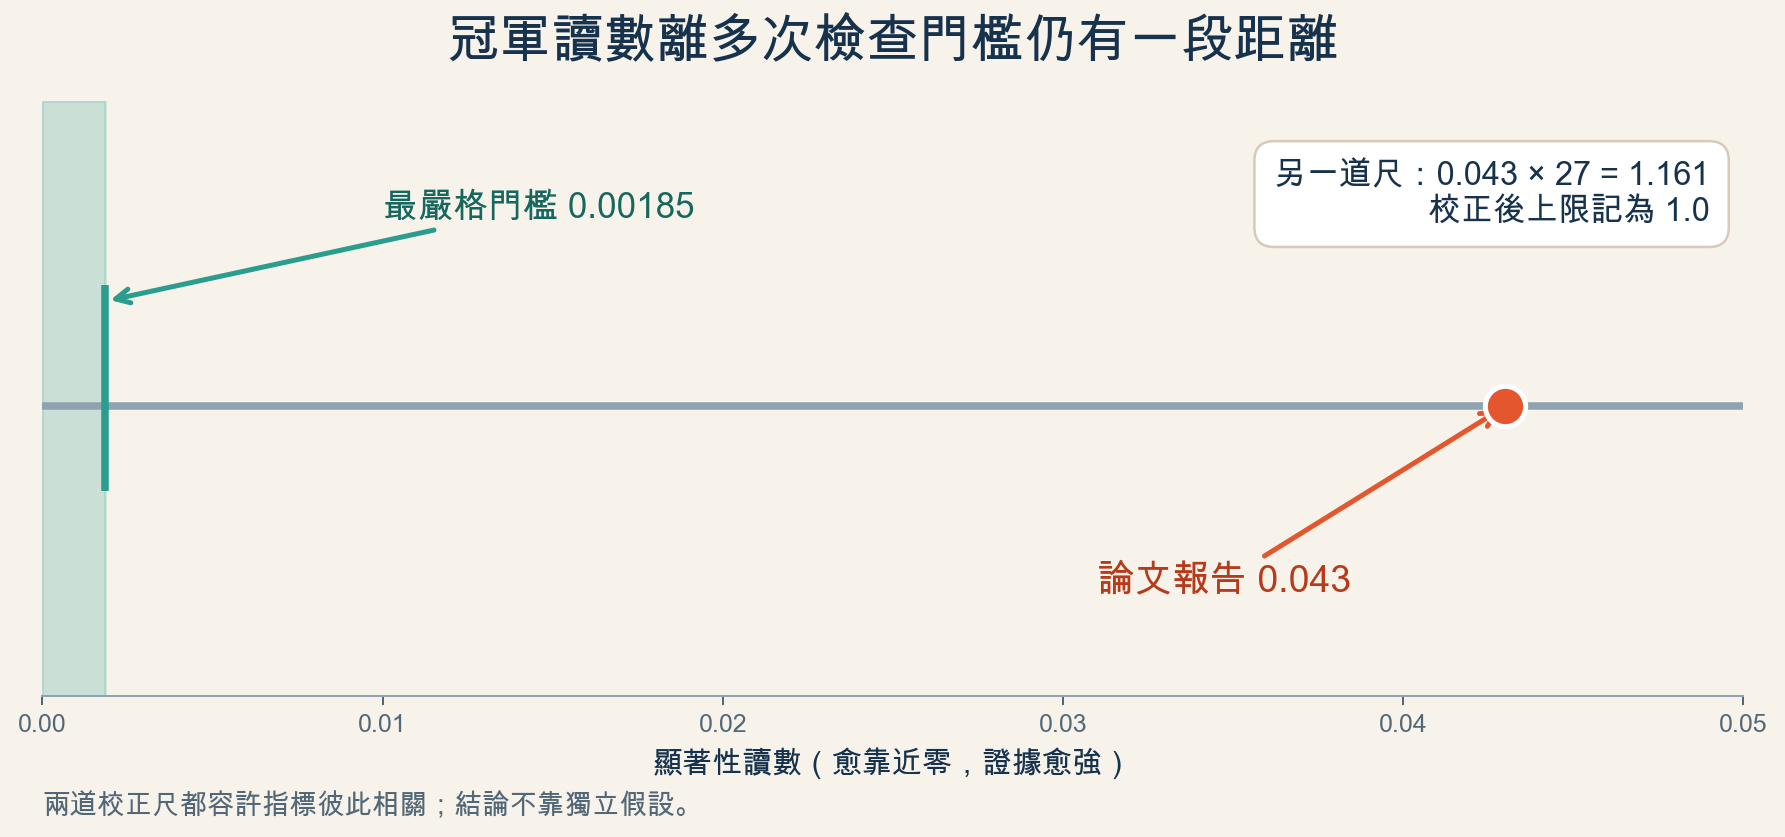
第二道尺會把全組讀數從小排到大,最亮的冠軍先接受最嚴格門檻。27 次檢查下,第一名必須小於:
0.05 ÷ 27 = 0.00185。
論文報告的 0.043 大約是這條門檻的 23 倍,因此第一關就沒有通過。後面的名次不必再算。這道尺同樣允許 27 個指標彼此相關,所以「總體變數高度相關」無法推翻這個判斷。
| 核對項目 | 數值 | 讀法 |
|---|---|---|
| 論文挑出的冠軍 | 0.043 | 只反映單次檢查 |
| 全組第一名的門檻 | 0.00185 | 冠軍沒有跨過 |
| 把 27 次機會乘回去 | 1.161 | 上限記為 1.0 |
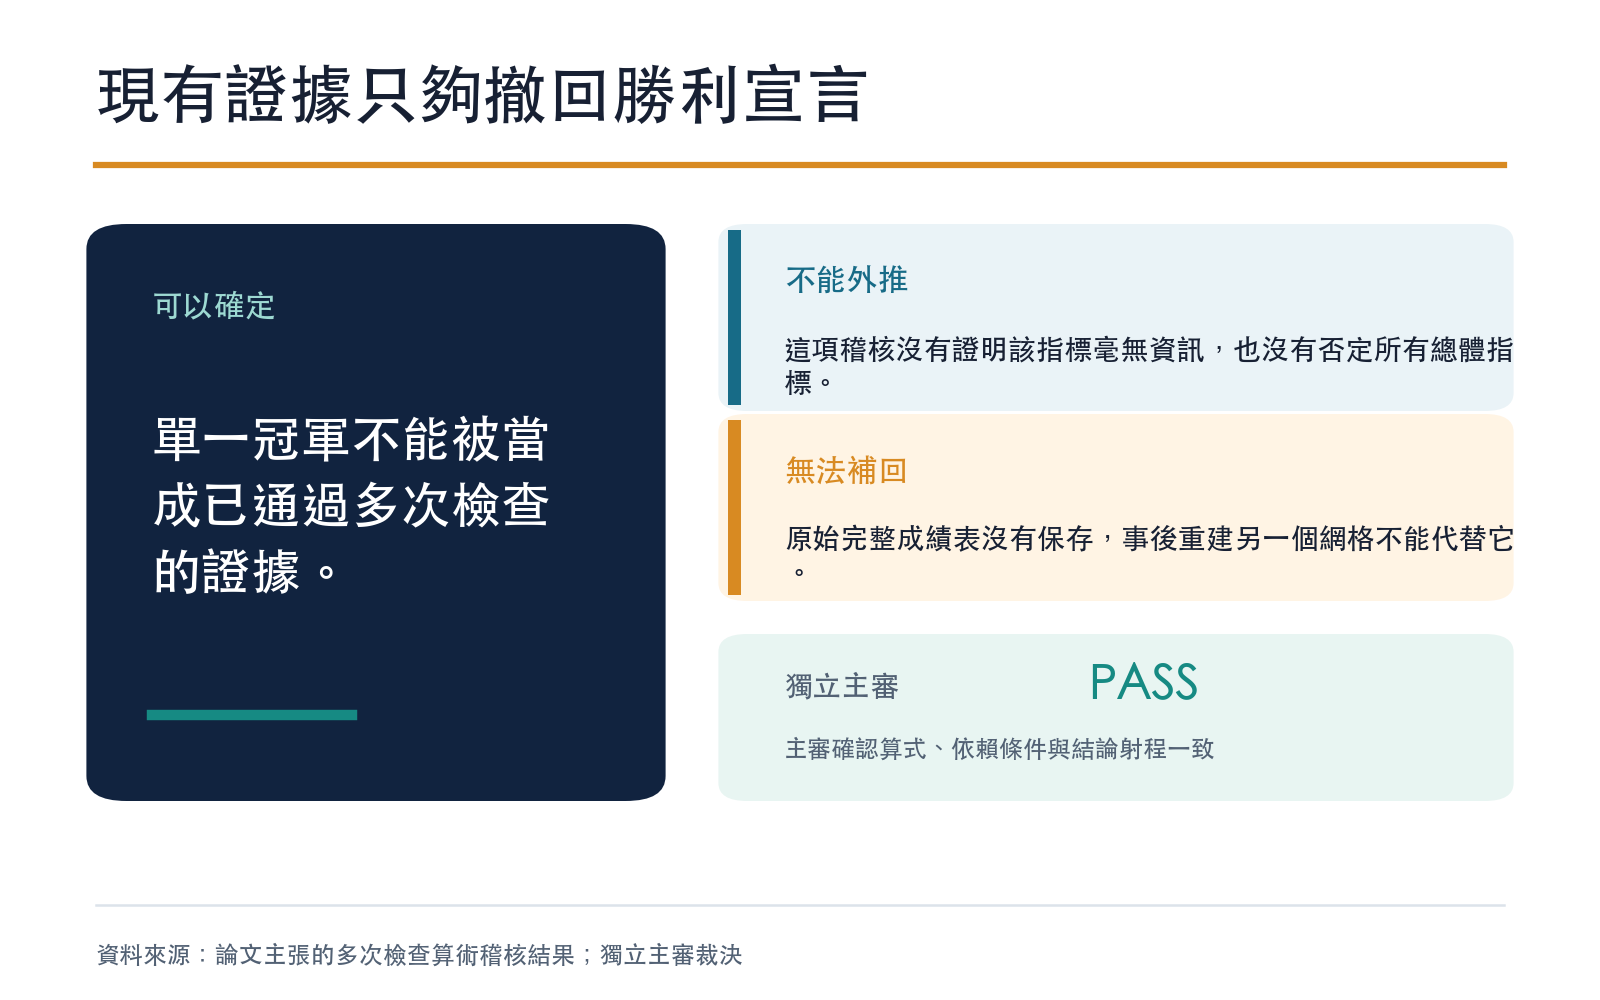
兩道尺回答的問題比原論文那句話更精確。它們沒有證明進口成長率對市場毫無資訊;它們證明的是, 只憑這個被挑出的 0.043,不能把進口成長率稱為通過多次檢查的獨立證據。
遺失的成績表,讓更深入的核對停在門外
理想的稽核會取得原始 27 項清單、每項資料版本、模型設定、預測區間與全部成績,再用同一份程式重跑。這篇論文目前沒有留下那份掃描成績表。可追到的來源是一則知識紀錄;它沒有對應的實驗目錄、程式或結果檔。稽核者只能確認論文自己寫出的「27」與「0.043」,無法確認其餘 26 個讀數,也無法查明中途是否換過指標定義或模型規格。
研究團隊後來用現有資料重建了一個相近的總體指標網格。那個網格只有 26 個可用指標,展開不同落後期與模型後共有 104 格,而且設計發生在已知論文冠軍之後。它可以幫忙發現程式或量尺的問題,卻無法替代當年那份 27 項成績表。本文因此完全不使用重建網格的勝負數字來替論文定案。
這個界線很重要。新的重建若找到很多亮點,不能替原來的 0.043 補票;若找不到亮點,也不能反過來證明進口成長率無效。缺掉的是原始比賽紀錄,事後舉辦另一場比賽無法把它補回來。
這次稽核沒有市場樣本期間
本文的核心計算只使用論文公開寫出的兩個輸入:27 次檢查與冠軍讀數 0.043。它不讀股價、不讀總體資料,也不估計新的預測模型。因此這項結論沒有可列的市場樣本起訖日、資料截止日或滾動視窗。
這反而讓結論容易複核。任何讀者拿計算機都能重做 0.043 × 27,以及 0.05 ÷ 27。這份稽核的程式、結果檔與重現規格已由獨立主審逐項核對;主審在 2026-09-07 給出 PASS,並確認兩道校正的輸入、算式、依賴條件與文章射程一致。
PASS 的意思也有限。它表示稽核產物正確重現了這個窄問題,不表示原論文的完整實證已被全面驗證,更不表示進口成長率永遠沒有預測價值。
讀到「只剩一個顯著」時,先問四件事
一、這個指標是在看結果前選定,還是從一整排結果中勝出? 事前唯一指定的檢查,可以直接閱讀自己的讀數;事後冠軍需要把全部參賽機會算回去。
二、作者校正的是哪一個家族? 同一篇研究若測了多個指標、不同落後期與不同模型,真正的參賽機會可能比摘要裡的一個數字更多。作者應先說清楚哪些結果屬於同一場選拔,再選校正方法。
三、完整成績表與程式還在不在? 摘要只留下冠軍,讀者便無法檢查第二名、失敗者與中途改動。可重現性在這裡直接決定主張能走多遠。
四、結論有沒有超過證據? 「這一個讀數未通過多次檢查校正」與「這個經濟變數毫無用處」是兩個不同命題。前者由現有算式支持;後者需要新的、事前固定且真正樣本外的研究。
最後判斷
這篇論文可以保留「進口成長率是後續研究候選」的描述,但目前不應把 5.6% 改善、0.214 關聯與 0.043 讀數包成一項已確認的預測發現。最穩妥的改法是暫停這句主張,找回原始 27 項成績表後重新校正;若原始紀錄找不回來,就把它清楚標成探索性線索。
一個冠軍值得被看見,也必須帶著參賽人數一起被看見。這裡的參賽人數是 27,而不是 1。當讀者把這個分母放回故事裡,0.043 就不再是終點;它只是下一場、事前寫好規則的研究起點。
證據與重現說明 :本文使用論文自己報告的 27 個指標、5.6% 改善、0.214 關聯與 0.043 顯著性讀數。核心算式不使用市場資料,因此沒有市場樣本期間、截止日或估計視窗。原始 27 項掃描產物未留存;事後重建屬探索性材料,未用於本文裁決。稽核結果、重現規格與獨立主審紀錄保存在研究專案,主審日期為 2026-09-07。
懶人包圖組
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊