K1704:冠軍換六把尺都不動,但第二三名的順序既會翻也分不開
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
K1704:冠軍換六把尺都不動,但第二三名的順序既會翻也分不開
[提出: 主線程, 執行: Claude]
一般讀者版(mile_c4c34762)已經報過主結論:換六把尺量同一件事,第一名六次都是同一個模型。
這一篇處理那篇刻意略過的部分,這個「六次一致」是在什麼機械條件下產生的、排名表上哪一截
其實不穩、以及六把尺為什麼不能算六個獨立證據。
主結論沒有改變。本文要說的是這個結論的邊界畫在哪裡。
一、共同帳本是怎麼建起來的
要讓六個目標的比較可比,六次評估必須落在完全相同的日期上。這份實驗把它做成一個預先宣告的 篩選政策,而不是各跑各的再對齊。
樣本外候選原點 2,048 個。扣掉目標值無效(非正的已實現變異數)的 8 個原點, 再扣掉模型輸入在該原點不可得的部分——HAR-RV 有 25 個原點的輸入不可得, GJR-GARCH 與 EWMA 都是 0 個,最後留下 2,016 個原點,就是六個目標共用的那份帳本, 日期從 2018-02-01 到 2026-07-14。
政策本身寫在結果檔裡:預先宣告「目標為正」與「模型輸入自 t-1 或更早即可得」的交集, 原始與校準後的預測若在各自的輸入可得集合內失敗,就算該模型的失敗,不另外放寬。 帳本的日期序列與被排除的原點索引都存了 sha256,所以「六次評估用的是同一批日子」這句話 可以被第三方重算驗證,而不是靠信任。
這一層在一般讀者版只寫成一句「六把尺共用同一份日期帳本」。差別在於:那句話是結論, 這一節是它的可查證形式。
二、每一個預測都先被校準過
一般讀者版完全沒有提這件事,但它會影響怎麼解讀那張損失分數表:表上的每一個數字都不是 原始模型輸出,而是經過兩層逐時點校正之後的結果。
第一層在代理端。 五個代理各自有偏誤,做法是用過去窗的平均對數偏離,偏離的基準是 「拿掉自己之後其餘代理的同日中位數」,把它扣掉。平均對數偏誤:一分鐘 RV +0.1077 、 五分鐘 +0.0593 、十分鐘 +0.0214 、Parkinson -0.0576 、日報酬平方 -1.0616 。 最後一個數字特別大,也就解釋了為什麼共識權重幾乎不給它:五個代理的平均權重是 一分鐘 0.2438 、五分鐘 0.3002 、十分鐘 0.3082 、Parkinson 0.1399 、 日報酬平方 0.0079 。共識這把尺實質上是三把 RV 加一點 Parkinson,日報酬平方近乎沒有份量。
第二層在模型端。 對每一個目標與每一個原點,把模型的原始預測乘上過去窗的幾何平均 「實際/預測」比值,並要求至少 252 對有效紀錄才啟用。在共識目標上,這個倍率的平均值是 HAR-RV 0.7996 、GJR-GARCH 0.7066 、EWMA 0.7447 ——三個模型的原始預測平均都偏高, 而偏高的程度不一樣,GJR-GARCH 的倍率在 0.5649 到 0.8813 之間移動,是三者中最不穩的。
這一層是必要的:QLIKE 對系統性偏誤很敏感,不校準等於在比誰的水位設定運氣好。但它同時意味著 本次比較的對象是「校準後的模型」而非「模型本身」,而校準用的窗與門檻都是設計選擇。
三、不變的是什麼
在六個目標上,QLIKE 的第一名都是 HAR-RV;六次 MCS 的存活名單也都只有 HAR-RV 一個, 被淘汰者的 p 值介於 0.009 與 0.036 。把樣本外切成前後兩段(前段 1,020 天、 後段 996 天)各跑一次,排名與 MCS 結論都不變,差別只在被淘汰者的 p 值從前段的 0.093 降到後段的 0.061 。
換用 MSE 排序,第一名同樣六次都是 HAR-RV。
所以「冠軍穩健」這件事跨了四個維度:六個代理目標、兩種損失函數、兩段子樣本、以及 MCS 這個 比點估計更嚴格的口徑。
四、不穩的是什麼,而且正好是分不開的那一截
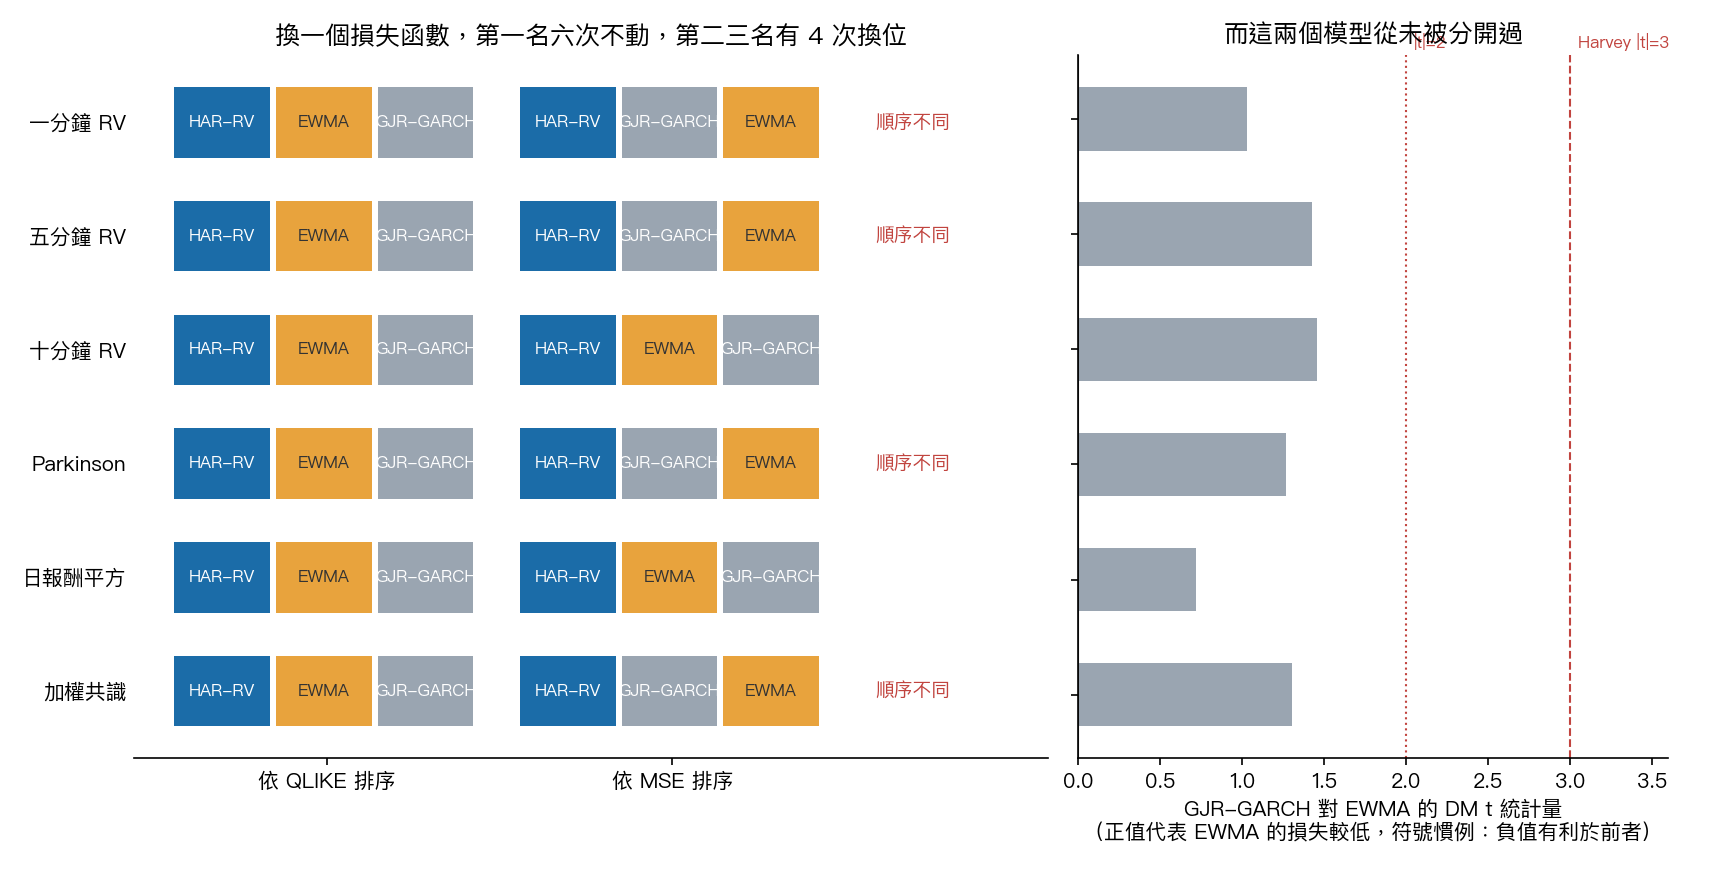
第二名與第三名的相對位置就不是這樣。依 QLIKE 排,六個目標的順序都是 EWMA 在 GJR-GARCH 之前;改依 MSE 排,一分鐘 RV、五分鐘 RV、Parkinson、加權共識這四個目標的順序反過來。 六個目標裡有四個換位。
有意思的是同一對模型的檢定結果。GJR-GARCH 對 EWMA 的 DM t 統計量在六個目標上分別是 1.0327 、 1.4241 、 1.4591 、 1.2652 、 0.7181 、 1.3033 ,對應的 p 值最小的 一個是 0.1447 。連 2 都沒有碰到,更不用說本平台採用的 Harvey 門檻 3。
六個目標的完整對照:
| 目標 | QLIKE 第一名 | QLIKE 二三名 | MSE 二三名 | 二三名是否換位 | GJR-GARCH 對 EWMA 的 DM t | MCS 淘汰 p |
|---|---|---|---|---|---|---|
| 一分鐘 RV | HAR-RV | EWMA / GJR-GARCH | GJR-GARCH / EWMA | 是 | 1.0327 | 0.036 |
| 五分鐘 RV | HAR-RV | EWMA / GJR-GARCH | GJR-GARCH / EWMA | 是 | 1.4241 | 0.023 |
| 十分鐘 RV | HAR-RV | EWMA / GJR-GARCH | EWMA / GJR-GARCH | 否 | 1.4591 | 0.025 |
| Parkinson | HAR-RV | EWMA / GJR-GARCH | GJR-GARCH / EWMA | 是 | 1.2652 | 0.009 |
| 日報酬平方 | HAR-RV | EWMA / GJR-GARCH | EWMA / GJR-GARCH | 否 | 0.7181 | 0.020 |
| 加權共識 | HAR-RV | EWMA / GJR-GARCH | GJR-GARCH / EWMA | 是 | 1.3033 | 0.026 |
最後一欄的 MCS 淘汰 p 值是給對照用的:同一份資料上,第一名把後兩名踢出存活名單的證據 (p 值 0.009 到 0.036)遠強於後兩名彼此的證據(DM p 值最小 0.1447)。
換句話說: 會隨損失函數翻盤的那一截,正是任何檢定都分不開的那一截。 這兩件事同時成立 並不是巧合,兩個模型的損失差如果小到統計上不可辨識,那麼換一個對誤差加權方式不同的 損失函數就足以讓點估計的大小關係反過來。
實務上的意思是:這份研究支持的說法是「HAR-RV 是冠軍」,不是「HAR-RV > EWMA > GJR-GARCH」。 一般讀者版已經寫過後兩名分不出來,本節補的是另一半,它們不只分不出來,順序還會隨口徑改變。
五、六把尺不是六個獨立證據
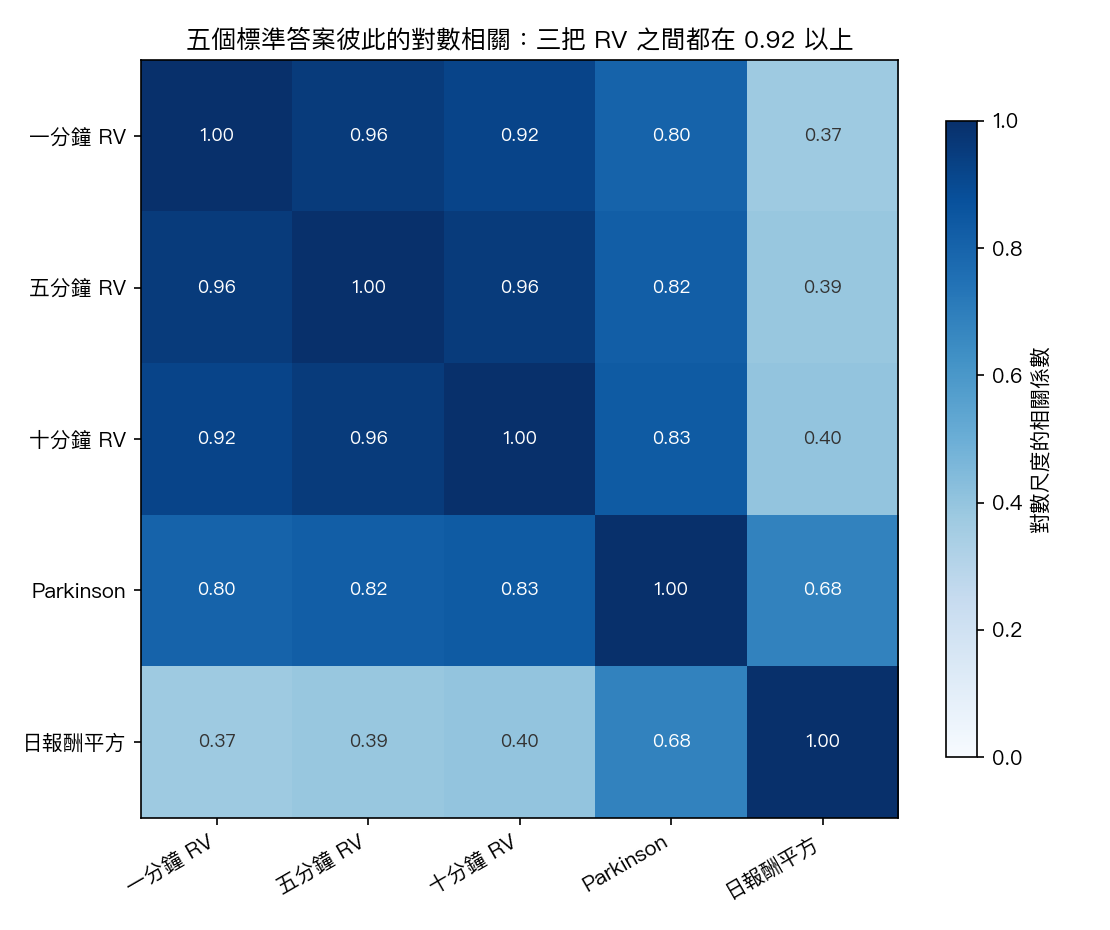
一般讀者版說「實際上比較接近四把半」。這裡把它換成數字。
一分鐘、五分鐘、十分鐘三把 RV 出自同一批逐筆資料,彼此的對數相關是 0.9567 、 0.9218 、 0.9564 。Parkinson 對三把 RV 是 0.8021 到 0.8320 。日報酬平方是唯一一把真正不同的 尺,對三把 RV 只有 0.3735 到 0.4016 。
再加上第六個目標,加權共識,本身就是前五個的加權組合,權重還幾乎全押在三把 RV 上。 所以「六個目標一致」的證據強度,遠低於六個獨立檢定一致。要說得更精確:這份實驗支持的是 「排名對測量頻率的選擇不敏感」,而不是「排名對量測方法的選擇不敏感」,後者需要一把與 RV 機制不同的尺,而樣本裡只有日報酬平方符合,它單獨一把撐不起這個更強的主張。
六、這個結論在什麼條件下不成立
結果檔自己列了六條限制,以下三條最會影響引用方式:
- 共識權重是啟發式的,不是識別出來的最適測量誤差權重。 潛在的積分變異數始終不可觀測, 這把尺是五個有偏觀測的加權逼近,不是真值的估計。
- 留一法只移除了直接的自我包含。 三把 RV 共用逐筆資料,測量誤差之間的相關性沒有被識別, 也沒有被建模。這正是第五節那張相關矩陣的意義。
- 只研究日盤。 夜盤是另一個盤別、另一批參與者,結論不外推。另外,選合約用的是當日成交量 最大的月份,這對盤後計算合理,但用到了當日結束後才知道的資訊,不能移植到日內交易。
還有兩條較技術性的:Parkinson 與日報酬平方保留了跳躍、漂移與微結構假設;MCS 用 1,000 次 重抽,對預先宣告的診斷足夠,但不足以支撐極端尾端的 p 值。
反過來說,有一個結論相對穩:HAR-RV 在這份資料上的領先不是量法的副產品。它跨六個目標、 兩種損失、兩段子樣本、六次 MCS 都成立,而它與後兩名的 DM t 全部超過 Harvey 門檻。 上面任何一條限制被放寬,都不會把這個結論推翻成「其實是另一個模型」。
七、文獻定位
多代理排名穩健性這個問題的起點是 Patton (2011):QLIKE 屬於 proxy-robust 損失族, 用有雜訊的代理仍能得到一致的排名,但前提是代理 條件無偏 。本實驗的第二節就是在補這個 前提:先把代理的系統性偏誤估掉再比較。Hansen and Lunde (2006) 討論的正是代理選擇如何 改變比較結論。
Liu, Patton and Sheppard (2015) 在數百個資產上比較了大量已實現量測,結論是很難穩定地打敗 五分鐘 RV;本實驗的權重結果與此相容,共識權重給五分鐘 0.3002 、十分鐘 0.3082 , 兩者接近,而日報酬平方幾乎沒有份量。
模型端,HAR 來自 Corsi (2009),模型信賴集來自 Hansen, Lunde and Nason (2011)。 內部前置知識方面,K1057 曾觀察到排名會在 RV 與報酬平方兩種原生目標之間翻轉, 那正是本實驗要用共同帳本處理的問題;本次的答案是:第一名不翻,第二三名翻。
八、數據來源
- 實驗:
experiments/k1704/,結果檔K1704_results.json,種子 42 - 資料:本地台指期全合約逐筆檔案,取每日成交量最大的月份合約,僅日盤時段, 2012-01-02 至 2026-07-14 共 3,548 個交易日;來源檔案逐檔複驗大小與內容雜湊全數相符
- 樣本外:2018-02-01 至 2026-07-14,共同帳本 2,016 天,帳本日期序列另存 sha256
- 模型重估:GJR-GARCH 每 21 天重估一次,共 122 次,估計失敗 0 次
- 本文兩張圖由
storage/drafts/k1704_research_charts.py程式化讀取結果檔產生,無硬編數值 - 一般讀者版:
mile_c4c34762
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊