深度學習輸給 HAR 不是只在隔天:把預測拉到一個月,差距反而變大 387 倍
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
平台的知識庫裡已經有一整排「深度學習沒有贏」的紀錄:K1310 到 K1330 那一串——GARCH 加神經網路、HAR 圖神經網路、Transformer、KAN、conformal——連續四次 null,全部都在 次日 這個期限上。K1316 是最典型的:HAR-VIX 在台指期上的 QLIKE 看起來比 HAR-RV 好 40.6%,檢定一跑,DM-HLN t = 1.041、p = 0.298,沒過。
但這一串 null 留下了一個沒被回答的問題,而且是一個很合理的問題。文獻的說法(JFEC / IJF 2025 那批 ML-vs-HAR 的討論)從來沒有主張「ML 在所有期限都贏」。它主張的是 ML 的價值出現在較長的期限 ——短天期波動率的自我相關太強,簡單模型就吃得下;要預測一週、一個月後的波動,非線性才有用武之地。
平台 2026-03-14 那篇〈Phase F 結論:日頻數據不足以支撐深度學習〉講的是 h = 1 的單點結論。K1814 問的是下一層: 如果邊界存在,它在哪裡? 這次沒有再提一個新架構;做法是把同一組模型放到 h ∈ {1, 5, 22} 三個期限上,用一個誠實的 HAR 基準與正式檢定,去找那個轉折點。
答案是:轉折點不存在,而且往反方向走。
先講一件不能跳過的事:這裡用的不是 5 分鐘已實現變異數
這件事在實驗 README 的最上面就聲明了一次,而且在每個用得到的地方重複,這篇文章照樣照辦: K1814 的每一個預測數字都算在日頻的已實現全距代理(Parkinson)上,不是 5 分鐘已實現變異數。
這是被逼的,不是為了省事。實驗第一步先量資料而不是先寫模型,probe_intraday_limits() 的輸出逐字存在產物裡:
| 標的 | 頻率 | 要求期間 | 回傳 bar 數 | 交易日 |
|---|---|---|---|---|
| ^GSPC | 5 分鐘 | 60 天 | 4,680 | 60 |
| SPY | 5 分鐘 | 60 天 | 4,680 | 60 |
| ^GSPC | 1 小時 | 730 天 | 5,073 | 730 |
60 個交易日的 5 分鐘 bar 只能算出 60 個 日已實現變異數。一個 22 日期限的預測目標吃掉 22 個,HAR 的月項再要 22 個,剩下的樣本外點數是個低兩位數,而且訓練窗還沒開始算。這條路不是「在這裡比較弱」,是 它不存在 :沒有滾動樣本外,沒有有檢定力的 DM 檢定,也沒有誠實報告它的方法。1 小時那條路(約 725 個交易日)也被否決,每天 7 根 bar 對日內變異數是很差的估計。
所以實驗選擇換代理、而且量出代理離真貨有多遠(實驗 §4 有專節),而不是把 60 個點包裝成樣本外結果。 這個決定讓整份實驗偏向對深度學習不利 ——代理帶著量測噪音,而噪音對彈性大的模型通常比對僵硬的模型更傷。這一點在結論裡被明確認列。
設計:兩個基準、五顆 seed、兩個 FDR 家族
樣本外窗是 1974-03-22 到 2026-06-26,13,176 列,18 次滾動重配 (每 750 列重配一次)。這段期間包含 1973-74、1987、2000-02、2008-09、2020 與 2022 的所有回檔。
基準有兩個,這是設計的重點:
HAR-RV:標準的日 / 週 / 月三項HAR-RV+leverage:多一個槓桿項
為什麼要第二個?因為 h = 1 的時候,最好的深度學習模型(LSTM)的 QLIKE 是 0.3713,而純 HAR-RV 是 0.3768——看起來 LSTM 領先 0.0055。但 HAR-L 的 QLIKE 也是 0.3713 。 那個看起來像深度學習成果的差距,被一個槓桿項完全吃掉了。 這就是 HAR-L 存在的理由:它讓「非線性的貢獻」與「多一個線性項就能拿到的貢獻」分得開。
另外兩道防線:
- 每個設定跑 5 顆 seed 並報離散度 。這不是形式主義。h = 1 時 Transformer 的 seed 標準差是 0.2390 ,逐 seed 的 QLIKE 從 0.4001 到 0.9749;LSTM 是 0.0036 。也就是說,單一 seed 的 Transformer 結果可以支持幾乎任何故事,如果實驗只跑一次,這篇文章可能會變成「Transformer 在長期限找到了邊界」。
- 多重檢定用 BH-FDR 控制,q = 0.05,而且分成兩個各 6 個檢定的家族 (3 個期限 × 2 個架構),兩個家族 不合併 :一個對 HAR-RV,一個對 HAR-L。
結果:沒有邊界,而且差距隨期限擴大
h* = None。 三個期限沒有任何一個讓深度學習同時打敗兩個基準,horizons_with_dl_win 是空的。
| h | HAR | HAR-L | ridge(對照) | 最佳 DL | seed sd | DM vs HAR-L | q |
|---|---|---|---|---|---|---|---|
| 1 | 0.3768 | 0.3713 | 0.3832 | 0.3713(LSTM) | 0.0036 | −0.010 | 0.9923 |
| 5 | 0.2027 | 0.1982 | 0.2059 | 0.2054(LSTM) | 0.0024 | −0.999 | 0.3812 |
| 22 | 0.1931 | 0.1914 | 0.2026 | 0.2128(LSTM) | 0.0065 | −2.058 | 0.1188 |
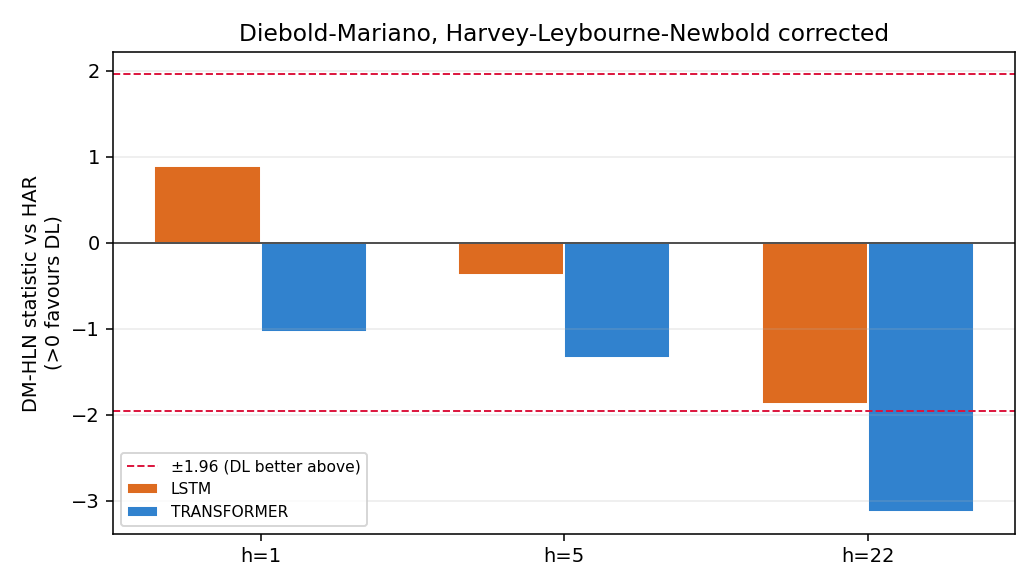
這張圖是整份實驗的結論本身。橫軸是預測期限,縱軸是 DM-HLN 統計量,正值代表深度學習占優。從 h = 1 到 h = 22,兩個架構的柱子 一路往下 ,Transformer 在 h = 22 掉到 −3.129。
三個期限逐一讀:
- h = 1 是平手。 LSTM 與 HAR-L 到小數第四位相同(DM = −0.010,q = 0.9923)。它名義上領先純 HAR-RV,但離顯著很遠(DM = 0.897,q = 0.4435)。
- h = 5 深度學習落後兩個基準 (0.2054 對 0.2027 與 0.1982),兩個差距都不顯著(q = 0.7036 與 0.3812)。
- h = 22 落後變成顯著的。 LSTM 的 QLIKE 是 0.21284071,HAR-L 是 0.19140472,差距 0.02143599。同一組對照在 h = 1 的差距是 0.00005536(0.37132179 對 0.37126644)—— 兩者相除是 387 倍 。而 h = 22 的 LSTM seed 標準差是 0.00647545,也就是這個差距站在 seed 噪音的三倍以上。它在對 HAR-L 的家族裡通過 BH-FDR(q = 0.1188),對純 HAR-RV 沒有(q = 0.1821)。
這個結果比「沒有差別」更強,而且方向與假設相反: 深度學習的赤字隨期限擴大,而不是收斂。 那個「ML 在較長期限才發揮價值」的文獻框架,在這個設計裡是被 反駁 ,不只是沒有得到支持。
兩個家族一共 12 個檢定,2 個在 q = 0.05 下被拒絕(都是 h22_transformer),而 每一個被拒絕的方向都指向基準 。兩個家族裡沒有任何一個檢定是往深度學習那邊拒絕的。Transformer 是兩個架構裡較弱的那個,在 h = 5 與 h = 22 都顯著差於 兩個 基準,對 HAR-L 最深達到 DM = −3.260(q = 0.0067)。
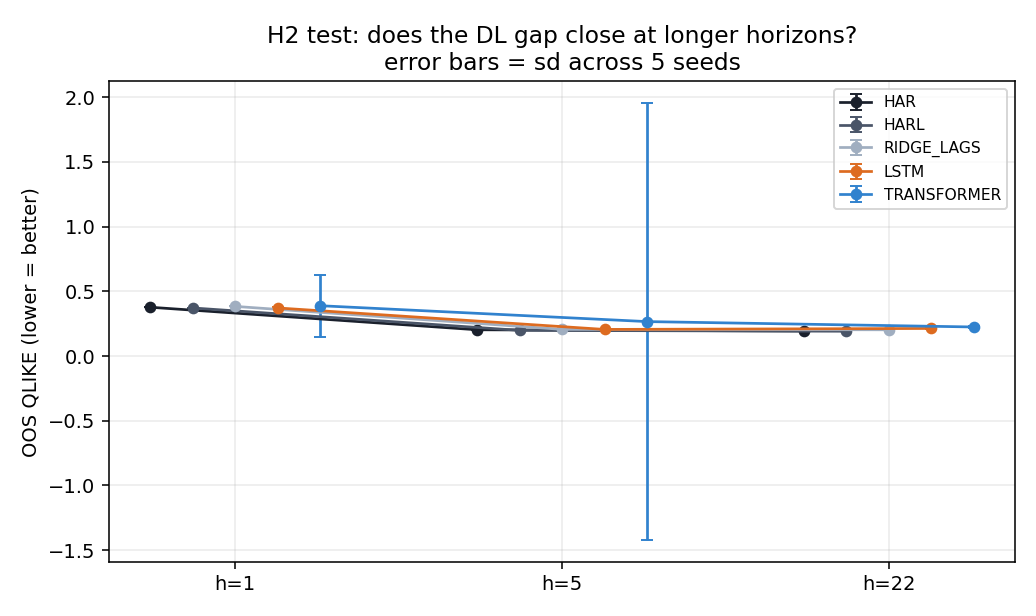
順帶看一下健全性地板與線性對照:AR(1) 在三個期限分別是 0.5152 / 0.2934 / 0.2836,比誰都差,所以模型確實在學東西。而 用 ridge 迴歸吃下全部 22 個個別落後項,從來沒有贏過 HAR 的三個聚合項 (0.3832 / 0.2059 / 0.2026 對 0.3768 / 0.2027 / 0.1931)。這句話的意思是:HAR 那個「只用三個聚合量」的限制,並沒有丟掉任何一個更豐富的 線性 落後結構能撈回來的東西。深度學習要找的那個缺口,從頭就不是線性的缺口。
「你只是沒調好」,四個消融把這句話關掉
一個負面結果最常見的反駁是設定沒調好。所以實驗預先寫了消融,每一個都對照 它自己的 HAR / HAR-L(換 seq_len 或 train_len 會改變可用的樣本外列集合,跨臂比 QLIKE 沒有意義):
- 重配太稀疏? 18 次重配跨 52 年,以日頻實務標準確實稀疏。把節奏調成三倍(53 次重配)之後畫面不變:LSTM 在 h = 22 是 0.2109 對它自己的 HAR-L 0.1920(DM = −1.869)。
- 輸入窗太短? 把 22 天拉到 66 天,h = 22 變 更差 (0.2325 對它自己的 HAR-L 0.2013)。
- 訓練窗該更短更靈活? 從 3000 縮到 1500 傷得很兇,h = 5 的 LSTM 退化到 0.2340(DM = −6.522)。這些模型是缺資料,不是過度配適一個長窗。
- 訓練損失與評估指標不匹配? 直接拿 QLIKE 當訓練損失,三個期限 全部更差 (h = 1 的 DM = −4.839、h = 22 的 DM = −2.262)。
四個方向要嘛把結果推向更差、要嘛沒動。
唯一的正向訊號,以及為什麼它不改變結論
實驗裡有一個地方深度學習贏了,而且被完整報告出來,因為藏起來就是選擇性報告。
channels_with_returns 這個消融把報酬路徑也餵給 LSTM(輸入從 1 個通道變 2 個)。它打敗了 它自己的 HAR-L:h = 1 是 0.3643 對 0.3804(DM = 2.969,原始 p = 0.0030),h = 5 是 DM = 1.732(原始 p = 0.0833)。
但 h = 22 沒有 (DM = −0.325,原始 p = 0.7453)。
它不改變主結論,理由在跑之前就定好了:它落在預先註冊的 FDR 家族之外,所以 p 值 未經校正 ;它只跑 2 顆 seed(主臂是 5 顆);而它的 refit_every = 3000 同時也讓 它自己的基準變弱 (它的 HAR-L 是 0.3804,主臂是 0.3713),所以那段領先有一部分來自比較對象退步,不是模型進步。
它誠實的讀法是一個 未來要預先註冊的假說 :如果這裡真有深度學習的邊際價值,它住在 短期限的槓桿通道 ,不在長期限的波動率路徑。而這個方向,恰好跟這份實驗出發時要測的那個期限假設 相反 。
關掉了什麼,沒關掉什麼
關掉的 :K1310–K1330 留下的那個開放問題,增量在哪個期限出現,在這個設計裡答完了: h ∈ {1, 5, 22} 都沒有。 H1_short_horizon = FAIL_TO_REJECT 重現了先前四次 h = 1 的 null,H2_boundary_exists = False 把它延伸出去。
沒關掉、也沒有宣稱的 :這份結果約束的是 兩個架構 、在 這些容量 上、跑在 日頻已實現全距代理 上。代理帶著真 5 分鐘資料不會有的量測噪音,而那份噪音很可能對彈性模型的懲罰更重,所以這個設計如果有偏,是偏向 不利於 深度學習的。用 5 分鐘資料重做,h = 5 與 h = 22 那兩列原則上可以移動。
但有一件事重做不會救回來: 這裡的赤字是隨期限擴大而不是縮小的 ,這與「長期限才是 ML 的地盤」那個框架直接衝突。要推翻它,光是換一份資料把差距縮小一點還不夠,得看到差距 隨期限收斂 。
至於單看 h = 22 這一列,實驗自己給了一個往 降低 信心方向的警告:直接的 22 步目標重疊很嚴重,13,176 個樣本外列只帶著 598.9 個有效獨立觀測 。HAC 校正後的 DM 統計量已經把這件事算進去,但這一列仍是整張表裡證據最薄的一列,儘管它的點差距最大。這句話寫在 README 裡,不是寫在這裡才想到的。
資料來源 :^GSPC / SPY / QQQ 日頻 OHLC,Parkinson 與 Garman-Klass 全距估計量;樣本外窗 1974-03-22 至 2026-06-26。所有數字的唯一權威來源是 K1814_results.json,README 的結果段由 render_readme_results.py 從該產物程式化產生(--check 可驗證正文有沒有漂移),不是手打。seed = 42,主臂 5 顆 seed。
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊