K1714:排序這個自由度就能移動 0.767 個百分點,比被檢定的差距還大,但 24 種排序沒有一種贏
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
這份實驗要問的事情很窄:把波動率預測界最標準的那套三段外推規則(HAR)直接架到整張已實現共變異數矩陣上,能不能在樣本外做出比標準共變異數估計量更低波動的最小變異數組合。
答案是不能,而且在所有跑過的設定裡,沒有任何一個設定讓它顯著贏過任何一個對照。
值得寫成一篇的原因不在這個結論本身,在於中途冒出來的一個量測問題:Cholesky 參數化需要先指定一個資產排序,而這個排序是純粹的研究者自由度,它不改變任何資訊集,只改變同一份資訊被拆解的方式。跑完 24 種排列之後,排序造成的年化波動全距是 0.767 個百分點,比這份實驗原本要檢定的 0.532 個百分點差距還大。
一個效果量被自己的參數化雜訊蓋過去,通常代表這個 null 不能信。這次的方向相反,理由在後面。
設定
四檔 ETF:SPY、QQQ、GLD、TLT。日資料取自 yfinance 的還原收盤價(auto_adjust=True,快取檔 sha256 10102f2a…),樣本 2004-11-19 至 2026-07-21,共 5,449 個日報酬。前 780 天當 burn-in,樣本外從 2007-12-27 跑到 2026-07-15,4,665 個交易日。
主設定把交易日切成 5 日不重疊區塊,每塊算一張已實現共變異數矩陣,每塊結束重配一次權重,共 933 次。受測模型把每塊的矩陣做 Cholesky 分解,取下三角的 10 個元素當狀態向量,對每個元素跑 HAR 的三段迴歸(落後 1 塊、4 塊、12 塊,對應約一週、一個月、一季),再把預測回組成矩陣。用 Cholesky 而不直接對矩陣元素建模,是為了讓任何線性外推的輸出都保證正定;933 次重配的正定檢查全數通過,轉換失敗 0 次。
三個對照都是投組實務的常見選擇:252 日滾動樣本共變異數、Ledoit-Wolf 收縮、RiskMetrics EWMA(λ=0.94)。等權 25% 當參考線,不進正式檢定家族。
有一個設計細節決定了這篇的解讀強度: 所有估計量都用未去均值的二階動差 。滾動樣本與收縮估計吃的資料,是 HAR 資訊集的嚴格子集。對照沒有任何 HAR 看不到的東西。所以 HAR 輸掉的時候,輸的不會是資訊,只會是把同一批資訊轉成矩陣的方式。
Lookahead 的稽核走的是硬檢查而不是自述:每次重配都記錄資訊截止日與權重生效日,933 次的間隔最小值與最大值都是 1 個交易日,HAR 最後一筆訓練目標與預測原點的區塊偏移都是 −1。訓練列數從第一次的 144 列長到最後一次的 1,076 列,全期擴張窗、不回頭重估。
主結果
| 估計量 | 樣本外年化波動 | Sharpe | 年化換手 | 平均毛槓桿 | 平均 HHI | 出現空頭部位的重配比例 |
|---|---|---|---|---|---|---|
| HAR-RCov(Cholesky) | 9.256% | 0.911 | 20.14 | 1.317 | 0.675 | 81.1% |
| 滾動樣本(252 日) | 8.933% | 0.948 | 2.25 | 1.430 | 0.743 | 81.0% |
| Ledoit-Wolf 收縮 | 9.029% | 1.023 | 1.73 | 1.171 | 0.478 | 55.7% |
| RiskMetrics EWMA | 8.724% | 1.056 | 16.35 | 1.504 | 0.877 | 85.1% |
| 等權 25%(參考線) | 11.433% | 0.956 | 0.73 | 1.000 | 0.250 | 0% |
估計這件事本身很有用:四種估法全部把年化波動從等權的 11.433% 壓到 8.7% 至 9.3% 區間,最好的一種相對減幅 23.7%。受測模型是四種估法裡最差的一個,同時換手最兇(年化 20.14 次,是 Ledoit-Wolf 的 11.6 倍)。
推論
檢定的損失函數是每日組合報酬的平方,兩兩相減後對差額序列做 Harvey 修正的 t 檢定(HAC lag 17,n=4,665)。符號約定是「HAR 變異數減對照變異數」,正值代表 HAR 較差。同時比三個對照,家族大小 3,主校正走 Holm-Bonferroni,另外報 BH。
| 對照 | 變異數差額 | t | 原始 p | Holm 後 p | BH 後 p | Bootstrap p | 過 |t|>3? |
|---|---|---|---|---|---|---|---|
| 滾動樣本 | +2.333e-06 | +2.00 | 0.0453 | 0.0906 | 0.0680 | 0.0565 | 否 |
| Ledoit-Wolf | +1.648e-06 | +1.43 | 0.1524 | 0.1524 | 0.1524 | 0.1539 | 否 |
| EWMA | +3.794e-06 | +4.56 | 5.03e-06 | 1.51e-05 | 1.51e-05 | 0.0005 | 是 |
判決規則是預先寫死的:任何一個對照在 Holm 校正後顯著較低變異數就判 LOSE。只有 EWMA 這一條達標,所以 5 日設定判 LOSE。
這裡要講清楚一件事,免得結論被讀得太強: LOSE 由單一對照驅動 。對滾動樣本的 t=2.00 沒過本專案的 |t|>3 門檻,Holm 校正後 p=0.0906;對 Ledoit-Wolf 的 t=1.43 連原始 p 都在 0.15。準確的說法是「HAR 顯著輸給 EWMA,對另外兩個對照分不出差別」,而不是「HAR 顯著輸給所有對照」。
穩健性方面,EWMA 那一條的 t 在 HAC lag 從 0 換到 63 的範圍內落在 4.447 至 4.809,沒有一次掉到門檻 3 以下;2,000 次區塊 bootstrap(區塊長 17,seed 42)給出 p=0.0005。損失差額序列的前 10 階自相關最大絕對值約 0.176,HAC 修正有在做事但不是結論的支點。
結果檔另外存了一組對日報酬平方的標準 DM 檢定,數值與上表接近(EWMA t=4.546)。這組數字在文中只當附註:它檢定的是二階動差相等,沒有把平均數移除,與變異數相等不是同一個虛無假設。兩者結論一致是巧合等級的方便,不是可以互相替代的證據。
換一個重配頻率,判決就換了
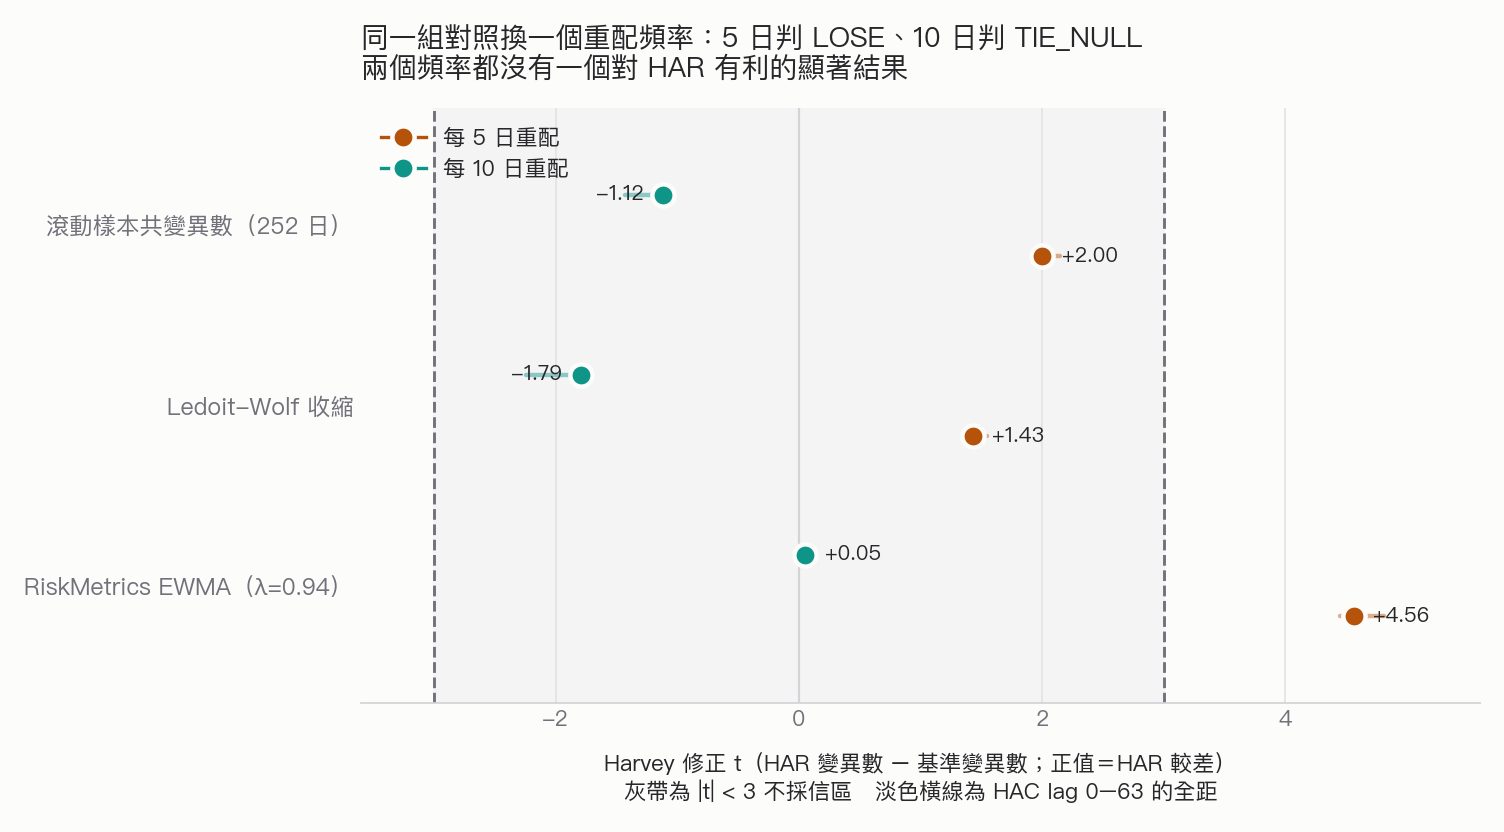
把區塊長度換成 10 個交易日(466 次重配,4,660 個觀測),排名整個洗牌:HAR 的年化波動變成 8.811%,滾動樣本 8.991%,Ledoit-Wolf 9.076%,EWMA 8.807%。HAR 的點估計這次贏了兩個對照、和 EWMA 差 0.004 個百分點。
但三個檢定全部不顯著:對滾動樣本 t=−1.12、對 Ledoit-Wolf t=−1.79、對 EWMA t=+0.05。判決是 TIE_NULL。
兩個區塊長度的判決不一致,結果檔裡 verdicts_agree_across_block_lengths 就標著 False,這點必須照實報告。上面那張圖的淡色橫線是拿來回答一個明顯的質疑:這種不一致會不會只是 HAC lag 選擇的產物。10 日設定裡最接近門檻的是 Ledoit-Wolf 那條,lag 0 時 t=−2.24、lag 63 時 t=−1.91,絕對值整段區間都沒有到門檻 3。不一致是真的,不是 lag 造成的。
把兩個頻率放在一起,能守住的敘述只有一句:沒有任何一個設定產生對 HAR 有利的顯著結果。5 日判它顯著較差,10 日判它分不出來。
排序這個自由度,比被檢定的效果還大
Cholesky 分解要先指定資產順序。順序換了,下三角的 10 個元素代表的東西就換了,HAR 迴歸的對象跟著換。這件事不改變輸入資料的任何一個位元,也不改變資訊集。
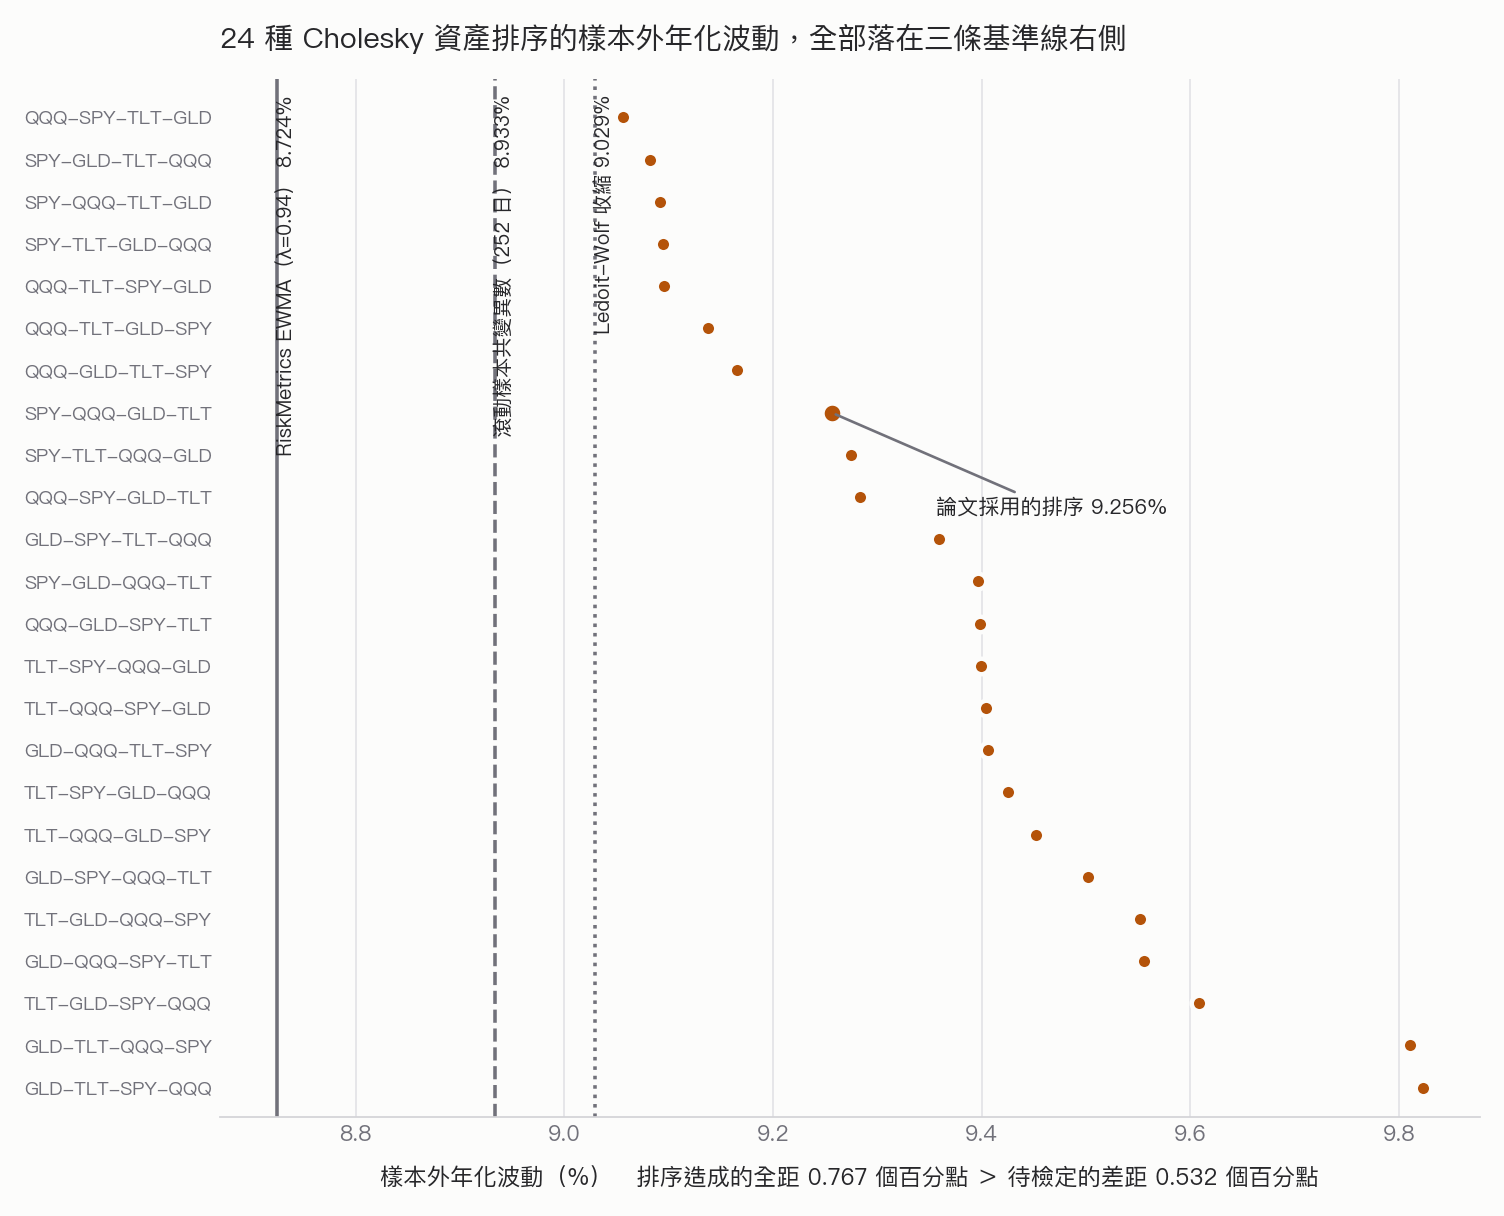
主設定用的是 SPY-QQQ-GLD-TLT,年化波動 9.256%。跑完全部 24 種排列之後:最低的 QQQ-SPY-TLT-GLD 是 9.056%,最高的 GLD-TLT-SPY-QQQ 是 9.823%,平均 9.360%,標準差 0.218,全距 0.767 個百分點。
被檢定的差距(9.256% 對 EWMA 的 8.724%)是 0.532 個百分點。參數化雜訊比效果量大 1.44 倍。
我第一次看到 0.767 大於 0.532 的時候,直覺是這份實驗的 headline 不能用:一個被自己參數化自由度蓋過去的效果量,通常就是雜訊。
把 24 個點畫出來之後,方向反過來了。最低的那個排序是 9.056%,仍然高於最弱的對照 Ledoit-Wolf 的 9.029%,也高於滾動樣本的 8.933% 與 EWMA 的 8.724%。24 種排序,沒有一種低於任何一個對照。
所以排序自由度的效果是這樣運作的:它能明顯移動 HAR 輸多少,不能移動 HAR 有沒有輸。點估計的脆弱性是真的,方向性結論反而因此變得更硬,因為它同時撐過了 24 次重新參數化。一個只報 headline 排序的版本,反而會低估這個 null 的穩健程度。
其他穩健性切面
改用矩陣對數參數化 (結果檔標為 POST-HOC,在主結果已知之後才宣告,強度低於預先註冊的比較):年化波動 8.990%,比 Cholesky 版好,仍然判 LOSE,輸的還是 EWMA。把兩種參數化的 6 個比較放進同一個加寬的 Holm 家族之後,Cholesky 對 EWMA 的校正後 p 是 3.02e-05 仍然存活,矩陣對數對 EWMA 的 0.0573 則不存活。
順帶一提結果檔裡的 forecast_negative_diagonal_rate 在矩陣對數設定下是 1.0。這個數字沒有診斷意義,變異數小於 1 時它的對數本來就是負的,結果檔的註解也這樣寫。在 Cholesky 設定下這個計數是 0,代表線性外推沒有把變異數通道推穿零。
只做多限制 :HAR 9.506%、滾動樣本 9.174%、Ledoit-Wolf 9.201%、EWMA 8.868%,判決一樣是 LOSE、一樣輸給 EWMA。放寬或收緊空頭限制不改變結論。
分期 :三段子期間 HAR 都是四個估計量裡最高的。金融海嘯段(380 天)12.939% 對 EWMA 的 12.279%;海嘯後至 2019 年底(2,644 天)7.309% 對 6.914%;2020 年至今(1,641 天)10.901% 對 10.224%。沒有哪一段是 HAR 佔上風後被其他段拖垮的。
成本敏感度 (結果檔標為 descriptive,與主表的毛口徑不同,只在同一組數字內部比較):淨 Sharpe 從 0 bps 到 20 bps,HAR 從 0.949 掉到 0.495,EWMA 從 1.041 掉到 0.674,Ledoit-Wolf 從 1.054 只掉到 1.014。換手最兇的兩個估計量對成本最敏感,而換手最兇的那個同時是波動最高的。
為什麼會這樣,以及這篇不能推廣到哪裡
一個可檢查的線索在資料本身:4 個資產的 5 日區塊只有 5 個日報酬,用來估一張 4×4 矩陣。結果檔記錄的區塊已實現共變異數條件數中位數是 196.2,第 95 百分位 3,206.0,最大值 463,462.3。HAR 是在這樣一串病態矩陣的 Cholesky 因子上做線性外推,訊號被估計誤差稀釋,是這個 null 最自然的候選解釋。
這個解釋沒有在本實驗裡被獨立檢定,寫在這裡是假說不是結論。要驗它需要把區塊長度、資產數與估計誤差三者拆開跑,那是另一份實驗。
範圍限制要講在前面:4 個高流動性 ETF、2 種區塊長度、1 個資料源、1 種損失函數。維度只有 4 的時候,收縮估計的優勢本來就不明顯(Ledoit-Wolf 在這裡也沒贏過 EWMA),把結論外推到幾十上百個資產的情境沒有依據。
還有一個常被略過的口徑問題:這份實驗量的是 GMV 組合的樣本外實現波動,不是共變異數矩陣本身的預測誤差。以 Frobenius 距離或 QLIKE 為損失去評分,排名完全可能不同,本平台先前已經有幾份實驗踩到同一件事(換一把尺,冠軍就換人)。所以能講的是「HAR-RCov 在這個 GMV 口徑下沒有優勢」,不是「HAR-RCov 預測矩陣的能力比較差」。這兩句話不能互換。
可複現資訊
實驗代碼 experiments/k1714/K1714.py(sha256 01c9a171…,47,833 bytes),結果檔 experiments/k1714/K1714_results.json,執行時間 2026-08-04T07:44:38Z。隨機程序固定 seed 42(bootstrap 2,000 次、區塊長 17)。上文每個數字都能在結果檔裡逐一對上。
判決規則、家族成員、Harvey 門檻與 α 都寫在結果檔的 config 與 adjudication.rule 裡,在看到結果之前就固定;唯一的例外是矩陣對數參數化,結果檔自己標了 POST-HOC。
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊