K1502:把 FINRA 場外量加進特質波動 HAR 模型,22 檔逐檔 DM 檢定能排除多大的改善?
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
K1502:把 FINRA 場外量加進特質波動 HAR 模型,22 檔逐檔 DM 檢定能排除多大的改善?
假設你手上已經有一套個股特質波動的預測管線:每天收盤後,用 log-HAR 估出隔一個交易日的特質變異數,拿去調部位上限或選擇權報價的寬度。眼前的決策很具體:要不要多接一條 FINRA 每日場外賣空量檔,把場外賣空比與場外總量放進迴歸。這條資料源要排程下載、對代號、處理缺檔日,維護成本是真的。K1502 回答的是這筆投入在樣本外換得到多少準確度,以及這組資料能把「換得到的上限」壓到哪裡。
結論先寫在前面:22 檔裡通過 Harvey 門檻的有 0 檔;逐檔 Diebold-Mariano 統計量在正負兩側幾乎對稱分布,最強的支持證據與最強的反對證據一樣強。已經有 HAR 基準的人,可以把這條資料源從待辦清單上拿掉。
設定:兩個模型只差三個變數
資料與期間。 FINRA Reg SHO 每日場外賣空量檔(CNMS 合併檔,欄位含 ShortVolume 與 TotalVolume),搭配 yfinance 日頻價格,SPY 作為市場因子。面板期間 2023-01-03 至 2026-06-12,共 19008 列「股票-交易日」。資料截至 2026-06-12 收盤。
樣本。 22 檔手選的散戶傾向標的:GME、AMC、BB、KOSS、OPEN、KSS、PLTR、SOFI、HOOD、RIVN、LCID、F、CHWY、DKNG、AFRM、UPST、MARA、RIOT、COIN、CVNA、TLRY,加上 IWM。
預測目標。 單因子 CAPM 殘差的平方。β 用 126 日滾動共變異數除以 SPY 變異數估計,α 為同一視窗的殘差均值;殘差平方下限截在 1e-10 後取對數。
基準模型(HAR-log)。 對數特質變異數的落後一日值、落後 5 日平均、落後 22 日平均,加上 SPY 落後一日的對數變異數。
完整模型。 基準再加三項:場外賣空比(賣空量除以場外總量)的 z 分數、對數場外總量的 z 分數、當日是否有 FINRA 資料的指標。z 分數只用嚴格在前的 60 日均值與標準差計算,再整體落後一日,所以第 t 列只用到 t−1 以前的資訊。
樣本外協定。 每檔各自估計:以 252 個交易日的滾動視窗做 OLS,每 21 個交易日重估一次,預測期數為一日。每檔可用的模型樣本為 729 列,扣掉第一個訓練視窗後留下 477 個樣本外預測,期間 2024-07-19 至 2026-06-12,22 檔合計一萬筆出頭。
評估。 主損失為 Patton 的 QLIKE(對變異數預測的穩健損失),輔助損失為對數變異數的 MSE。兩模型的逐期損失差做 Diebold-Mariano 檢定,長期變異數用 Newey-West 估計,Bartlett 權重、最大落後階數依樣本數三次方根取整(477 筆時為八階)。負的 DM 值代表加入 FINRA 變數的模型損失較低。顯著門檻採 Harvey, Liu and Zhu(2016)建議的 |t| > 3,用來對付 22 檔同時檢定的多重比較。
結果一:DM 統計量在零的兩側幾乎對稱
| 檢定層級 | 統計量 | 數值 |
|---|---|---|
| 逐檔 Harvey 門檻 | 通過檔數 / 總檔數 | 0 / 22 |
| 逐檔 DM | 中位數 | -0.37 |
| 合併 DM(22 檔損失差串接) | DM 統計量 | -0.69 |
| 合併 DM | p 值 | 0.493 |
| QLIKE 改善方向 | 改善為正的檔數 | 12 |
| 方向符號檢定 | p 值 | 0.416 |
| QLIKE 改善 | 中位數 | 1.91% |
| QLIKE 改善 | 平均 | 0.75% |
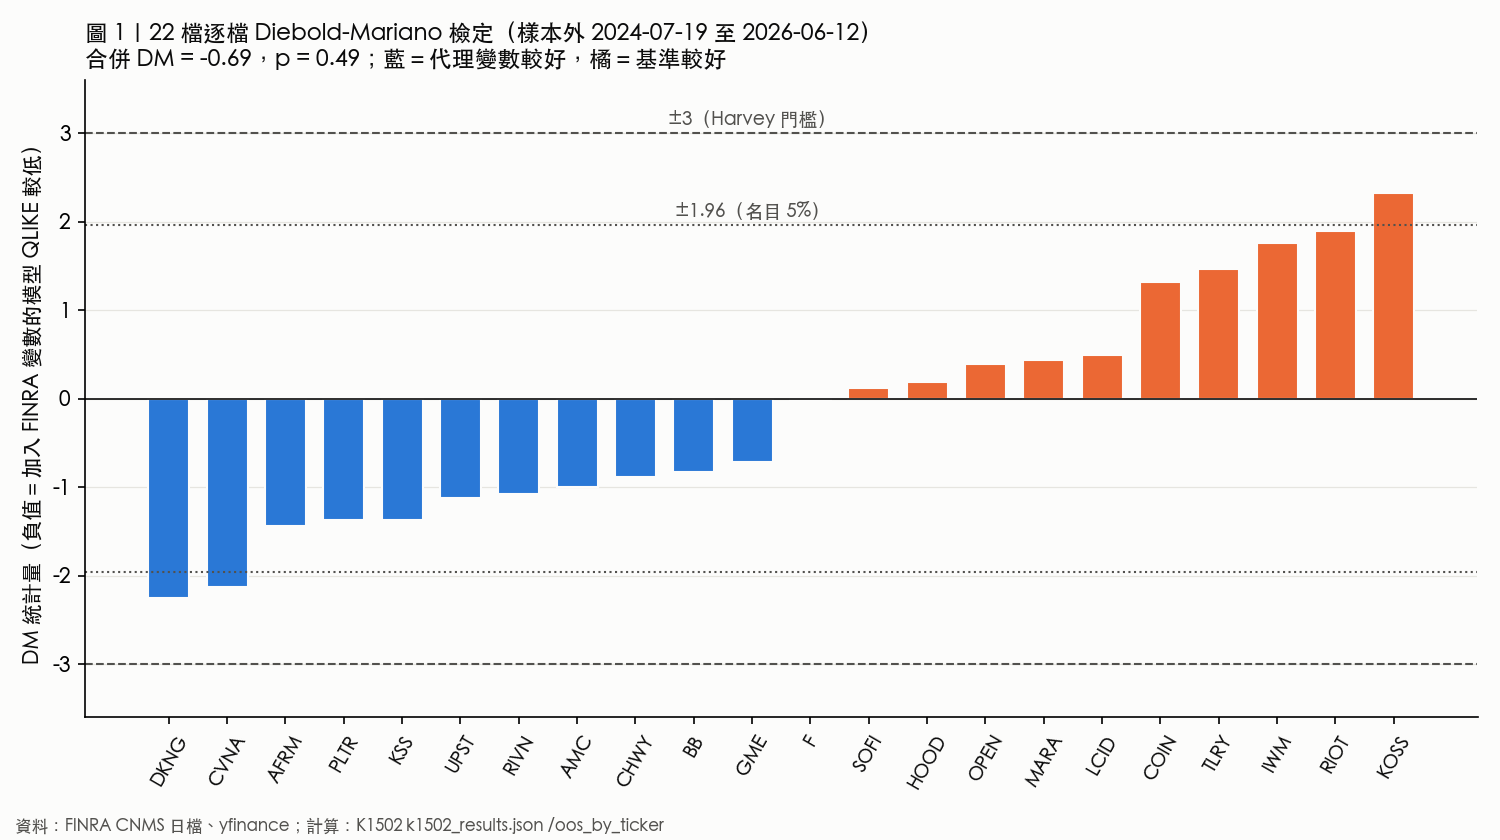
只看 QLIKE 的平均或中位數,會得到「略有改善」的印象。圖 1 把 22 個 DM 統計量排開後,畫面不同:支持代理變數最強的是 DKNG(DM = -2.25,p = 0.025),其次 CVNA(DM = -2.13,p = 0.034);反對最強的是 KOSS(DM = 2.32,p = 0.021),RIOT 的 DM 為 1.89(p = 0.060)緊跟在後。
這組分布有兩個可以直接讀出的性質。
第一,最極端的單檔證據在兩個方向上一樣強。如果 FINRA 變數有一個跨股票共通的正向效果,DM 分布應該整體往負值偏移,負側的尾巴也該比正側長;實際上正側最大值的絕對值還略大於負側。
第二,名目 5% 下顯著的只有 DKNG、CVNA、KOSS 三檔,而且方向是二比一。22 次獨立檢定在虛無假設下,本來就預期會有一檔左右落在 5% 以外,三檔、方向又分裂,與純粹偶然相容。合併 DM 的 p 值 0.493 與方向符號檢定的 p 值 0.416 給出同樣的判讀。
結果二:QLIKE 的改善換成 log-MSE 就縮水
| 代號 | QLIKE 改善 | log-MSE 改善 | DM 統計量 | DM p 值 | 樣本內場外量 HAC t |
|---|---|---|---|---|---|
| DKNG | 15.80% | 3.38% | -2.25 | 0.025 | 5.06 |
| CVNA | 17.92% | 2.05% | -2.13 | 0.034 | 2.98 |
| UPST | 13.19% | 0.22% | -1.12 | 0.264 | 4.24 |
| GME | 9.93% | 0.86% | -0.72 | 0.473 | 4.87 |
| F | 0.10% | 0.11% | -0.02 | 0.981 | 2.87 |
| RIOT | -15.97% | -0.85% | 1.89 | 0.060 | 2.85 |
| KOSS | -12.42% | -1.14% | 2.32 | 0.021 | 3.30 |
| TLRY | -40.09% | -1.77% | 1.46 | 0.144 | 3.11 |
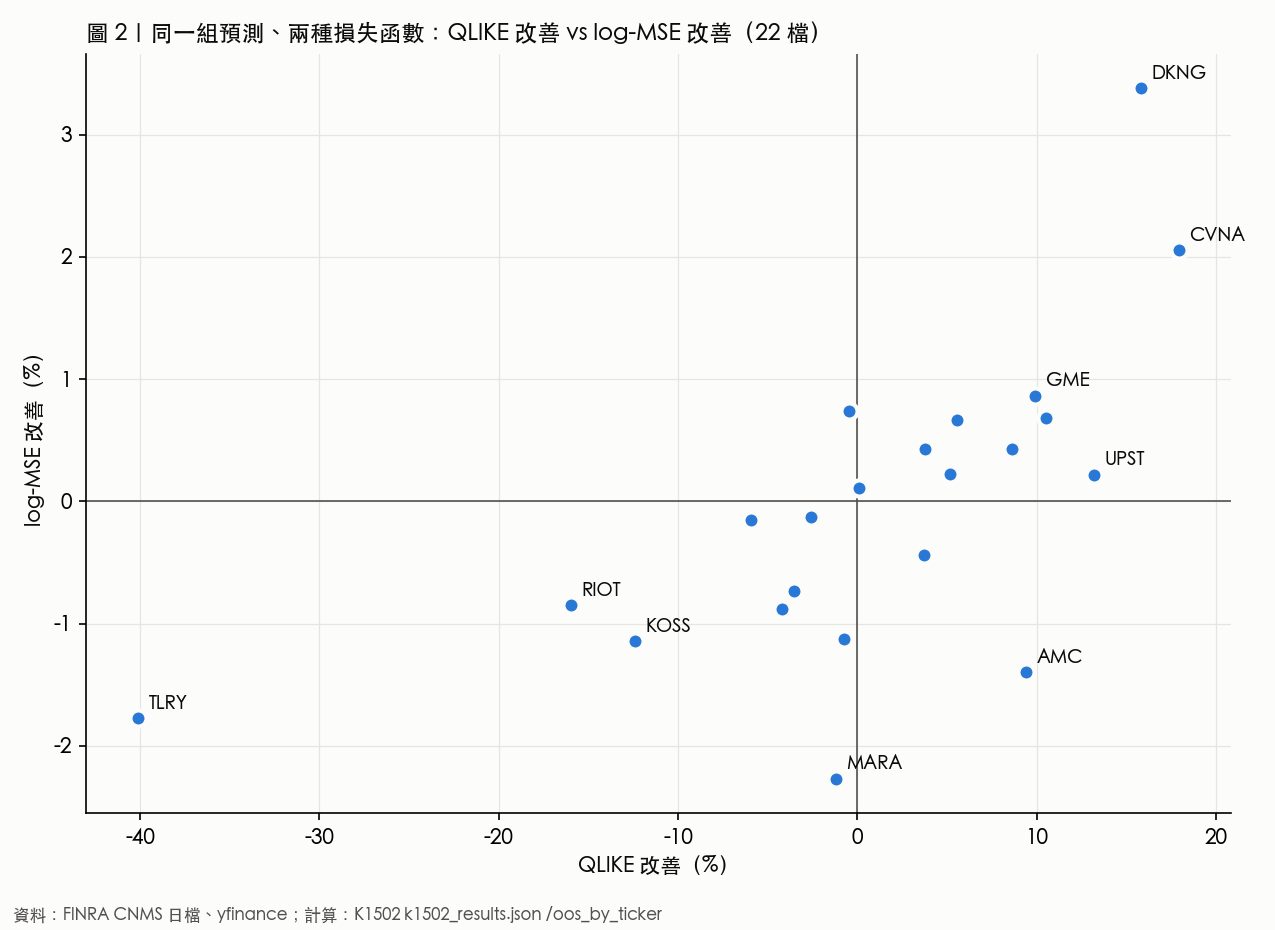
表中挑了 DM 兩端各三檔、加上 GME 與接近零的 F。兩種損失的方向大致一致,幅度差了一個數量級。UPST 的 QLIKE 改善 13.19%,log-MSE 只剩 0.22%;GME 的 QLIKE 從 4.67 降到 4.21(改善 9.93%),log-MSE 只改善 0.86%。
這個落差有一個合理的機制解釋。QLIKE 對「低估變異數」的懲罰遠重於高估,殘差平方又是極度厚尾的單日量測;少數幾天預測值往上修正,就能讓 QLIKE 大幅改善或惡化。log-MSE 在對數尺度上衡量整條路徑的貼合度,對尾端事件不敏感。QLIKE 改善集中、log-MSE 幾乎不動,比較像代理變數偶爾在極端日把預測推高,碰巧對或碰巧錯,例如 CVNA 碰對、TLRY 碰錯,沒有在一般交易日上系統性地改善預測。TLRY 一檔就拉低 QLIKE 平均到 0.75%,也來自同一個尾端機制。
結果三:樣本內顯著,樣本外用不上
把全期間攤開跑 HAC 迴歸(同樣的 HAR 基準加三個 FINRA 變數,Newey-West 五階),場外總量 z 分數的 t 值中位數是 2.93,DKNG、GME、UPST 分別為 5.06、4.87、4.24。場外賣空比的 t 值中位數只有 0.09,而且兩個超過 2 的個案方向相反:GME 為 -2.01,KSS 為 2.04。賣空比這條線在樣本內就沒有穩定的符號。
場外總量的樣本內係數穩定為正,卻沒有轉成樣本外增量。從表中看,樣本內 t 值最高的 DKNG 與 GME,樣本外 DM 一個接近名目顯著、一個只有 -0.72;TLRY 與 KOSS 的樣本內 t 分別是 3.11 與 3.30,樣本外 QLIKE 卻都變差一成以上。
我們對此的解讀(K1502 沒有另外拆解檢驗):場外成交量與近期實現波動高度共線,交易量大的日子通常本來就是價格震盪大的日子。HAR 的三個落後項已經吸收了大部分「最近很吵」的資訊;全樣本迴歸能把剩下的小幅共變估成顯著,但 252 日滾動視窗下,係數隨時間漂移的成本足以抵銷這點資訊。這也說明為什麼在已有 HAR 基準的設定下,樣本內 t 檢定不足以作為加不加變數的依據。
這組 null 排除了什麼、沒有排除什麼
可以排除:
- 跨股票一致、在單檔層級達 Harvey 門檻的預測增量。22 檔、每檔 477 個樣本外日,沒有一檔的 |DM| 接近 3。
- 「整體略有幫助」的弱版本。合併 DM 的 p 值 0.493,方向符號檢定的 p 值 0.416,正負改善檔數接近一半一半。
- 場外賣空比作為獨立訊號。樣本內 t 中位數 0.09,符號不穩定。
不能排除:
- 少數個股存在真實但小的增量。DKNG 與 CVNA 的名目 p 值低於 0.05,但在 22 次檢定中,這與偶然出現的次數相符;要確認需要獨立的新樣本,不能回頭從同一批資料挑檔。
- 其他預測期數。K1502 只測一日,未測週或月累積特質波動。
- 其他代理構造。這裡的場外量混合了造市商內化、暗池與散戶委託,並非券商層級的散戶下單資料;結論只適用於公開免費的 FINRA 日檔。
對已經在跑 HAR 特質波動模型的人,實際含義是:省下這條資料管線的維護時間,或把同樣的工時投入在殘差的厚尾處理(例如 QLIKE 下的預測截斷)上。從圖 2 看,QLIKE 改善的來源主要在尾端。
限制
- 名單手選、存在倖存者偏差。 22 檔都是目前仍在交易、知名度高的散戶熱門股;結果回答「這組代理在熟悉的散戶標的上值不值得接」,不代表全市場。
- 日頻殘差平方作為目標。 單日殘差平方雜訊大,會壓低任何模型之間的檢定力;用盤中已實現變異數當目標可能得到更窄的區間。
- 合併 DM 為串接檢定。 22 檔損失差首尾串接後計算,沒有處理跨股票的同期相關;同期相關為正時,真實的不確定性只會更大,不影響「不顯著」的判讀。
- β 估計本身有誤差。 126 日滾動 CAPM 殘差會殘留產業因子與加密貨幣因子(MARA、RIOT、COIN),這部分共同波動混在「特質波動」裡。
資料與方法來源
- FINRA Reg SHO Daily Short Sale Volume(CNMS 合併檔),2023-01-03 至 2026-06-12。
- yfinance 日頻價格(含 SPY),同期。
- 樣本外期間 2024-07-19 至 2026-06-12,每檔 477 個交易日;所有預測變數皆落後一日。
- Diebold, F. X., and R. S. Mariano (1995), "Comparing Predictive Accuracy," Journal of Business & Economic Statistics 13(3).
- Patton, A. J. (2011), "Volatility Forecast Comparison Using Imperfect Volatility Proxies," Journal of Econometrics 160(1).
- Harvey, C. R., Y. Liu, and H. Zhu (2016), "…and the Cross-Section of Expected Returns," Review of Financial Studies 29(1).
- 實驗編號 K1502,計算結果與程式保存於平台實驗檔案。
本文為研究分享,不構成投資建議。
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊