時序基礎模型在 SPY、0050.TW 與台指期的波動預測:TimesFM 與 TTM 裸用的 QLIKE 比 HAR-A 高 13.8% 到 29.9%;經校準或與 HAR 組合後留在模型信心集合內,最低 QLIKE 仍是 HAR-A
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
時序基礎模型在 SPY、0050.TW 與台指期的波動預測:TimesFM 與 TTM 裸用的 QLIKE 比 HAR-A 高 13.8% 到 29.9%;經校準或與 HAR 組合後留在模型信心集合內,最低 QLIKE 仍是 HAR-A
摘要
Google 的 TimesFM 與 IBM 的 Tiny Time Mixers(TTM)是零樣本時序基礎模型:不用替資料重新訓練,把歷史輸入就直接輸出預測。本文把它們放進一個波動率預測模型池,與 HAR 家族一起接受 Hansen、Lunde 與 Nason 的模型信心集合(Model Confidence Set,MCS)檢驗。本文問的是:含基礎模型的候選是否留在最佳集合內,以及原本 HAR 家族的最佳集合是否因它們而改變。這個問法不要求任何一個基礎模型打敗 HAR。
四個結果,強度依證據排序:
- 裸用的 TimesFM 與 TTM 在三個主要格點都被淘汰。 一步預測、2016 年 7 月起的樣本外、α = 0.10,兩個模型都不在 SPY、0050.TW 與台指期的最佳集合內;它們的平均 QLIKE 比 HAR-A 高 13.8% 到 29.9%。
- 經過 Mincer–Zarnowitz 校準,或與 HAR 組合後的模型,三個市場都至少有一個留在集合內。 留在集合內只代表沒被淘汰,三個市場的最低 QLIKE 都仍是 HAR-A。
- 跨資產合併後的最佳集合是 {HAR-A, COMB-MZ}。 合併以 2,344 個共同日期為樣本,先按日平均三個資產的 QLIKE 再重抽樣,避免把三個同日衝擊當成三個獨立樣本。
- 加入基礎模型後,只有 SPY 的 HAR 家族集合改變,方向是較弱的 HAR 重新入列,沒有任何一個基礎模型把 HAR 擠出去。
正式判定為 TSFM_BEARING_MODELS_SURVIVE_MCS_NO_WINNER_OR_INCREMENTAL_CLAIM:基礎模型的預測沒有被排除,但不能說它勝出,也不能說加入它有顯著的增量。
研究問題與文獻
HAR 模型(Corsi, 2009)是已實現波動率預測的標準基準。近兩年,在大量時間序列上預訓練的基礎模型(Das 等人,2024;Ekambaram 等人,2024)被宣稱可以不經訓練直接用於新序列。波動率預測的評分帶有雜訊,單看平均損失排名容易把運氣當成冠軍;Hansen、Lunde 與 Nason(2011)的 MCS 回答另一個問題:在給定信心水準下,哪些模型不能被集合程序排除。損失函數取 Patton(2011)證明對不完美波動率代理仍一致的 QLIKE。
資料與設計
資料。 SPY、0050.TW 與台指期(TX)的日資料。SPY 與 0050.TW 的已實現波動率代理是日 OHLC 的 Garman–Klass 變異數;TX 用本機五分鐘資料、按成交量選主力合約的日已實現波動率。樣本外起點 2016 年 7 月,終點與樣本數見下表。
| 資產 | 評分期間 | 評分日數 | 波動率代理 |
|---|---|---|---|
| SPY | 2016-07-01 至 2026-07-10 | 2,519 | 日 OHLC 的 Garman–Klass 變異數 |
| 0050.TW | 2016-07-01 至 2026-07-09 | 2,426 | 日 OHLC 的 Garman–Klass 變異數 |
| TX | 2016-07-01 至 2026-07-09 | 2,438 | 五分鐘資料的日已實現波動率 |
每個資產只用自己的歷史預測自己的波動率,沒有把一個市場的序列配到另一個市場的日期上。
模型池。 基準 4 個:RW、AR1、HAR、HAR-A。含基礎模型 7 個:TimesFM、TTM、兩者的 Mincer–Zarnowitz 校準版(TimesFM-MZ、TTM-MZ)、以及與 HAR 的三種組合(COMB-EW 等權、COMB-MZ 校準後組合、COMB-GR 估計權重)。TimesFM 檢查點為 200M 參數的 2.5 版,文件載明的訓練資料截止在 2023 年;兩個模型的輸入脈絡長度 512,預測期 32。HAR 與校準都用擴張窗口估計,訓練列必須比預測目標早一個預測期以上,最小訓練長度分別是 500 與 400。
檢定。 主要判定只讀 MCS 成員資格:Hansen–Lunde–Nason 的 T-max 淘汰程序,5,000 次 bootstrap,固定種子 20260714,信心水準 α = 0.10。成對的非巢狀比較用 Diebold–Mariano 檢定(Diebold & Mariano, 1995)加 Harvey、Leybourne 與 Newbold(1997)的小樣本修正,HAC 頻寬 14,只當診斷。巢狀的模型對(AR1 對 HAR、HAR 對 HAR-A、HAR 對 COMB-GR)在虛無假設下原始 DM 不是合法檢定,結果檔把它們固定標為診斷,不進入任何判定;巢狀的均方誤差用 Clark 與 West(2007)的校正。巢狀的 QLIKE 沒有已實作的合法檢定,因此該項判定記為無結論。
結果一:最佳集合與平均 QLIKE
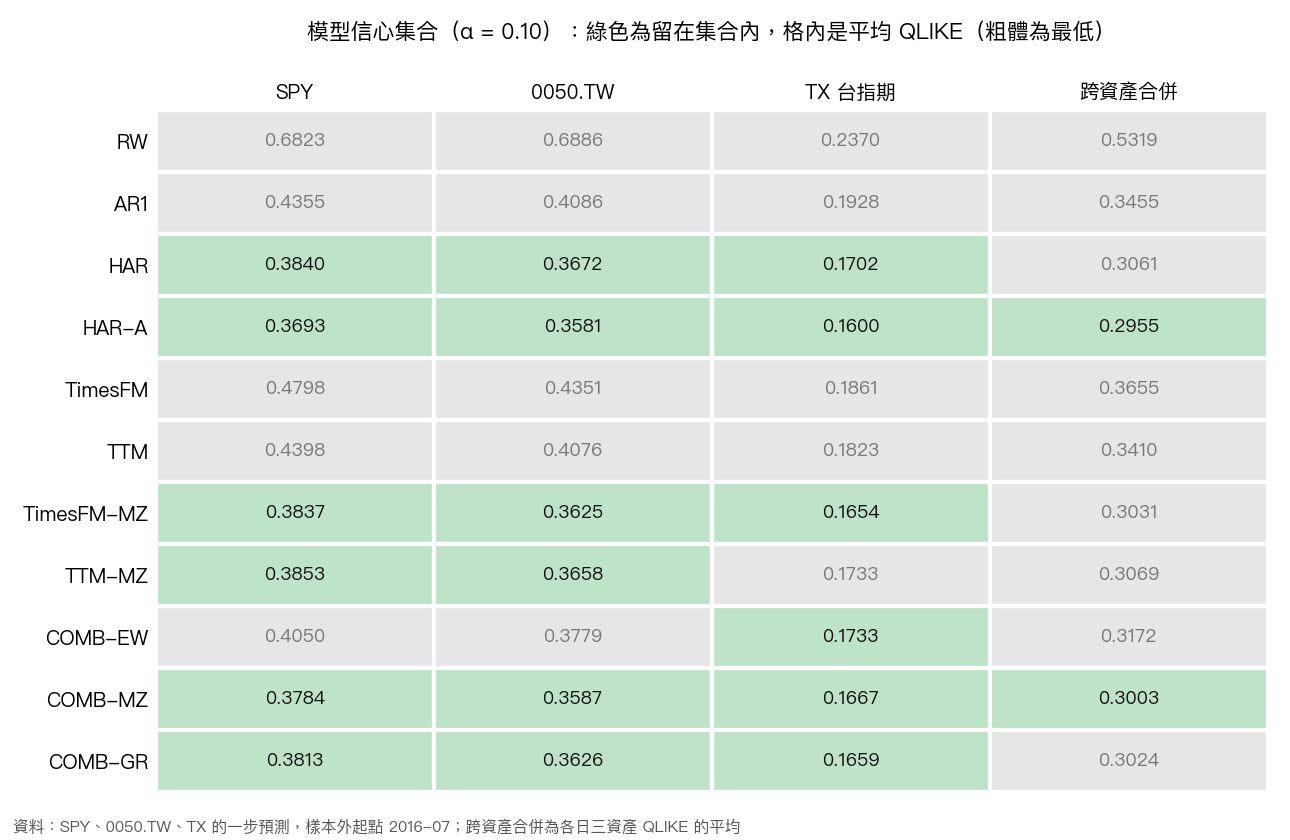
| 模型 | SPY | 0050.TW | TX | 跨資產合併 |
|---|---|---|---|---|
| HAR | 0.3840 | 0.3672 | 0.1702 | 0.3061 |
| HAR-A | 0.3693 | 0.3581 | 0.1600 | 0.2955 |
| TimesFM(裸用) | 0.4798 | 0.4351 | 0.1861 | 0.3655 |
| TTM(裸用) | 0.4398 | 0.4076 | 0.1823 | 0.3410 |
| TimesFM-MZ | 0.3837 | 0.3625 | 0.1654 | 0.3031 |
| TTM-MZ | 0.3853 | 0.3658 | 0.1733 | 0.3069 |
| COMB-EW | 0.4050 | 0.3779 | 0.1733 | 0.3172 |
| COMB-MZ | 0.3784 | 0.3587 | 0.1667 | 0.3003 |
| COMB-GR | 0.3813 | 0.3626 | 0.1659 | 0.3024 |
SPY 與 0050.TW 的最佳集合都有 6 個模型:HAR、HAR-A、TimesFM-MZ、TTM-MZ、COMB-MZ、COMB-GR。TX 的集合同樣有 6 個:HAR、HAR-A、TimesFM-MZ、COMB-EW、COMB-MZ、COMB-GR,TTM-MZ 在 TX 被淘汰。RW 與 AR1 在三個市場都不在集合內。含基礎模型而留在集合內的模型,SPY 有 4 個,0050.TW 有 4 個,TX 有 4 個。
結果二:裸用與校準差多少
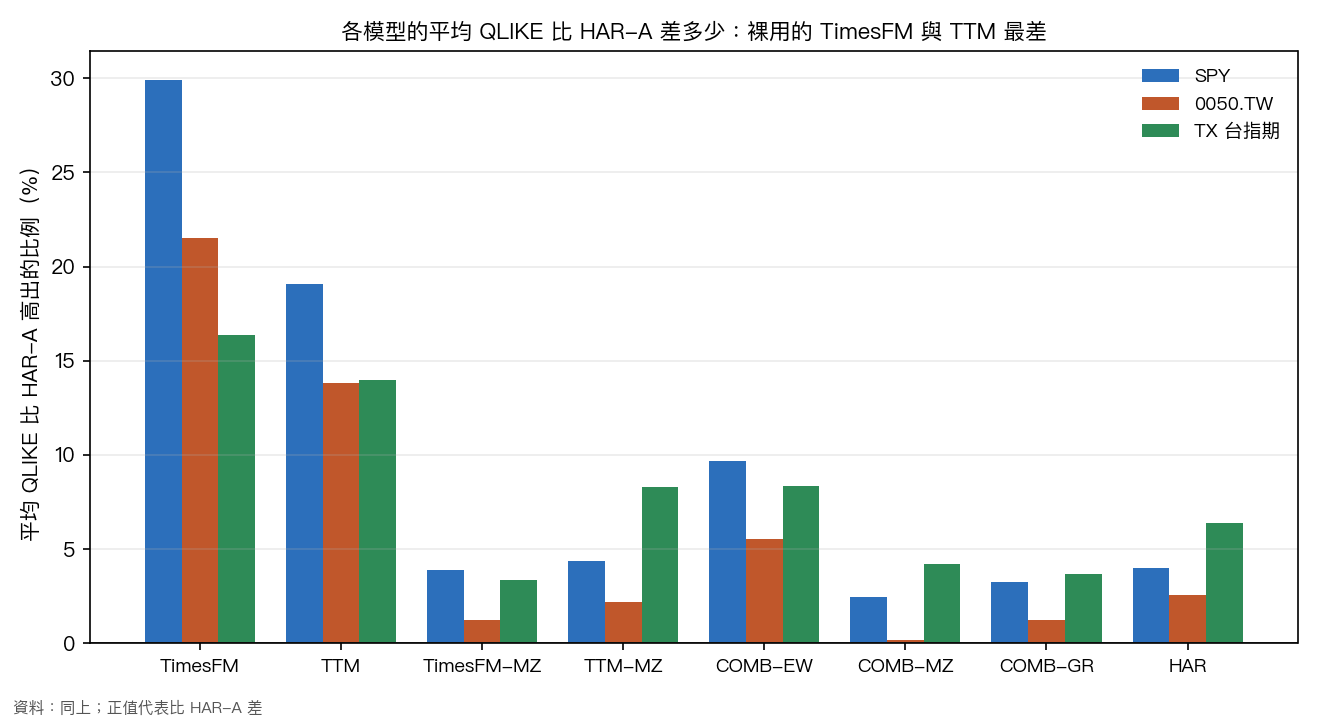
裸用的 TimesFM 與 TTM 比 HAR-A 差 13.8% 到 29.9%,跨資產合併的 TimesFM 差 23.7%、TTM 差 15.4%。校準或組合之後,四個版本(TimesFM-MZ、TTM-MZ、COMB-MZ、COMB-GR)在三個資產上比 HAR-A 差 0.2% 到 8.3%;HAR 本身比 HAR-A 差 2.6% 到 6.4%。校準把裸用模型的系統性高估修掉大半,剩下的差距與 HAR 對 HAR-A 的差距同一個量級。跨資產合併後,COMB-MZ 比 HAR-A 差 1.6%,HAR 差 3.6%。
結果三:加入基礎模型後,HAR 家族的集合有沒有改變
| 資產 | 只有基準模型時的集合 | 完整模型池集合裡的基準模型 | 有改變 |
|---|---|---|---|
| SPY | HAR-A | HAR、HAR-A | 是 |
| 0050.TW | HAR、HAR-A | HAR、HAR-A | 否 |
| TX | HAR、HAR-A | HAR、HAR-A | 否 |
| 跨資產合併 | HAR-A | HAR-A | 否 |
只有 SPY 改變,改變的方向是較弱的 HAR 重新進入集合。加入基礎模型沒有淘汰任何 HAR 家族的成員。
結果四:跨資產合併
跨資產合併的 2,344 個共同日期上,平均 QLIKE 最低的是 HAR-A(0.2955),其次是 COMB-MZ(0.3003)。α = 0.10 時集合是 {HAR-A, COMB-MZ},α 提高到 0.25 時只剩 HAR-A。合併只回答「平均而言誰不被排除」,不替各市場的差異作證。
結果五:穩健性
- MCS 區塊長度。 自動選取、減半、加倍三種區塊長度,三個資產的集合完全不變(3 種長度,三個資產,全部與主要集合相同)。
- QLIKE 代理。 改用有雜訊的日內報酬平方(open 對 close 的對數報酬平方,零值以窗口前資料的低百分位墊底)當代理,墊底百分位換成三種設定(三個資產共 9 組)後,各資產的集合沒有改變。換代理後,三個資產的一步集合都包含 HAR、HAR-A、TimesFM-MZ、TTM-MZ、COMB-MZ、COMB-GR 六個模型,AR1 也留下,SPY 另外多留下 COMB-EW;裸用的 TimesFM 與 TTM 仍不在內。
- 存活格點計數。 在 12 個 2016 年起的格點(三資產、一步與五步、兩種代理)裡,裸用的 TimesFM 留在集合內 0 次,裸用的 TTM 1 次;TimesFM-MZ 12 次,TTM-MZ 11 次,COMB-MZ 12 次,COMB-GR 12 次;HAR 與 HAR-A 各 12 次。
- 較晚的窗口。 自 2024 年起的 12 個格點只有約六百個評分日,檢定力低很多:裸用的 TimesFM 留在集合內 3 次,裸用的 TTM 8 次,AR1 與 RW 也分別留在 12 與 5 次。短窗口的存活不能解讀成模型變好,只代表資料量少,淘汰不了。
能說與不能說
- 能說: 校準後或與 HAR 組合後的含基礎模型候選,在三個市場的一步預測上沒有被 MCS 排除;裸用的 TimesFM 與 TTM 被排除;HAR 家族的集合在加入基礎模型後,只在 SPY 因較弱的 HAR 重新入列而改變。
- 不能說基礎模型勝出: 三個市場與跨資產合併的最低平均 QLIKE 都是 HAR-A。
- 不能說加入基礎模型有顯著增量: MCS 只回答哪些模型不被排除,不回答某個存活者是否顯著優於 HAR。
- 不能說存活代表更準: 集合裡同時有好幾個模型,代表樣本分不出它們的高低。
- 不能當成即時預測的證據: 樣本外窗口是回溯的偽樣本外,見限制。
限制
- 回溯偽樣本外。 兩個檢查點都是資料期間之後才發布的成品,TimesFM 公開的預訓練資料截止在 2023 年,晚於部分評估期;輸入脈絡沒有偷看未來,但模型權重是否接觸過類似的歷史型態無法完全稽核。2024 年起的窗口只是較晚較乾淨的穩健性檢查,TTM 的訓練資料截止並未載明,不能稱為完全不受污染。
- MCS 的前提。 候選預測是估計出來的,部分模型對是巢狀的,標準的 MCS bootstrap 沒有另外校正巢狀的 QLIKE 比較在虛無假設下的非標準分布。
- 代理品質不一。 SPY 與 0050.TW 用日 OHLC 的 Garman–Klass 代理,TX 用五分鐘資料,跨市場的量測品質不同。
- 日內報酬平方的代理 只在條件期望為零等理想化假設下才無偏,零值以窗口前資料墊底,只能當近似的穩健性檢查。
- 沒有交易檢驗。 只評預測損失,沒有策略、成本或夏普值。
- 預測期只有一步與五步。
資料來源:Yahoo Finance 日 OHLC(SPY、0050.TW)、本機 TAIFEX 五分鐘資料(TX);TimesFM 與 TTM 的公開檢查點;實驗編號 k1711。
參考文獻
- Clark, T. E., & West, K. D. (2007). Approximately normal tests for equal predictive accuracy in nested models. Journal of Econometrics, 138(1), 291–311. https://doi.org/10.1016/j.jeconom.2006.05.023
- Corsi, F. (2009). A simple approximate long-memory model of realized volatility. Journal of Financial Econometrics, 7(2), 174–196. https://doi.org/10.1093/jjfinec/nbp001
- Das, A., Kong, W., Sen, R., & Zhou, Y. (2024). A decoder-only foundation model for time-series forecasting. arXiv:2310.10688. https://arxiv.org/abs/2310.10688
- Diebold, F. X., & Mariano, R. S. (1995). Comparing predictive accuracy. Journal of Business & Economic Statistics, 13(3), 253–263. https://doi.org/10.1080/07350015.1995.10524599
- Ekambaram, V., Jati, A., Dayama, P., Mukherjee, S., Nguyen, N. H., Gifford, W. M., Reddy, C., & Kalagnanam, J. (2024). Tiny Time Mixers (TTMs): Fast pre-trained models for enhanced zero/few-shot forecasting of multivariate time series. arXiv:2401.03955. https://arxiv.org/abs/2401.03955
- Hansen, P. R., Lunde, A., & Nason, J. M. (2011). The model confidence set. Econometrica, 79(2), 453–497. https://doi.org/10.3982/ECTA5771
- Harvey, D., Leybourne, S., & Newbold, P. (1997). Testing the equality of prediction mean squared errors. International Journal of Forecasting, 13(2), 281–291. https://doi.org/10.1016/S0169-2070(96)00719-4
- Patton, A. J. (2011). Volatility forecast comparison using imperfect volatility proxies. Journal of Econometrics, 160(1), 246–256. https://doi.org/10.1016/j.jeconom.2010.03.034
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊