拿十幾年前的崩盤歷史餵給 AI 預測模型,波動率預測會被帶壞嗎?二十四組比較:沒抓到傷害,也排除不了
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
拿十幾年前的崩盤歷史餵給 AI 預測模型,波動率預測會被帶壞嗎?二十四組比較:沒抓到傷害,也排除不了
先講結論
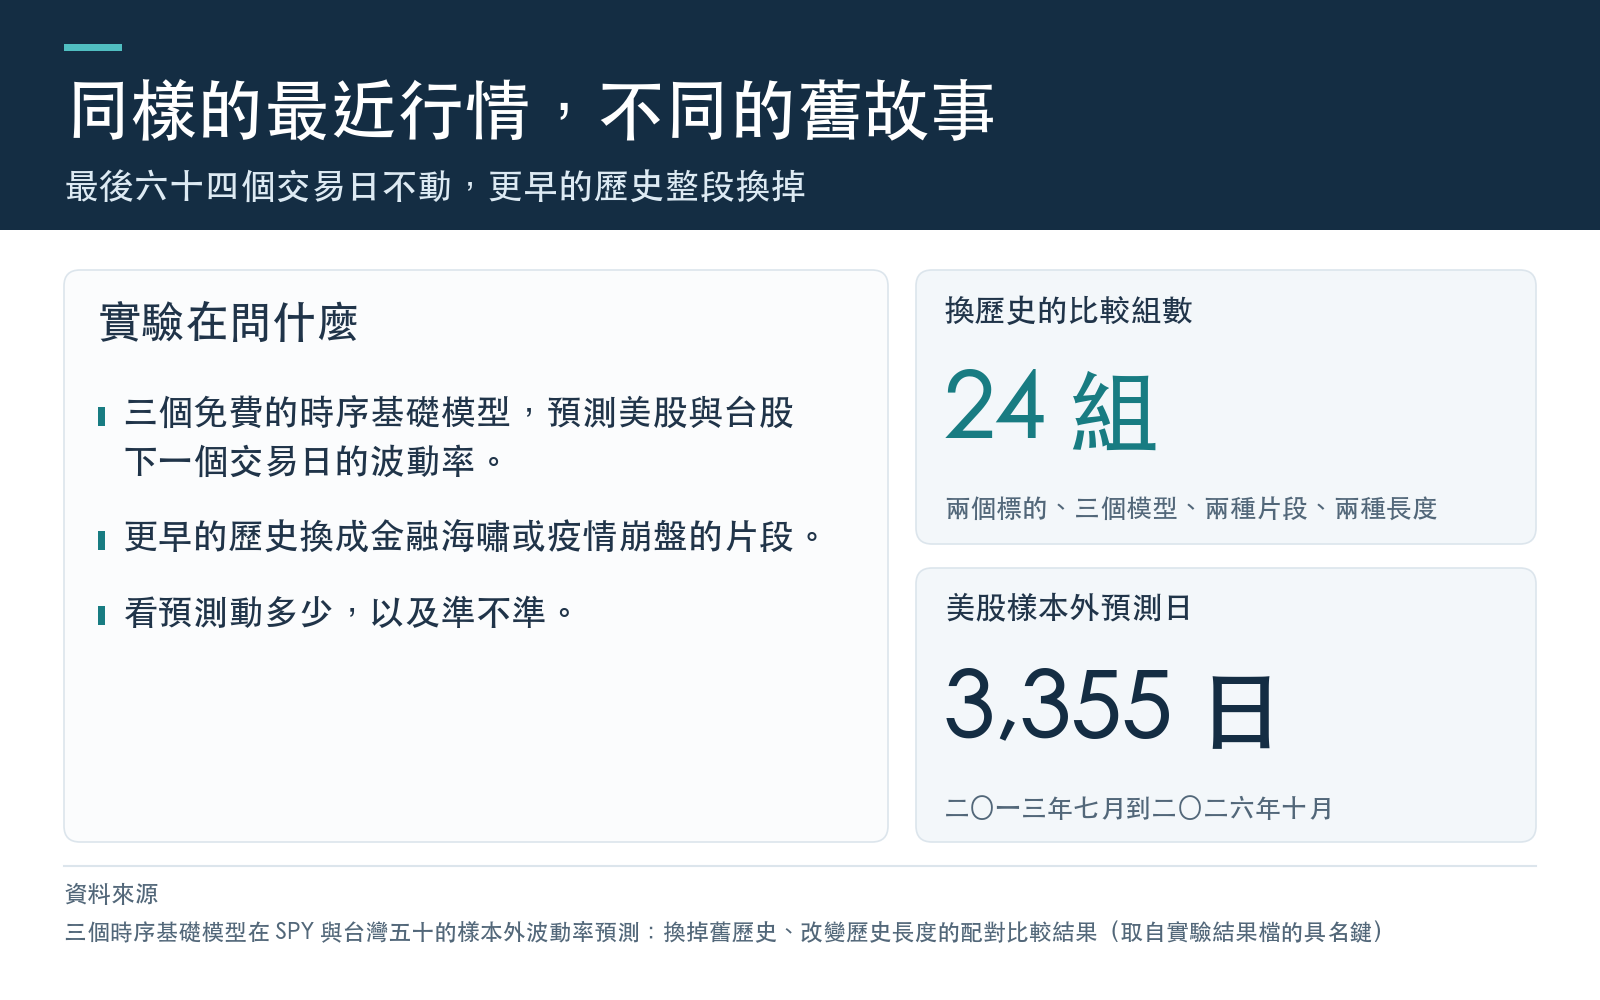
時序基礎模型(Chronos-Bolt、Chronos-2、TimesFM-2.5)的賣點是「不用重新訓練,丟一段歷史進去就吐出預測」。丟進去的歷史如果混著另一個時代的崩盤行情,預測會不會被帶歪?我們用美股 SPY 和台股 0050 做了一個配對實驗:最後 64 個交易日固定不動,更早的歷史整段換成 2008 年金融海嘯或 2020 年疫情崩盤的片段,比較下一個交易日的波動率預測。
三個結果,強度依證據排序:
- 預測會動,但動得不算大。 24 組組合裡,換掉舊歷史讓預測的中位變動落在 6.0% 到 15.2% 之間,比預測本身的誤差小得多。
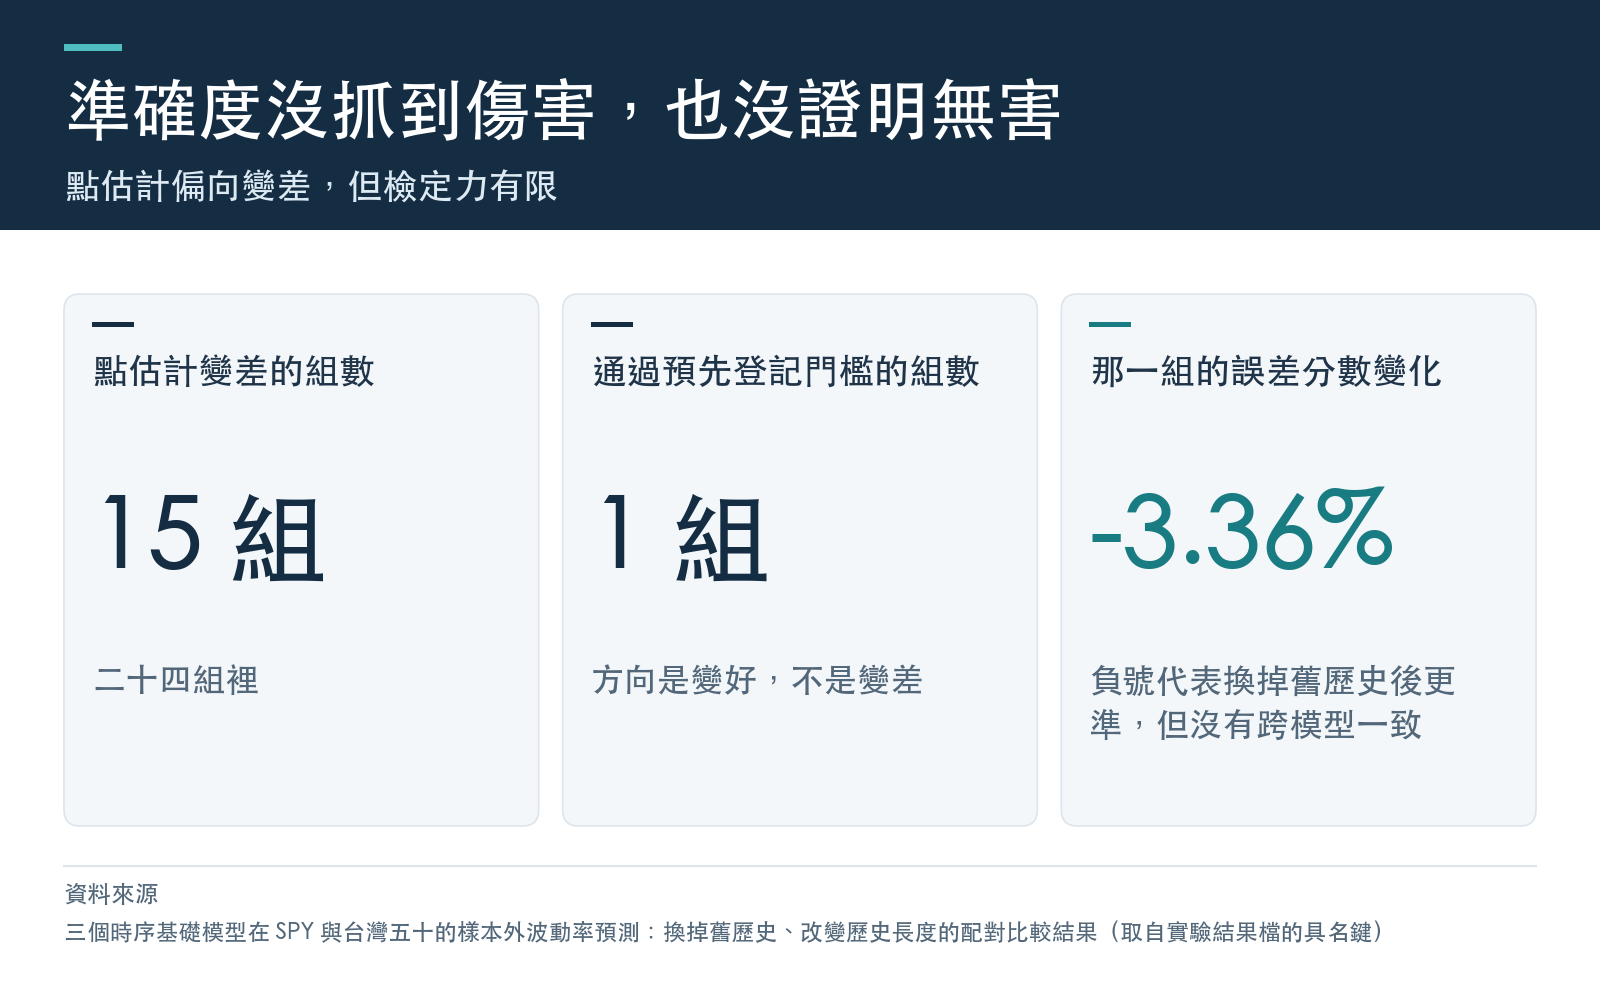
- 準確度沒抓到明確的傷害,但不能說舊歷史無害。 24 組裡有 15 組的點估計是變差、24 組中只有 1 組通過事先寫好的門檻,而那一組的方向是變好。這個實驗的檢定力不足以排除數個百分點的準確度損失。
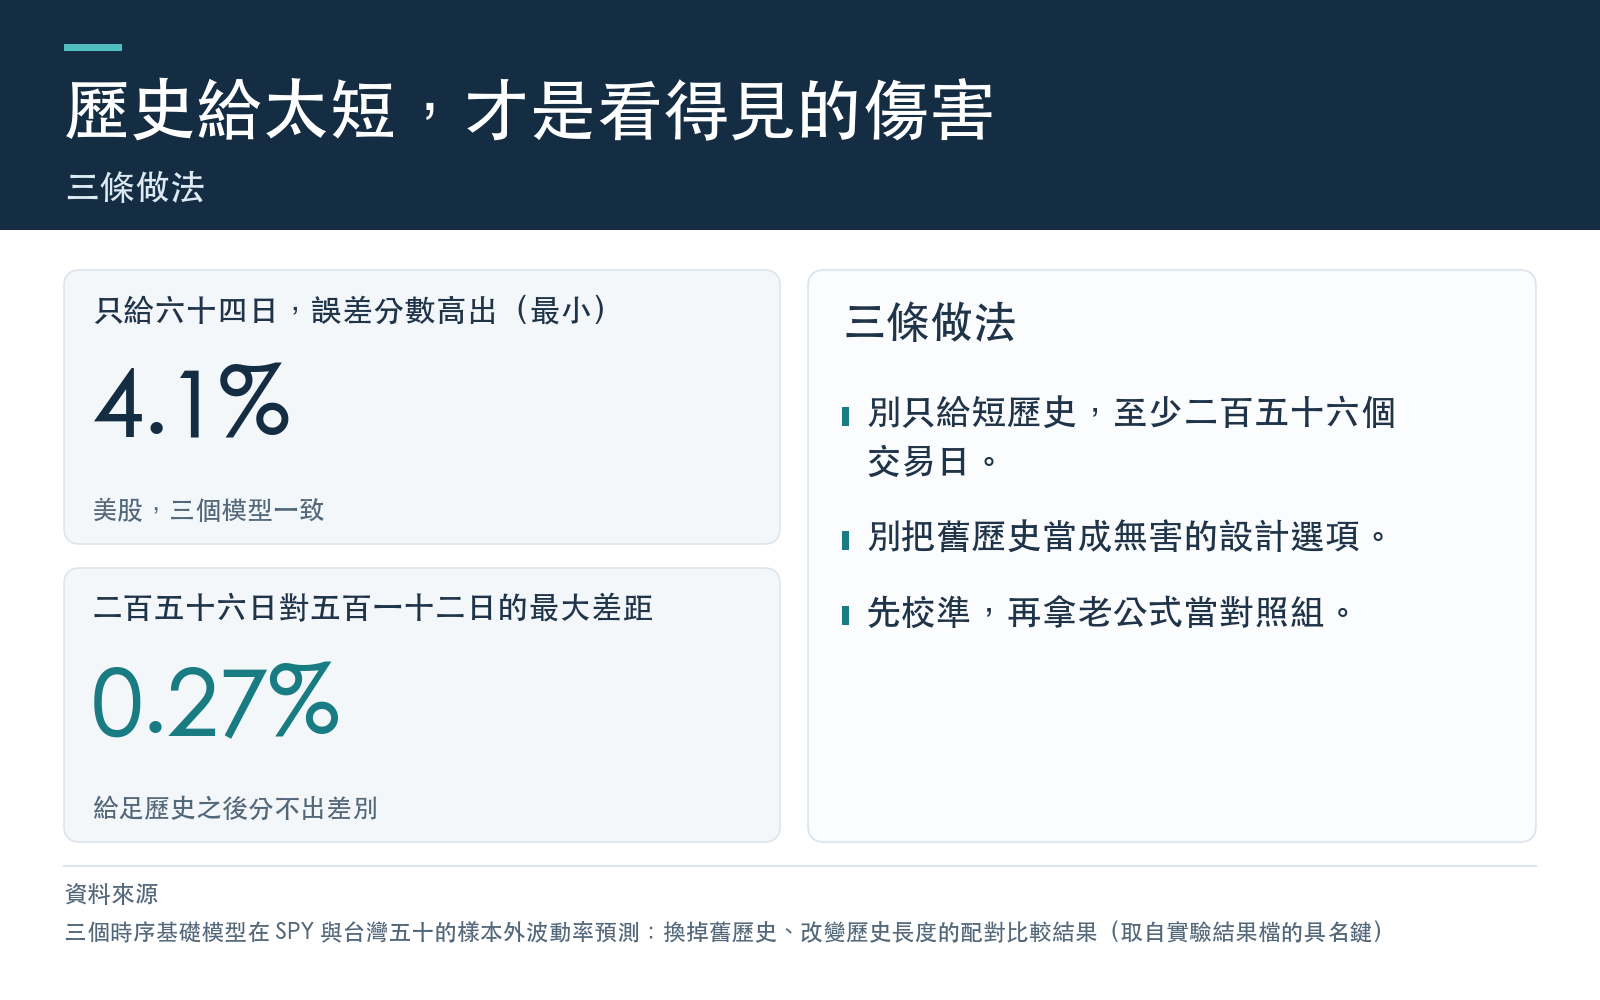
- 歷史給太短才是看得見的傷害。 只給 64 個交易日,SPY 上三個模型的預測誤差分數一致高出 4.1% 到 5.5%;給 256 或 512 個交易日,兩者的差距最大只有 0.27%。
一句話:與其擔心舊崩盤把模型帶壞,不如先確認你給它的歷史夠長;至於「舊歷史完全沒影響」,這份證據撐不起來。
實驗怎麼設計
波動率預測的好壞,看的是預測值和事後實現值的落差。我們用日內最高價與最低價推出每天的實現變異數,取對數後讓模型預測下一個交易日,樣本外期間從 2013-07-01 到 2026-10-30,SPY 有 3,355 個預測日,0050 有 3,239 個。
「換歷史」的做法是:每個預測日,最後 64 個交易日原封不動,其餘的上下文換成 2008 年或 2020 年的危機片段,並把它的平均水準調到與被換掉的那段相同,所以模型看到的是「同樣的最近行情、不同的舊故事」。每一格都拿換掉前後的預測做配對比較,預測誤差用 QLIKE 分數衡量(越低越準),統計檢定與多重比較的門檻在看到結果前就寫死。
結果一:預測會被拖動,但幅度有限
換掉舊歷史之後,預測值(取對數)逐格的中位變動介於 0.059 到 0.142 個單位,換算成變異數預測約是 6.0% 到 15.2%;各格有 27% 到 65% 的預測日,變動超過 0.10 個單位。
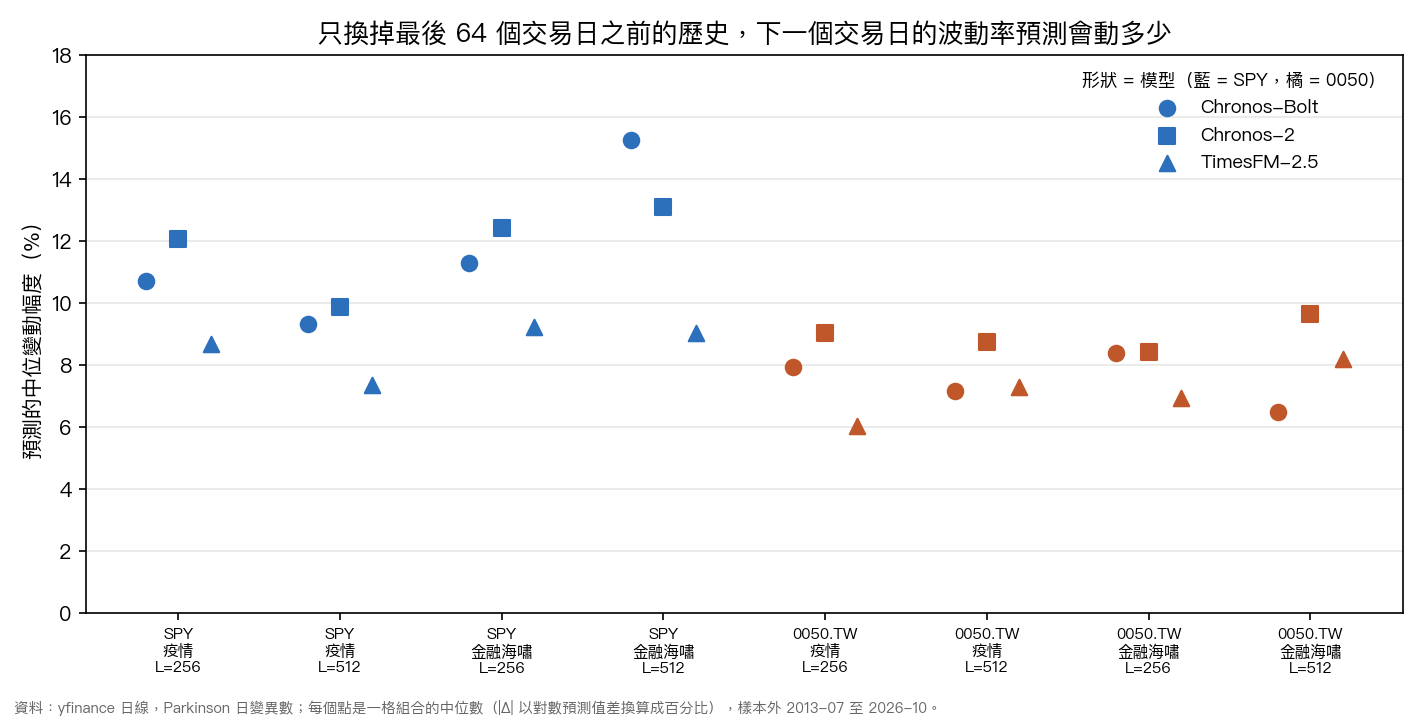
這個移動幅度不是模型獨有的現象。用同一段上下文去估老牌 HAR 公式,換掉舊歷史後的預測(取對數)中位變動是 0.077 到 0.129 個單位,和三個模型在同一量級。對模型來說,平均移動只有它自己預測誤差的標準差的 0.09 到 0.19 倍,也就是舊歷史造成的拖動遠小於預測本身的誤差。所以「預測會被舊歷史拖動」是真的,但單看拖動幅度,還不足以判斷它是否有害。
結果二:準確度沒抓到傷害,也沒證明無害
事先登記的判準是:誤差分數的相對變化至少 1%,並且通過多重比較校正。24 格裡只有 1 格達標,那一格(0050、疫情片段、512 日)的方向是換掉舊歷史之後 更準 ,誤差分數降了 3.36%;同一模型、同一片段在 256 日的設定並不顯示同樣的改善,另外兩個模型在同一格也沒有,所以這一格不能當成「舊崩盤反而有幫助」的證據。
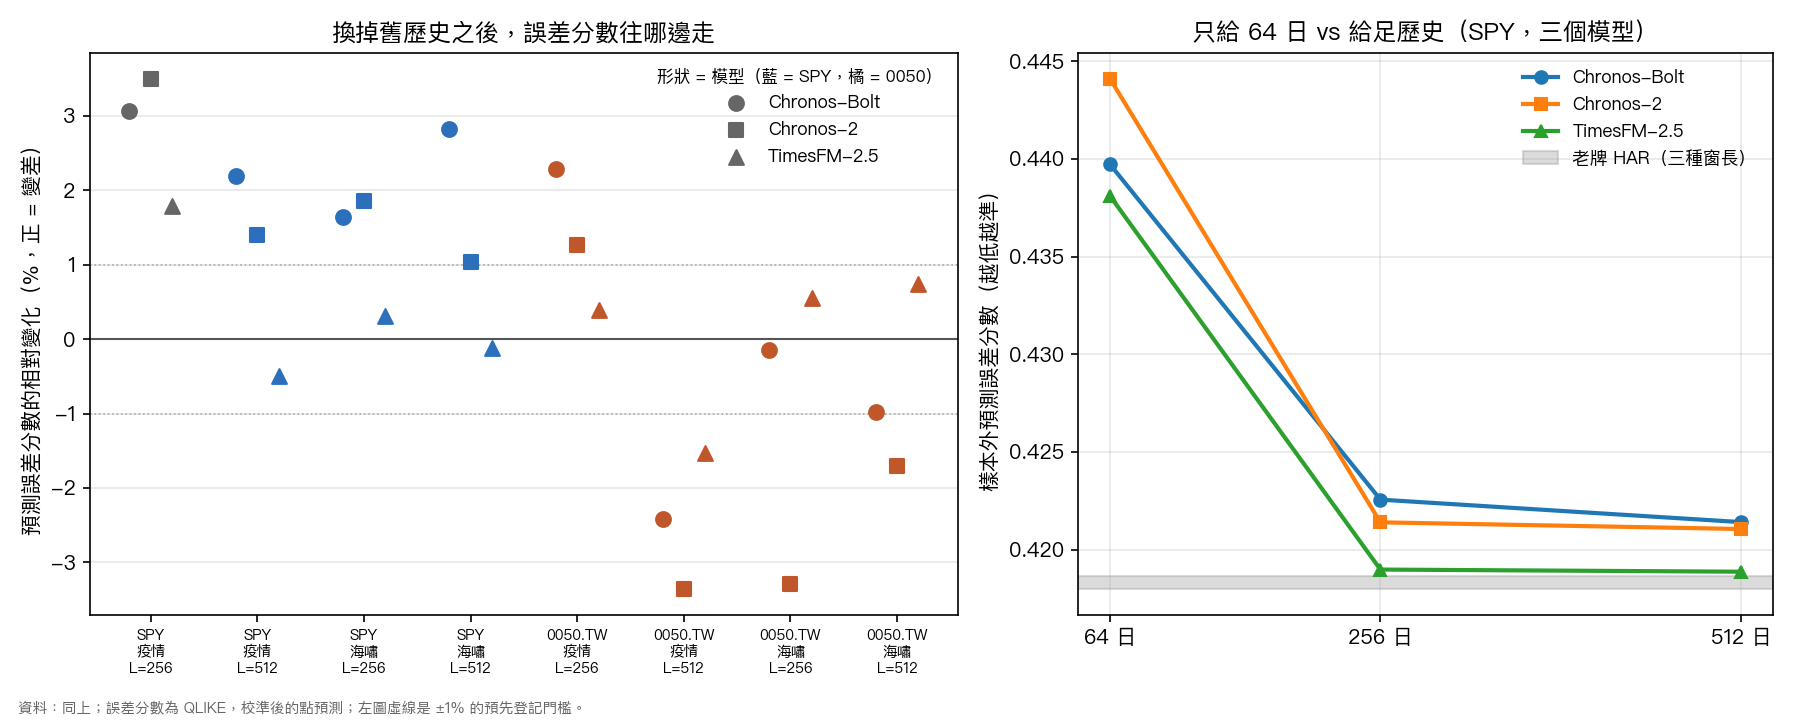
反過來,看點估計:24 格裡有 15 格是變差,SPY 就占 10/12,最大的一格變差 3.50%。沒有一格以「變差」的方向通過門檻,原因主要是樣本不夠大:這個設計能檢出的準確度變化至少要數個百分點。所以結論只能寫成「沒找到通過門檻的損害」,不能寫成「舊歷史無害」。要證明無害,需要另外設計等效性檢定。
結果三:真正有感的是歷史給太短
另一組比較看上下文長度。只給 64 個交易日時,SPY 上三個模型的誤差分數都比 256 日和 512 日差,差幅 4.1% 到 5.5%,六組比較全部通過門檻;256 日與 512 日之間,最大差距只有 0.27%。0050 的 18 組長度比較裡,通過門檻的有 0 組:沒偵測到長度的影響,這同樣是「沒偵測到」,不是「確定沒有」。
校準與老公式:沒有輸,也沒有贏
兩件事和「舊歷史」無關,但決定你能不能直接用這些模型。第一,模型輸出要先校準:不校準的話,預測誤差分數比校準後高出 23% 到 29%(SPY 的範圍)。第二,校準之後,歷史夠長(256 日與 512 日)的模型在 SPY 上的誤差分數落在 0.4189 到 0.4226,老公式 HAR 是 0.4180 到 0.4186;在 0050 上前者是 0.4725 到 0.4841,後者是 0.4771 到 0.4875。統計上,SPY 的 12 個系統裡有 9 個留在「分不出高下」的集合,0050 的 12 個系統全部留下。換句話說,免費的基礎模型校準後和老公式不相上下,沒有明顯更準。
與先前的檢查一致:AI 圈的「時序基礎模型」搬進波動率擂台:老公式 HAR 沒被打下來講的也是這個形狀。
這對你的意思:三條做法
- 別只給短歷史。 如果你拿這類模型預測波動率,給 256 個交易日以上的歷史;64 日在 SPY 上有看得見的成本。
- 別把舊歷史當成無害的設計選項。 這份證據沒抓到傷害,但點估計偏向變差、檢定力又有限;在有等效性證據之前,預設仍是「它可能有一點影響」。
- 先校準,再跟老公式放在一起比。 沒有校準的輸出誤差大一截;校準後也要拿 HAR 當對照組,別因為模型名字新就當成更準。
資料與限制
本文所有數字取自 2013-07-01 至 2026-10-30 的樣本外預測,標的為 SPY 與 0050(2008 年的片段,0050 用台灣加權指數代替,因為 0050 的資料從 2009 年才有)。波動率用日內最高價與最低價推估,不含隔夜跳空,也不是五分鐘已實現波動率。只測了一步預測、零樣本、中位數點預測與一種校準方式;兩個標的、一段樣本外期間。疫情片段的子樣本只有約一千個預測日,檢定力更弱。
還有一個不能由這個實驗排除的風險:三個模型的預訓練資料截止日並未取得,若預訓練語料含評估期的一部分,歷史結果就不等於當時可執行的預測。實驗的「沒有偷看未來」只涵蓋可檢查的部分:輸入上下文、校準、HAR 與替換片段的流程。本文不構成投資建議。
懶人包圖組
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊