K1999:49 個產業的最大 Sharpe 組合,預知期望報酬、波動與相關各值多少?完美預知的 Shapley 分解
讀者互動
登入會員可按讚與收藏。
持續追蹤這項研究
收藏、追蹤與明日提醒只保存必要識別資料,可在會員中心檢視或刪除。
研究資訊不構成個人投資建議;提醒僅代表研究更新,不代表交易訊號。
建構產業層級的最佳化組合時,預測的力氣可以放在期望報酬、波動或相關。若相關的影響最大,改進相關模型就是投入的方向;若期望報酬的影響最大,相關模型做得再細,對 Sharpe 比率的幫助也有限。
Roy、Motson 與 Thomas(2026)以美國前 1,000 大股、50 年的資料報告:在最大 Sharpe 組合中,相關結構遠比報酬預測或波動估計更主導最高效率組合的建構。
K1999 在 Kenneth French 的 49 個產業上問相同的問題,用 Shapley 分解量出完美預知期望報酬 M、波動 V、相關 C 各自對串接 Sharpe 比率的貢獻;另檢定可行的相關預測 DCC 與常數相關收縮能否提高 Sharpe 比率。
結果摘要
- 主分析(H1) :φ_M = 1.1001、φ_V = 0.0618、φ_C = -0.0006,D = φ_C − φ_M = -1.1007。拔靴 D 的第 5 至第 95 百分位為 -1.2600 至 -0.9563,第 95 百分位 < 0,判定 OTHER DIRECTION:在串接 Sharpe 比率上,完美預知期望報酬的貢獻大於完美預知相關。
- 相關的完美預知沒有增益 :期望報酬與波動都用可行估計時,把相關換成完美預知,f({C}) = 0.5393,低於 f(∅) = 0.5781;φ_C 的拔靴第 5 至第 95 百分位 -0.0242 至 0.0249 跨過零。
- 可行的相關預測(H2a、H2b) :沒有報酬觀點、波動用前一年估計時,DCC 與常數相關收縮的 Sharpe 比率為 0.6094 與 0.5874,比 f(∅) 高 +0.0313 與 +0.0093;單尾拔靴 p 為 0.0717 與 0.1246,Holm 調整後都是 0.1434,在 α = 0.05 下都不拒絕。
- 敏感度 :等權產業、落後五年均值、前後分段樣本與取消權重上限下,D 都為負,介於 -1.4004 與 -0.9045;這些設定只描述,沒有檢定。
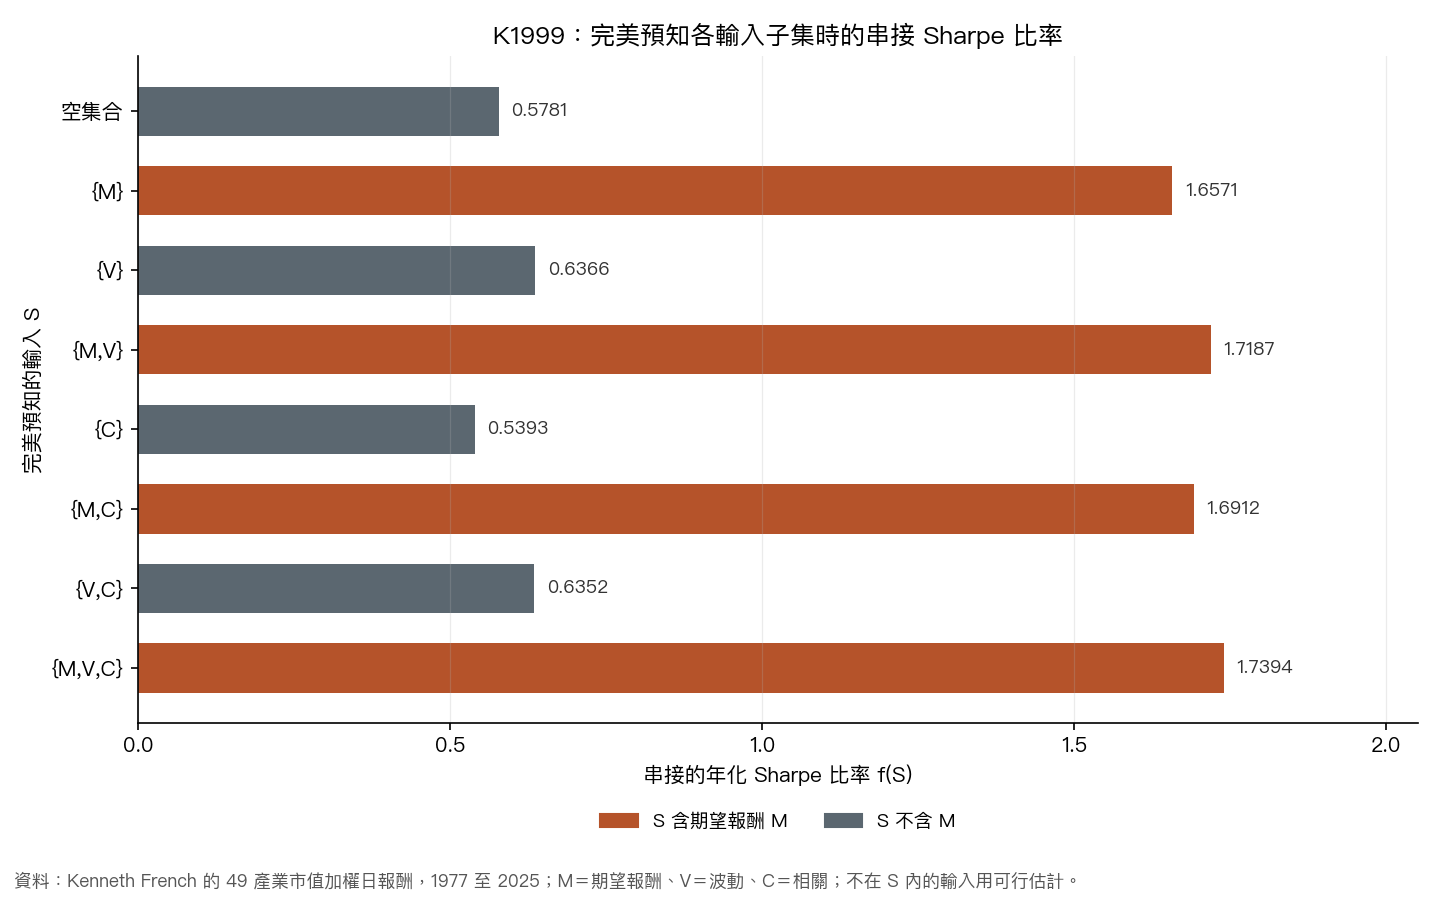
圖 1 的長條按 S 是否含 M 分開:含 M 的 f(S) 介於 1.6571 與 1.7394,不含 M 的介於 0.5393 與 0.6366。把相關或波動加進完美預知,改變的幅度都比加入 M 小。
設計
資料。 Kenneth French 資料庫的 49 個產業市值加權日報酬,減去同日無風險利率得到超額報酬。評估期 1977 至 2025 年,共 49 年、12,352 個交易日。
輸入。 期望報酬 M、波動 V、相關 C 各有可行版與完美預知版。可行版只用評估年度開始前的資料:M 不設報酬觀點(各產業相同),V 與 C 用前一年的樣本標準差與樣本相關。完美預知版用評估年度內的樣本平均、標準差與相關,投資人事前無法取得。
組合規則。 只做多、全額投資,產業權重上限 0.10,因此至少持有 10 個產業。沒有報酬觀點時取有上限的最小變異組合,有報酬觀點時取最大 Sharpe 組合。權重每年設定一次,年內維持不變,不計交易成本。滿足權重上限的組合中,最高期望報酬不為正的年份改用最小變異組合;主分析中含 M 的子集只有 2008 年出現這種情形。
統計量。 f(S) 是子集 S 內的輸入用完美預知、其餘用可行估計時,49 年日超額報酬串接後的年化 Sharpe 比率(乘以 √252)。φ_M、φ_V、φ_C 是 f 的 Shapley 值,φ_M + φ_V + φ_C = f({M,V,C}) − f(∅)。主統計量 D = φ_C − φ_M。
推論。 以評估年度為單位重抽 10,000 次(seed 1999),各統計量共用相同的重抽樣本。H1 的判定只看 D 的拔靴百分位:第 5 百分位 > 0 為 CONFIRMED,第 95 百分位 < 0 為 OTHER DIRECTION,其餘為 NULL。H2a、H2b 是 DCC 與常數相關收縮相對 f(∅) 的單尾拔靴檢定,Holm 族群大小 2,α = 0.05,不改變 H1 的判定。
可行的相關預測。 DCC(Engle,2002)先對各產業在評估年度之前五年的日資料配適 GARCH,再以相鄰產業對的複合概似估計相關動態,取未來 252 個交易日預測相關的平均。常數相關收縮(Ledoit 與 Wolf,2004)把前一年的樣本相關往平均相關收縮,收縮強度用他們的估計量。
完美預知的分解
| S(完美預知的輸入) | f(S) | 年化平均(%) | 年化波動(%) | 平均持有產業數 | 改用最小變異的年數 |
|---|---|---|---|---|---|
| 空集合 | 0.5781 | 7.43 | 12.86 | 14.47 | 0 |
| {M} | 1.6571 | 27.36 | 16.51 | 12.06 | 1 |
| {V} | 0.6366 | 7.76 | 12.19 | 14.61 | 0 |
| {M,V} | 1.7187 | 27.18 | 15.81 | 11.92 | 1 |
| {C} | 0.5393 | 6.70 | 12.43 | 14.14 | 0 |
| {M,C} | 1.6912 | 26.78 | 15.84 | 12.06 | 1 |
| {V,C} | 0.6352 | 7.47 | 11.76 | 14.55 | 0 |
| {M,V,C} | 1.7394 | 26.62 | 15.30 | 12.10 | 1 |
Shapley 值與 D 的拔靴百分位:
| 統計量 | 值 | 拔靴第 5 百分位 | 拔靴第 50 百分位 | 拔靴第 95 百分位 |
|---|---|---|---|---|
| φ_M | 1.1001 | 0.9540 | 1.1003 | 1.2651 |
| φ_V | 0.0618 | 0.0322 | 0.0621 | 0.0920 |
| φ_C | -0.0006 | -0.0242 | 0.0000 | 0.0249 |
| D = φ_C − φ_M | -1.1007 | -1.2600 | -1.1000 | -0.9563 |
φ_M 與 φ_V 的拔靴區間都在零的右側,φ_V 的區間上端 0.0920 仍遠低於 φ_M 的下端 0.9540;φ_C 的區間跨過零。D 的拔靴第 50 百分位 -1.1000 接近點估計 -1.1007。
可行的相關預測
可行的相關預測與 f(∅) 的比較:
| 相關預測 | Sharpe 比率 | 相對 f(∅) 的差 | 單尾拔靴 p | Holm 調整 p |
|---|---|---|---|---|
| DCC | 0.6094 | +0.0313 | 0.0717 | 0.1434 |
| 常數相關收縮 | 0.5874 | +0.0093 | 0.1246 | 0.1434 |
預註冊另定義回收比 ρ = (SR − f(∅)) / (f({C}) − f(∅)),量可行預測回收了多少完美預知相關的增益。本樣本的分母 f({C}) − f(∅) = -0.0388,為負,ρ 依預註冊報告為未定義。
敏感度
敏感度設定:S1 用等權產業報酬;S2 的可行 M 改用評估年度之前五年的樣本平均;S3 把評估期分成 1977 至 2000 年與 2001 至 2025 年;S4 取消權重上限。
| 設定 | f(∅) | f({M,V,C}) | φ_M | φ_V | φ_C | D |
|---|---|---|---|---|---|---|
| 主分析 | 0.5781 | 1.7394 | 1.1001 | 0.0618 | -0.0006 | -1.1007 |
| S1 等權產業 | 1.2343 | 2.3951 | 1.0853 | 0.0531 | 0.0223 | -1.0630 |
| S2 落後均值 | 0.5373 | 1.7394 | 1.1438 | 0.0603 | -0.0020 | -1.1458 |
| S3 前段 | 0.5408 | 1.9272 | 1.3599 | 0.0261 | 0.0003 | -1.3596 |
| S3 後段 | 0.6153 | 1.6035 | 0.9032 | 0.0863 | -0.0013 | -0.9045 |
| S4 無上限 | 0.6169 | 2.0469 | 1.3773 | 0.0758 | -0.0231 | -1.4004 |
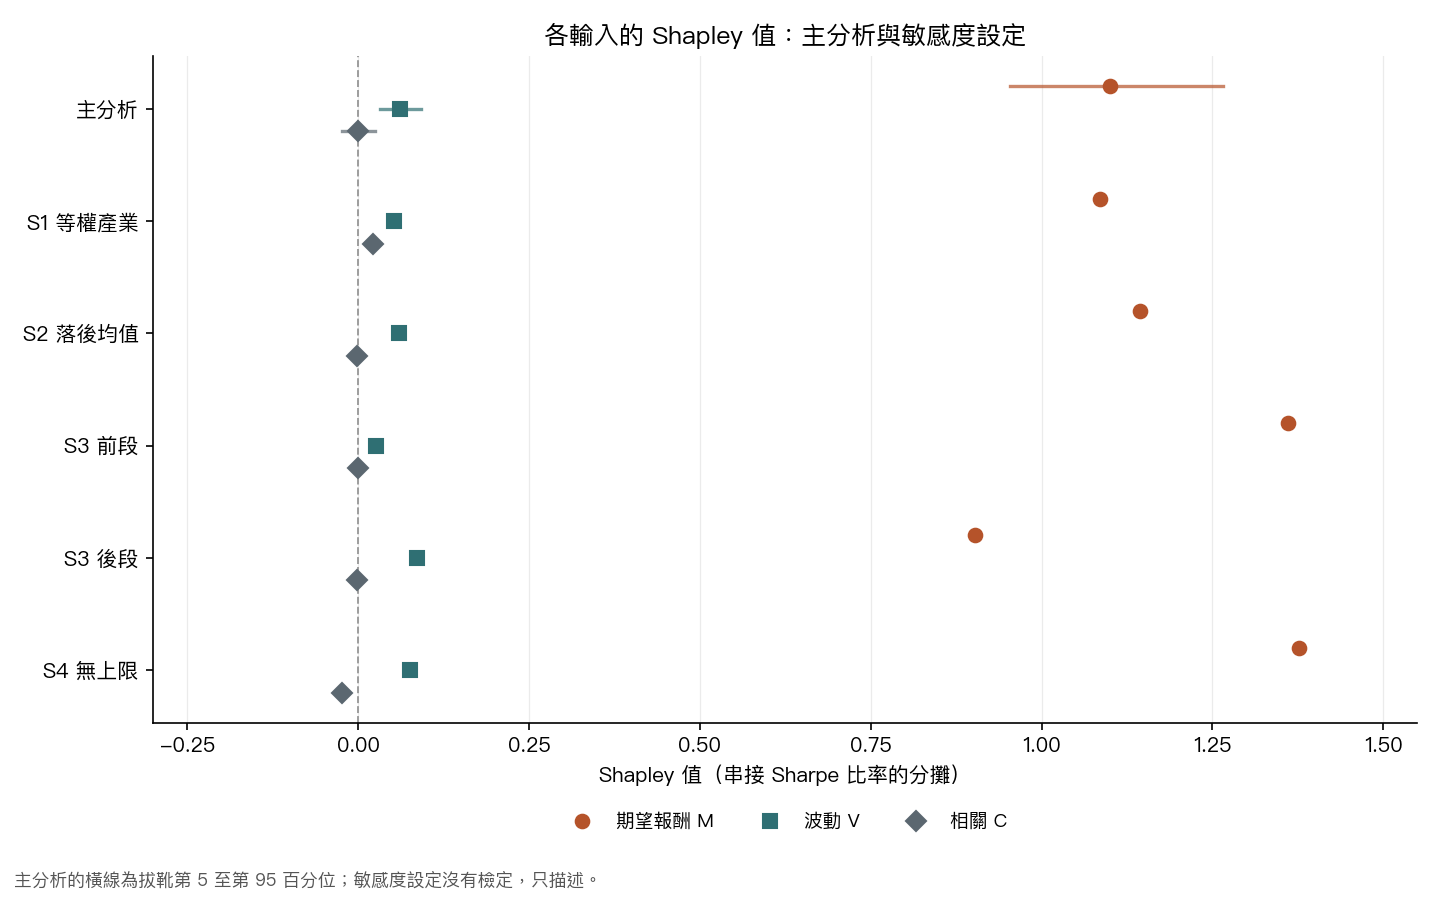
圖 2 中,φ_M 在各設定介於 0.9032 與 1.3773,φ_C 介於 -0.0231 與 0.0223,絕對值都小於同一設定的 φ_V。
對組合建構的意義
這組結果對建構產業組合的意義在投入的方向。本設定下,相關從前一年估計換成完美預知,串接 Sharpe 比率沒有提高;把相關估計從前一年樣本相關換成 DCC 或常數相關收縮,量到的增益在 +0.0093 至 +0.0313,Holm 校正後不拒絕零差;不拒絕不等於沒有增益。期望報酬的完美預知帶來最大的差距,但那是事後才知道的資訊:完美預知組合是投資人無法持有的資訊基準,也不是 49 年 Sharpe 比率的上界。
結果方向與 Roy 等人相反。本實驗與他們的設計差在樣本單位(產業對個股)、權重上限、日報酬與分解方法;差異來自哪個設計差別,本實驗沒有檢定。
Chopra 與 Ziemba(1993)量的是估計誤差帶來的確定等值損失,結論是均值誤差最重要;本實驗量的是完美預知對已實現 Sharpe 比率的價值,估計量不同。
診斷
DCC 的參數在 49 年間,a 介於 0.0081 與 0.0601,b 介於 0.7730 與 0.9842;GARCH 未收斂、改用樣本標準化的產業年數為 0。常數相關收縮的強度介於 0.0447 與 0.4030。
限制
- 產業不是個股 :結果只對 49 個產業的市值加權組合成立,不推到個股組合。
- 不計交易成本,權重年內固定 。
- 拔靴把評估年度當作獨立區塊 ,年度之間的相依沒有處理。
- 完美預知組合無法持有 :它們是資訊基準,不是策略;串接後也不是可行組合 Sharpe 比率的上界,所以 φ 可以為負。
- 機制沒有檢定 :本文只報各輸入的貢獻大小,不解釋原因。
- 敏感度設定只描述 ,不能取代主檢定。
資料與方法
- 資料:Kenneth French 資料庫的產業日報酬與無風險利率,1977 至 2025 年;實驗編號 K1999。
- 設計:預註冊在計算報酬統計量之前凍結;H1 只由拔靴 D 的百分位判定,H2a、H2b 以 Holm 校正。
相關文章
先讀正式關聯,若無則使用標籤與主題相似度補齊